LLM 추론 최적화: 더 빠르고 저렴한 AI를 위한 기법
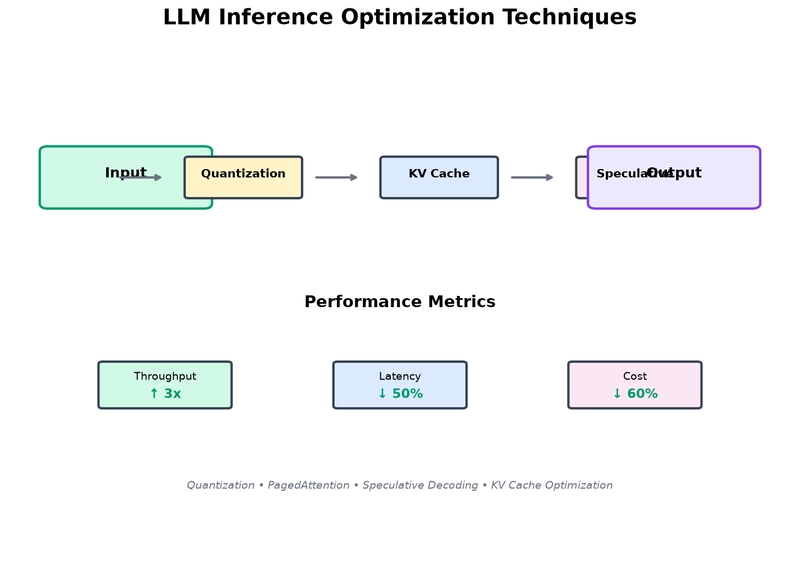
AI 애플리케이션이 확장됨에 따라 대규모 언어 모델(LLM)은 느린 추론과 높은 비용이라는 과제에 직면해 있습니다. LLM 추론을 최적화하는 것은 응답 시간을 줄이고, 계산 비용을 낮추며, 더 광범위한 배포를 가능하게 하는 데 중요합니다. 양자화는 모델 가중치 정밀도를 낮추는 핵심 기술로, INT8 또는 INT4를 사용하는 것과 같이 정확도 손실을 최소화하면서 상당한 속도 향상을 제공합니다. PagedAttention과 같은 방법을 사용하는 KV 캐시 최적화는 특히 긴 컨텍스트에서 더 빠른 생성을 위해 메모리 효율성을 향상시킵니다. 추측 디코딩은 더 작은 모델을 사용하여 토큰을 초안 작성하고, 이를 더 큰 모델이 검증하여 품질 저하 없이 2-3배의 속도 향상을 달성합니다. 프롬프트 최적화는 토큰 사용량과 관련 비용을 최소화하기 위해 더 간결하고 구조화된 프롬프트를 만드는 데 중점을 둡니다. 여러 요청을 그룹화하는 배치 처리는 효율성을 더욱 향상시킵니다. 양자화는 상당한 속도 및 비용 이점을 제공하며, KV 캐시 및 추측 디코딩은 품질 손실 없이 속도 향상을 제공합니다. 프롬프트 최적화는 품질에 영향을 주지 않으면서 적당한 속도 및 비용 개선을 제공합니다. KV 캐시 최적화를 구현하는 것이 종종 가장 쉬운 시작점이며, 엣지 장치의 경우 양자화, 처리량의 경우 추측 디코딩이 뒤따릅니다. 미래에는 하드웨어별 솔루션 및 동적 라우팅을 포함한 더 발전된 최적화 방법이 등장할 것입니다. 궁극적으로 최상의 최적화 전략은 속도, 비용 또는 모델 품질 유지라는 특정 우선순위에 따라 달라집니다.