llm-d 1.0 발표: Google Cloud TPU 및 GPU에서 에이전트의 오픈 분산 추론
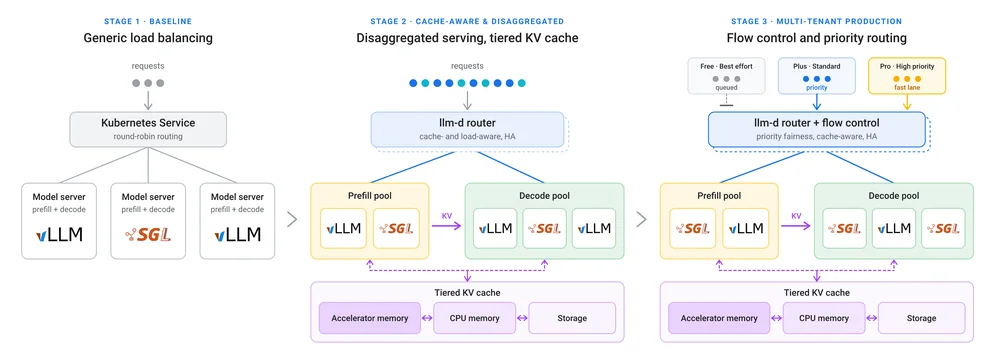
오늘 llm-d 1.0이 출시되었습니다. llm-d 1.0은 Google, Red Hat, IBM을 포함한 커뮤니티에서 개발한 분산 LLM 추론을 위한 오픈 소스 Kubernetes 네이티브 스택입니다. 이 프로젝트는 진화하는 추론 요구 사항을 해결하기 위해 PyTorch 및 Kubernetes 커뮤니티를 통합합니다. 단순한 채팅 상호 작용과 달리 현대적인 에이전트 기반 워크로드는 다단계 프로세스, 도구 사용 및 버스티 트래픽 패턴을 포함합니다. 이를 단일 머신이나 기본 로드 밸런서로 제공하는 것은 비효율적이며, 중복 계산과 대화형 사용자 지연을 초래합니다. llm-d는 클러스터를 조정된 서빙 풀로 변환하며, 이는 단일 엔드포인트에서 1,000개의 에이전트로 시연되었습니다. 주요 기능에는 에이전트 컨텍스트를 유지하기 위한 캐시 인식 라우팅 및 계층화된 KV 캐시, 트래픽 버스트 중에 대화형 요청을 우선시하기 위한 흐름 제어가 포함됩니다. 버전 1.0은 우선순위 인식 흐름 제어를 통한 멀티 테넌트 서비스 품질과 강화된 API를 통한 안정적인 기반을 제공합니다. 또한 고가용성 및 제로 다운타임 업데이트를 통한 안전한 업그레이드와 컨텍스트 재사용을 위한 에이전트 인식 서빙 기능을 지원합니다. 확장된 TPU 통합은 향상된 처리량과 활용도를 위해 TorchTPU 시간 분할을 통한 네이티브 PyTorch 모델 서빙을 제공합니다. llm-d 구성 요소는 조합 가능하여 사용자가 필요한 서빙 요소만 채택할 수 있습니다. 이 스택은 Kubernetes 기본 요소, PyTorch 서빙 엔진 및 가속기 인식 스케줄링을 연결하여 유연한 프로덕션 환경을 제공합니다.