멀티 클러스터 GKE Inference Gateway에서 1% 미만의 오버헤드로 글로벌 AI 라우팅
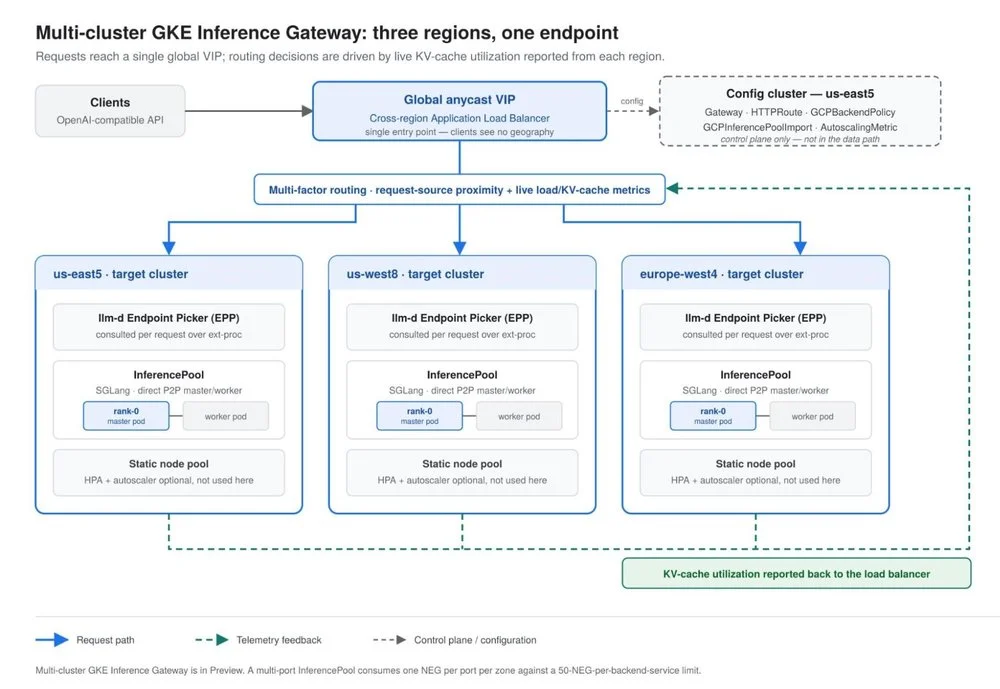
AI 인프라, 특히 가속기에 대한 수요가 매우 높아 전 세계 데이터 센터 전반에 걸쳐 부족 현상과 분산된 컴퓨팅 용량이 발생하고 있습니다. 대규모 컨텍스트 창을 가진 최신 AI 워크로드는 가속기 메모리를 빠르게 소비하여 활용도 문제를 악화시킵니다. 이를 해결하기 위해 전 세계에 분산된 용량을 단일 풀로 취급하는 계층형 라우팅 아키텍처가 개발되었습니다. 이 시스템은 글로벌 트래픽 분산을 위한 멀티 클러스터 GKE Inference Gateway와 메모리 인식 스케줄링을 위한 LLM-d 라우터를 특징으로 합니다. 이 아키텍처는 런타임, 모델, 가속기 유형에 구애받지 않도록 설계되었습니다. 대규모 멀티 리전 GKE 배포에 대한 벤치마크는 거의 선형적인 처리량 확장과 99.9%의 성공률을 보여주었습니다. GKE Inference Gateway는 1% 미만의 오버헤드를 추가하여 직접 클러스터 호출 처리량의 99.5%를 제공했습니다. 트래픽은 실시간 애플리케이션 신호, 특히 KV-캐시 토큰 활용도를 기반으로 라우팅되어 시스템이 지역 간 트래픽을 지능적으로 유출할 수 있도록 합니다. 이 메모리 인식 라우팅은 가속기가 메모리 포화로 인해 고립되는 것을 방지하여 효율적인 활용도를 보장합니다. 추가 가속기에서 거의 비례적인 성능 향상을 달성하고 자본 낭비를 방지함으로써 "달러당 지능"을 극대화합니다. 주요 교훈은 스마트 로드 밸런싱의 중요성, 에이전트 워크로드 메모리 병목 현상 고려, AI 트래픽 지연 시간에 대한 적응, 네이티브 서빙 패턴과의 라우팅 통합, 개방적이고 이식 가능한 스택 선택을 강조합니다.