모든 LLM 워크로드는 동일하지 않습니다: 분류 대 생성에 대한 TPU 성능 벤치마킹
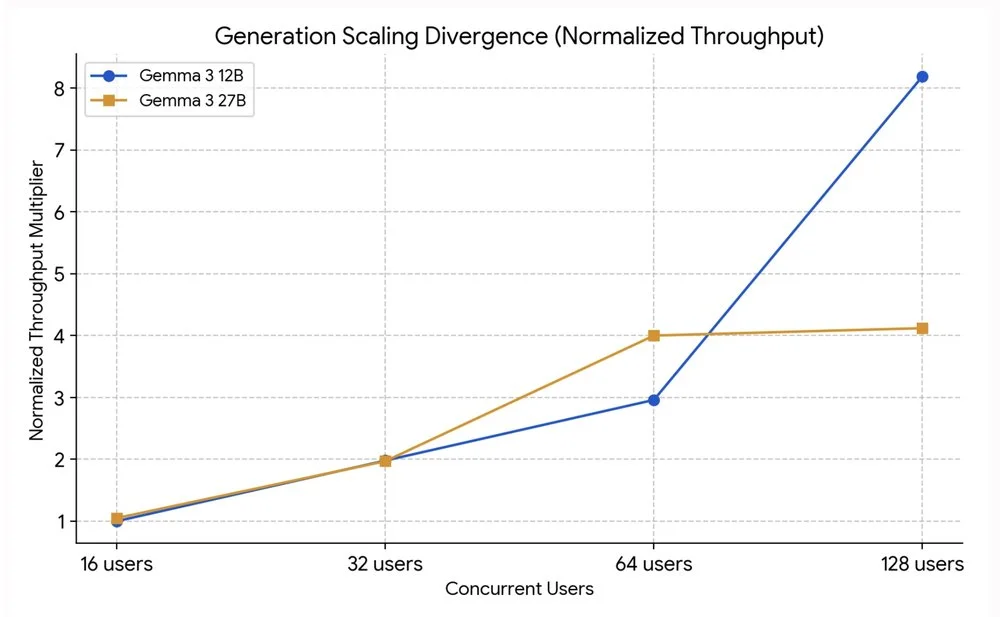
LLM의 엔터프라이즈 프로덕션 배포는 성능과 비용에 있어 인프라의 중요한 역할을 드러냅니다. 모든 LLM 요청이 하드웨어에 동일하게 부담을 주는 것은 아니므로 표준 벤치마크로는 불충분합니다. 본 연구는 Google Cloud TPU v6e에서 Gemma 3 12B와 27B를 비교하여 서로 다른 워크로드로 대규모 인프라 성능을 이해하고자 합니다. 디코드 중심 생성의 경우, Gemma 3 12B 모델은 높은 동시성에서 더 잘 확장되는 반면, 27B 모델은 포화 상태가 됩니다. 프리필 중심 분류 작업의 경우, 12B 및 27B 모델 모두 유사한 확장을 보여 처리량 페널티 없이 더 큰 모델을 사용할 수 있습니다. 하드웨어 포화는 지연 시간 급증과 요청의 조용한 드롭을 유발하므로, CPU/메모리뿐만 아니라 종단 간 지연 시간을 기반으로 확장해야 합니다. 아키텍처는 GKE, TPU v6e, vLLM 서빙 프레임워크 및 Gemma 3 모델로 구성됩니다. 분류 작업은 입력이 높고 출력이 낮으며, 생성 작업은 입력이 낮거나 중간이고 출력이 높습니다. 벤치마크는 높은 동시성에서의 생성 확장성에서 12B 모델의 우수성을 보여주는 반면, 분류에서는 두 모델이 유사하게 수행됩니다. 최적화를 위해서는 특정 워크로드의 입력/출력 프로필에 맞춰 모델 선택 및 서빙 구성을 조정해야 합니다.