NVIDIA Dynamo에서 Pinterest의 VLM 서빙 스택 구축
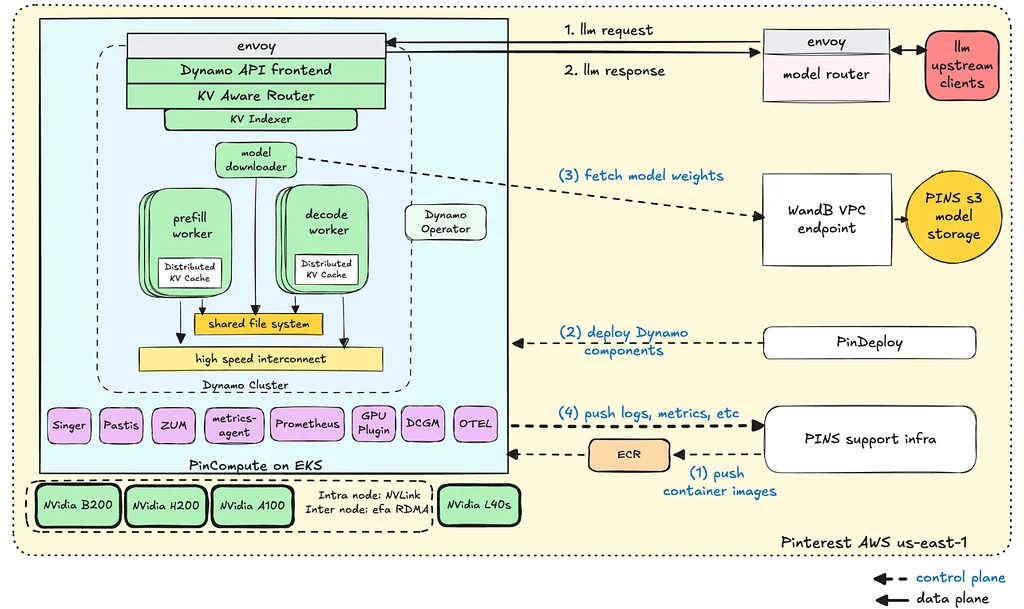
Pinterest는 비주얼 검색 및 탐색 플랫폼을 강화하기 위해 Vision-Language Models(VLM)을 활용합니다. 이러한 모델은 Pinterest Assistant 및 하이브리드 검색과 같은 새로운 기능을 지원하는 데 중요합니다. Pinterest는 특정 제품 및 규모 요구 사항을 충족하기 위해 오픈 소스 VLM을 맞춤화합니다. VLM을 제공하는 것은 여러 이미지와 더 큰 KV 캐시를 처리하는 것을 포함하여 기존 텍스트 전용 LLM을 넘어서는 고유한 과제를 제시합니다. 이를 해결하기 위해 Pinterest는 NVIDIA Blackwell GPU 및 NVIDIA Dynamo를 기반으로 VLM 제공 스택을 구축했습니다. Blackwell GPU는 까다로운 AI 워크로드에 대해 뛰어난 컴퓨팅 처리량과 메모리 용량을 제공합니다. Dynamo는 전체 제공 경로에 걸쳐 멀티모달 추론을 최적화하기 위한 분산 오케스트레이션 계층을 제공합니다. VLM에 대한 요청 페이로드는 이미지 다운로드, 사전 처리 및 프롬프트 구성을 필요로 하여 더 복잡합니다. VLM 제공의 사전 채우기 단계는 종종 지배적이고 계산 비용이 많이 들기 때문에 고급 캐시 관리가 필요합니다. 다중 턴 VLM 상호 작용은 시각적 컨텍스트의 변화와 더 무거운 사전 채우기 요구 사항으로 인해 제공을 더욱 복잡하게 만듭니다. KV 캐시 메모리 압력을 관리하는 것은 KV 인식 라우팅 및 오프로딩과 같은 전략이 필요하므로 중요합니다. Pinterest의 솔루션은 분산 사전 채우기 및 디코딩, LMCache를 사용한 KV 캐시 오프로딩, Dynamo 및 vLLM 내의 멀티모달 지원을 활용합니다. 또한 대규모 시각적 컨텍스트 처리 비용을 줄이기 위해 사용자 정의 프로젝션 임베딩을 구현했습니다. 이 최적화된 VLM 제공 스택은 성능을 크게 향상시켜 Time-to-First-Token에서 상당한 이득을 보여줍니다.