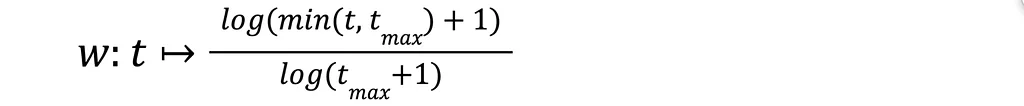Stories by Pinterest Engineeri... 노트

Stories by Pinterest Engineering | Medium 한국어

미디어(Medium)에서 공개된 'Pinterest 엔지니어링(Pinterest Engineering)'은 인기 있는 시각적 검색 플랫폼을 구동하는 기술 혁신에 대한 내부적인 모습을 보여준다. 엔지니어들은 확장성, 기계 학습, 데이터 인프라스트럭처 등에 대한 자신의 작업에 대한 깊은 통찰력을 공유한다. 이 출판물은 협업, 실험, 복잡한 문제 해결에 대한 열정을 강조하는 핀터레스트의 엔지니어링 문화를 강조한다. 독자는 추천 시스템 구축, 검색 기능 최적화, 데이터 분석을 위한 도구 개발 등 다양한 주제를 탐색할 수 있다. 이 콘텐츠는 핀터레스트와 같은 대규모 플랫폼의 세부 사항에 관심 있는 엔지니어와 기술 애호가들에게 귀중한 통찰력을 제공한다. 이미지 인식의 도전이나 인프라의 진화에 깊이 있게 탐구하는 것과 같은 주제를 다루는 동안, 미디어의 Pinterest 엔지니어링은 사랑받는 온라인 목적지의 기술적인 측면에 대한 매혹적인 모습을 제공한다.

노트 스레드

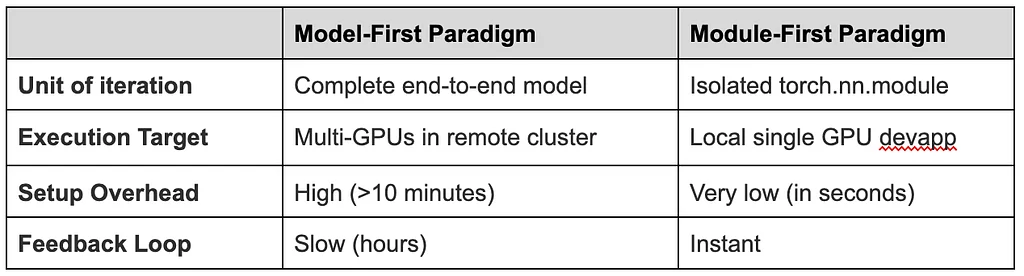
현대 추천 시스템은 대규모 및 분산 특성으로 인해 테스트 및 디버깅에 상당한 어려움을 겪고 있습니다. 기존의 "모델 우선(Model-First)" 접근 방식은 하드웨어 제한, 입력 데이터 종속성 및 느린 반복 피드백 루프를 초래합니다. ModuleLens는 "모듈 우선(Module-First)" 패러다임을 도입하여 엔지니어가 개별 모듈을 로컬에서 격리, 재구성 및 프로파일링할 수 있도록 합니다. 이는 개발자 워크플로우를 크게 가속화하고 자율 AI 에이전트 최적화를 촉진합니다.ModuleLens 아키텍처는 ModuleTracer, ModuleRepo 및 Consumption Layer로 구성됩니다. ModuleTracer는 PyTorch forward hook을 통해 텐서, 매개변수 및 초기화 인수를 포함한 필수 런타임 데이터를 비침습적으로 캡처합니다. 대규모 텐서를 효율적으로 처리하고 모듈 초기화를 인메모리에서 추적합니다.ModuleRepo는 추출된 모듈 상태를 Weights & Biases (WandB) Registry에 중앙 집중화하여 컬렉션 인덱싱 및 메타데이터와 바이너리 페이로드를 포함하는 버전화된 아티팩트로 구성합니다. Consumption Layer는 인간 엔지니어를 위한 대화형 Jupyter 확장 및 IPython CLI를 제공하고, LLM 에이전트를 위한 Agent Skills를 제공합니다.이를 통해 디버깅, 탐색 및 자율 모듈 분석 및 최적화가 가능합니다. ModuleLens는 병목 현상 식별을 위한 Training Analyzer, GPU 커널 생성 및 검증을 위한 KernelAgent, 인프라 비용 평가를 위한 Scaling Law ROI Tools를 포함한 다양한 내부 도구에 채택되었습니다.향후 계획에는 핵심 시스템 안정화, Triton/CUDA 커널 합성과 같은 고급 최적화를 위한 Agent Skills 강화, 자율 학습 및 서빙 최적화 활성화가 포함됩니다. ModuleLens는 인간 엔지니어링 속도를 높이고 모델 자동 연구 및 재귀적 자체 개선을 위한 실행 기반을 제공하는 것을 목표로 합니다.격리된 모듈 및 성능 신호에 대한 재현 가능한 액세스를 제공함으로써 ModuleLens는 에이전트가 실험하고, 구성 요소를 수정하고, 벤치마킹하고, 성공적인 변경 사항을 유지할 수 있도록 지원합니다. 이 프로젝트는 리더십, 설계 통찰력, 테스트, 채택 및 코드 개발에 대한 Product ML Infra, ATG, HomeFeed 및 Ads ranking 팀의 수많은 기여자를 인정합니다.
CdXz5zHNQW_NEug4e7mVW.png
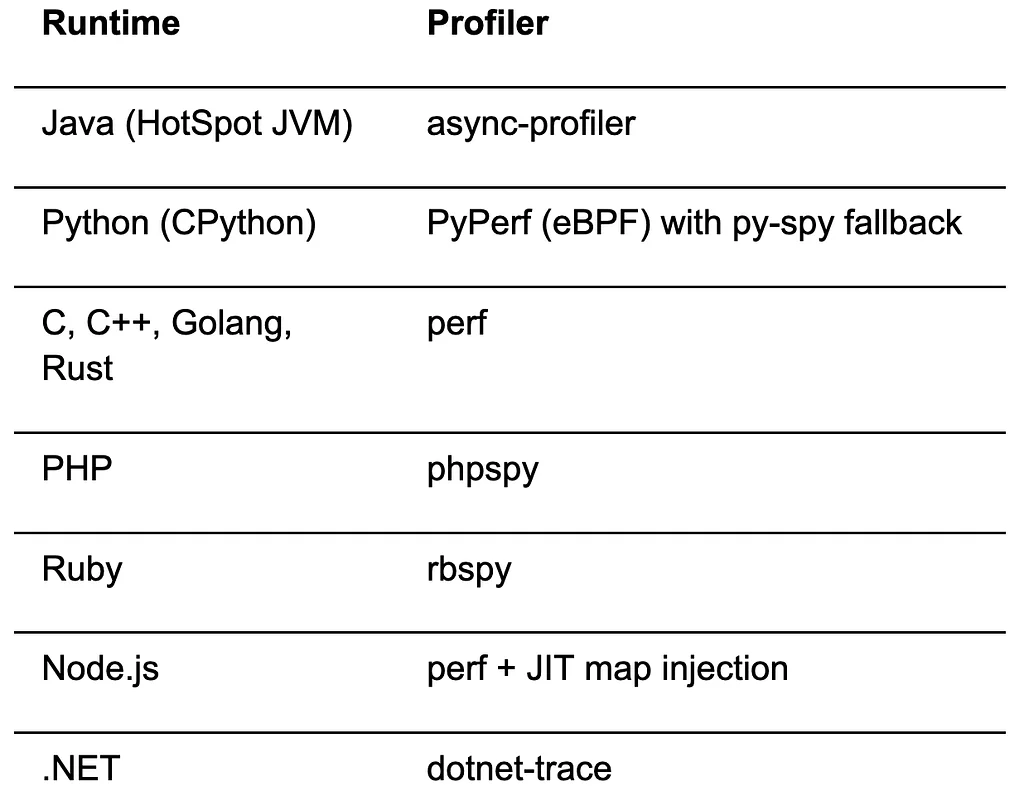
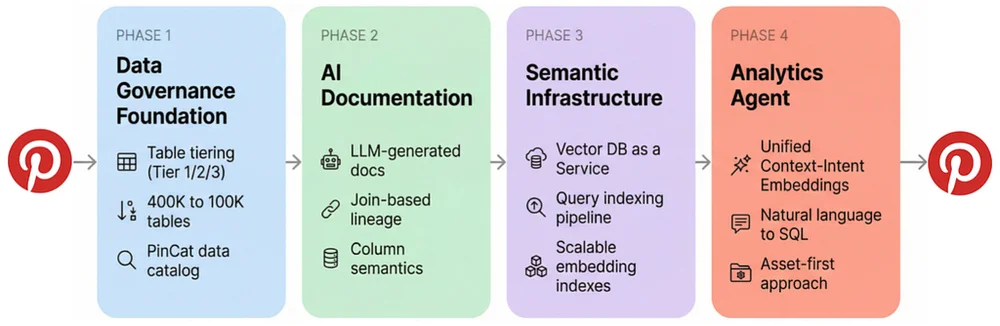
6억 4천만 명의 사용자를 보유한 Pinterest는 프로파일링을 통해 인프라 효율성을 개선하기 위해 Intel과 협력했습니다. 초기에는 파편화된 프로파일링 도구와 통합되고 확장 가능한 솔루션의 필요성이라는 문제에 직면했습니다. 그들은 원래 Intel의 전 자회사인 Granulate에서 개발한 오픈 소스 gProfiler를 개선하기로 결정했습니다. 이 협력은 대규모 클라우드 환경을 위한 강력한 프로파일링 시스템을 만드는 것을 목표로 했습니다.Pinterest와 Intel은 동적 프로파일링을 추가하여 gProfiler를 확장하여 주문형 프로파일링 세션을 가능하게 했습니다. 그들은 캐시 동작 및 CPU 스톨과 같은 세부 정보를 캡처하는 하드웨어 원격 측정을 위해 Intel PerfSpect를 통합했습니다. CPU 플레임 그래프가 놓치는 I/O 또는 잠금 경합으로 인한 지연 시간을 감지하기 위해 월 타임 프로파일링이 도입되었습니다. 또한 함수를 하드웨어 이벤트에 연결하기 위해 PMC 플레임 그래프를 추가하고 대규모에서 효율성을 보장하기 위해 프로덕션 강화 수정 사항을 기여했습니다.파트너십은 공급업체 종속을 피하고 협업을 촉진하기 위해 오픈 소스 접근 방식에 중점을 두었습니다. gProfiler는 여러 언어별 프로파일러를 조정하여 통합된 플레임 그래프를 생성하여 시스템 활동에 대한 포괄적인 보기를 제공합니다. Pinterest가 파트너십을 결정한 이유는 이러한 복잡한 도구를 처음부터 구축하는 것이 엄청날 것이라는 인식과 Intel의 하드웨어 전문 지식이 심층적인 병목 현상 분석에 중요했기 때문입니다.gProfiler와 백엔드인 gProfiler Performance Studio의 오픈 소싱은 Pinterest에 기반을 제공했습니다. Pinterest는 이후 리소스 소비 및 데이터 수집과 관련된 안정성 문제를 해결하기 위해 전체 시스템에 gProfiler 에이전트를 배포했습니다. 그들의 상당한 기여에는 전체 시스템에 대한 주문형 프로파일링을 가능하게 하는 동적 프로파일링 기능이 포함됩니다.이러한 기여는 월별 시간 프로파일링 및 하드웨어 이벤트 기반 플레임 그래프와 같은 추가 기능을 잠금 해제했습니다. gProfiler 아키텍처는 각 노드에서 데이터 수집을 위한 에이전트와 집계 및 시각화를 위한 백엔드로 구성됩니다. 에이전트는 다양한 언어 프로파일러를 조정하여 애플리케이션 코드 수정 없이 통합된 보기를 제공하는 병합된 스택 추적을 생성합니다. 백엔드 마이크로서비스는 프로파일 수집, S3에 저장, ClickHouse에 인덱싱, React 프런트엔드를 통한 시각화를 처리합니다.
CdXz5zHNQW_4O814w3FCn.png
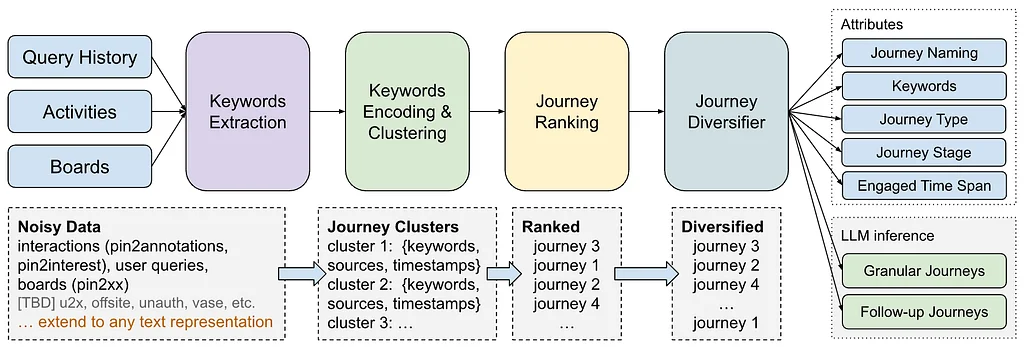
Pinterest는 특정 관심사와 의도와 관련된 상호작용의 연속인 '여정(journeys)'이라고 불리는 사용자의 장기적인 목표를 이해하는 것을 목표로 합니다. 이는 단일 클릭을 기반으로 다음 항목을 추천하는 것을 넘어섭니다. 이러한 여정을 식별하면 더 관련성 높은 추천 및 알림을 제공하여 사용자가 프로젝트를 완료하도록 도울 수 있습니다. 초기에는 Pinterest가 키워드를 클러스터링하고 속성을 첨부하여 여정을 추론하기 위해 다단계 파이프라인을 사용했습니다. 이 레거시 시스템은 참여 지표를 개선했지만 파편화, 일반적인 분류, 관련 없는 클릭으로 인한 부수적인 노이즈로 어려움을 겪었습니다. 이러한 문제를 해결하기 위해 Pinterest는 미세 조정된 40억 개의 매개변수를 가진 대규모 언어 모델을 사용하여 여정 추론을 생성 작업으로 재구성했습니다. 이 LLM은 사용자의 연대순 활동 로그를 직접 읽고 사용자의 로케일에서 여정 이름의 순위 목록을 출력합니다. 이 LLM에 대한 프롬프트 엔지니어링은 행동 중요도, 이벤트 그룹화, 싫어요와 같은 부정적인 신호 처리 등을 정의하는 데 중요합니다. 프론티어 모델은 더 작고 프로덕션 준비가 된 학생 모델을 미세 조정하기 위한 합성 훈련 데이터를 생성하는 교사로 사용되었습니다. 40억 개의 매개변수 모델은 출력 품질과 서빙 효율성의 균형을 위해 선택되었습니다. 이러한 모델을 대규모로 서빙하는 것은 수억 명의 사용자를 효율적으로 처리하기 위해 PagedAttention 및 연속 배치와 같은 정교한 최적화를 포함합니다. 새로운 생성 시스템은 파편화된 여정을 성공적으로 통합하고, 구체적인 이름을 제공하며, 손실된 의도를 다시 도입합니다. 이 접근 방식은 Pinterest를 넘어선 개인화를 위한 일반적인 레시피를 제공하며, 순차적인 사용자 활동과 구조화된 의도 목표를 가진 플랫폼에 적용할 수 있습니다.
CdXz5zHNQW_wEiKzVPwD3.png
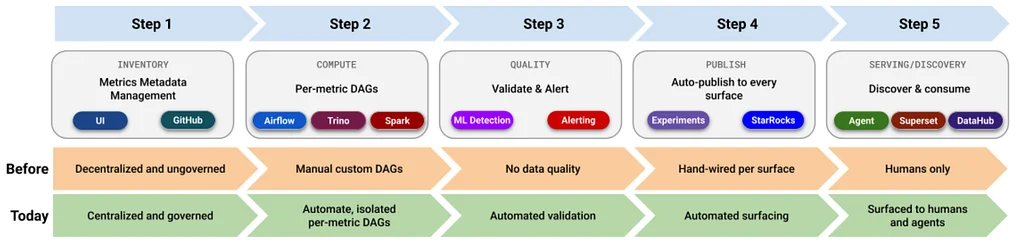
Pinterest는 비즈니스 성과부터 기능 실험에 이르기까지 모든 의사 결정에 신뢰할 수 있는 지표에 의존합니다. 수백 개의 데이터 생산자가 방대한 데이터 레이크에서 수천 개의 지표를 생성합니다. 이러한 복잡성을 관리하기 위해 Pinterest는 엔드투엔드 플랫폼인 Metrics Board를 구축했습니다. 이 플랫폼은 지표 생성을 자동화하고, 품질을 강제하며, 에이전트 기반 분석을 가능하게 합니다. 지표는 사용자 및 광고주 가치를 이해하고, 제품 결정을 내리며, 회사 전략을 예측하는 데 중요합니다. 또한 Pinterest의 대규모 제품 실험 관행을 지원하여 공정하고 통계적으로 유의미한 결과를 보장합니다.이전에는 지표가 맞춤형 데이터 파이프라인에서 정의되어 비효율성과 신뢰도 저하를 초래했습니다. Metrics Board는 지표를 통합하고, 투명한 정의를 제공하며, 파이프라인 생성을 자동화하고, 지표 검증 및 모니터링을 보장하기 위해 개발되었습니다. 목표는 모든 사용자, 애플리케이션 및 진화하는 AI 에이전트가 지표를 쉽게 사용할 수 있도록 하는 것이었습니다. Metrics Board는 Git 리포지토리에서 프로덕션 코드처럼 정의가 관리되는 시맨틱 레이어 역할을 합니다. 시스템은 YAML 사양을 생성하고 풀 리퀘스트를 열어 더 넓은 데이터 스택과 통합됩니다.Metrics Board는 예약된 Airflow DAG를 사용하여 지표 계산을 조정하고, 각 지표를 격리하여 더 나은 제어를 제공합니다. SQL을 SparkSQL 또는 PrestoSQL로 컴파일하고 종속성 작업 및 데이터 품질 검사를 자동으로 생성합니다. 백필은 Airflow를 통해 관리되며, 플랫폼은 업스트림 데이터 지연 감지와 같은 자동화된 작업을 처리합니다. 이를 통해 지표 생성 시간을 며칠 또는 몇 주에서 몇 시간으로 크게 단축할 수 있습니다.모든 정의에는 검증이 포함되어 지표 품질을 최우선으로 합니다. 이러한 검증은 명시적인 기대치를 위한 규칙 기반 검사와 ML 기반 이상 감지를 사용합니다. 검사가 실패하면 실시간으로 적절한 사람들에게 알림이 전송되며, API 및 PDF 내보내기를 통해 품질 보고서를 확인할 수 있습니다. 게시를 통해 지표는 PinCat, Helium, Superset 및 StarRocks와의 통합을 통해 사람들이 사용하는 제품에 도달합니다. 메타데이터 통합은 커밋 시점에 게시되고, 데이터 통합은 계산 후에 게시됩니다.Metrics Board는 정의 및 메타데이터를 중앙 집중화하여 검색 용이성을 촉진함으로써 검색 및 거버넌스를 지원합니다. 지표는 자동으로 데이터 카탈로그인 PinCat으로 흐릅니다. 알 수 없음부터 A+까지의 인증 등급 시스템은 소비자가 신뢰할 수 있는 지표를 식별하는 데 도움이 됩니다. 대시보드도 등급으로 분류되어 보존, 쿼리 성능 및 중요한 회사 전체 대시보드에 필요한 문서에 영향을 미칩니다. Tier 1 대시보드는 가장 중요한 집합을 나타내며, 강력한 보장을 받고 공식 인증이 필요합니다.
CdXz5zHNQW_G7lgncluYP.png
이 게시물은 Pinterest의 새로운 데이터베이스 수집 프레임워크에서 다운스트림 소비에 충분히 완료된 시점을 결정하는 솔루션을 소개합니다. Kafka, Flink, Iceberg와 같은 기술을 기반으로 구축된 이 프레임워크는 데이터를 지속적으로 처리하며, 이는 이전에 최종 처리를 위해 단일 실행 배치 작업에 의존했던 배치 작업에 어려움을 야기합니다. 시간 열로 그룹화된 시간 분할 데이터는 소비자가 전체 테이블을 스캔하지 않고 특정 슬라이스를 읽을 수 있도록 합니다. 배치 시스템에서는 프로듀서가 쓰기를 완료하면 파티션이 최종으로 간주되었습니다. 그러나 스트리밍 프레임워크는 파티션에 지속적으로 쓰기 때문에 기존의 최종 처리가 어렵습니다. 이를 해결하기 위해 Pinterest는 Flink-to-Iceberg 싱크 내에서 이벤트 시간 기반 파티션 최종 처리 메커니즘을 개발했습니다. 이 시스템은 레코드에서 이벤트 시간을 추출하고, Flink 체크포인트 간의 최소 및 최대 이벤트 시간과 같은 통계를 수집하며, 이를 Iceberg의 스냅샷 요약에 저장합니다. 그런 다음 알고리즘이 이러한 통계를 사용하여 파티션이 완료된 시점을 나타내는 워터마크를 생성하며, 이는 항상 증가하도록 보장합니다. 이 워터마크는 Iceberg 테이블 속성으로 저장되어 다운스트림 작업이 처리 트리거를 위해 이를 쿼리할 수 있도록 합니다. 이 메커니즘은 업서트 작업에 의해 기본 테이블로 전파되어 신호가 데이터와 함께 이동하도록 보장합니다. 이 구현은 확장 가능한 Iceberg-Flink 싱크 기능을 활용합니다. 누적기는 작성자 하위 작업에서 레코드 통계를 수집하고, 커밋 프로세서는 Iceberg 커밋 전후에 사용자 정의 로직을 실행합니다. 이 설계는 확장이 구성되지 않은 경우 오버헤드가 없도록 하고, 파티션 최종 처리가 스트리밍 데이터 파이프라인에 효율적으로 통합되도록 보장합니다.
CdXz5zHNQW_u1wkB0MUto.png
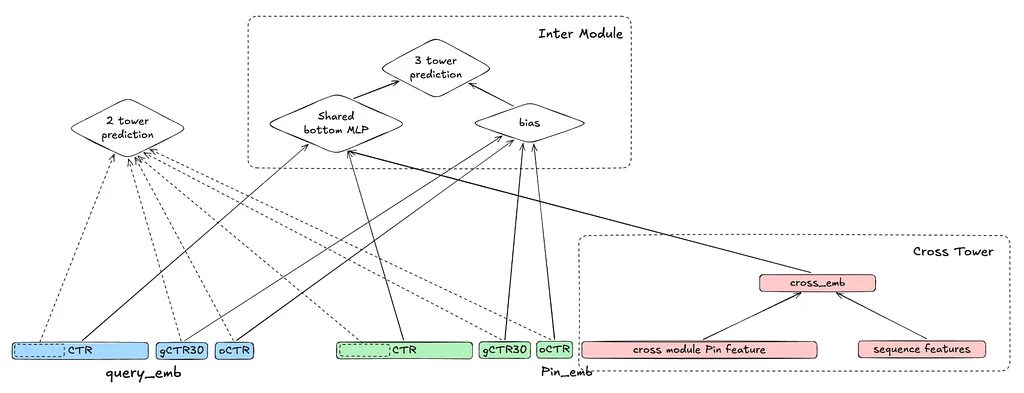
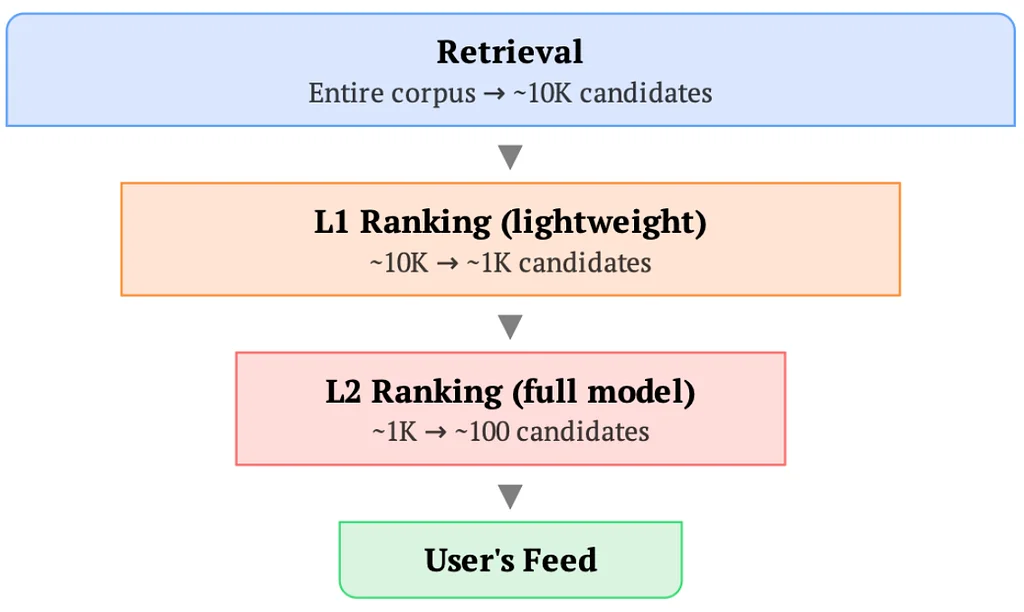
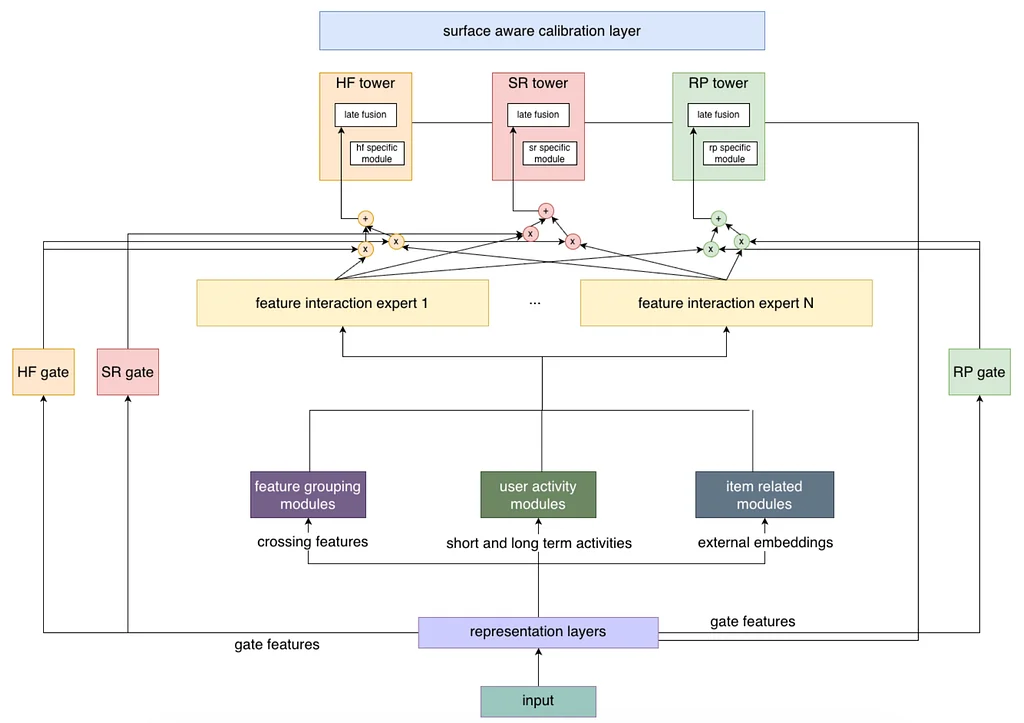
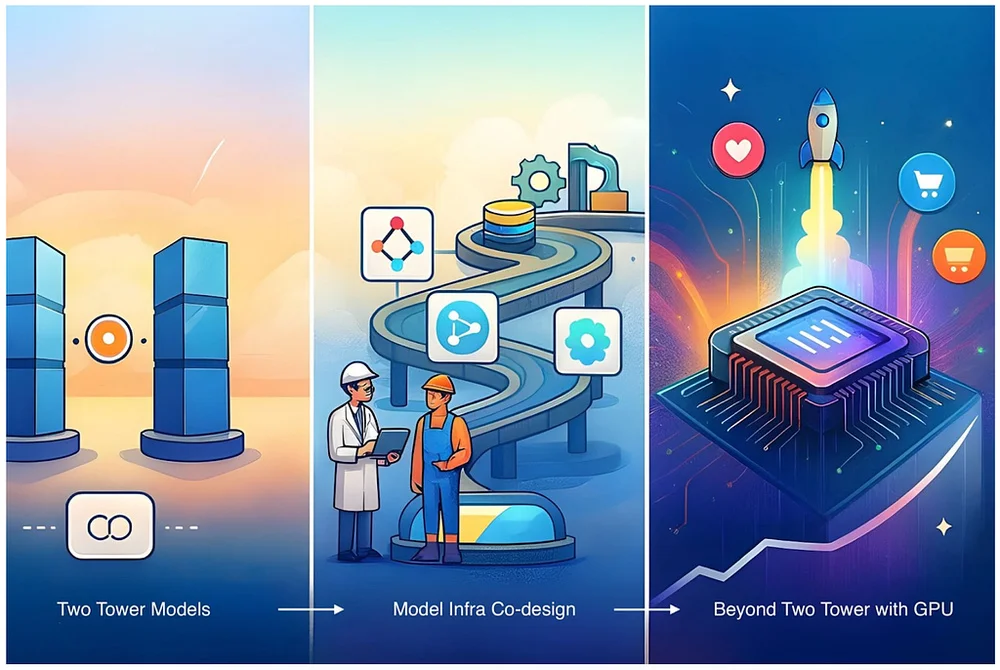
Pinterest는 Nexus라는 새로운 경량 랭킹 모델을 개발했으며, 이는 기존의 투 타워(two-tower) 아키텍처를 넘어섭니다. 이 모델은 클릭률(pCTR), 좋은 클릭률(pGCTR30), 그리고 아웃바운드 클릭률(pOCTR)을 공동으로 예측합니다. 이러한 예측을 효율적으로 지원하기 위해 각 태스크별로 임베딩이 분할됩니다. Nexus 시스템은 크로스 어텐션(cross-attention) 및 시퀀스 모델링과 같은 더 복잡한 모델 아키텍처를 가능하게 합니다. 그러나 요청당 수십만 개의 후보를 스코어링하는 것은 상당한 지연 시간 및 비용 문제를 야기합니다. 이를 해결하기 위해 빠른 투 타워 예측과 더 풍부한 쓰리 타워(three-tower) 예측을 결합한 3 타워 공동 학습 모델이 설계되었습니다.이 아키텍처는 효율적인 캐싱 및 내적(dot-product) 예측을 위해 원래의 쿼리 및 핀(Pin) 타워를 유지합니다. 사용자 시퀀스와 후보 피처 간의 어텐션을 사용하는 세 번째 크로스 타워와 이러한 임베딩을 결합하는 인터 모듈(inter module)을 도입합니다. 이 모델은 공동으로 학습되어 모든 후보에 대한 빠른 스코어와 일부에 대한 더 정확한 스코어를 가능하게 합니다. 이 접근 방식은 컴퓨팅을 가장 영향력 있는 곳에 할당함으로써 성능과 지연 시간을 균형 있게 맞춥니다. 크로스 타워는 고차 상호작용을 포착하고, 인터 모듈은 모든 태스크에 대한 공유 표현을 생성합니다.학습 과정은 보조적인 투 타워 공동 학습 손실보다 주요 쓰리 타워 손실에 더 높은 가중치를 부여하는 다중 태스크 손실 함수를 사용합니다. 이를 통해 쓰리 타워 예측이 주요 최적화 목표가 되도록 하면서 빠른 투 타워 예측의 품질을 유지합니다. 계산 비용을 관리하기 위해 상당한 서빙 최적화가 구현되었습니다. 여기에는 요청당 계산을 피하기 위해 핀 타워에서 핀 피처를 사전 처리하고, BF16을 사용한 저정밀도 추론을 활용하는 것이 포함됩니다. 이러한 최적화는 P99 모델 추론 시간을 극적으로 단축하여 쓰리 타워 접근 방식을 대규모로 실용적으로 만들었습니다. 결합된 변경 사항은 상당한 오프라인 손실 감소와 긍정적인 온라인 비즈니스 지표로 이어졌습니다.
CdXz5zHNQW_1jHfrOQVr3.png
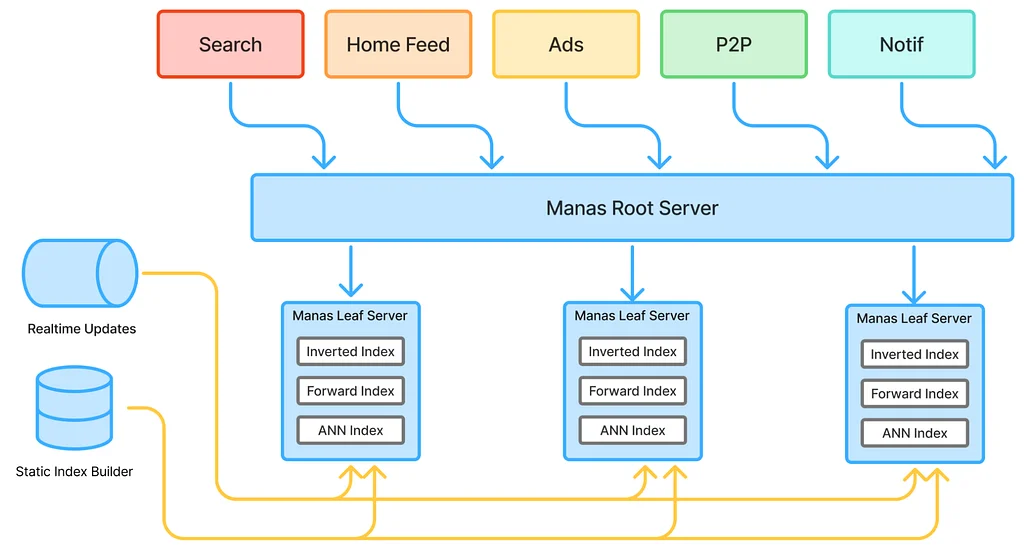
Pinterest의 검색 엔진은 사내 플랫폼인 Manas가 지원하는 임베딩 검색에 크게 의존합니다. Manas는 다양한 제품 표면에서 수십억 개의 임베딩을 지원하지만, 메모리 비용과 모델 표현력 측면에서 확장성 문제를 겪고 있습니다. 이를 해결하기 위해 세 가지 주요 이니셔티브를 통해 검색 스택을 발전시키고 있습니다. 첫째, Scalar Quantization 및 Product Quantization과 같은 양자화 기술을 사용하여 임베딩 인덱스의 메모리 사용량과 서빙 비용을 크게 줄입니다. 둘째, SSD 기반 서빙, 특히 PQ 양자화를 사용한 SPANN을 구현하여 고가의 RAM에서 인덱스를 이동시키면서도 낮은 지연 시간을 유지합니다. 이 접근 방식은 인메모리 솔루션에 비해 메모리 사용량과 CPU 비용을 극적으로 줄입니다. 셋째, Manas는 제한적인 투 타워 모델에서 멀티 임베딩 검색으로 전환하여 더 풍부한 점수 함수와 더 미묘한 유사성 평가를 가능하게 합니다. 이러한 전환은 후보의 단일 벡터 표현을 넘어선 후반 상호 작용 모델을 가능하게 합니다. 향후 계획에는 SPANN 및 SPFresh를 통한 비용 최적화, 멀티 임베딩 지원 강화, GPU 기반 검색 시스템 탐색이 포함됩니다. 이러한 발전은 Pinterest를 위한 확장 가능하고 비용 효율적이며 혁신적인 임베딩 검색 아키텍처를 만드는 것을 목표로 합니다.
CdXz5zHNQW_HJwkDbk2Uz.png
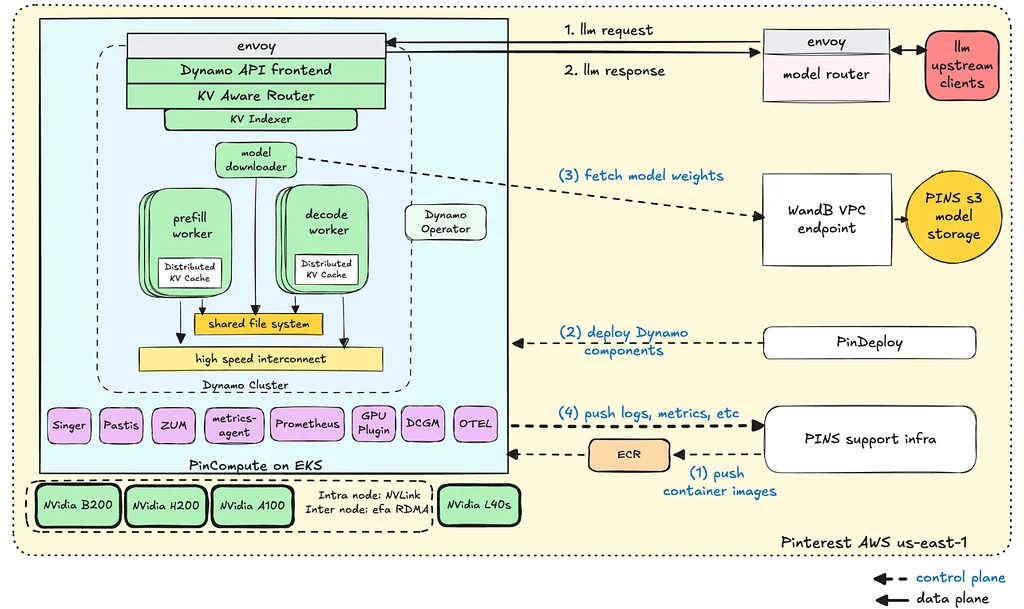
Pinterest는 비주얼 검색 및 탐색 플랫폼을 강화하기 위해 Vision-Language Models(VLM)을 활용합니다. 이러한 모델은 Pinterest Assistant 및 하이브리드 검색과 같은 새로운 기능을 지원하는 데 중요합니다. Pinterest는 특정 제품 및 규모 요구 사항을 충족하기 위해 오픈 소스 VLM을 맞춤화합니다. VLM을 제공하는 것은 여러 이미지와 더 큰 KV 캐시를 처리하는 것을 포함하여 기존 텍스트 전용 LLM을 넘어서는 고유한 과제를 제시합니다. 이를 해결하기 위해 Pinterest는 NVIDIA Blackwell GPU 및 NVIDIA Dynamo를 기반으로 VLM 제공 스택을 구축했습니다. Blackwell GPU는 까다로운 AI 워크로드에 대해 뛰어난 컴퓨팅 처리량과 메모리 용량을 제공합니다. Dynamo는 전체 제공 경로에 걸쳐 멀티모달 추론을 최적화하기 위한 분산 오케스트레이션 계층을 제공합니다. VLM에 대한 요청 페이로드는 이미지 다운로드, 사전 처리 및 프롬프트 구성을 필요로 하여 더 복잡합니다. VLM 제공의 사전 채우기 단계는 종종 지배적이고 계산 비용이 많이 들기 때문에 고급 캐시 관리가 필요합니다. 다중 턴 VLM 상호 작용은 시각적 컨텍스트의 변화와 더 무거운 사전 채우기 요구 사항으로 인해 제공을 더욱 복잡하게 만듭니다. KV 캐시 메모리 압력을 관리하는 것은 KV 인식 라우팅 및 오프로딩과 같은 전략이 필요하므로 중요합니다. Pinterest의 솔루션은 분산 사전 채우기 및 디코딩, LMCache를 사용한 KV 캐시 오프로딩, Dynamo 및 vLLM 내의 멀티모달 지원을 활용합니다. 또한 대규모 시각적 컨텍스트 처리 비용을 줄이기 위해 사용자 정의 프로젝션 임베딩을 구현했습니다. 이 최적화된 VLM 제공 스택은 성능을 크게 향상시켜 Time-to-First-Token에서 상당한 이득을 보여줍니다.
CdXz5zHNQW_ydHVPNTidy.png
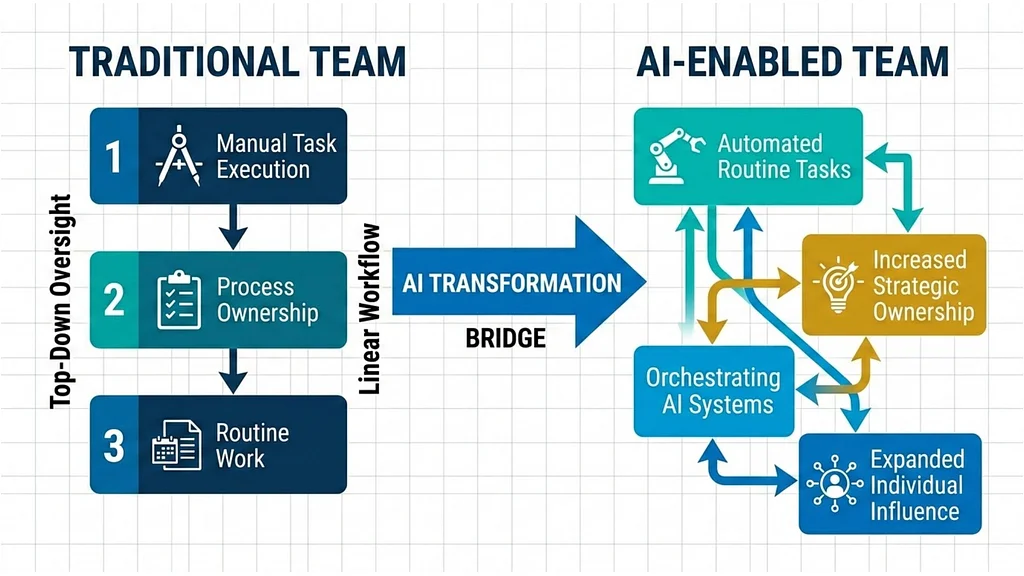
AI 팀으로의 전환은 단순히 AI 도구를 사용하는 것을 넘어 운영 모델, 철학, 역할의 근본적인 변화를 요구합니다. 팀원들은 자동화와 분석을 위해 AI를 활용하여 더 높은 수준의 사고에 집중하는 역량 있는 전략가이자 문제 해결사가 됩니다. 이러한 진화는 이전에는 해결하기 어려웠던 문제들을 해결 가능하게 만들고 엔지니어링 작업의 본질을 극적으로 변화시킵니다. Pinterest의 인프라 팀은 신뢰성과 효율성을 확장하기 위한 필요성에 따라 이러한 변화에 적응하고 있습니다. 접근 가능한 AI 도구는 성능 한계를 크게 높여 코드베이스 리팩토링과 같은 복잡한 프로젝트를 몇 달 대신 며칠 만에 완료할 수 있게 합니다. 이러한 확장된 역량은 실현 가능성이 전략적 일치와 동일하지 않기 때문에 더욱 중요한 전략적 우선순위 설정을 필요로 합니다. 엔지니어는 실행에서 전략적 사고, 문제 정의, 사용자 요구 검증으로 전환하며 AI를 포스 멀티플라이어로 사용할 것입니다. 관리자는 프로세스 강제에서 전략적 지침으로 전환하여 비전, 영향력 극대화, 인재 개발에 집중할 것입니다. Pinterest는 데이터 탐색, 콘텐츠 생성, 인프라 개선을 위해 적극적으로 AI를 구현하고 있습니다. 고성능 팀의 미래는 인간 전문성과 기계 지능 간의 공생 관계와 본질적으로 연결되어 있습니다. 팀은 경쟁력과 혁신성을 유지하기 위해 이러한 문화적 변화를 수용해야 합니다. AI 통합은 팀 역량을 증가시켜 기술 개발과 도구 활용 극대화에 필요한 잉여를 창출합니다. AI 기반 환경으로의 전환은 복잡하고 격동적이므로 리더십은 정보의 홍수를 헤쳐나가고 팀을 효과적으로 안내해야 합니다.
CdXz5zHNQW_hKF1eaOw11.png
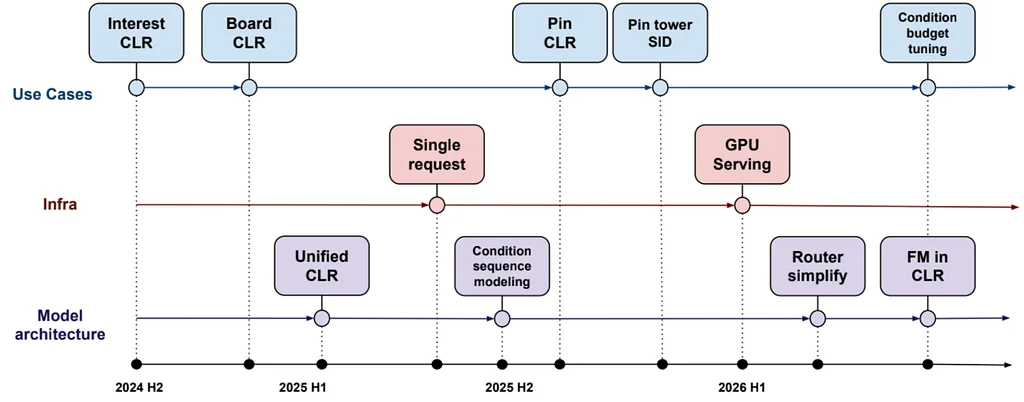
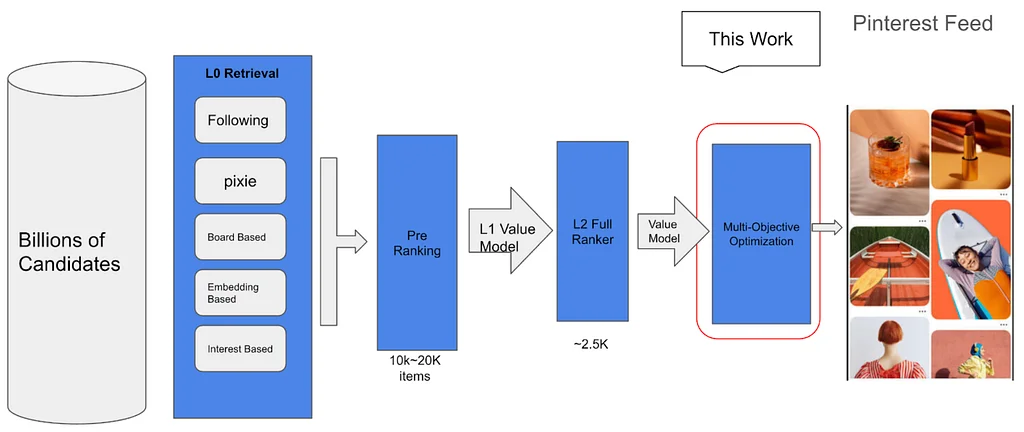
Pinterest의 홈 피드는 추천 시스템을 개선하여 사용자에게 관련성 높은 핀을 제공하는 것을 목표로 합니다. 초기에는 사용자와 아이템을 별도로 인코딩하는 투 타워 모델이 사용되었지만, 사용자의 다양한 관심사를 처리하는 데 어려움이 있었습니다. 이를 해결하기 위해 명시적인 검색 컨텍스트에 대한 사용자 임베딩을 조건화하는 Conditional Learned Retrieval(CLR)이 개발되었습니다. 이전 연구에서는 알림을 위한 CLR 부트스트래핑과 홈 피드를 위한 멀티 임베딩 프레임워크에 통합하는 것을 탐구했습니다. 이 블로그는 Pinterest 홈 피드를 위한 더 넓은 검색 시스템으로 CLR이 발전한 과정을 자세히 설명합니다.CLR은 관심사, 핀, 보드와 같은 새로운 조건 유형을 통합하여 다양한 검색 후보를 지원하도록 확장되었습니다. 관심사 조건은 처음에 사용자 신호에서 부트스트래핑되었고 나중에 LLM 생성 관심사로 강화되었습니다. 핀 조건은 참여한 핀을 클러스터링하고 임베딩으로 표현하여 CLR이 레거시 생성기를 대체할 수 있도록 했습니다. 보드 조건은 핀-보드 그래프에서 랜덤 워크를 사용하고 보드를 임베딩으로 표현하여 생성되었습니다.모델 기반은 시퀀스 모델링과 개선된 조건 표현을 사용하여 확장되었습니다. Conditioned User Sequence Transformer는 사용자 행동과 조건 토큰을 함께 인코딩하여 CLR을 시퀀스 인식하도록 도입되었습니다. 이는 전역 사용자 시퀀스에 대해 훈련된 대규모 트랜스포머를 통합하는 Foundation Model 기반 CLR 아키텍처로 발전했습니다. 이 기반 모델은 사용자 및 아이템 타워 모두에 대해 공유 핀 임베딩을 사용하고 대조 정렬 손실을 통합합니다.단일 모델 내에서 이기종 조건을 처리하기 위해 조건 표현이 통합되어 중복 작업을 줄였습니다. Unified CLR은 다양한 조건 유형을 하나의 모델로 통합하여 여러 조건을 수락하고 누락된 기능을 대체했습니다. 라우터 단순화는 라우팅 로직을 다양한 임베딩 유형에 대한 사전 정의된 슬롯을 가진 조건 불가지론적 슬롯 아키텍처로 리팩토링하는 것을 포함했습니다.CLR의 훈련 효율성은 훈련 처리량을 두 배로 늘린 무손실 인프라 최적화를 통해 향상되었습니다. 요청 수준 훈련은 배치 내에서 동일한 사용자 기능을 중복 제거하며 추가 최적화가 진행 중입니다. 이 시스템은 이제 프로덕션 규모에서 다중 조건 검색을 효율적으로 처리하여 더 다양하고 관련성 높은 콘텐츠를 통해 사용자 참여를 개선합니다.
CdXz5zHNQW_6wtn6E8XMD.png
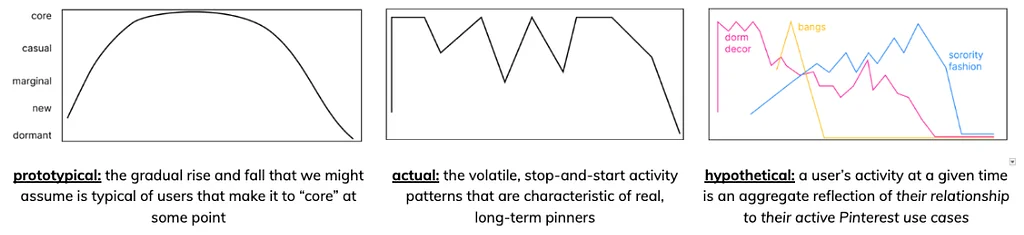
Pinterest는 추천 시스템을 통해 사용자가 더 나은 삶을 위한 영감을 발견하도록 돕는 것을 목표로 합니다. 주요 발견 플랫폼인 홈 피드는 추천을 위해 다단계 파이프라인을 활용합니다. 이전에는 클릭 및 저장과 같은 참여 지표에 최적화가 집중되었습니다. 그러나 참여와 유지는 다르며, 참여만을 최적화하면 사용자 이탈로 이어질 수 있습니다.이 게시물은 사용자의 변화하는 요구를 이해함으로써 사용자 유지에 우선순위를 두는 프로그램인 Pinner Progression을 소개합니다. 핵심 아이디어는 순차적인 사용자 이해와 지속적인 사용 사례 표현을 결합하는 것입니다. 이 접근 방식은 사용자 행동을 예측하고 우연한 발견을 촉진하는 추천을 제공하는 데 도움이 됩니다. 도입된 핵심 신호는 사용자가 참여하는 뚜렷한 사용 사례를 나타내는 User Interest Clusters(UICs)입니다.지속 가능한 성장은 단기적인 참여뿐만 아니라 특정 사용 사례와의 지속적인 사용자 관계 구축에 달려 있습니다. 분석에 따르면 사용 사례 채택은 지속적인 참여 및 유지와 상관관계가 있습니다. 현대 추천 시스템은 현재 사용자 선호도를 이해하는 데 뛰어나지만 이러한 선호도의 수명 주기를 모델링하는 데 어려움을 겪습니다. 사용자의 활성 "아파트 장식" 단계와 쇠퇴하는 "사워도우" 단계를 구별하는 것은 장기적인 유지에 중요합니다.UIC 표현은 PinnerSage 및 OmniSage와 같은 과거 작업 위에 구축됩니다. 참여 콘텐츠에만 클러스터를 개인화하여 사용자당 동적 클러스터 수를 허용함으로써 혁신합니다. 중요하게도 각 UIC에는 상태 저장 수명 주기 메타데이터가 포함되어 시간적 및 행동적 통찰력을 제공합니다. 이 메타데이터는 사용자의 관심 성숙도를 추론하는 데 도움이 되며, 덧없는 호기심과 새로운 습관을 구별합니다.UICs는 OmniSage 임베딩 공간 내의 메도이드 및 랜드마크 핀으로 정의되며, 여기서 가까움은 기능적 유용성을 의미합니다. 신호 구성은 사용자의 최근 참여 임베딩의 계층적 클러스터링을 포함합니다. 완전 연결 알고리즘은 가장 유사하지 않은 쌍의 유사성을 기반으로 클러스터를 병합하며, 유사성 임계값이 있습니다. 이 프로세스는 더 이상 남은 쌍이 임계값을 초과하지 않거나 최대 클러스터 수에 도달할 때까지 중지됩니다.시스템 수준 통합은 검색, 순위 및 블렌딩 단계의 추천 파이프라인 전반에 걸쳐 공유 추상화로 UIC를 사용하는 것을 포함합니다. 이를 통해 다양한 시스템 구성 요소가 사용자 관심의 성숙도를 추론할 수 있습니다. UIC는 효율성을 위해 공유 기능 저장소로 외부화되어 여러 신호 검색과 관련된 지연 시간을 줄입니다. 향후 작업에는 시간적 역학을 보존하는 장기 시퀀스 표현으로 UIC를 확장하는 것이 포함됩니다. 검색은 첫 번째 통합 지점으로, Conditional Learned Retrieval은 의미론적 관련성을 보장하기 위해 사용자 정보와 조건을 사용하여 후보를 생성합니다.
CdXz5zHNQW_3eUbsaOfmV.png
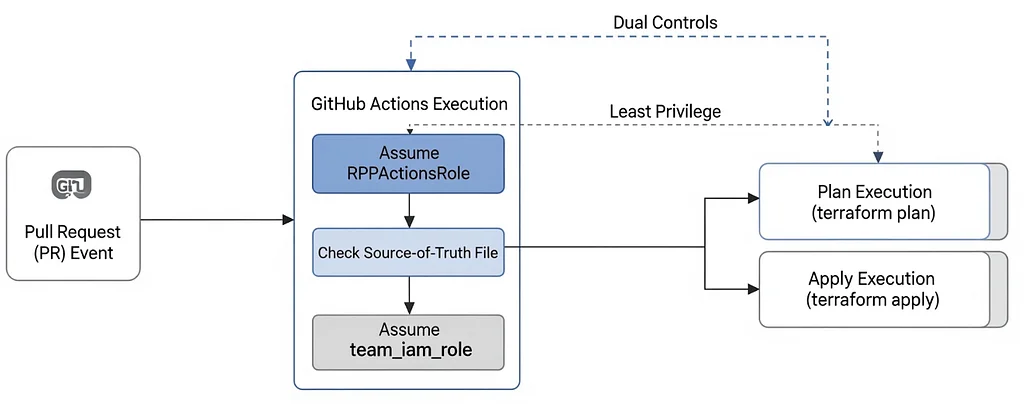
Pinterest와 같이 크고 분산된 조직에서 Infrastructure as Code를 관리하는 것은 상당한 보안 및 물류상의 난관을 제시합니다. 이를 해결하기 위해 Pinterest는 독점적인 Terraform 실행 엔진인 Resource Provisioner Pipeline(RPP)을 개발했습니다. RPP는 여러 리포지토리 설정 내에서 중요 및 비중요 인프라 변경 사항 모두를 안전하게 관리합니다. 이 시스템은 이중 제어, 중앙 집중식 GitHub Actions 및 안전한 역할 체이닝을 통해 글로벌 AWS 운영에 대한 규정 준수와 강력한 보안을 제공합니다. RPP는 수백 개의 Terraform 워크스페이스를 관리하며, 보안 정책, 네트워킹 및 컴퓨팅을 포함한 수만 개의 AWS 리소스를 제어합니다. RPP GitHub 워크플로는 PR 이벤트에 의해 트리거되는 중앙 집중식 실행 모델에서 작동합니다. 이는 복합 GitHub Actions를 사용하고 각 워크스페이스에 대한 계획을 독립적으로 실행하여 워크스페이스 영향을 격리합니다. 이중 제어는 코드 검토자의 승인을 요구하는 필수적인 인간 검토 계층을 추가합니다. 최소 권한을 시행하기 위해 RPP는 안전한 역할 체이닝을 사용하여 엄격한 워크스페이스-경로-역할 매핑을 구현합니다. 프로세스는 GitHub OIDC를 통해 인증된 중앙 집중식 RPPActionsRole을 가정하는 것으로 시작됩니다. 그런 다음 워크스페이스 속성을 결정하고 허용된 리포지토리, 경로 및 실행 역할에 매핑합니다. 중요한 백엔드 유효성 검사는 코드 경로가 지정된 워크스페이스에 대해 올바른 S3 상태 백엔드 및 KMS 키를 엄격하게 참조하도록 보장합니다. 유효성 검사가 통과하면 RPPActionsRole은 최소 권한을 보장하는 축소된 팀 IAM 역할을 가정합니다. 배포 프로세스에는 린팅, PR에 대한 출력과 함께 계획, 그리고 특정 주석에 의해 트리거되는 의도적인 적용이 포함됩니다. 이 접근 방식은 통합 감사, 즉각적인 시스템 패치 및 중앙 집중식 리소스 메트릭과 같은 이점을 제공합니다.
CdXz5zHNQW_ggFzV94AMK.png
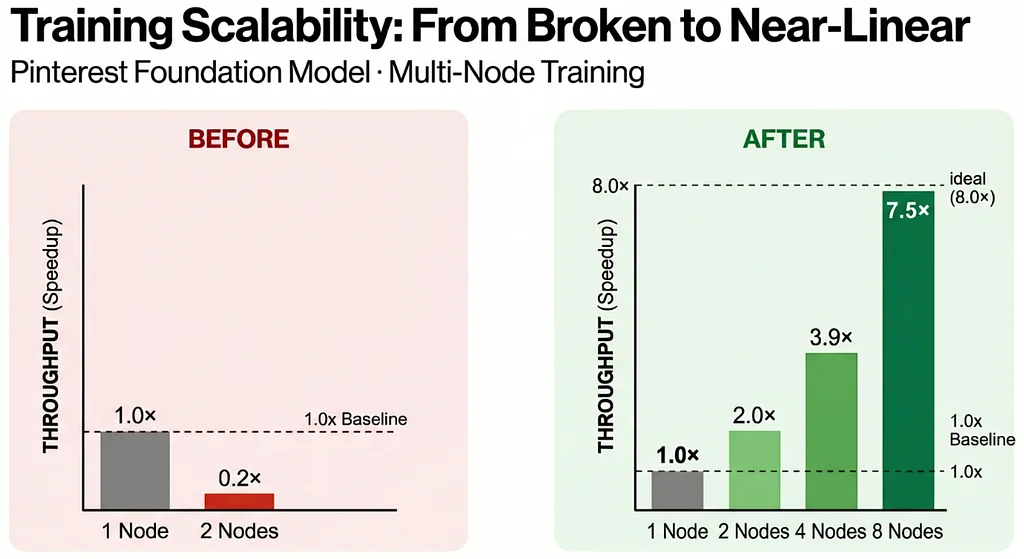
Pinterest의 기반 모델은 수백만 명의 사용자에게 매일 영향을 미치는 추천 시스템에 매우 중요합니다. 초기에는 이러한 대규모 모델의 멀티 노드 학습 성능이 저조했으며, 머신을 추가할수록 프로세스가 현저히 느려졌습니다. 네트워킹 개선을 위해 AWS Elastic Fabric Adapter(EFA)를 사용했음에도 불구하고 확장성은 비효율적이었습니다. 프로파일링 결과, 분산 임베딩 조회(distributed embedding lookups)가 상당한 통신 병목 현상을 유발했으며, GPU는 데이터 대기를 해야 했습니다. 팀은 이러한 통신 오버헤드를 해결하기 위해 여러 최적화를 구현했습니다. 양자화 통신(Quantized Communications, QComms)은 임베딩 텐서를 압축하여 데이터 페이로드를 줄였습니다. 균형 잡힌 샤딩(Balanced sharding)은 GPU 간 워크로드 분산을 개선했습니다. 대역폭 인식 임베딩 최적화(Bandwidth-aware embedding optimization)는 임베딩 차원을 절반으로 줄여 데이터 이동을 감소시켰습니다. 주요 돌파구는 2D 병렬 처리(2D Parallelism)를 구현한 것으로, 초기에는 AllReduce를 최적화하여 로컬 통신을 개선했습니다. 마지막으로, 2D 병렬 처리 토폴로지를 뒤집어 All-to-All을 최적화하여 노드 내에서 비싼 연산을 유지하고 저렴한 AllReduce를 노드 간 동기화에 사용했습니다. 이는 거의 선형적인 확장을 가능하게 하여 2개 노드에서 2.0배, 4개 노드에서 3.9배, 8개 노드에서 인상적인 7.5배의 확장을 달성했습니다. 이러한 발전은 더 큰 모델을 학습할 수 있게 하여 Pinterest 추천 표면에서의 사용자 참여도 향상과 더 빠른 실험 주기를 가져왔습니다.
CdXz5zHNQW_MsiwuAmomZ.png
Pinterest는 Kafka 기반 CDC 수집 플랫폼을 위해 강력하고 자동화된 스키마 진화 프레임워크를 개발했습니다. 스키마 변경은 중요한 시스템 간 계약이며, 검증되지 않은 진화는 파이프라인 실패와 데이터 불일치를 초래할 수 있습니다. 이들의 솔루션은 스키마 진화를 다단계 수렴 프로세스로 취급하여 안전하고 반복 가능하며 확장 가능하게 만드는 데 중점을 둡니다. 아키텍처는 CDC 소스, Kafka, 변환을 위한 Flink, Iceberg 테이블로의 upsert를 위한 Spark를 포함합니다.핵심 구성 요소는 안정적인 숫자 식별자를 가진 스키마 정의 파일을 진실의 원천으로 사용하는 신뢰할 수 있는 온보딩 모델입니다. 업데이트는 버전 관리 및 감사 기능이 있는 PR 기반 롤아웃을 통해 Kafka, Flink, Spark 및 Iceberg 전반에 걸쳐 자동으로 전파됩니다. 이 시스템은 주로 후방 호환성을 유지하고 복잡성을 최소화하기 위해 추가적인 스키마 변경을 지원합니다. 타입 변경은 숫자 정밀도 확장과 같이 의미론적 의미를 보존하는 것으로 엄격히 제한됩니다.스키마 진화는 파이프라인 가용성을 유지하기 위해 3단계 수렴 모델을 통해 관리됩니다. 1단계는 Iceberg 스키마를 업데이트하고, 2단계는 업데이트된 Flink 및 Spark 코드를 배포하며, 3단계는 데이터 수렴을 보장합니다. 이 단계적 접근 방식은 스키마 전파와 데이터 정확성을 분리하여 정의된 SLA 내에서 일시적인 편차를 허용합니다. Pinterest는 예측 가능성과 운영 안전을 우선시하는 SLA 기반 모델을 스키마 진화에 사용합니다.데이터 손실을 방지하기 위해 배포 전략, 특히 Flink의 배포 전략은 신중하게 관리됩니다. 기본값 또는 기본 키 변경과 같이 지원되지 않거나 모호한 경우는 특정 수동 복구 경로를 가집니다. 모호한 CREATE TABLE diff는 텍스트 변경에서 의도를 추론하는 대신 데이터베이스의 실제 DDL 기록과 비교하여 해결됩니다. 동시 스키마 변경은 경쟁 조건을 방지하기 위해 순차적으로 처리되어 직렬화된 수렴을 보장합니다. 열 변환은 필요한 변환으로 스키마를 주석 처리하여 관리되며, 이는 수집 파이프라인에 주입됩니다. 오류 처리 및 복구 메커니즘, 특히 Spark 실패의 경우, 마지막 성공한 워터마크부터 처리가 재개되도록 합니다.
CdXz5zHNQW_srAU1TSiiq.png
CdXz5zHNQW_ofSjTVKPmX.png
엔지니어들은 AI 에이전트를 사용할 때, 특히 사용자 정의 스킬을 호출해야 할 때 신뢰성 문제를 겪고 있습니다. 이를 해결하기 위해 특정 iOS 아키텍처 스킬을 사용하는 에이전트에 대한 테스트가 수행되었습니다. 목표는 스킬 호출의 신뢰성을 정량화하고 최적화 기법을 식별하는 것이었습니다. 핵심 테스트 도구는 Bash 스크립트를 기반으로 구축되었으며, 이는 프롬프트를 사용하여 자동화된 테스트를 조율하고 로그를 캡처하며 결과를 확인했습니다. 스킬 호출 능력을 평가하기 위해 긍정 및 부정 테스트 케이스가 정의되고 사용되었습니다. 로그 파싱 기법은 JSON 출력 패턴을 기반으로 스킬 호출을 감지하기 위해 구현되었습니다. 성공률 및 정확도와 같은 주요 성능 지표는 에이전트의 성능을 평가하기 위해 계산되었습니다. 초기 테스트 결과, 두 에이전트 모두 스킬 호출율이 완벽하지 않았으며, 특히 모호한 프롬프트에서 그러했습니다. 스킬 설명 강화, 공격적인 언어 사용, 스킬 테이블 추가를 포함한 여러 최적화 기법이 발견되었습니다. 여러 기법을 결합하면 특히 Codex 에이전트의 경우 개선된 결과를 제공했습니다. 결론적으로 스킬 호출 프로세스의 테스트 및 개선의 중요성이 강조되었습니다. 개발자는 AI 에이전트의 효과를 극대화하기 위해 고품질의 철저한 프롬프트를 사용해야 합니다.
CdXz5zHNQW_AFL9DXaCyE.png
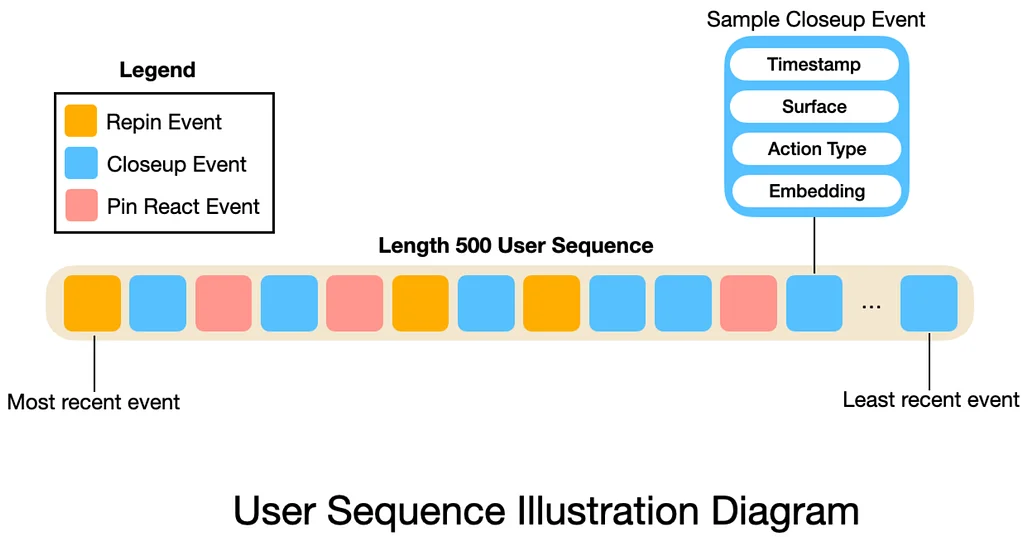
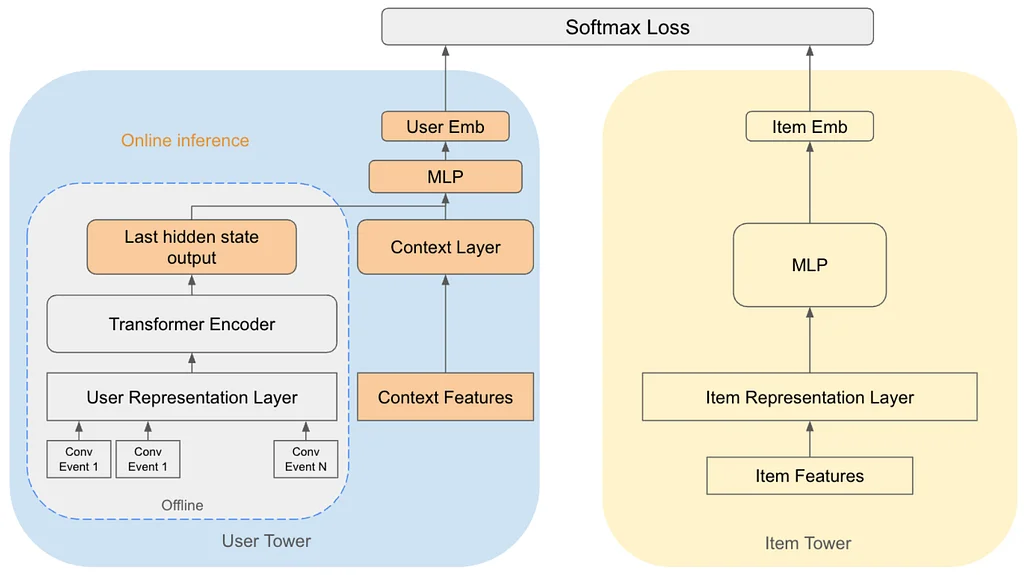
저자들은 Pinterest의 광고 추천, 특히 관련 핀(Related Pins)과 같이 맥락에 특화된 표면에서의 추천을 개선하기 위해 Contextual Sequential Two Tower Model을 개발했습니다. 초기 모델은 실시간 맥락이 부족하여 과거 사용자 행동에만 의존했기 때문에 효과가 제한적이었습니다. 이를 해결하기 위해 모델 아키텍처에 맥락 레이어(context layer)를 통합하여 모델이 사용자의 현재 활동 정보를 통합할 수 있도록 했습니다. 훈련 중에는 전환 이벤트에서 파생된 의사 맥락(pseudo-context)을 주입하여 모델을 학습시키기 위해 합성 데이터를 사용했습니다. 하이브리드 서빙 흐름(hybrid serving flow)을 채택했는데, 사용자 타워(user tower) 처리의 대부분은 오프라인으로 수행되지만 맥락 레이어는 온라인으로 처리됩니다. 이를 통해 실시간 맥락의 영향을 받는 동적 사용자 임베딩(dynamic user embeddings)이 가능해져 관련성이 향상됩니다. 오프라인 평가에서는 이전 프로덕션 모델에 비해 Recall@K에서 상당한 개선을 보였습니다. 새로운 모델은 후보 생존율(candidate survival rates)을 높이고 광고 관련성을 개선했으며, 특히 관련 핀 표면에서 이러한 효과가 두드러졌습니다. 이는 광고 지출 대비 수익률(Return on Ad Spend, ROAS)을 포함한 측정 가능한 전환 관련 비즈니스 지표의 증가로 이어졌습니다. 향후 작업에는 검색(Search)과 같은 다른 표면으로 모델을 확장하고 교차 주의(cross-attention)와 같은 고급 융합 기법을 실험하는 것이 포함됩니다. 이 연구는 광고 관련성과 사용자 경험을 향상시키기 위해 실시간 맥락을 통합하는 것의 중요성을 보여줍니다.
CdXz5zHNQW_rmxcXIRNOK.png
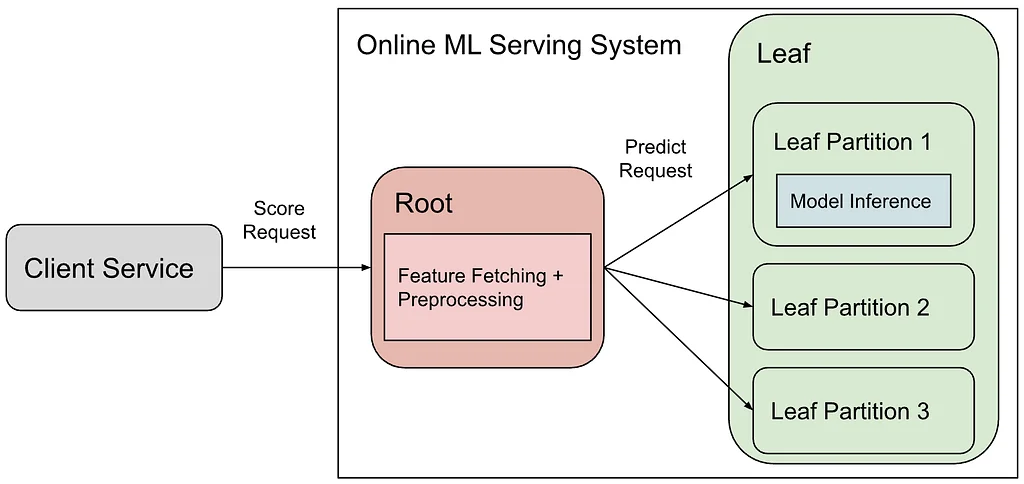
Pinterest의 온라인 ML 서빙 시스템은 클라이언트 서비스가 Pin에 대한 점수를 요청하는 루트-리프 아키텍처를 사용합니다. 루트 컴포넌트는 피처 검색 및 전처리를 담당하고, 리프는 종종 GPU에서 모델 추론을 수행합니다. 이 설계는 새로운 모델의 온보딩을 단순화하고 CPU 및 GPU 워크로드를 분리하여 리소스 활용을 최적화합니다. 그러나 많은 피처를 전달함으로 인해 루트와 리프 파티션 간의 네트워크 병목 현상이 발생했습니다.초기에는 lz4 압축을 구현하여 네트워크 사용량을 줄였고, 상당한 대역폭 절감 효과를 얻었지만 CPU 사용량과 지연 시간이 약간 증가했습니다. 이는 좋은 시작이었지만, 불필요한 피처를 전달하는 근본적인 문제는 지속되었습니다. "Send What You Use" 접근 방식은 특정 모델이 요구하는 피처만 보내도록 하여 이 문제를 해결하기 위해 개발되었습니다.모델의 입력과 출력을 정의하는 모델 시그니처는 피처 요구 사항의 진실 공급원 역할을 합니다. 모델이 훈련되고 내보내질 때, 해당 시그니처는 모델과 함께 저장됩니다. Leaften은 이러한 시그니처를 로드하여 필요한 피처만 처리하는 피처 컨버터를 구축합니다.루트와 리프 간의 피처 요구 사항을 동기화하기 위해 모델 시그니처는 경량 아티팩트로 게시됩니다. 이러한 시그니처는 번들 수준 매핑으로 집계된 다음, 기존 구성과 함께 루트에 배포됩니다. 이 배포는 모델 롤아웃과 동일한 단계적 전달 프로세스를 따르며, 일관성을 보장하고 점진적인 롤백을 가능하게 합니다.이러한 통합을 통해 Feature Trimmer는 루트의 피처 허용 목록을 동적으로 업데이트하여 필수 피처만 전송되도록 합니다. 시스템은 버전화된 조회 및 폴백 메커니즘을 사용하여 빈번한 모델 업데이트와 점진적인 롤아웃을 처리하도록 설계되었습니다. 이를 통해 루트의 피처 요구 사항에 대한 뷰는 리프에 배포된 실제 모델과 동기화된 상태를 유지합니다. 불필요한 피처를 트리밍함으로써 Pinterest는 네트워크 트래픽을 크게 줄이고 인프라 효율성을 향상시켰습니다.
CdXz5zHNQW_Pr67hugpQp.png
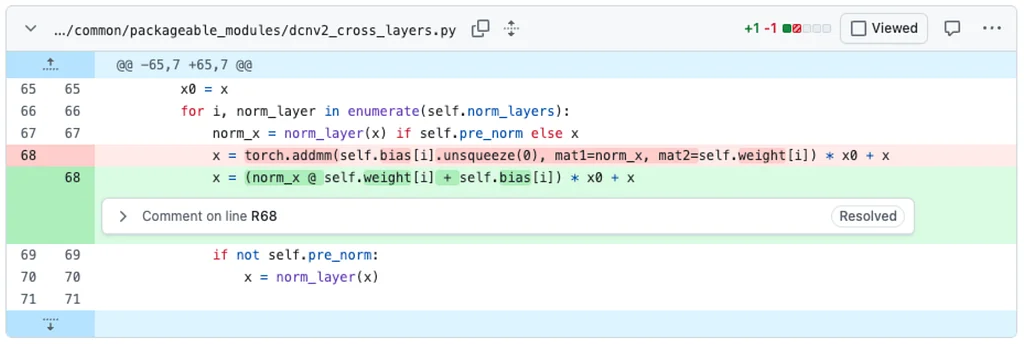
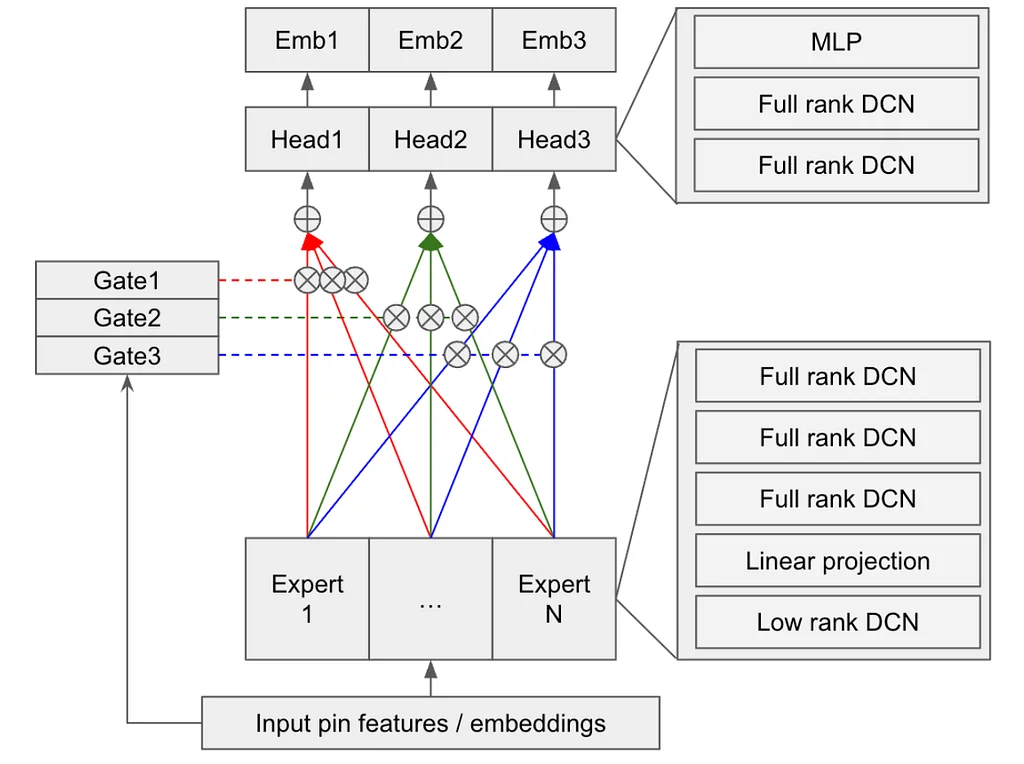
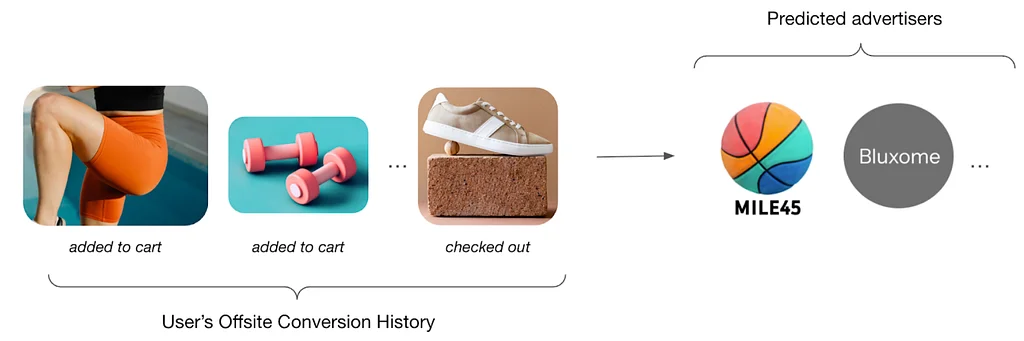
Pinterest는 오프사이트 전환 데이터의 희소성과 노이즈 문제를 해결하기 위해 전환 광고를 위한 전용 후보 생성 모델을 개발했습니다. 이 모델은 이전의 참여 기반 시스템과 달리 하위 퍼널 전환에 초점을 맞춘다는 점에서 차이가 있습니다. 2023년 초기 출시 결과, 클릭률 증가를 포함한 전환 및 참여 지표 모두에서 상당한 개선이 이루어졌습니다. 2025년의 추가적인 반복 개발을 통해 전환 가치가 더욱 향상되었고 광고주의 광고 투자 수익률이 개선되었습니다. 데이터 희소성을 극복하기 위해 이 모델은 멀티 서피스 접근 방식을 사용하여 모든 쇼핑 서피스에서 학습됩니다. 또한, 노이즈를 완화하기 위해 클릭 데이터를 기간에 따라 재가중하여 전환 신호를 보강하고 온사이트 참여 데이터를 보충합니다. 참여가 없는 광고 노출과 같은 하드 네거티브를 사용하여 더 강력한 대조 학습을 수행합니다. 이 모델은 실시간 의도와 장기적인 선호도를 포착하는 사용자 측 기능과 의미론적 이해 및 성능 추적을 위한 Pin 측 기능을 통합합니다. DCN v2와 MLP를 병렬 교차 계층에 사용하는 투 타워 아키텍처는 특징 상호 작용 모델링 및 검색 품질을 향상시킵니다. 이 모델은 멀티 헤드 디자인에서 통합 멀티태스크 아키텍처로 발전하여 서빙 중 멀티태스크 최적화로부터 직접적인 이점을 얻을 수 있게 되었습니다. 전환 신호에 대한 더 안정적인 세분성을 제공하기 위해 광고주 수준 손실 함수가 도입되어 상당한 리콜 개선으로 이어졌습니다. 이 새로운 모델은 쇼핑 전환량을 성공적으로 늘리고 광고주 성과를 개선하는 동시에 사용자 쇼핑 경험을 향상시켰습니다.
CdXz5zHNQW_iZkUUBsGZ2.png
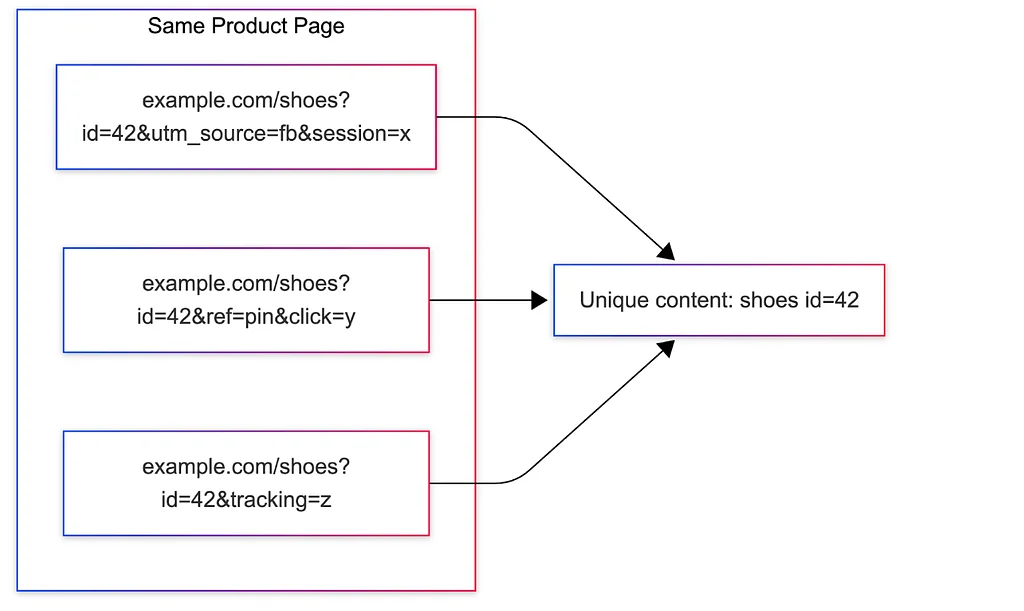
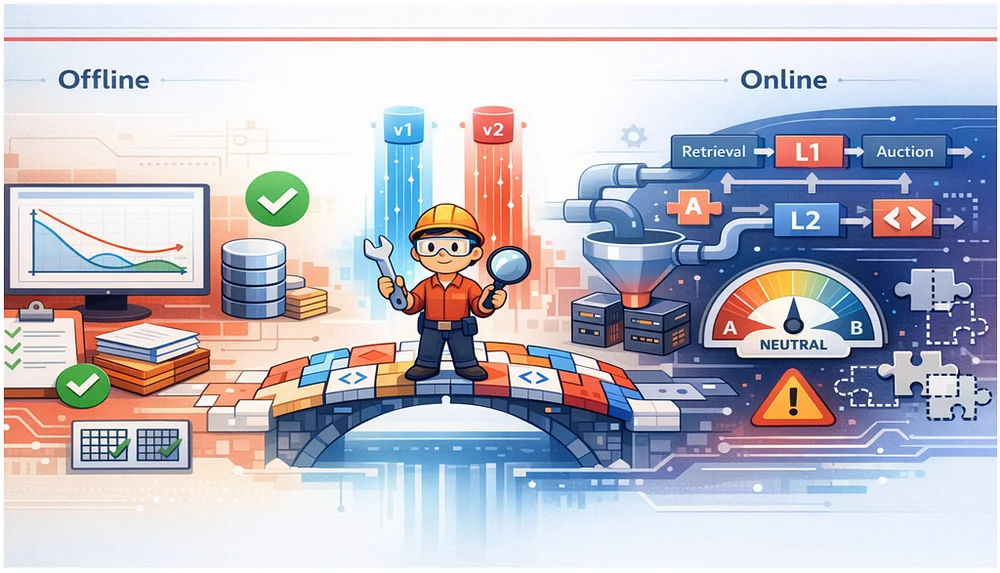
Pinterest는 이미지와 외부 링크에 대한 통찰력을 바탕으로 콘텐츠 배포 및 참여를 유도하기 위해 콘텐츠 이해를 활용합니다. 핵심 문제는 URL 정규화로, 추적 매개변수로 인해 동일한 제품 페이지가 다양한 URL로 표시되는 경우입니다. 이러한 중복성은 반복적인 가져오기 및 처리로 인해 컴퓨팅 리소스 낭비를 초래합니다. 항목 표준화는 다른 URL로 표현되는 동일한 항목을 통합하는 것을 목표로 하며, 쇼핑 카탈로그에 매우 중요합니다. 항목 ID가 없는 경우 고급 URL 정규화가 중복 제거에 필수적입니다.MIQPS(Minimal Important Query Param Set) 알고리즘은 어떤 URL 매개변수가 콘텐츠 ID에 영향을 미치는지 자동으로 학습합니다. 페이지 콘텐츠에 영향을 미치지 않는 중립 매개변수와 영향을 미치는 비중립 매개변수를 구분합니다. 잘 알려진 플랫폼의 경우 정적 규칙이 작동하지만, Pinterest의 방대한 도메인 세트에는 동적이고 데이터 기반 접근 방식이 필요합니다.MIQPS 알고리즘은 세 단계로 작동합니다. 첫째, Pinterest의 수집 파이프라인에서 도메인별 관찰된 URL 코퍼스를 수집합니다. 둘째, URL은 쿼리 매개변수 패턴별로 그룹화되어 매개변수가 특정 컨텍스트에서 분석되도록 합니다. 이렇게 하면 다른 URL 유형에 따라 매개변수를 잘못 분류하는 것을 방지할 수 있습니다.마지막으로, 패턴 내의 각 매개변수에 대해 알고리즘은 경험적으로 중요성을 테스트합니다. 매개변수 값이 다른 URL을 샘플링하고 원본 URL과 수정된 URL(매개변수 제거) 모두에 대한 콘텐츠 ID를 계산합니다. 매개변수를 제거하면 샘플의 상당 부분에서 콘텐츠 ID가 변경되면 비중립으로 분류되고 유지됩니다. 그렇지 않으면 중립으로 간주되어 정규화를 위해 안전하게 제거할 수 있습니다. 각 판매자 도메인은 도메인별 매개변수 의미를 고려하여 자체 MIQPS 맵을 받습니다.
CdXz5zHNQW_WVip85jMBw.png
모바일 앱에서 성능은 시계의 시간과 같은 기본 기능만큼이나 중요합니다. Pinterest는 주요 사용자 경험 전반에 걸쳐 성능을 측정, 보호 및 개선하는 데 중점을 둡니다. 사용자가 콘텐츠를 기다리는 시간을 반영하는 사용자 체감 지연 시간은 중요한 성능 지표입니다. 특히 시각적으로 완료되는 시간(Visually Complete time)을 측정하는 것은 이전에는 복잡하고 시간이 많이 소요되었습니다. 시각적으로 완료되는 시간은 크게 달라지기 때문에 사용자 정의 측정 로직이 필요했으며, 이는 성능 작업에 방해가 되었습니다. Pinterest의 성능 팀은 제품 엔지니어가 지연 시간 데이터에 쉽게 접근할 수 있는 솔루션을 모색했습니다. 이를 통해 시각적으로 완료되는 시간 로직을 기본 UI 클래스에 통합하여 모든 UI 표면에 대한 지연 시간을 자동으로 측정할 수 있게 되었습니다. 이 시스템은 뷰 트리를 탐색하고 렌더링 진행 상황을 위해 주요 미디어 뷰를 식별하고 추적하여 작동합니다. 이 통합 시스템은 60개 이상의 Android 표면에 대한 지연 시간 데이터를 제공하여 성능 모니터링을 지원합니다. 이를 통해 수명이 짧은 기능들을 포함한 다양한 기능 간의 공정한 성능 비교가 가능합니다. 이 단순화된 접근 방식은 모든 엔지니어에게 성능을 가시화하여 사용자 체감 지연 시간 최적화를 촉진합니다. 유사한 구현은 iOS 및 웹 플랫폼으로도 확장되었습니다.
CdXz5zHNQW_E0CjwHBss6.png
CdXz5zHNQW_DU2kVthyel.png
CdXz5zHNQW_qKc4D1jJuD.png
CdXz5zHNQW_RcLxSqw9JO.png
CdXz5zHNQW_Wze6BrkcVd.png
CdXz5zHNQW_4sChFakajo.png
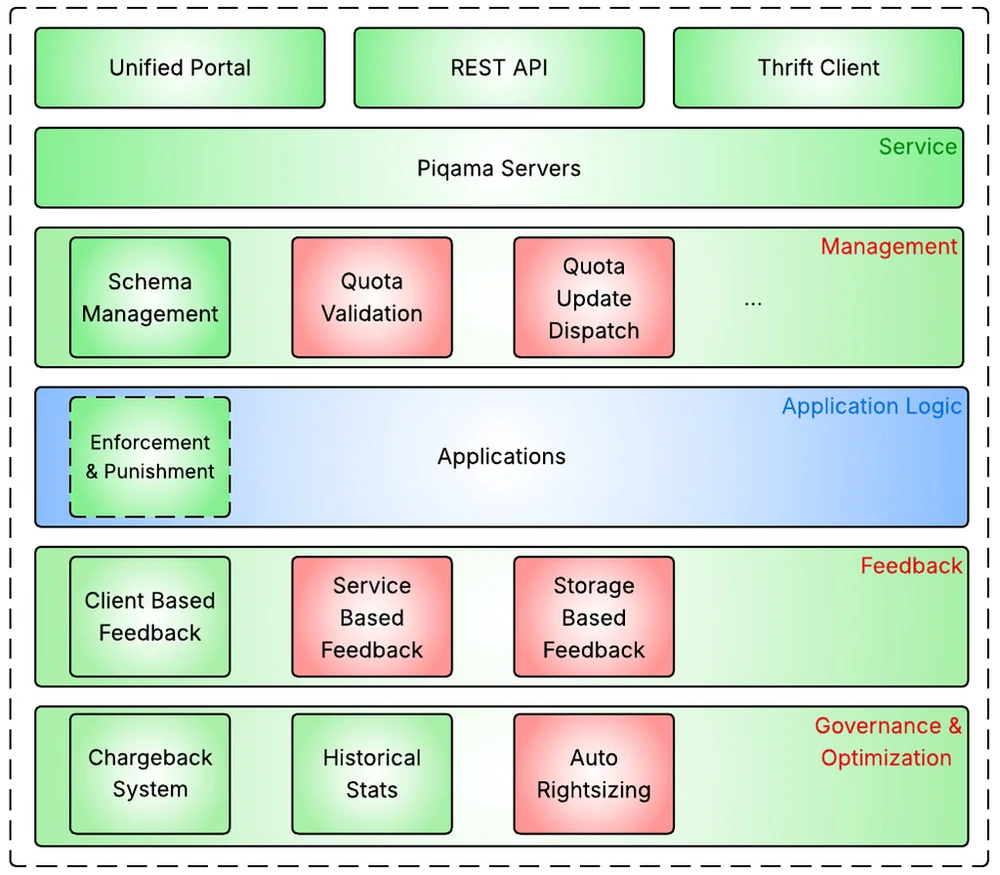
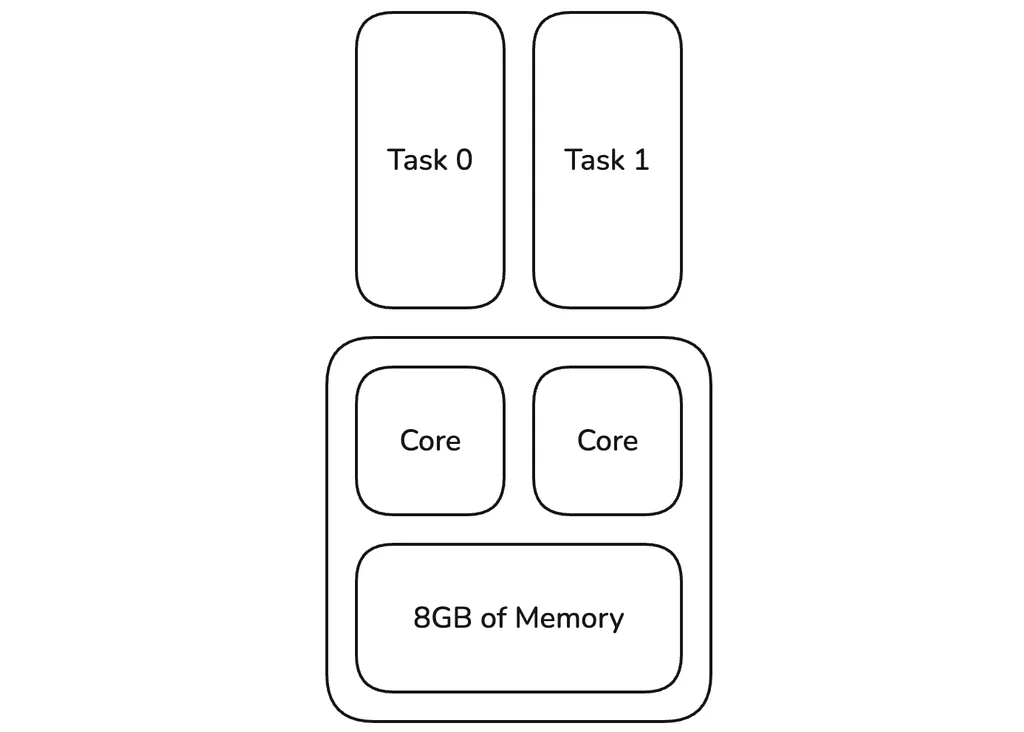
핀터레스트는 다양한 시스템에서 리소스 사용량을 관리하기 위해 Piqama라는 제네릭 쿼터 관리 플랫폼을 개발했습니다. Piqama는 중앙 집중식 포털을 통해 스키마 관리, 유효성 검사 및 업데이트 승인을 포함하여 쿼터 전체 수명 주기를 관리합니다. 이 플랫폼은 기본 강제 및 처벌 전략을 제공하면서 응용 프로그램별 논리를 통해 사용자 지정이 가능합니다. 거버넌스 및 최적화 기능에는 사용 통계 수집 및 효율적인 리소스 할당을 위한 자동 조정 기능이 포함됩니다. 예산과 쿼터는 상호 연결되어 있으며, 청구 시스템은 쿼터 설정 및 리소스 할당에 영향을 미칩니다. Piqama는 두 가지 영역에서 구현됩니다. 빅데이터 처리 플랫폼을 위한 용량 기반 쿼터 관리 및 온라인 스토리지의 속도 제한 쿼터입니다. 빅데이터 플랫폼에서 Piqama는 메모리, vcore 및 동시 애플리케이션을 관리하며 자동 및 수동 조정을 통해 쿼터를 조정합니다. 빅데이터 플랫폼은 정확한 쿼터 계산 및 시행을 위해 Yunikorn 및 리소스 데이터베이스를 사용합니다. 온라인 스토리지를 위한 새로운 속도 제한 프레임워크가 시스템 리소스 할당 및 비용 제어를 강화하기 위해 도입됩니다. 속도 제한 프레임워크는 수명 주기 관리를 간소화하고 속도 제한을 리소스 사용과 연결하며 Piqama를 제어 평면으로 사용하는 것을 목표로 합니다. 이 접근 방식은 수동 조정이 필요 없는 다양한 플랫폼에서 리소스를 관리하기 위한 강력하고 유연하며 중앙 집중식 솔루션을 제공합니다.
CdXz5zHNQW_acxjx5IRwX.png
CdXz5zHNQW_Np2gePBjyR.png
CdXz5zHNQW_6k9q6s1Pj5.png
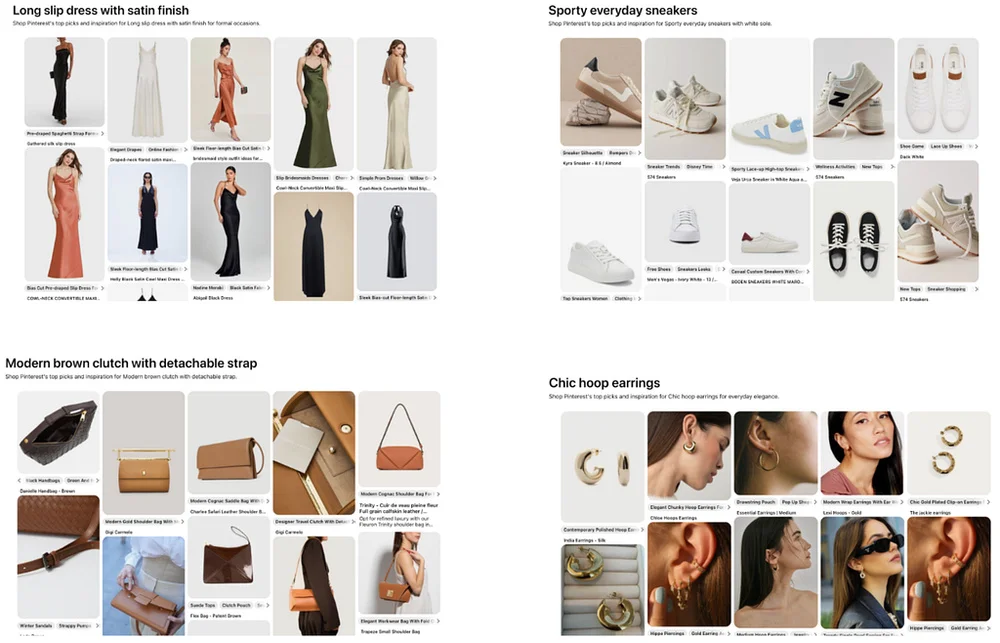
대규모 온라인 플랫폼은 수십억 개의 상품을 탐색 가능한 쇼핑 컬렉션으로 구성하는 과제에 직면해 있습니다. 역사적으로 이러한 컬렉션은 사용자 검색 기록과 수동 큐레이션에 의존했습니다. 그러나 이제 멀티모달 대규모 언어 모델(LLM)은 사용자 검색 패턴을 고려하면서도 콘텐츠에서 직접 컬렉션을 생성할 수 있게 합니다. 본 논문은 쇼핑 컬렉션 생성을 위한 프로덕션 파이프라인인 Pinlanding을 소개합니다. Pinlanding은 사용자 검색 의도 이해, LLM을 사용한 쇼핑 컬렉션 어휘 구축, 속성을 기반으로 한 피드 구성, 시스템 평가/진화의 네 가지 구성 요소로 이루어져 있습니다. 사용자 상호 작용 데이터는 쇼핑 의도를 특징화하는 데 도움이 되며, 대량 검색과 새롭게 등장하는 롱테일 대화형 쿼리 모두를 보여줍니다. 비전-언어 모델은 초기 상품 속성을 생성하며, 이는 통계적 필터링, 임베딩 기반 클러스터링, LLM 지원 검토를 통해 간결한 어휘로 큐레이션됩니다. CLIP 스타일의 듀얼 인코더 모델은 확장 가능한 속성 할당을 위해 학습되어 상품을 속성에 효율적으로 매핑합니다. Ray는 속성 할당에서 확장 가능한 배치 추론에 사용되며, Spark는 상품-주제 관련성을 점수화하여 피드를 구성합니다. CLIP 기반 분류기는 패션 속성 예측 벤치마크에서 우수한 성능을 보입니다. 인간 평가는 Pinlanding이 기존 방법보다 컬렉션 품질의 정확도를 크게 향상시킨다는 것을 보여줍니다. 이 시스템은 고유한 쇼핑 주제를 4배 증가시키고 검색 성능을 35% 향상시켰습니다. 향후 작업에는 소셜 트렌드 통합과 새로운 복합 개념을 처리하기 위한 AI 에이전트 계층 개발이 포함됩니다.
CdXz5zHNQW_plPICGLX7O.png
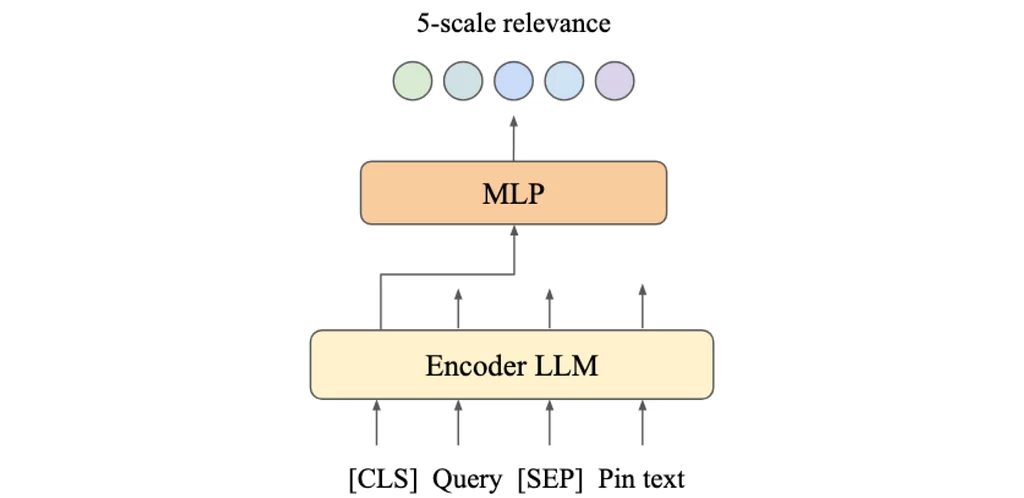
Pinterest 검색, LLM을 활용한 검색 관련성 평가 방법 개발Pinterest 검색팀은 대규모 언어 모델(LLM)을 활용하여 검색 관련성 평가를 개선하는 방법을 개발했습니다. 기존의 관련성 측정 방식은 비용이 많이 드는 사람의 주석에 의존하여 A/B 실험의 규모와 민감도를 제한했습니다. 이를 해결하기 위해 Pinterest는 사람의 레이블이 지정된 데이터로 오픈소스 LLM을 미세 조정하여 핀(Pin)이 쿼리에 얼마나 관련 있는지 예측하도록 했습니다. 이 LLM 기반 접근 방식은 핀 제목, 설명, 이미지 캡션과 같은 기능을 활용하여 관련성 예측을 다중 클래스 분류 문제로 취급합니다.계층적 쿼리 샘플링 설계를 채택하여 최소 감지 효과(MDE)를 한 자릿수 이상 크게 줄였습니다. 이 새로운 방법론은 이질적인 처리 효과를 측정하고 평가 효율성을 향상시킵니다. LLM 레이블링 프로세스는 비용과 시간을 크게 절감하여 더 크고 대표적인 표본 크기를 사용할 수 있게 합니다.미세 조정 후 LLM 기반 관련성 모델은 관련성 점수를 생성하며, 이를 사용하여 sDCG@K와 같은 지표를 계산합니다. 엄격한 검증 결과 LLM 생성 레이블과 사람의 주석 간에 높은 일치율을 보였으며, 정확히 일치하는 비율은 73.7%였고 순위 기반 상관 관계도 강했습니다. 이러한 일치는 쿼리별 인기도 세그먼트가 다른 경우에도 유지되었습니다.LLM 기반 관련성 평가는 비영어 쿼리에서도 효과적이었으며, 강한 상관 관계와 낮은 편향을 유지했습니다. LLM 기반 관련성 평가로 전환함으로써 Pinterest 검색은 평가 쿼리 세트를 확장하고 온라인 실험 평가를 위한 관련성 지표의 품질을 향상시킬 수 있었습니다. 이를 통해 수동 주석 작업이 크게 줄어들고 A/B 테스트 프로세스의 전반적인 효율성이 향상되었습니다. 선택된 LLM인 XLM-RoBERTa-large는 예측 품질과 추론 효율성의 좋은 균형을 제공합니다.
CdXz5zHNQW_fbv8G1VHoa.png
Pinterest는 정책 위반 콘텐츠를 측정하기 위해 '유병률'이라는 지표를 사용하며, 이는 전체 조회수 중 유해 콘텐츠에 대한 조회수의 비율로 정의됩니다. 유병률은 사용자 신고를 보완하여 신고되지 않은 유해 사례를 파악하고 추세를 추적합니다. 과거에는 유병률 측정을 위해 사람의 검토에 의존하는 방식은 느리고 비용이 많이 들었습니다. 이를 해결하기 위해 Pinterest는 일일 유병률 측정을 위한 AI 지원 워크플로우를 개발했습니다. 여기에는 사용자 노출 샘플링과 대규모 라벨링을 위한 멀티모달 LLM 사용이 포함됩니다. 전문가 프롬프트와 주제 전문가의 지도를 받는 LLM은 정확도를 유지하면서 지연 시간과 비용을 크게 줄입니다. 유병률은 신뢰 구간과 함께 매일 계산되며, 정책 영역, 하위 정책 및 콘텐츠 표면별로 세분화할 수 있습니다. 이 시스템은 효율적인 샘플링을 위해 집행 모델의 위험 점수를 사용하지만, 이러한 점수는 레이블 역할을 하지 않습니다. 역확률 가중치는 집행 임계값 변경에도 불구하고 유병률 통계가 시간이 지남에 따라 사용자 노출을 정확하게 반영하도록 보장합니다. 머신러닝은 편향되지 않은 샘플링과 효율적인 라벨링에 중요하며, 이를 통해 더 빠른 위험 감지와 사전 예방적 대응이 가능합니다. 이러한 데이터 기반 접근 방식은 더 빠른 제품 반복, 정보에 기반한 정책 개발 및 목표 설정 및 리소스 할당과 같은 전략적 의사 결정을 가능하게 합니다. 희귀 범주에 대한 넓은 신뢰 구간 또는 정책 드리프트와 같은 문제는 적응형 샘플링 및 지속적인 모니터링을 통해 관리됩니다. 향후 계획에는 피벗 기능 확장, LLM 사용 최적화 및 정확도 향상 및 편향 감소를 위한 인간 참여 프로세스 개선이 포함됩니다.
2023년, Pinterest는 사용자 웰빙과 더 안전한 온라인 경험을 위해 영감을 주는 인터넷 서약(Inspired Internet Pledge)을 준수하기로 했습니다. Pinterest는 사용자들의 콘텐츠 품질에 대한 인식을 파악하고 플랫폼 콘텐츠를 개선하기 위해 Pinner 설문조사를 활용하고 있습니다. 이 설문조사는 사용자들에게 이미지를 평가하도록 직접적으로 요청하여 추천 개선에 대한 귀중한 피드백을 제공합니다. 목표는 사용자에게 영감을 주고 장기적인 참여를 유도하는 고품질 콘텐츠를 홍보하는 것입니다. Pinterest는 설문조사 데이터를 활용하여 추천 시스템을 훈련함으로써 저품질 "클릭 유도형" 콘텐츠의 홍보를 지양합니다. 이미지 임베딩과 쌍별 랭킹 방식을 사용하여 Pinner 평가를 기반으로 시각적 품질을 예측하는 머신러닝 모델이 개발되었습니다. 이 모델은 5,000개의 핀(Pin) 데이터 세트를 기반으로 훈련되었으며, 노이즈를 줄이기 위해 이미지당 여러 개의 평가가 사용되었습니다. 오프라인 평가를 통해 모델이 고품질 콘텐츠와 저품질 콘텐츠를 구별하는 능력을 입증했습니다. 이 모델은 Pinterest가 시스템의 편향성을 제거하고, 보상받는 참여가 고품질 콘텐츠에서 비롯되도록 보장하여 "Pinners First" 가치에 부합하도록 돕습니다. 이 모델은 홈피드, 관련 핀, 검색을 포함한 Pinterest의 주요 서비스 전반에 걸쳐 성공적으로 구현되었습니다.
Pinterest는 로그, 트레이스, 메트릭이 분리된 단편적인 관측 가능성 시스템에 직면했습니다. 이는 플랫폼 문제에 대한 전체적인 이해를 방해하여 엔지니어들이 여러 인터페이스를 탐색해야 했습니다. 팀은 계측 및 프로덕션 모니터링을 개선하기 위해 "shift-left" 및 "shift-right" 접근 방식을 채택했습니다. 데이터 단편화를 극복하기 위해, 그들은 AI와 컨텍스트 엔지니어링을 수용했으며, 특히 Model Context Protocol (MCP)을 사용했습니다. MCP 서버는 메트릭, 로그, 트레이스, 변경 이벤트와 같은 서로 다른 관측 가능성 신호를 통합하기 위해 개발되었습니다. 이 솔루션을 통해 AI 에이전트는 완전한 인프라 개편 없이 데이터에 접근하고 상관 관계를 파악할 수 있습니다. MCP 서버는 다양한 데이터 기둥에 대한 통합된 접근 방식을 제공하며, 세분화된 컨텍스트 제어 및 플러그 앤 플레이 확장성을 제공합니다. 이는 에이전트 기반 관측 가능성 경험의 허브 역할을 하며, 팀이 컨텍스트 인식 도구를 구축할 수 있도록 지원합니다. 처리되는 데이터의 방대한 양으로 인해 모델 컨텍스트 크기 제한 문제가 발생했습니다. 해결책으로는 관련 대시보드에 대한 직접 링크 생성 또는 AI 에이전트에게 보다 구체적인 도구 문서를 제공하는 것이 포함되었습니다.
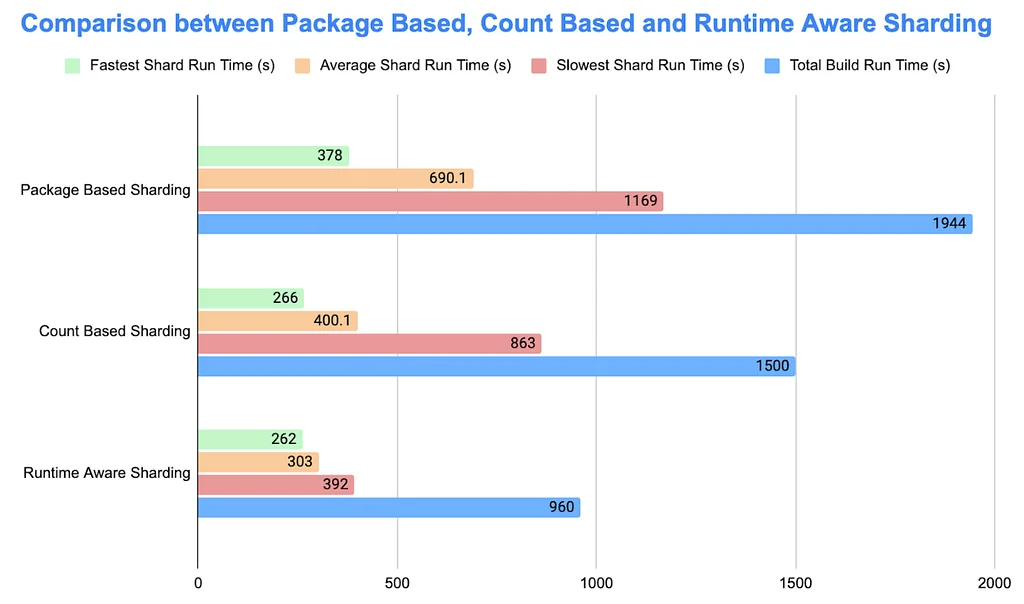
Pinterest의 Android 엔드투엔드 테스트 빌드는 테스트 샤드 불균형과 플랫폼 제한으로 인해 느리고 불안정했습니다. 팀은 먼저 타사 솔루션을 평가했지만, 자체 요구 사항에 부적합하다고 판단했습니다. 이에 따라 EC2 에뮬레이터에서 호스팅되는 PinTestLab이라는 자체 테스트 플랫폼을 구축하기로 결정했습니다. 이 플랫폼을 통해 테스트 스택과 인프라를 완벽하게 제어할 수 있게 되었습니다.핵심 혁신은 런타임 인식 샤딩 메커니즘입니다. 이 시스템은 과거 테스트 실행 시간 및 안정성 데이터를 사용하여 테스트를 샤드에 분배합니다. 목표는 각 샤드의 총 실행 시간을 유사하게 만드는 것입니다. 이 접근 방식은 단순히 샤드당 테스트 수를 균등하게 분배하는 것과는 다릅니다.이전에는 패키지 기반 샤딩으로 인해 단일 느린 샤드가 전체 빌드를 지연시키는 불균형이 발생했습니다. 단순한 시간 기반 정렬조차도 에뮬레이터 유휴 시간을 고려하지 못했습니다. 새로운 런타임 인식 샤딩 알고리즘은 테스트를 평균 실행 시간별로 정렬한 다음, 가장 빨리 완료될 것으로 예상되는 에뮬레이터에 각 테스트를 탐욕적으로 할당하는 방식으로 작동합니다. 이를 통해 모든 에뮬레이터가 바쁘게 작동하고 가장 빠른 샤드와 가장 느린 샤드 간의 시간 차이를 최소화합니다.이 솔루션의 영향은 상당했습니다. 엔드투엔드 빌드 시간이 9분 단축되어 36% 개선되었습니다. 가장 느린 샤드의 실행 시간은 55% 감소했습니다. 가장 빠른 샤드와 가장 느린 샤드 간의 시간 차이는 597초에서 130초로 극적으로 줄었습니다. 이는 더 빠르고 안정적인 피드백을 제공하여 개발자 생산성을 향상시킵니다.
CdXz5zHNQW_7VB873V6rz.png
CdXz5zHNQW_jljfgPqEKe.png
Pinterest의 ML 훈련 플랫폼인 MLEnv는 PyTorch 버전 업그레이드 후 상당한 성능 저하를 겪었습니다. 이 문제는 훈련 처리량을 50% 이상 감소시켰습니다. 디버깅 과정은 GPU roofline 처리량 검사로 시작되었습니다. 이 측정 결과, 데이터 로더를 제외하더라도 20%의 성능 저하가 나타났습니다. 추가 분석은 성능 저하의 원인을 파악하기 위해 개별 모델 모듈에 초점을 맞췄습니다. 특정 변환기 모듈인 모듈 A가 주요 원인으로 확인되었습니다. PyTorch 프로파일러는 이 모듈에 대해 이전에 존재했던 CompiledFunctions가 업그레이드된 버전에서는 누락되었음을 보여주었습니다.torch.compile에 대한 조사 결과, torch.compile이 지원하지 않는 비 인프라 PyTorch 디스패치 모드가 존재한다는 로그가 나타났습니다. 최소 재현 가능한 스크립트는 이 문제가 특히 트레이너 클래스 내에서 나타난다는 것을 확인했습니다. 문제의 구성 요소는 기본적으로 활성화된 FLOPs 계산에 사용되는 컨텍스트 관리자로 확인되었습니다. 이 컨텍스트 관리자를 비활성화하면 torch.compile 문제가 해결되어 CompiledFunctions가 복원되었습니다. 그러나 이 수정 사항은 엔드 투 엔드 처리량을 개선하지 못했습니다.초점은 데이터 로딩 및 분산 훈련 측면으로 다시 옮겨졌으며, 네이티브 PyTorch 애플리케이션으로 실행할 때에도 동일한 GPU roofline 처리량 문제가 관찰되어 Ray.data가 원인이 아님을 배제했습니다. 여러 관찰 결과는 간헐적인 느린 반복, 동기화 중의 straggler 효과, 그리고 Nvidia의 Nsight Systems 프로파일러를 활성화하면 느림이 사라지는 특이한 동작을 지적했습니다. 단일 GPU에서 테스트한 결과, 분산 훈련이 근본 원인이 아님을 확인했습니다. Ray 설정에서 torch.compile을 완전히 비활성화하면 원래의 처리량이 복원되었으며, 이는 torch.compile 내의 그래프 중단이 성능 저하와 관련이 있음을 시사했습니다.광범위한 그래프 중단을 포함하는 최소 재현 가능한 모델을 생성한 결과, 반복적인 느린 반복이 관찰되었습니다. Nsight Systems 추적 결과, 주요 훈련 스레드가 이러한 느린 반복 동안 GIL(Global Interpreter Lock)을 유지하고 있었지만, 이것이 전체 일시 중지를 설명하지는 못했습니다. Linux perf 도구를 사용하고 chrome://tracing으로 추적을 시각화한 추가 분석 결과, 의심스러운 Python 프로세스가 강조되었습니다. 이 프로세스는 smap_gather_stats라는 Linux 커널 호출, 즉 가상 메모리 통계를 수집하는 비용이 많이 드는 계산을 실행하고 있었습니다.
CdXz5zHNQW_ahqFK2Jga1.png
CdXz5zHNQW_slhDyOmW2y.png
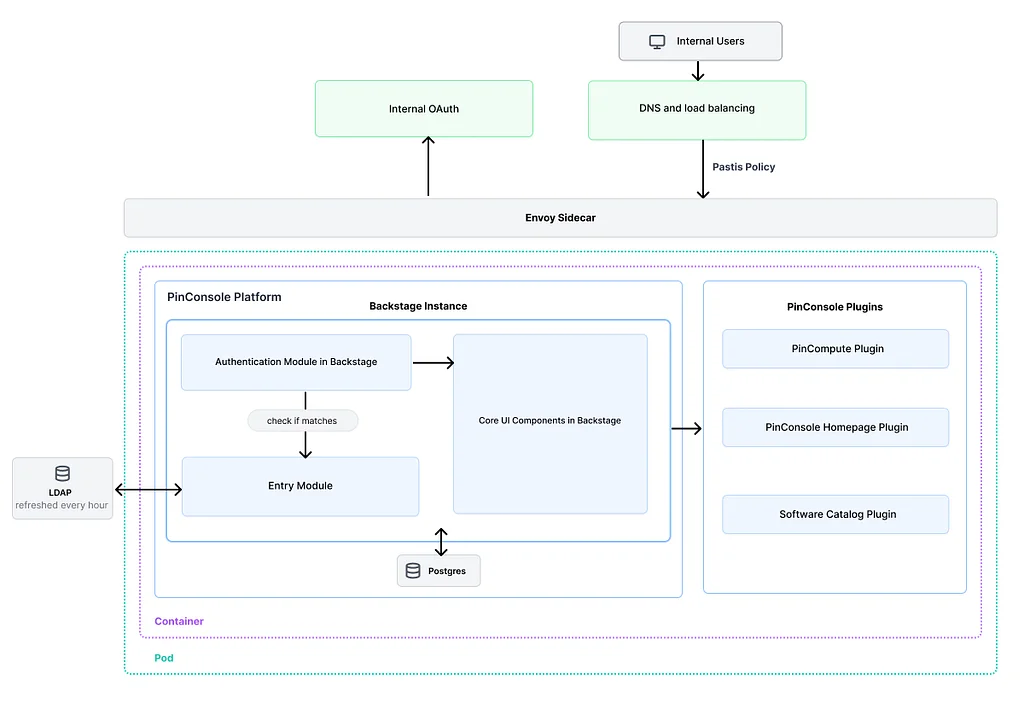
Pinterest는 사용자 기반이 성장함에 따라 기술 복잡성이 증가하여 엔지니어링 속도에 어려움을 겪었습니다. 회사는 분산된 도구 채택 전략이 병목 현상을 일으키고 신규 엔지니어들에게 부담스러운 환경을 조성한다는 것을 인지했습니다. 이를 해결하기 위해 Pinterest는 PinConsole이라는 내부 개발 플랫폼을 구축하여 개발자 경험을 재구상하기로 결정했습니다. PinConsole은 오픈 소스 Backstage 플랫폼을 기반으로 구축된 통합 개발자 포털입니다. 이 플랫폼 접근 방식은 일관된 추상화 계층을 생성하여 엔지니어가 인프라가 아닌 비즈니스 로직에 집중할 수 있도록 하는 것을 목표로 합니다. Pinterest는 다양한 솔루션을 평가한 후 강력한 커뮤니티 채택, 확장 가능한 플러그인 아키텍처, 활발한 개발을 이유로 Backstage를 선택했습니다. PinConsole은 Pinterest의 내부 인증 시스템 및 LDAP와 통합되어 통합된 엔티티 모델을 제공합니다. 아키텍처는 데이터 저장에 PostgreSQL 데이터베이스를 활용하고 UI 일관성을 위해 Pinterest의 Gestalt 디자인 시스템을 적용합니다. 핵심 구성 요소는 Pinterest별 추상화를 사용하여 워크로드 관리를 단순화하는 사용자 지정 Kubernetes 통합인 PinCompute 플러그인입니다. GitHub 통합과 같은 개인화된 홈페이지 위젯은 컨텍스트 전환을 줄이고 관련 정보를 제공하여 개발자 경험을 더욱 향상시킵니다.
CdXz5zHNQW_JMlsyqEFEB.png
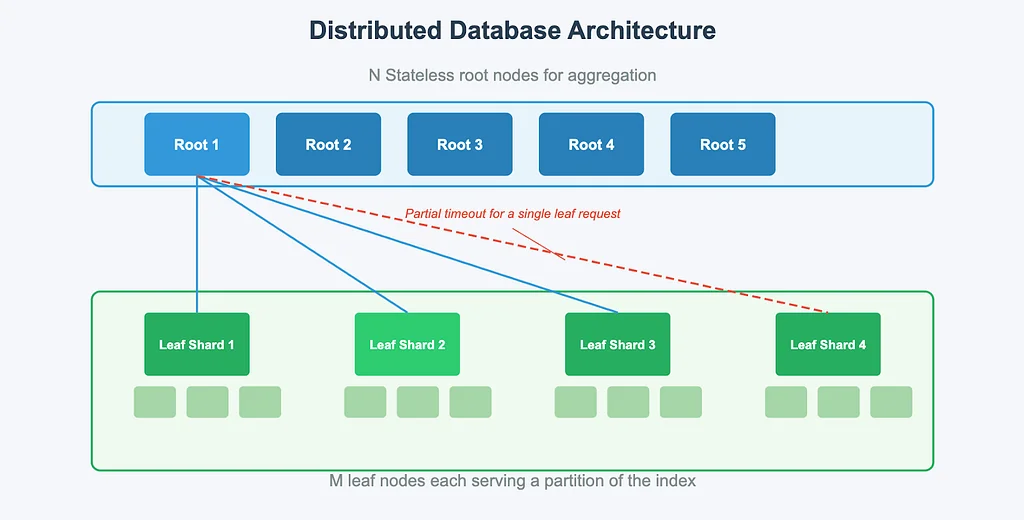
Pinterest의 검색 인프라인 Manas는 Kubernetes로 마이그레이션되었지만, 백만 건의 검색 요청 중 하나가 평소보다 100배 더 오래 걸리는 성능 문제가 발견되었습니다. 이 문제는 조사되었고, 모니터링 프로세스인 cAdvisor가 문제를 일으키고 있음이 밝혀졌습니다. cAdvisor는 프로세스가 참조하는 총 메모리 바이트를 계산하기 위해 30초마다 전체 페이지 테이블을 스캔하고 있었는데, 이는 Manas의 메모리 집약적인 리프 처리와 경합을 유발했습니다. 이것이 검색 요청의 지연 시간 급증을 야기한 원인이었습니다. 조사는 검색 시스템 프로파일링, 성능 문제 디버깅, Linux 커널 기능 및 메모리 관리 등을 포함했습니다. 근본 원인은 기본적으로 활성화되어 메모리 경합을 유발하는 cAdvisor의 WSS(Working Set Size) 추정으로 파악되었습니다. 이 문제는 모든 PinCompute 노드에서 cAdvisor의 WSS 추정을 비활성화함으로써 해결되었습니다. 이 수정은 Pinterest의 Kubernetes 플랫폼에 중요한 이정표가 되어 다른 온라인 서비스들이 플랫폼으로 이전될 수 있도록 했습니다. 이번 조사는 리소스 격리, 문제 공간 축소, 블랙박스 디버깅 전략 활용의 중요성을 강조했습니다. 또한, 때로는 '충분히 좋은' 해결책만으로도 충분하며, 앞으로 나아가기 위해 완벽한 해결책을 찾을 필요는 없다는 것을 보여주었습니다.
CdXz5zHNQW_dc6w46JhEJ.png
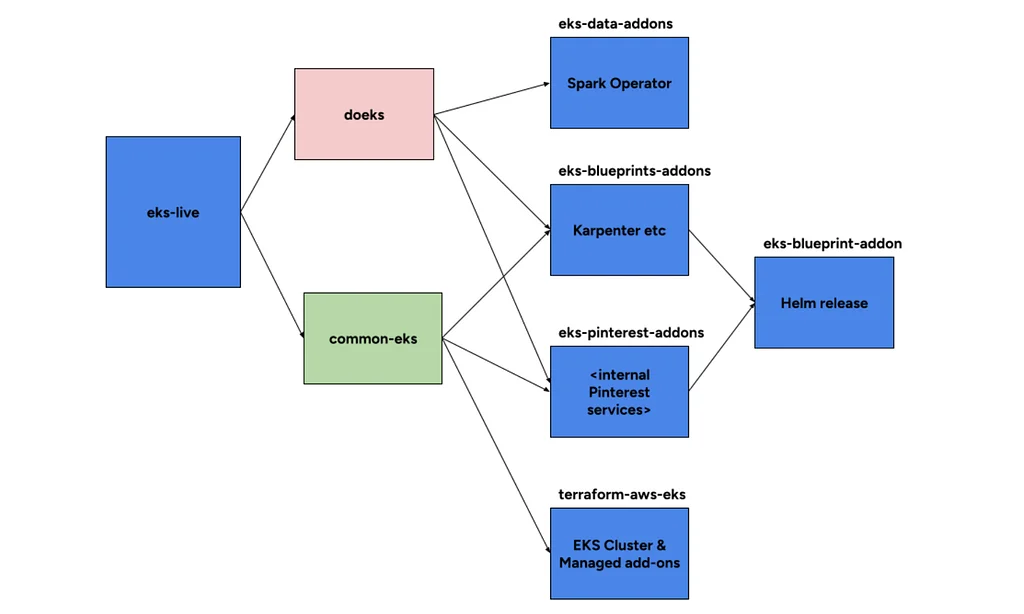
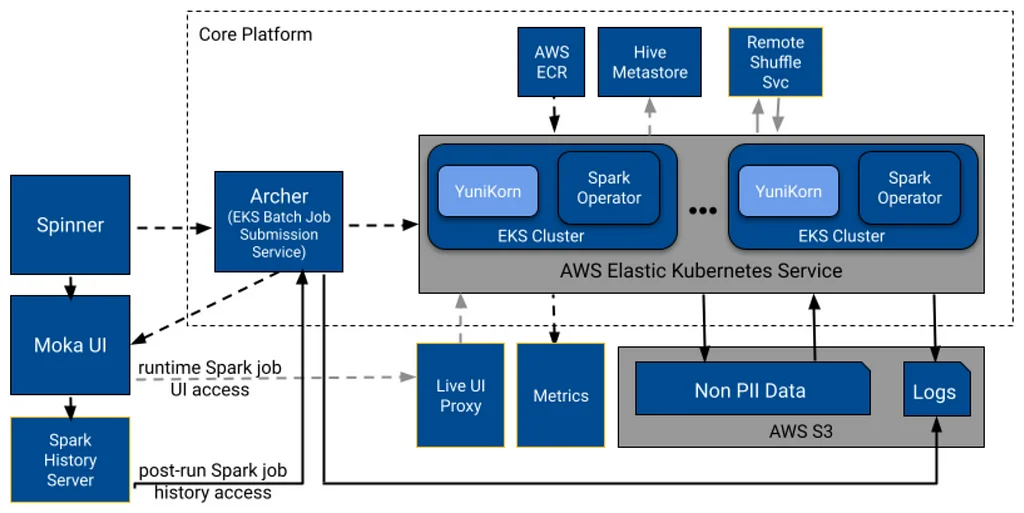
핀터레스트의 데이터 엔지니어링 팀은 현재 사용 중인 하둡 기반 플랫폼인 모나크(Monarch)를 대체하기 위해 대규모 데이터 처리 플랫폼을 구축 중이다. 팀은 빅데이터 커뮤니티에서 점점 더 많이 사용되고 채택되는 쿠버네티스 기반 시스템을 대체 플랫폼으로 탐색했다. 새로운 플랫폼은 컨테이너에 대한 광범위한 지원, 핀터레스트의 커스텀 스파크 포크의 실행, 운영 및 유지 보수 비용의 감소와 같은 특정 기준을 충족해야 했다. 팀은 다양한 플랫폼에서 스파크를 실행하는 것을 포함한 종합적인 평가를 수행했으며, 컨테이너 기반의 격리 및 보안, 배포의 용이성, 내장된 프레임워크와 같은 장점으로 인해 쿠버네티스 기반 프레임워크를 선호했다. 쿠버네티스는 다른 시스템보다 컨테이너 관리 및 배포에 대한 더 세부적인 지원을 제공하지만, 데이터 관리, 저장소 및 처리에 대한 내장된 지원은 부족하다. 팀의 현재 배포 모델은 하둡에서 번거롭기 때문에, 팀은 테라폼, 컨테이너 이미지 및 헬름을 사용하여 더 직접적인 접근 방식을 사용하고 있다. 새로운 플랫폼은 모나크를 대체하기 위해 쿠버네티스와 EKS를 사용할 것이며, 이는 EKS를 기존 핀터레스트 환경에 통합하고 하둡 구성 요소를 대체하는 것과 같은 여러 가지 도전을 가져올 것이다. 팀은 배치 스파크 워크로드를 처리할 수 있는 새로운 플랫폼인 모카(Moka)를 구축했으며, 향후에는 더 많은 기능을 추가할 계획이다. 모카의 초기 고급 설계에는 일련의 구성 요소인 스핀너(Spinner), 아처(Archer) 및 스파크 연산자를 통해 작업이 제출되고 처리되는 배치 스파크 워크로드를 처리할 수 있는 시스템이 포함된다. 팀은 블로그 시리즈의 다음 부분에서 플랫폼의 핵심 애플리케이션 중심 측면에 대한 자세한 정보를 제공할 예정이다.
CdXz5zHNQW_bbfzbQhJcm.png
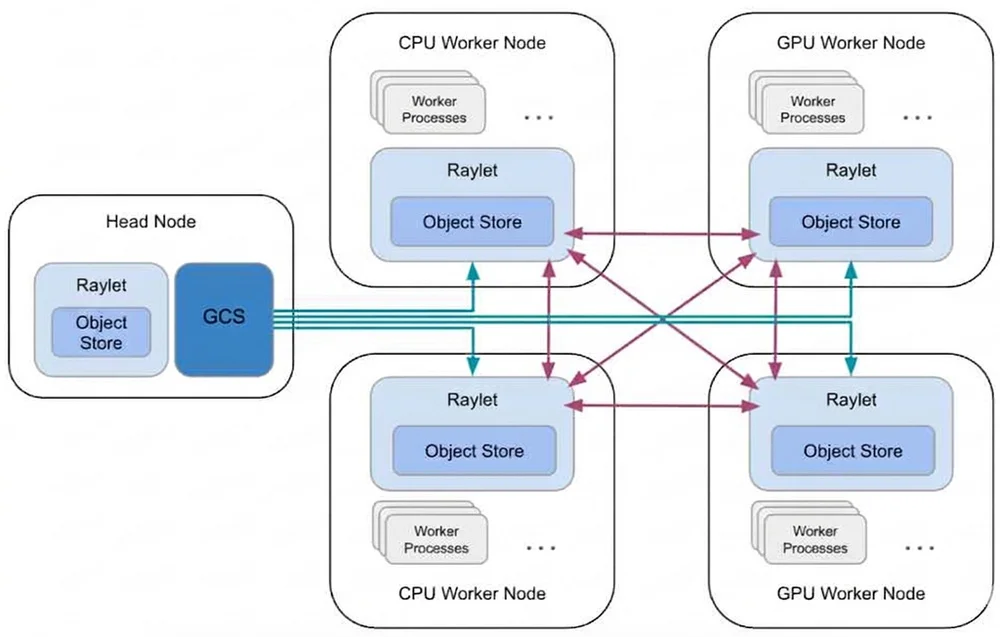
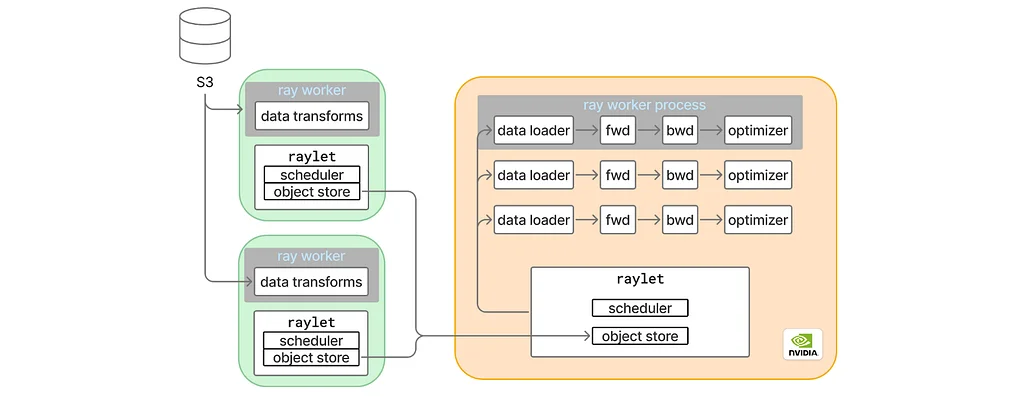
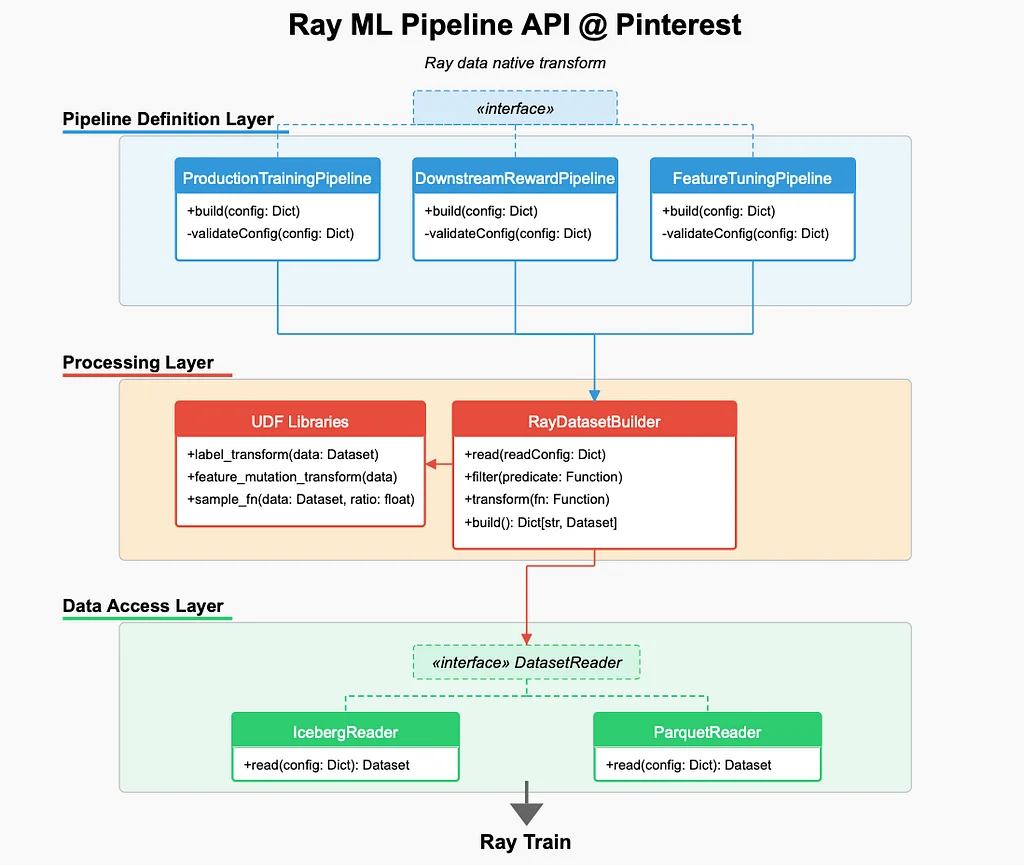
Pinterest에서 ML 엔지니어들은 느린 데이터 파이프라인, 비용이 많이 드는 기능 반복, 비효율적인 컴퓨팅 사용으로 인해 기능 개발 최적화, 샘플링 전략, 라벨 실험에 어려움을 겪고 있습니다. 이러한 문제를 해결하기 위해 Pinterest는 Ray의 기능을 훈련 외에도 기능 개발, 샘플링, 라벨 모델링까지 확장했습니다. 기존 ML 인프라는 느린 데이터 파이프라인, 비용이 많이 드는 기능 반복, 비효율적인 컴퓨팅 사용에 의해 제약을 받았습니다. Pinterest는 Ray-네이티브 ML 인프라 스택을 도입하여 다음과 같은 네 가지 주요 개선 사항에 중점을 두었습니다: Ray Data 네이티브 파이프라인 API 구축, Iceberg Bucket Join을 이용한 효율적인 데이터 조인, 효율적인 반복을 위한 데이터 지속성, 대규모 워크로드를 위한 Ray Data 최적화. 새로운 Ray 기반 ML 워크플로우는 ML 반복 시간을 10배 줄이는 동시에 인프라 비용을 크게 절감합니다. Ray Data 네이티브 파이프라인 API는 Ray에서 기능 개발, 샘플링, 라벨 변환을 네이티브하게 수행하여 Spark 백필의 필요성을 없앴습니다. Iceberg Bucket Join은 대규모 테이블을 미리 계산하지 않고도 서로 다른 소스 간의 빠르고 효율적인 기능 조인을 가능하게 합니다. 데이터 지속성은 변환된 기능을 캐싱하고 해당 기능을 재사용하여 효율적인 반복을 가능하게 합니다. Ray Data 최적화는 다양한 파이프라인에서 2-3배의 속도 향상을 달성했으며, 새로운 워크플로우는 Pinterest에서 더욱 확장 가능하고 효율적이며 비용 효율적인 ML 인프라를 구축했습니다.
CdXz5zHNQW_vBYaC4X7rO.png
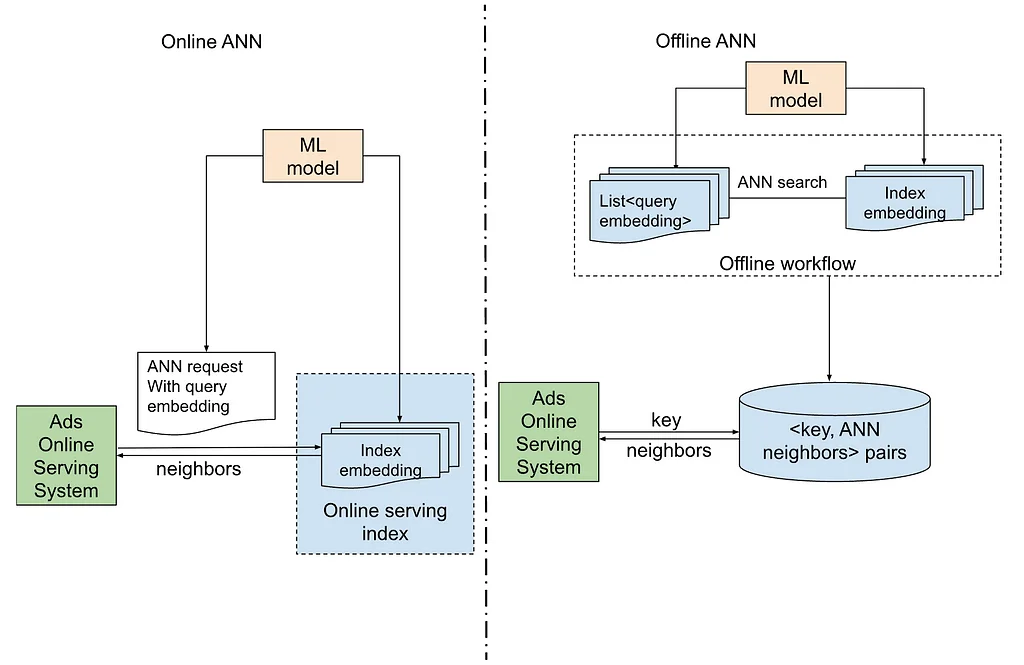
Pinterest는 광고 검색을 위해 온라인 근사 최근접 이웃(ANN)을 사용하지만, 오프라인 ANN 또한 대규모 데이터 처리와 비용 효율적인 운영에 가치가 있습니다. 오프라인 ANN은 후보군을 사전에 계산하며, 높은 처리량과 짧은 응답 시간을 요구하고 쿼리 컨텍스트가 비교적 정적인 시나리오에 이상적입니다. Pinterest는 온라인 ANN을 성공적으로 적용했지만, 광고 인벤토리를 확장하는 데 어려움을 겪고 있습니다. Hierarchical Navigable Small World (HNSW)에서 Inverted File (IVF) 알고리즘으로 마이그레이션하면 더 큰 계층 인덱스를 사용할 수 있지만, 비용이 증가합니다. 오프라인 ANN은 충분한 계산 자원과 지연 시간 허용을 활용하며, 정적인 쿼리 컨텍스트를 가진 후보 생성기에 효과적입니다. 온라인 방식과 오프라인 방식의 주요 차이점은 ANN 검색 시점입니다. 오프라인 ANN은 비용 효율성과 확장성을 포함한 장점을 가지지만, 실시간 제약과 고정된 이웃을 갖는 단점도 있습니다. Pinterest는 유사 아이템 광고 및 시각적 임베딩을 포함한 여러 사용 사례에서 오프라인 ANN 기반 검색을 평가해 왔습니다. 오프라인 ANN은 더 나은 참여도와 전환 성과를 보여주었으며, Pinterest는 향후 발전을 위해 자체 오프라인 ANN 프레임워크와 플랫폼을 적극적으로 개발하고 있습니다.
CdXz5zHNQW_OYKi1HZH8r.png