오픈 표준으로 간편해진 크로스 클라우드 대화형 분석
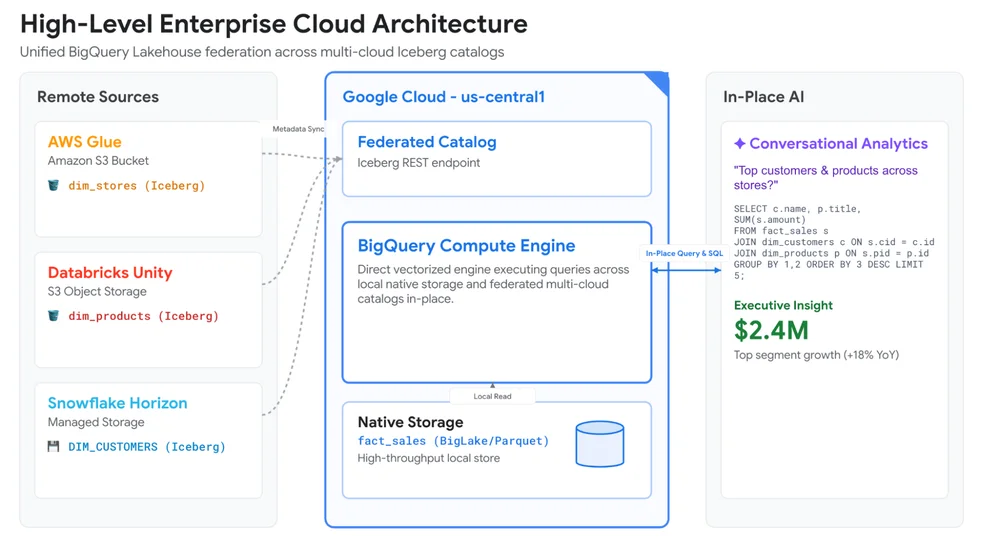
조직은 종종 여러 전문 플랫폼과 클라우드에 분산된 파편화된 데이터로 어려움을 겪습니다. 이전에는 이를 위해 복잡한 데이터 파이프라인을 구축하거나 불완전한 보고를 수용해야 했습니다. 기존 방식은 데이터를 중앙 웨어하우스로 복사하는 것을 포함하며, 이는 스키마 변경 시 동기화 문제, 스토리지 비용 및 중단된 파이프라인을 초래합니다. Google Cloud의 Apache Iceberg 기반 borderless Lakehouse는 컴퓨팅 및 AI가 다양한 플랫폼에 걸쳐 데이터를 있는 그대로 액세스할 수 있도록 함으로써 솔루션을 제공합니다. 이 아키텍처는 메타데이터를 동기화하는 동시에 데이터 파일에 대한 직접 액세스를 허용합니다. Databricks, Snowflake 및 AWS Glue의 데이터를 데이터 마이그레이션 없이 BigQuery로 통합하는 것을 지원합니다. BigQuery의 federated 쿼리는 이러한 외부 카탈로그에 걸쳐 데이터에 액세스하기 위해 네 부분으로 구성된 경로를 사용합니다. 이 통합을 통해 이질적인 데이터 세트에 대한 통합된 쿼리 및 분석이 가능합니다. 또한, federated 테이블은 BigQuery의 conversational analytics와 함께 자연어를 사용하여 탐색할 수 있습니다. 운영 고려 사항에는 백그라운드 새로 고침 타이밍 관리, 쿼리 캐싱 이해 및 데이터 상주 규정 준수 보장이 포함됩니다. borderless Lakehouse는 비용이 많이 드는 마이그레이션과 복잡한 파이프라인을 제거하여 데이터 활성화를 단순화하는 것을 목표로 합니다.