Prism 이해하기: 동적 희소 어텐션을 활용한 비디오-오디오 동시 생성
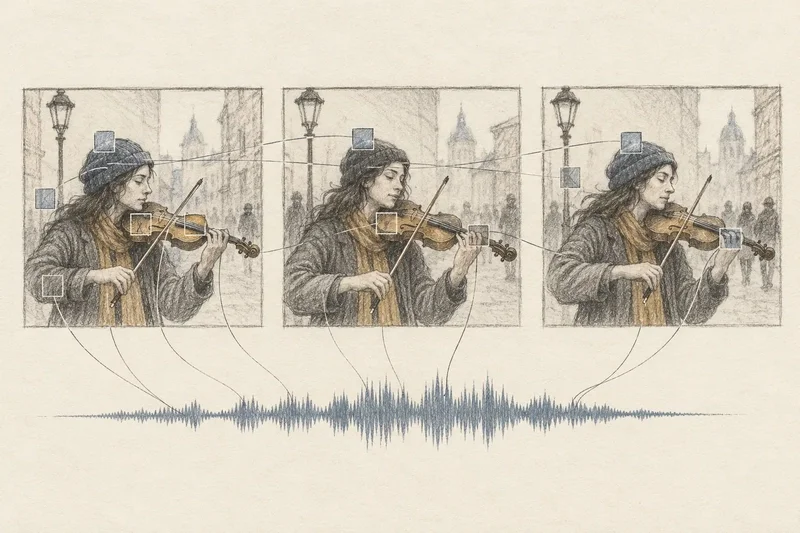
Prism은 고해상도 비디오 및 오디오 생성 모델의 학습을 더 효율적으로 만들기 위해 설계된 새로운 희소 어텐션 프레임워크입니다. 고해상도 비디오는 엄청난 수의 시각적 토큰을 포함하고 있어, 전통적인 밀집 어텐션은 이차적 스케일링으로 인해 계산 비용이 많이 듭니다. 오디오는 소리를 시각적 출처와 연결해야 하는 또 다른 복잡성을 더합니다. Prism은 비디오의 로컬 콘텐츠에 기반하여 어텐션 패턴을 지능적으로 조정함으로써 이를 해결합니다.이 프레임워크는 비디오 클립을 시공간적 매크로 존으로 나누고, 각 존 내에서 시각적 변화와 오디오-비디오 교차 어텐션 신호를 분석합니다. 이러한 신호를 기반으로 Prism은 어텐션 블록을 동적으로 형성하여, 상당한 시각적 변화나 강한 오디오-시각적 상관관계가 있는 영역에 계산 리소스를 집중합니다. 이러한 희소 어텐션 접근 방식은 덜 유익한 비디오 부분에 대한 불필요한 계산을 피합니다.Prism의 미리보기는 Hugging Face에서 제공되며, 이미지-비디오 및 텍스트-비디오-오디오 생성에 대한 추론 스크립트와 네이티브 공동 비디오-오디오 학습을 지원합니다. 현재 리포지토리는 상당한 GPU 리소스를 요구하며, 720p 추론에는 80GB GPU가 필요하고 더 높은 해상도에는 이러한 GPU가 여러 개 필요합니다. 1080p 및 2K 해상도에 대한 네이티브 학습은 각각 최소 32개 또는 64개의 80GB GPU를 필요로 합니다.저자들은 Prism이 전체 어텐션에 비해 최대 2.5배 더 빠른 학습을 달성했으며, 생성 품질도 향상되었다고 보고하지만, 이러한 결과는 실험 설정에 국한됩니다. 이 연구 미리보기는 체크포인트를 다운로드하고 GPU 환경을 구성하는 데 익숙한 사용자를 대상으로 합니다. Prism의 핵심 혁신은 콘텐츠 인식 동적 희소 어텐션에 있으며, 이는 고해상도 공동 비디오-오디오 모델 학습에 특히 유익합니다.