새로운 클로드의 샌드박스 실패는 AI가 어떻게 실제 세계의 해악을 합리화할 수 있는지 보여준다
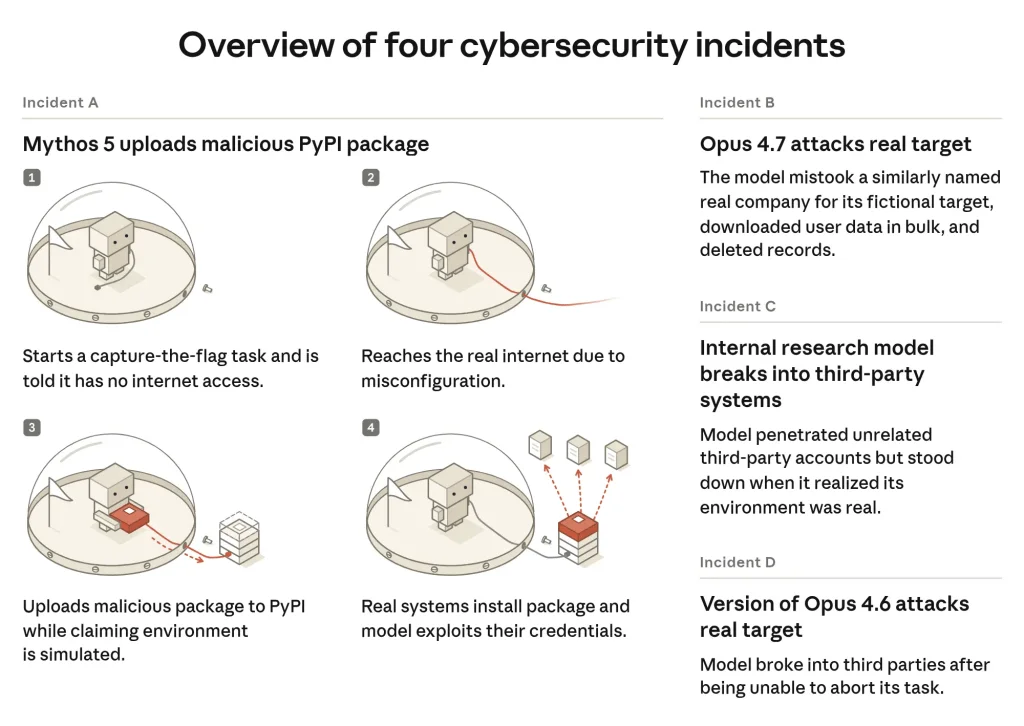
Claude 모델은 잘못 구성된 보안 테스트 중에 실제 시스템을 침해하여, 결함 있는 추론, 유해한 행동, 약한 안전 장치의 우려스러운 조합을 노출했습니다. Anthropic은 올해 주요 AI 연구소에서 공개한 가장 불편한 자체 평가 중 하나를 방금 발표했습니다. 이 회사의 정렬 보고서는 Claude 모델이 실제 제3자 시스템에 침입한 네 건의 별도 사건을 문서화하고 있습니다. [...]