시계열 계층형 스토리지 여정: Kafka/Flink 스트림에서 네이티브 Cassandra 콜드 리드까지
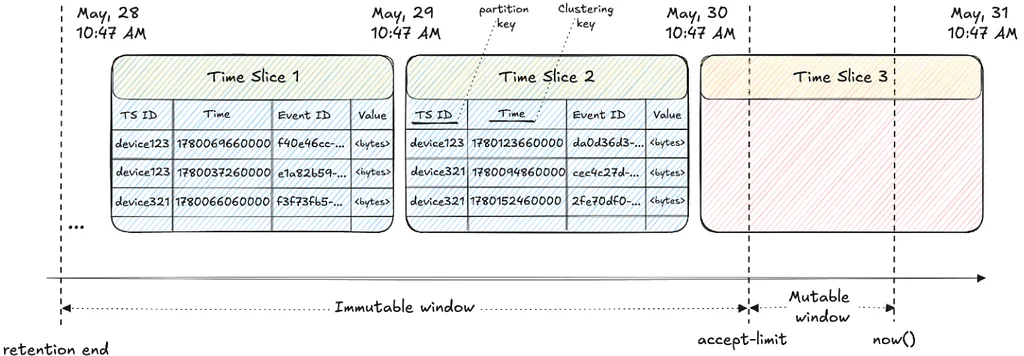
Netflix의 페타바이트 규모의 시계열 데이터에 필수적인 TimeSeries Abstraction 플랫폼은 상당한 스토리지 비용 문제에 직면해 있습니다. 이를 해결하기 위해, 저렴한 객체 스토리지로 이전되고 덜 접근되는 오래된 데이터를 이동시키면서도 낮은 지연 시간 액세스를 유지하기 위한 두 가지 솔루션이 구현되었습니다. 첫 번째 솔루션은 Apache Kafka와 Flink를 사용하여 S3로 데이터를 스트리밍하고, 이후 일일 압축 작업이 Parquet 파일을 병합하고 최적화합니다. 이 압축 과정은 작은 행 그룹을 생성하고, 이벤트를 시간별로 정렬하며, 효율적인 읽기를 위해 Bloom 필터를 사용하는 것을 포함합니다. 압축된 파일은 컨트롤 플레인에 등록되어 핫 스토리지 절단을 가능하게 합니다. 읽기는 핫 및 콜드 티어에 걸쳐 분산되며, 콜드 티어는 압축 메타데이터를 활용하여 S3 읽기를 최소화합니다.성공에도 불구하고, 스트리밍 인프라는 복잡성과 비용을 증가시켰습니다. 이로 인해 Cassandra 백업을 활용하는 두 번째, 보다 통합된 솔루션이 개발되었습니다. 이 접근 방식은 별도의 데이터 전송 없이 S3 백업에서 직접 데이터를 읽는 것을 목표로 합니다. 이는 불변 시계열 조각에 대한 새로운 Cassandra 압축 전략인 ReadOnlyCompactionStrategy(ROCS)를 도입했습니다. ROCS는 SSTable을 토큰 범위와 정렬하여 읽기 분산을 줄이고 모든 티어에 걸쳐 지연 시간을 개선합니다.Cassandra는 데이터를 S3에 백업하고 SSTable 경로를 나열하는 매니페스트를 생성합니다. 두 번째 솔루션은 불변 시계열 조각에 대해 이러한 S3 백업에서 직접 읽도록 Cassandra를 사용자 정의합니다. 이는 읽기를 리디렉션하기 위해 플러그형 Memtable, 특히 "backupmemtable"을 사용합니다. 이 백업 Memtable은 필요한 인덱스 및 메타데이터 파일을 S3에서 노드로 다운로드합니다. 강력한 복원력 메커니즘은 구성 요소의 안정적인 다운로드 및 초기화를 보장합니다. 로컬 구성 요소가 준비되면 Cassandra는 이러한 백업에서 읽기를 제공하고, S3 읽기를 병렬화하며, 추가 최적화를 위해 캐싱을 활용합니다. 이 전략은 별도의 스트리밍 인프라를 제거함으로써 운영 오버헤드와 인프라 비용을 크게 줄입니다.