ZenteiQ, llm-d 기반 GKE Inference Gateway로 배치 추론 4배 확장
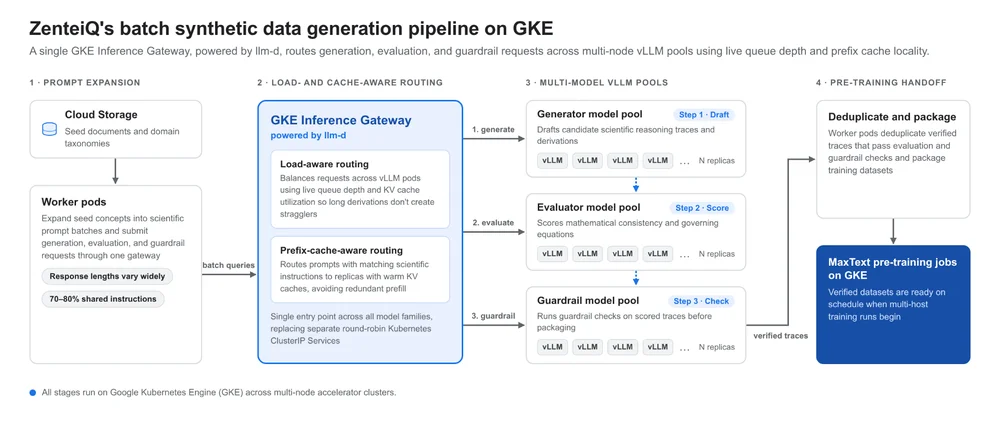
인도 과학 연구소 출신의 AI 스타트업인 ZenteiQ는 주권 과학 기반 모델을 구축하고 있습니다. 이러한 모델은 일반 언어 모델과 달리 물리학, 방정식, 수치 솔버에 대한 이해를 필요로 합니다. ZenteiQ는 이러한 모델을 사전 훈련하기 위해 대규모 합성 데이터 생성 파이프라인을 사용합니다. 이 파이프라인은 복잡한 과학적 도출 및 솔버 검증을 포함하는 수십억 개의 추론 토큰을 생성합니다.이전에 ZenteiQ는 Kubernetes에서 라우팅 병목 현상에 직면하여 엔진 큐가 불균등하고 중복 계산이 발생했습니다. 이로 인해 데이터 생성이 크게 느려지고 사전 훈련이 지연되었습니다. 이러한 문제를 극복하기 위해 ZenteiQ는 llm-d를 기반으로 하는 Google Kubernetes Engine(GKE) Inference Gateway를 구현했습니다. 이 솔루션은 추론 요청에 대해 지능적이고 로드 및 캐시를 고려한 라우팅을 제공합니다.GKE Inference Gateway는 서빙 노드 전반에 걸쳐 실시간 큐 깊이와 KV 캐시 활용도를 모니터링합니다. 요청을 효과적으로 라우팅하여 병목 현상을 방지하고 캐시된 프롬프트 접두사를 재사용합니다. 이러한 지능형 라우팅은 처리량을 극적으로 증가시켜 일일 출력량이 14억 7천만 개에서 거의 60억 개의 생성된 토큰으로 증가했습니다. 또한 사전 훈련 실행의 예측 가능성을 보장했습니다. ZenteiQ는 향후 고급 AI 훈련 단계에 이 설정을 활용할 계획입니다.