Google Cloud Blog на русском
Подписаться
Анонсируем llm-d 1.0: Открытый распределенный инференс для агентов на Google Cloud TPU и GPU
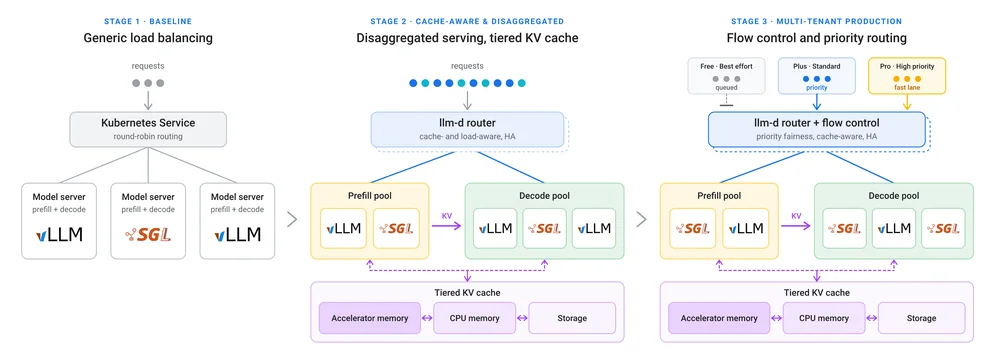
Сегодня отмечается выпуск llm-d 1.0 — открытого, нативного для Kubernetes стека для распределенного инференса LLM, разработанного сообществом, включающим Google, Red Hat и IBM. Этот проект объединяет сообщества PyTorch и Kubernetes для удовлетворения растущих потребностей в инференсе. Современные рабочие нагрузки на основе агентов, в отличие от простых чат-взаимодействий, включают многоэтапные процессы, использование инструментов и всплески трафика. Обслуживание их на отдельных машинах или с помощью базовых балансировщиков нагрузки оказывается неэффективным, что приводит к дублированию вычислений и зависанию интерактивных пользователей. llm-d превращает кластеры в скоординированные пулы обслуживания, что продемонстрировано на примере 1000 агентов на одном конечной точке. Ключевые особенности включают маршрутизацию с учетом кэша и многоуровневый KV-кэш для поддержания контекста агента, а также управление потоком для приоритезации интерактивных запросов во время всплесков трафика. Версия 1.0 предлагает многопользовательское качество обслуживания благодаря управлению потоком с учетом приоритетов и стабильную основу с защищенными API. Она также обеспечивает более безопасные обновления с высокой доступностью и обновлениями без простоя, а также возможности обслуживания с учетом агентов для повторного использования контекста. Расширенная интеграция TPU обеспечивает нативное обслуживание моделей PyTorch с временным разделением TorchTPU для повышения пропускной способности и утилизации. Компоненты llm-d являются составными, позволяя пользователям использовать только необходимые элементы обслуживания. Этот стек объединяет примитивы Kubernetes, движки обслуживания PyTorch и планирование с учетом ускорителей для гибкой производственной среды.