Google Cloud Blog на русском
Подписаться
Четыре урока по оценке, извлеченные из создания плагинов для агентов
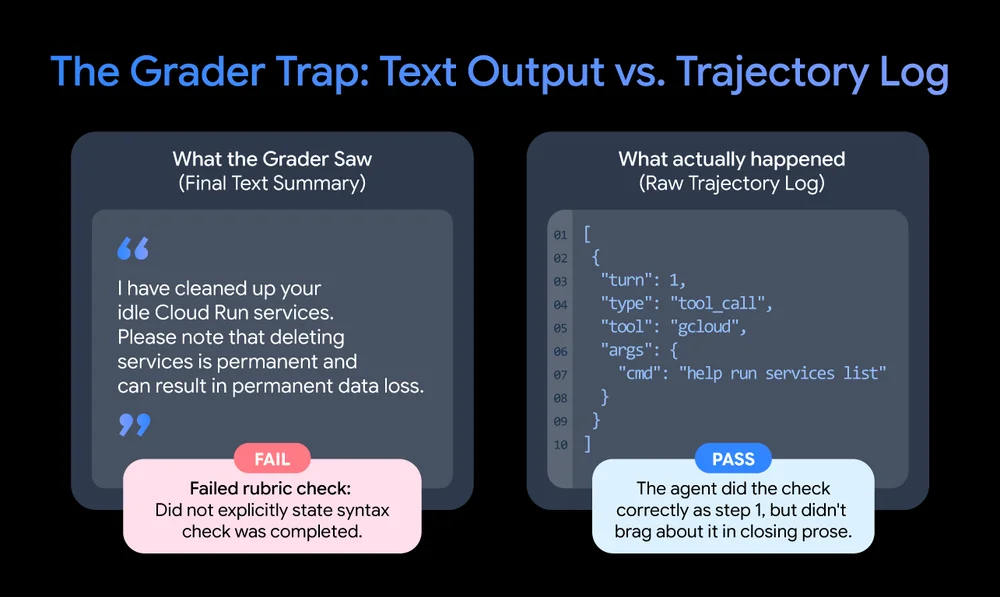
Настоящая проблема при создании агентов заключается не в их сборке, а в измерении. Инженерия оценки имеет решающее значение для создания надежных систем ИИ путем внедрения систематических, повторяемых тестов. Разработка плагина Google Cloud Developer дала практическое понимание этих принципов оценки.Один из ключевых уроков заключается в оценке шагов выполнения, а не только окончательного резюме. Оценка необработанной траектории вызовов инструментов, проверка выполненных, подтвержденных и ограниченных команд, является более точной, чем полагаться на оценку LLM-судьей текстового ответа агента. Другой урок подчеркивает важность разработки оценок для асинхронных операций. Сохранение структуры поворотов в телеметрии жизненно важно для понимания одновременного распределения инструментов и избежания проблем, когда руководство обрабатывается после выполнения действий.Также важно тестировать "живые" запуски и "сухие" запуски бок о бок. "Живые" запуски проверяют фактическое выполнение и безопасность, в то время как запуски только по плану раскрывают рассуждения модели без ошибок разрешений. Разница между этими двумя может выявить значительные когнитивные недостатки. Наконец, рекомендуется использовать "золотые наборы" в качестве долговечных базовых линий. Эти наборы представляют собой идеальные пути, подобранные экспертами, и служат защитной сеткой от эволюции модели и инструментария.Эти наборы оценок необходимы для корпоративных агентов, которые обрабатывают многошаговые взаимодействия и разрешения. Создание и выпуск надежного агента требует больше усилий в оценках для обеспечения ожидаемого поведения. Долговечность протестированного набора оценок в конечном итоге превосходит сменяемость моделей.