Google Cloud Blog на русском
Подписаться
Глобальное ИИ-маршрутирование с накладными расходами <1% на многокластерном GKE Inference Gateway
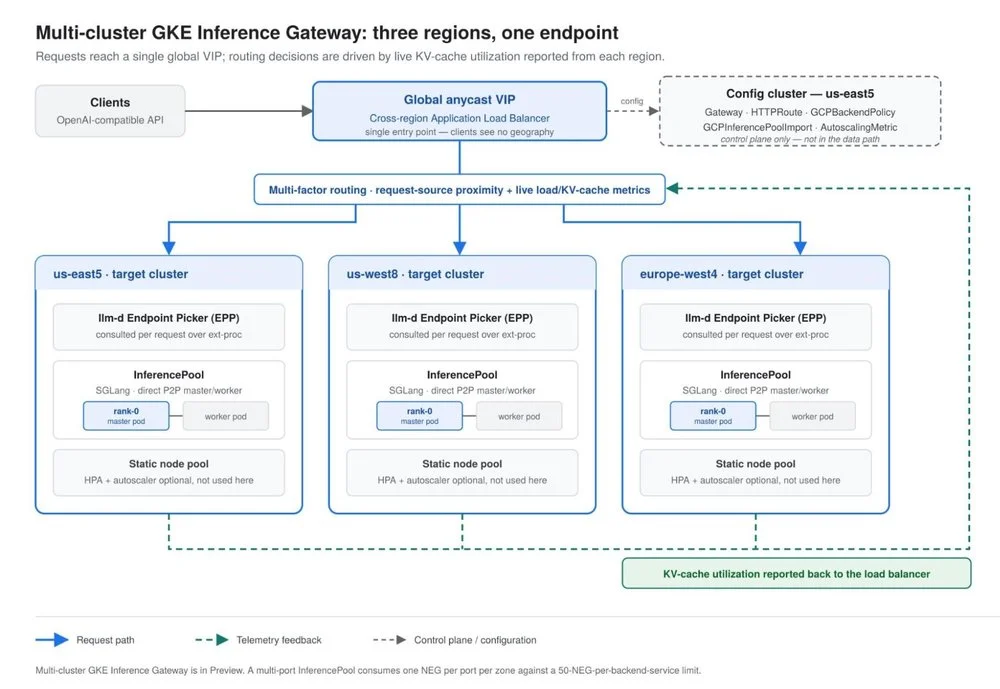
Спрос на инфраструктуру ИИ, особенно на ускорители, чрезвычайно высок, что приводит к дефициту и фрагментации вычислительных мощностей в глобальных центрах обработки данных. Современные рабочие нагрузки ИИ с большими контекстными окнами быстро потребляют память ускорителей, усугубляя проблемы с утилизацией. Для решения этой проблемы была разработана многоуровневая архитектура маршрутизации, позволяющая рассматривать разрозненные глобальные мощности как единый пул. Эта система включает в себя многокластерный GKE Inference Gateway для глобального распределения трафика и маршрутизатор LLM-d для планирования с учетом памяти. Архитектура разработана так, чтобы быть независимой от типов среды выполнения, моделей и ускорителей. Тестирование на крупном многорегиональном развертывании GKE продемонстрировало почти линейное масштабирование пропускной способности и 99,9% успешных операций. GKE Inference Gateway добавил менее 1% накладных расходов, обеспечив 99,5% пропускной способности прямых вызовов кластера. Трафик маршрутизируется на основе сигналов активного приложения, в частности, использования токенов KV-кэша, что позволяет системе интеллектуально перераспределять трафик между регионами. Эта маршрутизация с учетом памяти обеспечивает эффективное использование, предотвращая простой ускорителей из-за переполнения памяти. Результатом является максимальная "интеллектуальная мощность на доллар" за счет достижения почти пропорционального прироста производительности от добавленных ускорителей и избежания пустых капиталовложений. Ключевые выводы подчеркивают важность интеллектуальной балансировки нагрузки, учета узких мест памяти в агентских рабочих нагрузках, адаптации к задержкам трафика ИИ, интеграции маршрутизации с нативными шаблонами обслуживания и выбора открытых, переносимых стеков.