Netflix TechBlog | Medium на русском
Подписаться
Надежные вычисления на GPU для больших задач обучения и инференса
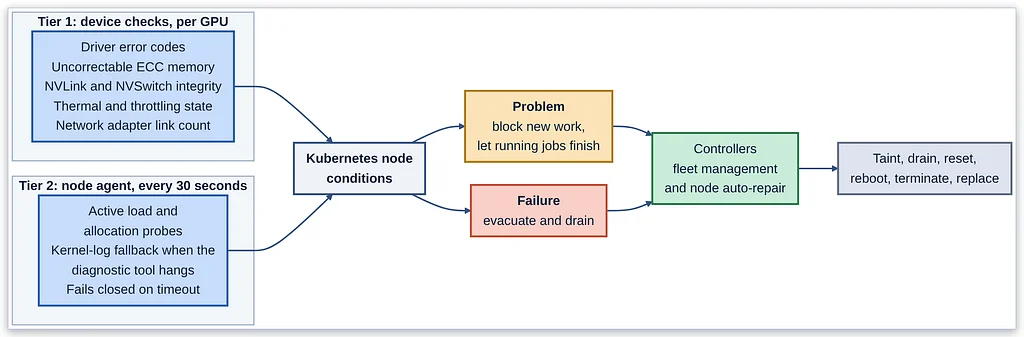
Netflix в значительной степени полагается на графические процессоры (GPU) для персонализированных рекомендаций контента и других приложений машинного обучения. Эти GPU имеют решающее значение для обучения и предоставления контента, что делает их надежность императивом для бизнеса как с точки зрения доступности, так и с точки зрения экономической эффективности. Базовые проверки работоспособности облачных провайдеров недостаточны, поскольку они не обнаруживают тонкие сбои GPU или сетевой фабрики, которые могут парализовать длительные задания обучения. Такие сбои могут проявляться в виде медленной производительности или полного прекращения работы задания, что влияет на пользовательский опыт и приводит к пустой трате ресурсов.Netflix использует многоуровневый подход для обеспечения работоспособности инфраструктуры GPU. Первый уровень фокусируется на обнаружении и устранении сбоев оборудования, такого как GPU и сетевые адаптеры. Второй уровень включает планировщик и платформу, которые повторно запускают задачи и проверяют машины перед их использованием. Третий уровень позволяет длительным заданиям переживать потерю машины благодаря контрольным точкам и эластичным рабочим процессам. Четвертый уровень — это наблюдаемость, которая отслеживает эффективность трех других уровней.Проверки работоспособности работают на двух уровнях: проверки на уровне устройств для отдельных GPU и проверки на уровне узлов, выполняемые агентом. Эти проверки сообщают результаты в виде условий узла Kubernetes. При обнаружении проблемы состояние машины обновляется, и контроллеры принимают меры. Первоначальные проблемы терпятся, но постоянные сбои приводят к эвакуации машины, ее очистке и замене.Устранение неисправностей градационное, действия соответствуют степени серьезности неисправности, от перезапуска одного GPU до завершения работы и замены всей машины. Для постоянно сбоящего оборудования записываются неизменяемые идентификаторы, чтобы предотвратить его повторное включение в пул. Машины проверяются перед выпуском на работу, чтобы убедиться, что они прошли все диагностические тесты. Наконец, длительные задания делаются устойчивыми благодаря контрольным точкам, что позволяет им возобновляться с последнего стабильного состояния в случае потери машины.