Google Cloud Blog на русском
Подписаться
Не все рабочие нагрузки LLM одинаковы: оценка производительности TPU при классификации и генерации
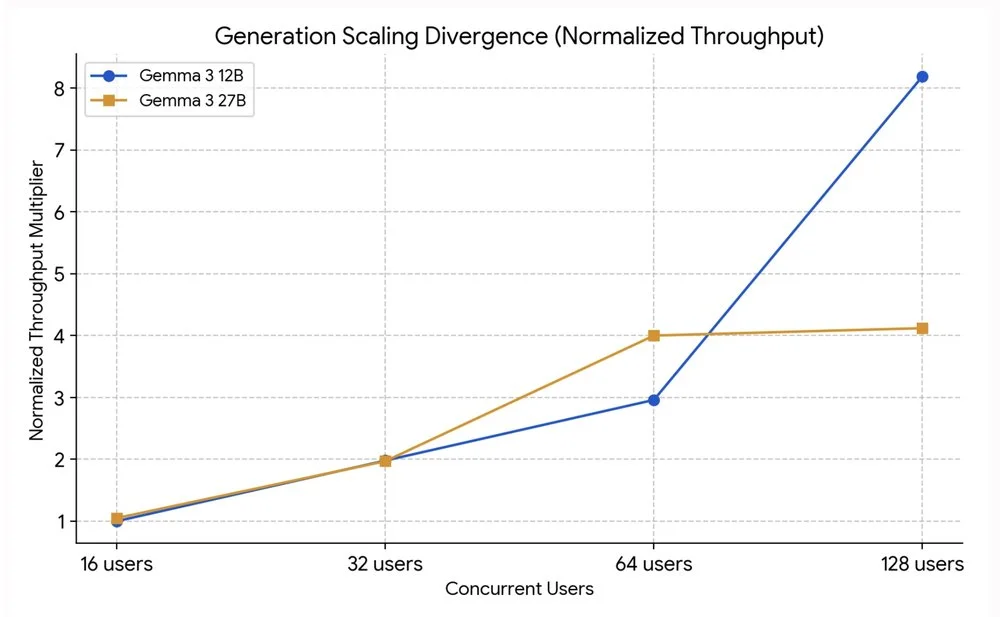
Внедрение больших языковых моделей (LLM) в корпоративном производстве выявляет критическую роль инфраструктуры в производительности и затратах. Не все запросы к LLM одинаково нагружают оборудование, что делает стандартные тесты недостаточными. Данное исследование сравнивает Gemma 3 12B и 27B на Google Cloud TPU v6e для понимания производительности инфраструктуры в масштабе при различных рабочих нагрузках. Для задач генерации с преобладанием декодирования модель Gemma 3 12B лучше масштабируется при высокой параллельности, в отличие от модели 27B, которая насыщается. Для задач классификации с преобладанием предварительного заполнения обе модели, 12B и 27B, демонстрируют схожее масштабирование, позволяя использовать более крупные модели без снижения пропускной способности. Насыщение оборудования вызывает всплески задержки и тихие отказы в обработке запросов, что требует масштабирования на основе сквозной задержки, а не только использования ЦП/памяти. Архитектура включает GKE, TPU v6e, фреймворк обслуживания vLLM и модели Gemma 3. Задачи классификации имеют большой ввод и малый вывод, в то время как задачи генерации имеют малый/средний ввод и большой вывод. Тесты показывают превосходство модели 12B в масштабировании генерации при высокой параллельности, тогда как обе модели работают схожим образом при классификации. Для оптимизации необходимо согласовывать выбор модели и конфигурации обслуживания с профилями ввода/вывода конкретных рабочих нагрузок.