DEV Community на русском
Подписаться
Оптимизация инференса LLM: Техники для более быстрого и дешевого ИИ
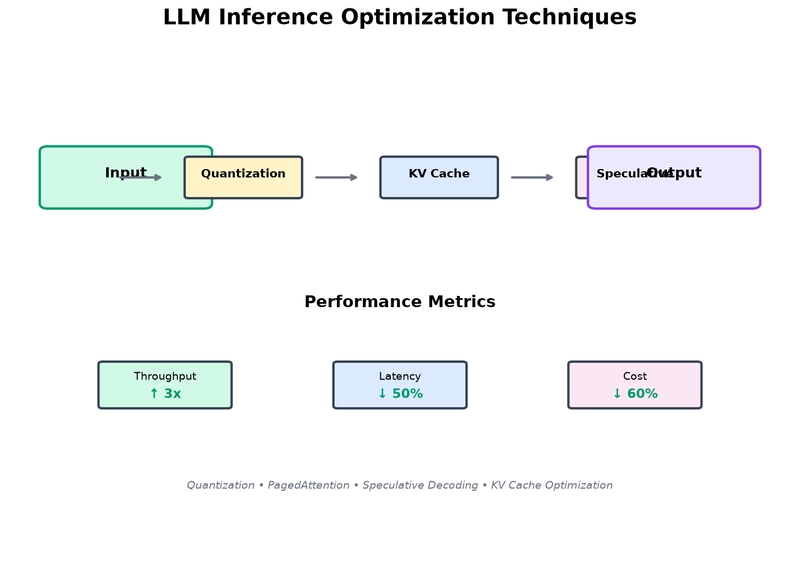
Большие языковые модели (LLM) сталкиваются с проблемами медленного инференса и высоких затрат по мере масштабирования приложений ИИ. Оптимизация инференса LLM имеет решающее значение для сокращения времени отклика, снижения вычислительных расходов и обеспечения более широкого развертывания. Квантование — это ключевой метод, который снижает точность весов модели, например, используя INT8 или INT4, что обеспечивает значительное ускорение при незначительных компромиссах в точности. Оптимизация KV-кэша, с использованием таких методов, как PagedAttention, повышает эффективность использования памяти для более быстрого генерирования, особенно при работе с длинными контекстами. Спекулятивное декодирование использует меньшую модель для предварительного создания токенов, которые затем проверяются большей моделью, достигая ускорения в 2-3 раза без снижения качества. Оптимизация промптов фокусируется на создании более кратких и структурированных промптов для минимизации использования токенов и связанных с этим затрат. Пакетная обработка, группируя несколько запросов, дополнительно повышает эффективность. Квантование предлагает существенные преимущества в скорости и стоимости, в то время как KV-кэш и спекулятивное декодирование обеспечивают ускорение без потери качества. Оптимизация промптов предлагает умеренные улучшения скорости и стоимости без влияния на качество. Реализация оптимизации KV-кэша часто является самым простым отправным пунктом, за которым следует квантование для периферийных устройств и спекулятивное декодирование для пропускной способности. Будущее принесет более продвинутые методы оптимизации, включая аппаратные решения и динамическую маршрутизацию. В конечном счете, лучшая стратегия оптимизации зависит от конкретных приоритетов: скорости, стоимости или поддержания качества модели.