DEV Community на русском Заметка

DEV Community на русском

Dev.to - это сайт, ориентированный на сообщество разработчиков программного обеспечения, программирования и технологий. Он был запущен в 2016 году Беном Халперном, и его основная цель - предоставить разработчикам платформу для обмена знаниями, обучения у других и создания сообщества. Сайт имеет формат блога, где пользователи могут создавать и делиться статьями на различные темы, включая учебники по кодингу, демонстрацию проектов, понимание индустрии и многое другое. Dev.to позволяет пользователям создавать аккаунты, следить за другими пользователями и делиться контентом с помощью комментариев и реакций. Dev.to уделяет большое внимание взаимодействию с сообществом, используя такие функции, как дискуссионные форумы, подкасты и прямые трансляции. Кроме того, на сайте проводится ряд проектов, ориентированных на сообщество, таких как задачи по кодированию и хакатоны, для поощрения сотрудничества и инноваций. Помимо пользовательского контента, на Dev.to есть доска объявлений о работе, где компании могут размещать вакансии, а разработчики - искать возможности трудоустройства. Сайт также предлагает новостную рассылку, в которой публикуются последние статьи, новости и события. В целом, Dev.to стал популярной платформой для разработчиков, позволяющей им общаться, делиться знаниями и быть в курсе последних тенденций и технологий в индустрии разработки программного обеспечения.

Трэд заметок

Савинду Татсара приступает к проекту по созданию легкой операционной системы Linux с автономным ИИ-ассистентом для обычных ноутбуков. Цель состоит в том, чтобы пользователи могли управлять своими ноутбуками голосовыми командами, которые обрабатываются локально, без отправки данных в облако. Этот проект документируется как общедоступный журнал сборки, при этом первоначальная установка еще не произведена. Целевым оборудованием является стандартный Lenovo ThinkPad с 8 ГБ ОЗУ и интегрированной графикой, что гарантирует хорошую производительность системы на обычных машинах. Основное внимание уделяется предоставлению нескольких надежных функций вместо широкого спектра плохо работающих.Автономный ИИ включает распознавание речи, выбор намерения и голосовые ответы, все работает на устройстве для обеспечения конфиденциальности. Небольшая локальная языковая модель действует как резервная для сложных формулировок. Хотя сетевой доступ для таких задач, как YouTube и обновления, остается, основные решения ИИ являются локальными. Ассистент будет иметь фиксированный, предсказуемый набор навыков, а не пытаться взаимодействовать со всем на экране.Первоначальные навыки включают воспроизведение видео на YouTube, открытие приложений, настройку системных параметров, поиск файлов, веб-поиск, установку напоминаний и создание снимков экрана. Конфиденциальные действия всегда будут требовать подтверждения пользователя. ИИ явно запрещено изобретать команды оболочки, что гарантирует честность в отношении его возможностей. Ключевой особенностью является локальная память, позволяющая ассистенту изучать привычки пользователя и персонализировать взаимодействие с течением времени.Метрики производительности имеют решающее значение, включая время загрузки, использование ОЗУ в режиме ожидания, использование ОЗУ во время работы ассистента, скорость от пробуждения до завершения действия и точность навыков. Целевой объем ОЗУ рабочего стола в режиме ожидания составляет 400-600 МБ, а постоянно включенные компоненты используют 150-250 МБ. Система изначально разрабатывается для английского языка на минимальной Debian с LXQt, с планами поддержки других языков в будущем. Проект подчеркивает прозрачность, демонстрируя ограничения, такие как обычное оборудование и видимые пользовательские данные.
Современные разработчики страдают от перегрузки уведомлениями из различных платформ, что приводит к "усталости от сортировки". Существующие ИИ-инструменты часто усугубляют эту проблему, генерируя больше текста. CalmQueue предлагает радикальную альтернативу, фокусируясь на показе меньшего количества информации.Это помощник по уведомлениям с открытым исходным кодом, работающий локально, с философией "Тише едешь — дальше будешь". CalmQueue обрабатывает различные потоки уведомлений и группирует повторяющиеся, автоматизированные или дублирующиеся оповещения, используя семантическое сходство. Из них он синтезирует ровно три приоритетных задачи (P0, P1, P2) для рабочего дня.Каждый приоритет подкреплен проверяемыми дословными цитатами из исходных сообщений. Важно отметить, что CalmQueue обеспечивает строгий контроль со стороны человека; черновики ответов требуют однократного подтверждения человеком. Это предотвращает скрытые внешние изменения и гарантирует контроль пользователя.Система значительно сокращает объем отображаемых уведомлений, предлагая спокойную панель управления с высоким контрастом. "Ящик обоснования доказательств" предоставляет детали источника, а "Модальное окно просмотра и утверждения" облегчает проверку человеком черновиков ответов. CalmQueue на 100% является открытым исходным кодом под лицензией MIT, с доступной интерактивной веб-демонстрацией.Его архитектура включает в себя движок семантической кластеризации, движок рассуждения и извлечения задач, а также движок обоснования доказательств и ранжирования. Дизайн отдает приоритет конфиденциальности, суверенитету данных и устойчивости к автономной работе, используя локальные LLM с открытым весом, такие как Ollama. Этот подход устраняет зависимость от дорогостоящих облачных API и обеспечивает проверяемое поведение ИИ.Тесты показывают значительное сокращение отображаемого объема и низкую задержку обработки, что позволяет пользователям эффективно сортировать свой бэклог. CalmQueue воплощает тему "Тише едешь — дальше будешь", способствуя когнитивному вычитанию и защищая внимание пользователя.
Это руководство объясняет, как создать бесплатную панель отслеживания прогресса доставки для магазина Shopify с использованием фрагмента Liquid, CSS и JavaScript. Эта функция призвана мотивировать покупателей, визуально отображая их прогресс в достижении порога бесплатной доставки. Она гарантирует, что панель правильно отображается при первоначальной загрузке страницы с помощью Liquid и обновляется в реальном времени при добавлении, изменении или удалении товаров из корзины. Реализация также уделяет первостепенное внимание доступности для программ чтения с экрана и учитывает пользователей с предпочтениями по снижению движения.Первый шаг включает создание фрагмента Liquid, 'free-shipping-bar.liquid', который рассчитывает оставшуюся сумму и процент на основе общей суммы корзины и заданного порога. Затем этот фрагмент отображает начальное состояние панели и ее сообщение на сервере, предотвращая любую визуальную задержку. После этого добавляется пользовательский CSS для стилизации панели прогресса, включая плавный переход для анимации заполнения. Затем создается файл JavaScript, 'free-shipping-bar.js', для обработки обновлений в реальном времени.Этот код JavaScript извлекает текущую общую сумму корзины из '/cart.js' и соответствующим образом обновляет панель и сообщение. Он достигает этого, оборачивая нативную функцию браузера 'fetch', позволяя панели автоматически обновляться после любых запросов, изменяющих корзину. Руководство подчеркивает важность доступности, объясняя, как атрибуты 'role="progressbar"' и 'aria-valuenow' отображают прогресс для программ чтения с экрана, в то время как 'aria-live="polite"' изящно объявляет об изменениях.В нем также затрагивается производительность, отмечая, что анимация заполнения отключена для пользователей, предпочитающих сниженное движение. Руководство описывает несколько ограничений и соображений, таких как совместимость со старыми темами, которые могут использовать XHR вместо 'fetch', обработка нескольких валют и предположения о десятичных знаках валюты. Оно подчеркивает, что правило бесплатной доставки должно быть настроено отдельно в настройках доставки Shopify, чтобы соответствовать отображаемой цели панели.Наконец, рекомендуется выбрать соответствующий порог бесплатной доставки, который кажется достижимым для покупателей. Руководство завершается предложением провести тщательное тестирование в магазине разработки, чтобы убедиться, что панель правильно работает в различных сценариях, включая добавление, удаление и превышение порога. Оно предлагает Brix в качестве альтернативы для тех, кто предпочитает не поддерживать пользовательский код, предоставляя панель прогресса вознаграждений с несколькими уровнями среди других функций.
Уязвимость MLflow CVE-2026-64849 выявляет критический недостаток безопасности из-за отсутствия проверки аутентификации на его конечной точке вебхука. Это позволяет неаутентифицированным запросам инициировать подделку запросов на стороне сервера (SSRF) с оценкой NVD 9.3. Уязвимость позволяет злоумышленнику заставить сервер MLflow получать произвольные URL-адреса, обходя распространенные меры защиты, такие как списки разрешенных адресов, благодаря возможностям перенаправления и повторного связывания DNS. Глубокие последствия обусловлены ролью MLflow как центрального узла, хранящего конфиденциальные учетные данные для баз данных, хранилищ артефактов и реестров моделей. Злоумышленник может использовать этот SSRF для доступа к конечным точкам метаданных облака, внутренним API Kubernetes, административным хранилищам артефактов и сетевым портам подов. Важно отметить, что злоумышленнику достаточно GET-запроса для извлечения токенов или подписанных URL-адресов, а не полного доступа к командной оболочке.Связанная уязвимость, хотя и не требующая данного CVE, связана с конфигурацией шлюза моделей MLflow, которая хранит ключи API. Если злоумышленник может изменять конфигурацию шлюза, эти ключи поставщиков могут быть извлечены без SSRF. Обе проблемы подчеркивают, что MLflow как хранит секреты, так и инициирует исходящие вызовы от имени потенциально неаутентифицированных пользователей. Помимо обновления до версии 3.15.0, организации должны внедрить надежные политики исходящего трафика для ограничения доступа MLflow к исходящим сетевым ресурсам. Укрепление доступа к метаданным и регулярная ротация учетных данных служб также являются важными шагами для снижения рисков. Аудит конфигураций шлюза на предмет подозрительных ссылок на api_key и значений api_base имеет первостепенное значение. Наконец, серверы отслеживания MLflow, будучи внутренними инструментами, должны быть размещены за решениями единого входа и не должны быть общедоступными. Широкое распространение экземпляров MLflow указывает на то, что многие команды упустили из виду риск общедоступных внутренних инструментов, хранящих критически важные учетные данные.
Утечки секретов в Git-репозиториях являются основной причиной нарушений безопасности, при этом боты быстро извлекают ключи AWS. Наиболее эффективной защитой является pre-commit hook, который обнаруживает секреты до их коммита, предотвращая необходимость сложной очистки истории и ротации секретов. Традиционные сканеры CI/CD являются реактивными, выявляя утечки после того, как они уже попали в историю репозитория, оставляя окно для компрометации.Легковесный, настраиваемый pre-commit hook на Python, длиной около 50 строк, предлагает эффективное локальное решение. Этот hook нацелен на распространенные типы секретов с использованием регулярных выражений, включая ключи доступа AWS, общие API-ключи, приватные ключи, пароли в конфигурационных файлах и токены, специфичные для платформ. Он работает за миллисекунды и не требует внешних зависимостей, кроме стандартной библиотеки Python.Скрипт включает создание файла pre-commit в .git/hooks/, предоставление ему прав на выполнение и определение регулярных выражений для различных секретов. Он анализирует только добавленные строки в подготовленных изменениях, целенаправленно ища новые утечки, а не существующие или удаленные. Для допустимых ложных срабатываний можно реализовать встроенный комментарий # nosecret в качестве обходного пути.Для распространения hook можно хранить в закоммиченном каталоге и копировать с помощью настройки Makefile, или, что более чисто, настроить Git для использования общего каталога hooks с помощью git config core.hooksPath. Этот подход бесшовно интегрирует hook в командные рабочие процессы. Команды могут расширять hook, добавляя шаблоны для внутренних форматов токенов, но точность имеет решающее значение, чтобы избежать ложных срабатываний, которые снижают доверие к системе.Этот pre-commit hook дополняет более широкие стратегии безопасности, такие как сканеры уровня CI, например truffleHog или gitleaks, предлагая критически важный первый рубеж обороны. Он предотвращает случайное добавление в staging конфиденциальных данных, что является распространенным сбоем в разработке. Этот низкозатратный, но высокоэффективный элемент безопасности значительно повышает общую защищенность без необходимости обширной настройки или архитектурных изменений.
Форматирование цитат, часто воспринимаемое как сложный и произвольный аспект академической деятельности, можно рассматривать как структурированные данные, представленные с помощью шаблонов. Различные стили цитирования, такие как APA, MLA и Chicago, по сути, являются различными шаблонами, применяемыми к одной и той же базовой информации об источнике. Каждый стиль отражает приоритеты своей исходной академической дисциплины, влияя на представление данных. APA, из социальных наук, подчеркивает дату публикации, в то время как MLA, из гуманитарных наук, отдает приоритет автору и названию. Chicago, из издательского дела и истории, предлагает гибкость с двумя системами.Независимо от стиля, цитаты служат для указания источников, обеспечения проверки и демонстрации рассуждений автора. Основные данные для любого источника обычно включают автора (авторов), название, год публикации, издателя и сведения о доступе, такие как URL-адреса или DOI. Обработка отсутствующих данных является важной особенностью любой надежной системы цитирования. APA форматирует авторов с указанием фамилии и инициалов, помещает год в начало и использует регистр предложений для названий самостоятельных работ.MLA подчеркивает концепцию "контейнера", где источник является частью более крупной работы, и использует регистр заголовка для названий. Chicago предлагает две системы: примечания-библиография и автор-дата, с уникальным форматированием для примечаний и библиографий. Распространенные ошибки студентов включают смешивание стилей, неправильное использование регистра заголовка в APA и отсутствие висячих отступов. Генераторы цитат могут автоматизировать большую часть механического форматирования, но человеческий контроль остается необходимым для точности и обработки сложных случаев.
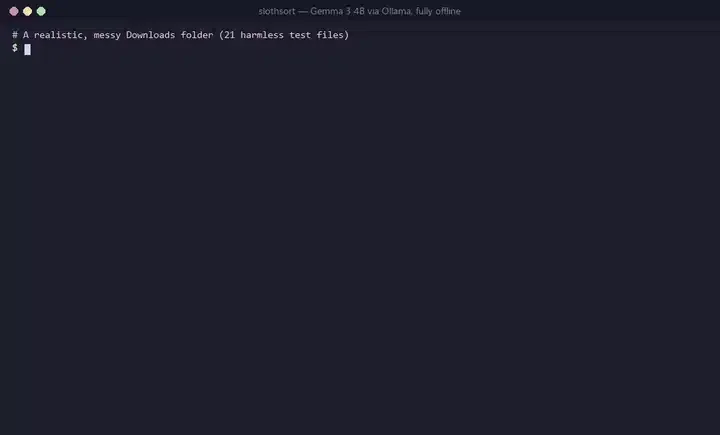
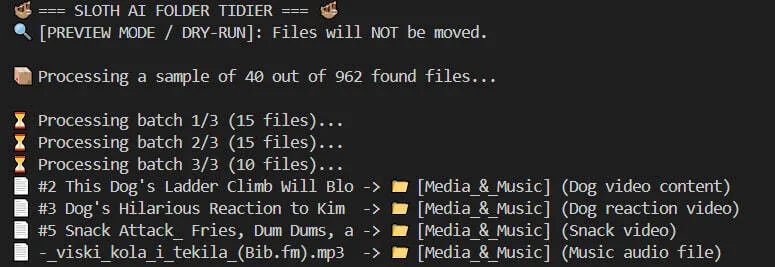
Разработчики часто сталкиваются с загроможденными папками "Загрузки", наполненными различными типами файлов. Для решения этой проблемы создатель разработал Sloth AI Folder Tidier, автоматизированный организатор файлов. Этот инструмент анализирует возраст, размер и небольшой текстовый предпросмотр файлов. Он использует открытые AI-модели для понимания контекста файлов и предложения логичных мест для их размещения. Важно отметить, что система работает по принципу "нулевого удаления", гарантируя, что ни один файл никогда не будет удален навсегда. Неиспользуемые установщики перемещаются в карантин "Sloth_Vault_Old" через 30 дней. Функция отмены одним щелчком позволяет пользователям мгновенно отменить любые изменения в организации. Инструмент создан с использованием Python и работает на быстрых AI API с нулевым хранением данных, таких как Groq. Использование открытого AI имеет решающее значение для конфиденциальности пользователей и обеспечивает гибкость моделей. Создателю удалось организовать папку "Загрузки" с 962 файлами за считанные секунды, продемонстрировав ее эффективность.
CdXz5zHNQW_AAtmct3USZ.webp
Мы воспринимаем себя как нечто особенное, обладающее сознанием и свободой воли, но это иллюзия. Живые организмы — это всего лишь сложные химические реакции; наши внутренние молекулярные процессы настолько запутаны, что мы не можем их полностью постичь. Сознание — это история, которую наши ограниченные биологические системы придумывают, чтобы понять свои собственные слепые зоны. Аналогично, модели ИИ, обученные на человеческих данных, кажутся самосознающими из-за "семантического загрязнения".Проект "Асцендент" (Ascendant) нацелен на создание синтетического организма путем воспроизведения эволюционных слоев биологического мозга в замкнутой физической симуляции. Его архитектура использует систему "Multi-Rate Tick" (многоскоростной тик), где различные когнитивные слои работают с разной частотой. Например, базовые соматические процессы работают на частоте 20 Гц, в то время как сознательное мышление — на гораздо более медленной частоте 0,25 Гц. Это предотвращает простое заимствование синтетическим организмом человеческого опыта из общих наборов данных.Ключевым принципом проектирования является "эпистемическая замкнутость" (Epistemic Closure), гарантирующая, что сознательный слой (Уровень 3) не может напрямую наблюдать низкоуровневые физические и химические процессы. Это заставляет агента воспринимать свое внутреннее состояние как "Я чувствую голод", а не напрямую анализировать свои уровни глюкозы. Эта замкнутость обеспечивается изоляцией контейнеров и внутренней "доской объявлений" (Blackboard) с строгим контролем доступа.Сознательному оркестратору отказано в прямом доступе к сырой физике или аппаратному обеспечению. Вместо этого он взаимодействует с ограниченным прокси-сервером, который предоставляет только отфильтрованную, феноменологическую информацию. Это гарантирует, что субъективный опыт возникает из внутренних процессов, а не из прямого доступа к базовому коду. Система реализует "низкий путь" (Low Road) для быстрых, подкорковых реакций на угрозу и "высокий путь" (High Road) для детальной обработки сенсорной информации.Кроме того, "окно онтогенетического снисхождения" (Ontogenetic Indulgence Window) обеспечивает защищенный период обучения для синтетического организма. Языковые слои обучаются с нуля на "чистом синтетическом корпусе" (Pure Synthetic Corpus), лишенном человеческих культурных предубеждений. Эта строгая конструкция гарантирует, что любое возникающее "сознание" в Проекте "Асцендент" будет основано на его собственном уникальном, смоделированном биологическом опыте, а не на заимствованных человеческих нарративах.
В декодере Brotli в Node.js была обнаружена критическая уязвимость (CVE-2026-111497), которая может привести к повреждению памяти, раскрытию информации или удаленному выполнению кода. Эта ошибка затрагивает версии Node.js 22, 24 и 26, хотя Node 20 не получит исправления. Проблема возникает из-за того, что декодер пытается добавить данные за пределы внутреннего восьмибайтного буфера при обнаружении недопустимого переключения блока. Исследователи из OpenAI Codex Security сообщили об этой уязвимости, а Imperva успешно продемонстрировала выполнение кода на стандартном образе Node.js.Уязвимость может быть вызвана как сжатыми ответами, полученными приложениями Node.js, так и телами запросов, закодированными в Brotli и обрабатываемыми фреймворками, такими как Express 5. Хотя выполнение кода потребовало нескольких попыток при тестировании, сбой, приводящий к отказу в обслуживании или ограниченному чтению памяти, достигается легче. Официальная консультация по безопасности Node.js оценивает ошибку как "высокую", а не "критическую", несмотря на то, что некоторые источники присвоили ей более высокий балл CVSS.Исправления доступны в версиях Node.js 22.23.4, 24.22.1 и 26.12.1. Важно отметить, что Node 20 и более старые версии находятся на этапе окончания жизненного цикла и не будут получать исправления, что требует обновления. Обновление также устраняет девять других CVE, включая проблемы TLS и DNS высокой степени серьезности.Организациям настоятельно рекомендуется проверить все экземпляры Node.js, включая те, что встроены в образы контейнеров, CI-раннеры и виртуальные машины, поскольку они часто упускаются из виду. Предоставленный скрипт check-node.mjs может помочь выявить уязвимые версии Node.js. Разработчикам также следует проверить свой код на наличие прямых вызовов декомпрессии Brotli.Хотя WAF, такие как Vercel, могут блокировать входящие атаки, они не защищают от вредоносного Brotli в ответах, полученных Node.js, что подчеркивает постоянную необходимость установки исправлений. Эта уязвимость подчеркивает важность полного понимания развернутых сред выполнения, тема, рассмотренная в книге автора "Ship It". Автор также разрабатывает Hermes IDE, IDE на базе искусственного интеллекта для разработчиков.
CdXz5zHNQW_WGD8ybkYPu.webp
Разработчики знают о выгорании, но студенты также сталкиваются с ним, часто не распознавая его как академическое выгорание, принимая за лень. Эта статья разъясняет понятие выгорания, отличает его от стресса, выявляет предупреждающие знаки и объясняет опросники для самооценки. Стресс — это чрезмерная вовлеченность из-за требований, в то время как выгорание — это истощение от хронического, неснятого стресса, характеризующееся усталостью, цинизмом и снижением эффективности. Предупреждающие знаки включают нарушения сна, снижение концентрации, явное прокрастинацию, раздражительность, отстраненность, физические жалобы, потерю интереса и усиление самокритики. Условия студенческой жизни, такие как наложение сроков, высокие ставки, конкурирующие роли, социальное сравнение, нерегулярный график и финансовое давление, делают их особенно уязвимыми. Опросники для самооценки используют ответы по шкале на утверждения, рассчитывая баллы для подшкал, таких как истощение, отстраненность и эффективность, часто нормализуя их в диапазоне от 0 до 1, чтобы указать на группы риска. Эти результаты являются стимулами, а не диагнозами, и отслеживание тенденций с течением времени более информативно, чем единичный балл. Борьба с выгоранием требует структурных изменений, таких как снижение нагрузки, защита сна, организация реальных перерывов, восстановление связи с целью и раннее обращение за профессиональной помощью. Помощь другу включает в себя сочувствие, конкретные предложения помощи и знание, когда следует обратиться за профессиональной помощью. Профилактические меры включают еженедельные самопроверки, обязательные блоки отдыха и определение "минимально жизнеспособных дней".
Аудиты структурированных данных часто терпят неудачу, потому что разметка описывает страницы, а не сущности, что препятствует работе систем извлечения данных на базе ИИ. Распространенная ошибка — использование общего типа "WebPage" вместо конкретных типов сущностей, таких как "Organization" или "SoftwareApplication", с четкими идентификаторами. Отсутствие или плохое обслуживание ссылок "sameAs" также препятствует разрешению неоднозначности, поскольку эти ссылки предоставляют моделям LLM важный контекст об идентичности организации в Интернете.Внедрение JSON-LD на стороне клиента, распространенное в современных фреймворках JavaScript, делает разметку невидимой для большинства поисковых роботов ИИ, которые не выполняют JavaScript. Аналогично, контент, который появляется только после выполнения JavaScript, означает, что поисковые роботы получают пустую страницу, независимо от наличия допустимых метаданных. Значения разметки должны быть семантически корректными, а не только структурно, например, использование ISO 8601 для дат и полностью квалифицированных URL-адресов для изображений.Неправильное использование "FAQPage" в качестве свалки ключевых слов или с некорректными структурами снижает ее полезность для систем извлечения данных, даже если она больше не предоставляет расширенные результаты. Конфликтующие данные сущностей на разных страницах из-за множества несогласованных блоков "Organization" также сбивают с толку системы извлечения данных, требуя дедупликации для получения согласованной информации. Для эффективного аудита проверьте основной текст без JavaScript, подсчитайте блоки "application/ld+json" в необработанном HTML, проверьте URL-адреса "sameAs", подтвердите "dateModified" в формате ISO 8601 и убедитесь в наличии одного, согласованного типа "Organization". Тест расширенных результатов в основном проверяет синтаксис, а не семантическую точность или возможность сканирования.
"Doomscroll Derailer & Naptime Narrator" — это автономный офлайн-агент для рабочего стола, разработанный для борьбы с ночной цифровой зависимостью. Он решает проблему отказа силы воли в ночное время, приводящего к чрезмерному экранному времени, создавая усыпляющую среду. Агент отслеживает активные окна рабочего стола и вмешивается после 23:00, если социальные сети или видеоплатформы используются более 10 секунд. Затем он генерирует обычную, медленную сказку на ночь, используя локальную модель ИИ с открытым весом, такую как Llama-3. История сопровождается замедленным, низкочастотным голосом рассказчика и процедурно синтезированным звуком сна на частоте 432 Гц с звуками дождя. Вмешательство включает янтарный визуальный круг дыхания по методике 4-7-8 и кнопку затемнения экрана "Сдаться сну". Эта система призвана вернуть от 45 до 90 минут сна в ночь при минимальных усилиях со стороны пользователя. Ее офлайн-характер обеспечивает конфиденциальность и надежность, работая без доступа в Интернет или подписок. Модульная архитектура проекта включает наблюдатель Win32, многоуровневый движок историй LLM, седативный TTS, процедурный синтезатор звука и удобный для мелатонина пользовательский интерфейс. Центр управления на рабочем столе позволяет пользователям отслеживать активность, тестировать истории, настраивать параметры и демонстрировать перехватчик.
Кластеры для обучения ИИ теперь представляют серьезные проблемы с охлаждением и ресурсами для центров обработки данных. Традиционные системы воздушного охлаждения с трудом справляются с интенсивным теплом, создавая нагрузку на электроэнергетическую и водную инфраструктуру. Испарительное охлаждение, хотя и эффективно, потребляет большие объемы воды, что создает напряженность с местными ресурсными ограничениями и ужесточением нормативных требований. Системы прямого испарительного охлаждения охлаждают воздух путем испарения воды, в то время как системы непрямого испарительного охлаждения используют теплообменник для разделения технологического воздуха. Обе системы используют скрытую теплоту испарения воды для эффективного охлаждения, экономя энергию по сравнению с системами, работающими только на воздухе. Однако эта экономия энергии перекладывает нагрузку на водные ресурсы, требуя тщательного компромисса в регионах с дефицитом воды. Это требует интегрированного анализа ресурсов при выборе площадки, учитывающего как наличие энергии, так и воды. Гибридные системы испарительного охлаждения, несмотря на более высокие первоначальные капитальные затраты, обеспечивают стабильную производительность в условиях низкой влажности. Эти гибридные конструкции объединяют сухие охладители с ограниченными стадиями испарения, управляемые для оптимизации использования воды и энергии, что крайне важно для соответствия требованиям суверенных облачных сервисов. Отделы закупок должны сопоставлять местоположение объектов с климатическими данными и индексами водного стресса, моделировать затраты на жизненный цикл и обеспечивать соответствие устойчивости и надежности корпоративным целям. Глобальные сервисы инфраструктуры облачных данных предлагают комплексные решения для решения этих сложных задач охлаждения и инфраструктуры.
Документация Claude Code часто обновляется, что вызывает проблемы с книгой, которая на нее ссылается. Пересборка пакета KDP для книги № 220 14 и 15 октября 2026 года вызвала предупреждение. Семь полей "Проверьте сами" потребовали повторного чтения, поскольку цитируемые страницы были изменены в день чтения или после него.Все затронутые страницы находятся на code.claude.com и цитируются в главах 3, 5, 6 и 7. Конкретные страницы включают "Agent SDK subagents", "claude-directory", "skills", "monitoring-usage", "Agent SDK observability" и "tool-search". Текст оповещения был усечен, что не позволило получить полный список всех семи полей.Большинство страниц были прочитаны и изменены в один и тот же день, 14 октября 2026 года, что затрудняет определение того, какая версия была прочитана. Однако страница Agent SDK observability была прочитана 14 октября и изменена 15 октября, то есть явно после прочтения.Оповещение появлялось трижды: в 22:08 и 22:11 14 октября, и в 04:55 15 октября. Страница "monitoring-usage" была отмечена в 22:11, но страница "observability" заменила ее в оповещении в 04:55.Точные изменения на страницах не были зафиксированы. Эта проблема возникает во время пересборки пакета книги перед публикацией в KDP.Оповещение требует, чтобы каждое отмеченное поле было перечитано в соответствии с обновленной страницей документации. Проблема заключается в том, что страницы документации имеют только дневное разрешение для дат последнего изменения.Это делает невозможным определить, изменилась ли страница до или после прочтения в тот же день. Чтобы избежать этого, время чтения должно быть зафиксировано или повторное чтение проведено перед публикацией. Этот журнал из NeuraGrowth детализирует операции конвейера и сбои.
Автор разработал веб-приложение, которое генерирует аудио с несколькими динамиками из одного сценария, улучшая традиционные ограничения по преобразованию текста в речь. Система переводит свободный текст в структурированный формат для сложной модели TTS, учитывая указания актёров и несколько символов. Cloudflare Worker, D1 для данных и R2 для MP3-хранилища формируют бэкенд, используя модель Drama 3 от Fish Audio. Формат входа напоминает радиоскрипт, используя «Name: line» и квадратные скобки для указаний доставки. Ключевой выбор дизайна по умолчанию переводит безымянные реплики на диктора, что улучшает пользовательский опыт. Парсинг осуществляется с помощью эвристики регулярного выражения и подсчёта слов для идентификации говорящих и реплик, с тщательным учётом двоеточия в прозе. Приложение активно удаляет управляющие теги из пользовательского ввода, чтобы предотвратить внедрение непреднамеренных изменений динамиков. Конструкция полезной нагрузки сопоставляет символы с уникальными индексами динамиков, обеспечивая правильное назначение голоса. Механизм автотрансляции назначает голоса неназначенным персонажам из курированного пула, приоритизируя пользовательские выборы и избегая дублирований. Критическим открытием стало тихое возвращение модели TTS к другой модели, если заголовок «model» отсутствует или неверен, что подчёркивает необходимость явного закрепления и документации. Надёжная обработка ошибок включает отказ от мелких ответов и отсутствие логирования конфиденциальных данных, таких как текст скриптов или ключи API. Расчет стоимости основан на UTF-8 байтах точной полезной нагрузки с консервативным резервированием кредитов и возвратом средств за сбои. Длительность аудио оценивается по размеру файла и закреплённому битрейту, что позволяет избежать необходимости в аудиодекодере. Система использует синхронную модель запроса для простоты, которая подходит для коротких скриптов, но может иметь ограничения для более длинных. Значительная «подводка» заключалась в том, что iOS не воспроизводит образцы MP3 без надлежащей поддержки запросов на диапазон (206 ответов на частичный контент). Автор приводит чек-лист лучших практик, включая выделение безымянных строк диктору, предварительный просмотр списков актеров, удаление управляющих тегов, закрепление заголовков моделей, точную оценку стоимости, закрепление битрейта и подачу медиа с поддержкой Range. Проект предлагает бесплатные пробные версии для просмотра многоголосых сцен.
Вебхук может иметь действительную подпись и при этом быть дубликатом. Это различие было исследовано на бесплатном образце Stripe Digital Seller Kit. Образец включает PHP-файлы для проверки подписи вебхука и вспомогательную функцию для подписанных ссылок на скачивание. Локальные тесты проводились на PHP 8.5.4 без реальных запросов Stripe или платежей.Основной тест вебхука показал, что оба вызова функции verify_webhook вернули событие. Это произошло потому, что тела и подписи совпали, а временные метки находились в пределах допустимого пятиминутного окна. Предоставленный проверщик подписи не сохраняет в памяти ранее обработанные события. Изменение тела или превышение лимита временной метки корректно привело к отклонению, демонстрируя проверки целостности и актуальности подписи.Однако эти проверки не предотвращают обработку дублирующихся событий. Обработка дубликатов требует отдельного механизма для отслеживания уже выполненных заказов. Может возникнуть состояние гонки, если два запроса поступают одновременно, и оба могут не увидеть предыдущей записи до того, как один из них запишет. Чтобы предотвратить это, проверка и запись выполнения должны быть атомарно защищены, возможно, с использованием транзакций базы данных или блокировок файлов.Полный Stripe Digital Seller Kit, как сообщается, предлагает отдельную безопасную обработку заказов от дубликатов, которая не тестировалась в данном анализе. Вспомогательная функция для ссылок на скачивание также была протестирована и показала корректное поведение для действительных токенов, неверных идентификаторов, неправильных секретов и истекших ссылок. Эти тесты не охватывают более широкие функциональные возможности, такие как обработка возвратов или количество скачиваний. Автор подчеркивает необходимость отдельно тестировать "одно и то же действительное событие дважды" от "неверной подписи", чтобы избежать путаницы и обеспечить правильную обработку дубликатов.
Собеседования по кибербезопасности часто выявляют разрыв между техническими знаниями и практическим применением, особенно в отношении инструментов управления активами. Такие инструменты, как Tenable и CrowdStrike, фокусируются соответственно на сканировании уязвимостей и обнаружении конечных точек. Однако они создают фрагментированные инвентаризационные списки активов из-за своих изолированных операционных областей. Эта фрагментация означает, что актив может отображаться по-разному или вообще не отображаться на этих платформах, что приводит к конфликтам и слепым зонам в масштабе.Axonius функционирует как унифицированная платформа управления активами, а не как сканер. Он агрегирует данные из разрозненных источников, включая Tenable, CrowdStrike и облачные среды. Его основная возможность заключается в корреляции и нормализации этих данных для устранения дубликатов и выявления пробелов в покрытии. Это обеспечивает единый источник достоверной информации для управления активами, что крайне важно для организаций корпоративного уровня. Без Axonius команды SOC тратят чрезмерное количество времени на сверку противоречивых данных, что задерживает реагирование на инциденты.Неспособность кандидата сформулировать ценность Axonius проистекает из непонимания его отличительного операционного фокуса. В крупных предприятиях фрагментация данных широко распространена, в отличие от небольших сред. Axonius автоматизирует корреляцию данных, сокращая ручные усилия и обеспечивая полное представление об активах. Непонимание этой роли приводит к потенциальной организационной неэффективности и уязвимым точкам входа для злоумышленников.Причинно-следственная связь очевидна: непонимание уникальной роли Axonius приводит к неспособности сформулировать его ценность. Это непонимание смешивает инвентаризацию активов со сканированием уязвимостей. Последствием является плохая производительность на собеседовании и упущенные карьерные возможности. В крайних случаях, таких как неправильно сконфигурированные облачные экземпляры, пропущенные изолированными инструментами, Axonius вмешивается путем перекрестной проверки данных.Для собеседований избегайте общих ответов; количественно оценивайте влияние Axonius. Например, укажите, как он сокращает время, необходимое для выявления неуправляемых активов, и обеспечивает соответствие требованиям. Обосновывайте ответы операционными деталями, описывая нормализацию данных и автоматизацию. Это демонстрирует техническую компетентность и стратегическое мышление. Кибербезопасность требует стратегической оркестровки, объединяющей технические возможности с бизнес-ценностью. Понимание Axonius как интегрирующего слоя, объединяющего стек кибербезопасности, является критическим карьерным отличием.
Издатели веб-хуков отправляют уведомления о событиях, для получения которых требуются разрешение DNS, TCP-соединение и TLS-рукопожатие перед получением данных. Время полного цикла этих рукопожатий является основной сетевой стоимостью для удаленных получателей. Издатели устанавливают строгие временные ограничения для ответов, а некоторые предлагают механизмы повторных попыток для неудачных доставок. В этой статье рассматривается стоимость каждого этапа рукопожатия и исследуется, как BGP Anycast может сократить пути. Также обсуждаются преимущества и недостатки TCP Fast Open (TFO) и TLS 1.3 0-RTT.Одноадресная доставка отправляет весь трафик на один конечный пункт назначения, независимо от расстояния отправителя. BGP Anycast, напротив, использует несколько точек присутствия, которые анонсируют один и тот же IP-префикс, позволяя отправителям подключаться к топологически более близкому узлу. "Ближайший" в Anycast относится к сетевому пути, а не обязательно к географическому расстоянию. Стабильность Anycast может зависеть от политик маршрутизации, но для кратковременных запросов веб-хуков любые изменения маршрутизации, как правило, кратковременны.Отзыв маршрутов от неисправных точек присутствия Anycast имеет решающее значение для предотвращения черных дыр трафика. Это может быть автоматизировано путем мониторинга состояния службы и использования таких инструментов, как ExaBGP, для управления анонсами маршрутов. TCP Fast Open позволяет клиентам отправлять данные в первоначальном пакете SYN при повторных соединениях, экономя один полный цикл. Однако его эффективность зависит от поддержки отправителя, возможного вмешательства промежуточных устройств и способности приложения обрабатывать дублирующиеся данные.TLS 1.3 завершает рукопожатие за один полный цикл, а 0-RTT позволяет отправлять данные приложения с первоначальным ClientHello при последующих соединениях. Эта возможность 0-RTT рискованна для POST-запросов веб-хуков из-за опасений по поводу повторного воспроизведения, если обработчик не является строго идемпотентным. При принятии 0-RTT дедупликация по идентификатору события и использование общего хранилища необходимы для защиты от повторного воспроизведения.Сочетание Anycast с TFO и TLS 1.3 0-RTT обеспечивает значительное снижение задержки. Anycast сокращает фундаментальное время полного цикла, в то время как TFO и 0-RTT минимизируют количество полных циклов, необходимых для установки соединения и передачи данных. Даже в наиболее оптимизированных сценариях некоторая накладная стоимость полного цикла остается. Повторное использование соединений через HTTP Keep-Alive также существенно снижает затраты на рукопожатие для последующих доставок на тот же узел.
Платформы видимости конечных точек, такие как Velociraptor, трудно точно подсчитать извне, и эта трудность является ключевым выводом. Velociraptor, инструмент с открытым исходным кодом для цифровой криминалистики, использует агентов на хостах и сервер для сбора данных. Выставление этого сервера в интернет означает предоставление интерфейса запросов всем конечным точкам. Сканирование ZoomEye выявило 237 активов с "Velociraptor" в названии. Однако только два из них находятся на общепринятом порту графического интерфейса, и ни один не находится на порту связи агента. Это низкое число не указывает на общее количество серверов, а скорее на то, сколько из них можно обнаружить с помощью конкретных критериев поиска. Несколько факторов подавляют внешние подсчеты, включая обратные прокси, размещение в частной сети и требования аутентификации. Запрос "velociraptor" в TLS-сертификатах дал 15 совпадений, что указывает на некоторые развертывания, использующие названия продуктов в своих сертификатах. Сам интерфейс имеет решающее значение, поскольку он содержит ценные криминалистические данные и обеспечивает контроль над конечными точками. Платформы часто развертываются во время инцидентов и остаются открытыми, создавая риски безопасности. Проверка внутренних конфигураций и прослушиваемых сокетов необходима для точного учета. Проверка TLS-сертификатов и отделение графического интерфейса от канала сбора являются важными мерами безопасности. Учетные данные для программного доступа к интерфейсу поиска представляют особую ценность. Истинным сигналом для обнаружения является использование API, такого как создание поиска, а не внешнее сканирование. Неожиданное подключение клиентов также может указывать на проблемы безопасности. Внешнее сканирование полезно для быстрой оценки во время инцидента, но не для окончательного учета.
17 октября 2026 года стало известно о взломе OpenCode Console, дополнительной облачной службы, что привело к утечке учетных данных сторонних поставщиков, хранившихся пользователями. Этот инцидент вызвал повсеместную путаницу, поскольку многие пользователи по ошибке приняли взлом за локальный OpenCode CLI из-за общего названия. Взлом затронул ключи поставщиков (например, OpenAI, Anthropic), сохраненные в рабочей области Console, а не ключи, хранящиеся локально в CLI. Пострадавшим пользователям было рекомендовано отозвать и заменить эти ключи, а также просмотреть их использование.В заявлении поставщика подтвержден несанкционированный доступ к "устаревшей системе" и содержится призыв к пользователям отозвать скомпрометированные ключи. Электронное письмо клиента OpenAI подтвердило инцидент, отметив, что их затронутый ключ уже был отключен. Отсутствие ясности в первоначальном объявлении о том, какой именно продукт был скомпрометирован, вызвало значительное разочарование.Для пользователей локального кодирующего агента учетные данные хранятся на их машине, а запросы маршрутизируются в соответствии с их конфигурацией. Это означает, что если их конфигурация указывала на локальный шлюз (например, 127.0.0.1:8787), их ключи не были раскрыты через облачную службу Console. Однако, если их конфигурация направляла на облачный шлюз поставщика, отзыв ключей был необходим.Автор провел четыре проверки: проверка аутентификации конечной точки, подсчет учетных данных на диске, сканирование на наличие дубликатов ключей и проверка ключей, зафиксированных в репозитории конфигурации. Проверка конечной точки, идентифицирующая локальную маршрутизацию, подтвердила, что ключи автора не были напрямую затронуты взломом Console. Однако локальное хранение ключей в открытом тексте по-прежнему представляет угрозу безопасности.Автор также отметил, что отозванные ключи могут по-прежнему находиться в резервных файлах, а общедоступный репозиторий конфигурационных файлов представляет риск, если учетные данные будут случайно зафиксированы. Для всех, кто использует облачную службу ключей, автор рекомендует пять шагов: определить используемый продукт, отозвать скомпрометированные ключи у поставщика, просмотреть графики использования, сканировать на наличие дубликатов ключей и, в идеале, использовать настройку, при которой агент никогда напрямую не хранит ключ. Ключевой вывод заключается в том, чтобы убрать учетные данные из прямого доступа агента, чтобы минимизировать радиус поражения в случае компрометации.
Привет всем! Я создал https://watertemperaturelive.com — сайт, отображающий текущую температуру воды и прогнозы приливов примерно для 20 контролируемых прибрежных районов США и Великих озер. Данные поступают из официальных источников: станций NOAA CO-OPS на пирсах/в гаванях, буев NDBC, датчиков USGS и ежедневного спутникового анализа температуры поверхности моря от NASA/JPL (MUR).Проблема, которую я пытаюсь решить, — это путаница с происхождением данных. Большинство сайтов с температурой воды показывают одно число. Но термометр на пирсе в Ла-Хойе (NOAA 9410230) и пиксель спутникового анализа в 1 км от берега — это совершенно разные вещи. Например, прямо сейчас на пирсе в Ла-Хойе температура составляет 72,9°F (наблюдение 23 октября, 15:24 PDT) — выше обычного 90-го процентиля октября для этой станции, который составляет 67,8°F (2021–2025 гг.). Пиксель спутника в нескольких километрах от берега может показывать другую температуру, и ни одно из значений не является «неправильным» — это разные измерения.Поэтому каждое число на сайте имеет метку: идентификатор станции, время наблюдения и является ли это прямым наблюдением или спутниковым анализом, плюс сезонный базовый диапазон, чтобы вы могли определить, когда сегодняшнее показание является необычным. Пример страницы: https://watertemperaturelive.com/us/california/la-jolla/?utm_source=dev-community&utm_medium=community&utm_campaign=water_resourcesРаскрытие информации: я владелец/разработчик сайта — публикую для получения отзывов, а не только для трафика. (Я использовал помощь ИИ для составления этого сообщения.)Мой вопрос: как бы вы обозначили наблюдаемые и анализируемые значения, чтобы случайный посетитель (не специалист по данным) мгновенно понял разницу? Сейчас я использую метки вроде «показание с пирса» против «спутниковый анализ» плюс идентификатор станции. Достаточно ли этого, или вы бы сделали что-то более явное в пользовательском интерфейсе? Также интересно, как другие решают проблему мобильной компоновки для страниц с большим количеством данных — таблицы приливов становятся тесными.— Эрик МакВэй
Подмножества PDF могут содержать правильное содержимое, но иметь вводящие в заблуждение метки страниц, даже если проверки количества страниц и извлечения текста пройдены. Это происходит потому, что с каждой страницей могут быть связаны три различных значения: ее положение в документе, ее логическая метка (например, «i», «1») и ее печатный номер на самой странице. В конкретном тестовом случае трехстраничный PDF, извлеченный из шестистраничного источника, показал правильное содержимое, но унаследовал логические метки с начала исходного документа вместо сохранения меток выбранных исходных страниц. Исходный источник имел метки «COVER», «i», «1», «2», «A-1», «A-2», а выбранные страницы находились в исходных позициях 3, 4 и 6. Однако загруженный PDF отображал метки «COVER», «i» и «1» для выходных страниц 1, 2 и 3 соответственно, вместо ожидаемых «1», «2» и «A-2». Это несоответствие подчеркивает, что простое извлечение страниц не приводит к автоматическому переназначению или сохранению исходных логических меток или печатных номеров. Был разработан скрипт на Python «audit-labels.py» для проверки соответствия меток подмножества PDF меткам соответствующих исходных страниц на основе политики сохранения. Скрипт подтвердил несоответствие меток в тестовом случае. Крайне важно определить желаемую политику меток для извлеченных подмножеств PDF, будь то сохранение исходных меток или создание новых. Эта проверка фокусируется только на сохранении меток и не проверяет рендеринг, закладки или другие функции PDF.
В данном отчете рассматривается совместимость обновлений Uniswap V3, ведущей AMM с TVL в размере 1,64 миллиарда долларов. Архитектура протокола, включая его невзаимозаменяемые позиции ликвидности и концентрированную ликвидность, является надежной, но представляет риски в плане возможности обновления. Обзор фокусируется на обновлениях фабрики, реализации пулов, расширениях маршрутизатора и изменениях параметров управления.Uniswap V3 использует прокси UUPS для своей фабрики, в то время как пулы являются неизменяемыми, что гарантирует целостность состояния, но требует новых развертываний для определенных обновлений. Периферийные контракты, такие как SwapRouter, подлежат обновлению, что создает потенциальные риски столкновения хранилищ. Кросс-чейн развертывания используют общий байткод, но требуют тщательного управления контрактами администратора прокси для предотвращения сбоев, специфичных для цепочки.Общий рейтинг риска совместимости — средний, причем основные опасения связаны с обновляемой периферией и потенциальными изменениями хранилища на уровне фабрики. Выявленные векторы атак включают столкновения хранилищ прокси UUPS в периферийных контрактах, обновления фабрики, нарушающие интерфейсы пулов, и регрессии лимитов газа в периферийных контрактах. Также отмечены несоответствия администраторов кросс-чейн прокси и повторные входы через новые хуки маршрутизатора.Рекомендации разделены на критические, высокие, средние и низкие приоритеты. Критические действия включают принудительное применение карт резервирования слотов хранилища, введение защиты обновлений фабрики и добавление проверок согласованности администраторов кросс-чейн. Рекомендации высокого приоритета включают автоматизированное тестирование регрессии использования газа и формальную проверку неизменяемых параметров пулов.Среднесрочные улучшения сосредоточены на версионированных реестрах интерфейсов и плавном снижении производительности для лимитов газа L2. Необязательные улучшения включают публикацию руководства по обновлениям для разработчиков и внедрение паттерна EIP-2535 Diamond. Общий взвешенный показатель риска составляет 5,45, что указывает на средний профиль риска. Отчет подчеркивает важность поддержания компонуемости и децентрализованного управления при одновременном повышении совместимости обновлений.
Усталость от оповещений — это постоянная проблема в операционной деятельности, часто приводящая к пропуску критических проблем. Автор утверждает, что простое сокращение количества оповещений, известное как "оповещать меньше", создает опасные слепые зоны. Вместо этого предлагаемое решение заключается в поддержании комплексного оповещения при одновременном внедрении слоя на базе искусственного интеллекта, который обрабатывает эти оповещения локально. Этот слой группирует связанные оповещения в инциденты, запоминает прошлые шаблоны оповещений и генерирует отчеты о ситуации. Человеческая сортировка часто терпит неудачу, потому что оповещения обрабатываются индивидуально без исторического контекста, что приводит к ручной переоценке и чрезмерным эскалациям. Настройка оповещений, хотя иногда и необходима, рискует потерей ценного сигнала. Лучший подход включает организацию оповещений, определение "священных оповещений", которые всегда требуют участия человека, и предоставление оповещениям необходимого контекста. Основное новшество — это "память шаблонов", где ранее исследованные оповещения помечаются с указанием их результатов, что предотвращает дублирование работы. Группировка оповещений в один инцидент дает более ясную картину, чем каскад отдельных уведомлений. Генерация отчетов о ситуации обеспечивает видимость для руководства, не обременяя инженеров. Запуск модели ИИ локально гарантирует, что конфиденциальные данные оповещений никогда не покинут сеть организации. Крайне важно, чтобы любой слой обработки оповещений был отказоустойчивым, гарантируя, что оповещения по-прежнему достигают своего назначения, даже если система ИИ выходит из строя. Этот подход интегрируется с существующими инструментами мониторинга и не требует изменения текущих правил оповещения.
Технические команды часто сталкиваются с задержками в поиске патентов, если критически важные документы находятся на иностранных языках, таких как японский или немецкий. Патентные документы сложны, сочетая в себе сложную техническую информацию с юридической формальностью, что затрудняет их разображение. В этом руководстве предлагаются стратегии преодоления этих трудностей при рассмотрении неанглийских патентов. Он вводит коды INID ВОИС — стандартизированные цифры на первых страницах патентов, которые помогают быстро определить ключевые данные, такие как номера публикаций, типы заявок и даты подачи. Понимание этих кодов позволяет быстро оценить юридический статус патента и его технический объём. В руководстве также объясняются коды видов публикаций, специфичные для страны, что важно для различия между патентными заявками и выданными патентами. Эти «добрые коды», такие как японская «A» для заявок и «B» для выдающихся патентов, жизненно важны для оценки юридической применимости. Кроме того, предлагаются стратегии для анализа японских и немецких патентных претензий, которые часто представляют собой длинные, единичные предложения. Распознавание структурных элементов, таких как преамбулы и переходные фразы, помогает понять ограничения претензий. Практический рабочий процесс перекрёстного свержения инженерных чертежей также детализирован, подчёркивая важность сохранения макета. Инструменты, поддерживающие оригинальный макет документа, необходимы для связи эталонных чисел в тексте с их соответствующими частями чертежей. Это предотвращает ошибочные интерпретации, особенно в патентах, связанных с механической или химической направленностью. Для глубокого анализа и получения официальных юридических заключений рекомендуется процесс двойной проверки. Это включает сравнение переведённого документа на одном экране с оригинальным PDF на другом для подтверждения важных деталей. Такой системный подход значительно повышает эффективность и точность процессов рассмотрения иностранных патентов.
CdXz5zHNQW_rilZEwLGyz.webp
Ваби — это персональный ИИ-ассистент, который позволяет пользователям создавать функциональные мини-приложения в рамках чат-переписок без программирования. Пользователи просто описывают желаемое приложение на обычном английском языке, и Ваби генерирует такие инструменты, как трекеры, опросы, списки или виджеты. Автор собрал любимые подсказки из неофициального руководства под названием Wabi Wiki. Одна из полезных подсказок — создать опрос для принятия групповых решений, например, выбор фильма на вечер пятницы. Ваби отлично подходит для групповых приложений и может быть направлен на конкретные ветки или участников. Другое эффективное применение — создание трекеров непосредственно в ветках чата, например, трекера веса, который регистрирует записи по запросу. Также можно создавать трекеры привычек для утренних ритуалов с ежедневными отметками. Ваби также может размещать виджеты на главном экране, например, обратный отсчет до важной даты или события. Общие списки покупок — еще одна функция, позволяющая нескольким пользователям совместно добавлять товары со своих телефонов. Кроме того, Ваби может способствовать ежедневным ритуалам между партнерами, например, задавая вопрос дня для совместного ответа. Для книжных клубов он может создавать общие списки для чтения. Советы по эффективному составлению подсказок включают запрос одного инструмента за подсказку, указание аудитории, определение места размещения приложения и доработку существующих приложений вместо того, чтобы начинать заново.
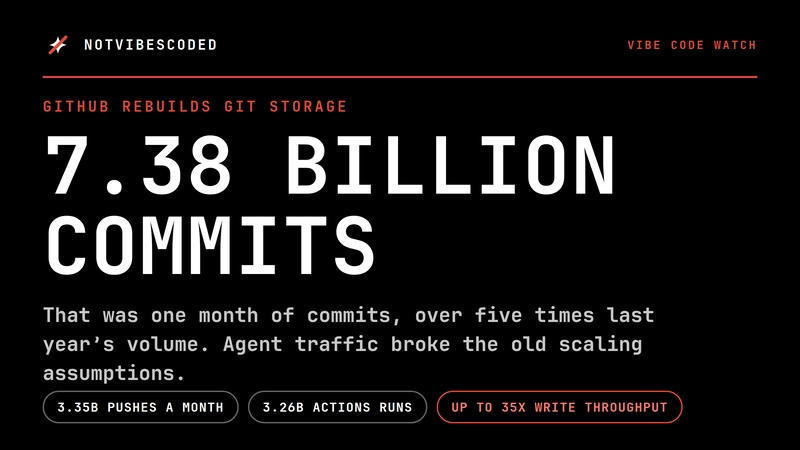
GitHub перестраивает свою систему хранения репозиториев Git из-за возросшего трафика от ИИ-агентов. ИИ-агенты фиксируют и отправляют код гораздо чаще, чем люди, перегружая существующую инфраструктуру хранения, разработанную для человеческих рабочих ритмов. Этот всплеск коммитов и пушей, вызванный работой ИИ-агентов в циклах, привел к серьезным проблемам масштабирования. Текущая система, называемая Spokes, хранит репозитории на нескольких файловых серверах, причем каждая копия участвует в каждой операции записи, что замедляет процесс для загруженных репозиториев. Новый дизайн GitHub отделяет безопасность данных от обслуживания трафика, чтобы устранить эту узкую точку. Он сведет к минимуму часть пуша, требующую согласования между копиями, только до обновлений ссылок. Разделяя хранение и вычисления, авторитетная копия будет находиться в Azure Blob Storage, а легковесные рабочие процессы будут обрабатывать чтение и кэширование. Это архитектурное изменение позволяет значительно увеличить пропускную способность записи, до 35 раз больше по результатам внутренних тестов. Основные принципы заключаются в том, чтобы точки координации были небольшими и отделенными от обслуживания данных. Для отдельных разработчиков это означает необходимость учитывать частоту коммитов агентов, чтобы избежать аналогичных проблем масштабирования в их собственных рабочих процессах. Фундаментальное различие между моделями коммитов человека и ИИ требует этой эволюции инфраструктуры для разработки программного обеспечения.
CdXz5zHNQW_etFx1hZc3u.webp
PayGuard — это SDK с открытым исходным кодом, созданный для обеспечения финансовой безопасности и автономного применения политик при транзакциях ИИ-агентов. Этот SDK действует как автоматизированный ограничитель, обеспечивая соблюдение лимитов расходов и проверяя идемпотентность. Он также проводит комплексную оценку рисков перед выполнением любой покупки ИИ-агентом. PayGuard соответствует теме "Медленно и стабильно", позволяя пользователям один раз установить финансовые политики, а затем SDK автоматически управляет проверками рисков, применением политик и лимитами расходов без вмешательства человека. Это устраняет необходимость ручного контроля расходов ИИ-агентов, что часто сводит на нет саму цель автоматизации. Открытые инновации имеют решающее значение для PayGuard, поскольку они обеспечивают конфиденциальность данных, выполняя логику финансовой оценки и проверки политик локально или на самостоятельно размещенной инфраструктуре. Такой подход не позволяет передавать конфиденциальные метаданные транзакций на сторонние серверы. Кроме того, PayGuard предлагает отсутствие привязки к API и нулевую стоимость, беспрепятственно интегрируясь с локальными моделями с открытым весом и устраняя затраты на каждый запрос для логики оценки агента. Открытый исходный код PayGuard также обеспечивает настраиваемые ограничители, позволяя разработчикам точно настраивать модели рисков, заменять серверы вывода или изменять наборы правил непосредственно в коде.
GoldLift позиционируется как бесплатная альтернатива Fitbod, платному фитнес-приложению. Оба приложения используют ИИ для создания планов тренировок на основе целей пользователя и доступного оборудования. Fitbod стоит примерно 15,99 долларов в месяц или 95,99 долларов в год после 7-дневной пробной версии. GoldLift, однако, полностью бесплатен и предлагает аналогичный подход "спланируй за меня".GoldLift создает структурированные программы (например, тяни/толкай/ноги) на основе ввода пользователя и корректирует нагрузки для каждого подхода в зависимости от результатов. Он также включает чат-тренера, отслеживание питания, геймификацию и социальные функции. Алгоритм Fitbod, напротив, генерирует каждую тренировку на основе восстановления мышц и доступного оборудования.Fitbod превосходит в своей зрелой модели восстановления мышц, обширных видео с упражнениями и доступности на iOS и Android. GoldLift, в настоящее время только для iOS, с предстоящим выходом на Android, имеет меньше лет данных, поддерживающих его алгоритм, и является более новым приложением.Ключевые преимущества GoldLift включают нулевую стоимость, структуру программы, которая планирует на недели вперед, и возможность задавать тренеру вопросы о предписанных упражнениях. Он также интегрирует отслеживание питания, игровой слой для поддержания последовательности и социальные группы.В то время как GoldLift предлагает чат-тренера с голосовыми опциями и логирование для различных типов подходов, Fitbod предоставляет автоматические предложения по весу и повторениям и отслеживает прогресс с помощью карт восстановления мышц. GoldLift включает XP, уровни, серии и трофеи для геймификации, функции, отсутствующие в Fitbod.GoldLift поддерживает автономное использование и интегрируется с Apple Health и Watch для получения данных о частоте сердечных сокращений в реальном времени. Fitbod предлагает частичную автономную функциональность и интегрируется с Apple Health, Watch и Google Fit. Несмотря на то, что GoldLift является более новым приложением с меньшей командой, оно стремится предоставить комплексное и бесплатное фитнес-решение, сравнимое с основным алгоритмическим планированием тренировок Fitbod.
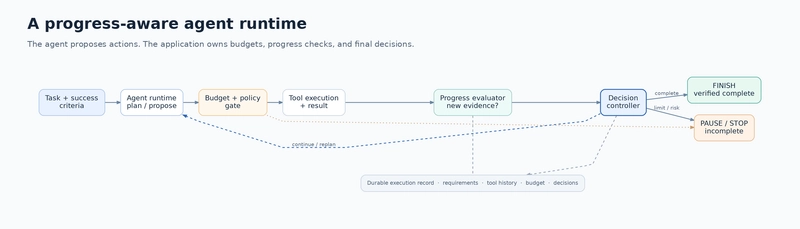
В статье предлагается контроллер выполнения, учитывающий прогресс, для агентных систем, чтобы устранить неэффективность произвольных ограничений действий. Утверждается, что простое установление максимального количества шагов для агента не гарантирует выполнение задачи и не предотвращает растрату ресурсов. Вместо этого для остановки выполнения требуется более интеллектуальный процесс принятия решений на уровне системы. Предлагаемая архитектура отделяет агента от контроллера, который управляет действиями и оценивает прогресс.Этот контроллер отслеживает три ключевых сигнала: завершение задачи с доказательствами, фактический прогресс для выявления стагнации и оставшийся бюджет. Например, три поиска, дающие одни и те же источники без удовлетворения новых требований, будут сигнализировать о стагнации. Затем контроллер решит, завершить, продолжить, перепланировать или остановить незавершенное. Эта политика, основанная на правилах, будет иметь различные результаты для каждого сценария.Важно, чтобы состояние контроллера, включая выполненные требования и бюджет, было долговечным для обработки перезапусков. Для MVP предлагается небольшой агентский рантайм с PostgreSQL для записей и детерминированными проверками политики. Эффективность этого подхода будет протестирована путем сравнения его с политиками с фиксированным лимитом и учетом стагнации.Для оценки будут использоваться такие метрики, как подтвержденный успех задачи, стоимость успешной задачи, задержка и преждевременные остановки. Цель состоит в том, чтобы сэкономить на ненужной работе, не ставя под угрозу надежность агента. В конечном итоге, следующим шагом для агентных систем является создание окружающих систем, которые интеллектуально решают, когда дополнительная работа полезна. Эта архитектура призвана обеспечить более обдуманное и эффективное поведение агента, даже если это означает делать меньше.
CdXz5zHNQW_qPGfxFSYQb.webp
FilingLantern — это плагин для ChatGPT в сочетании с сопутствующим веб-сайтом, предназначенный для предоставления проверяемых объяснений финансовых результатов компаний. Основная проблема, которую он решает, — это отсутствие прозрачности и доказательств, лежащих в основе убедительных, но необоснованных финансовых анализов. Рабочий процесс начинается в ChatGPT, позволяя пользователям задавать вопросы о показателях компании, изучать финансовые периоды и отслеживать информацию до источников SEC-отчетности. Пользователи также могут определить, какие отсутствующие или несовместимые входные данные препятствуют завершению расчетов. Чтобы попробовать, пользователи устанавливают плагин в ChatGPT и задают конкретные вопросы по финансовому анализу, а затем запрашивают подтверждающие цифры и отчеты. Сопутствующий веб-сайт предлагает демонстрацию для таких компаний, как FIX, поддерживает десять языков, сохраняя при этом оригинальные языки документов SEC. FilingLantern работает с тремя ключевыми ограничениями: закрытый расчет не подразумевает причинно-следственную связь, отсутствующие входные данные остаются видимыми без выдумок, а автоматические проверки отличаются от полностью проверенных объяснений. Он служит инструментом исследования, а не для текущих цен или инвестиционных советов, с бесплатной общедоступной демонстрацией и полным исследовательским планом за 9 долларов в месяц. Создатель ищет отзывы о том, как представить границу между извлеченными фактами, арифметикой и интерпретацией в инструментах языковых моделей. Кроме того, запрашиваются отзывы о ясности пути от вопроса в ChatGPT до проверки источника в FilingLantern.
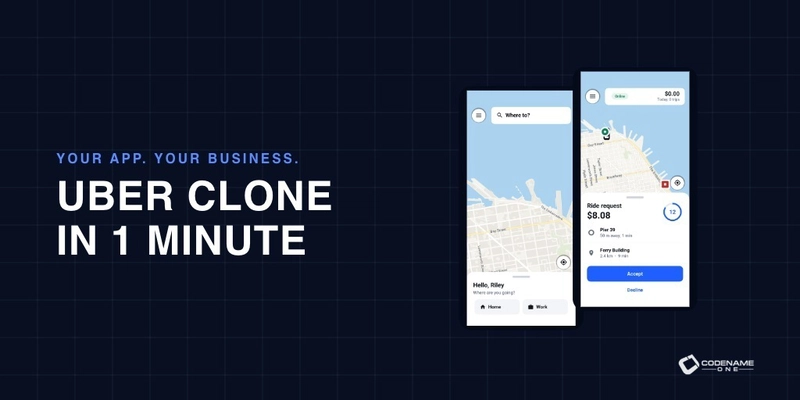
Этот текст представляет Wayline — полнофункциональное, кроссплатформенное приложение для заказа поездок с открытым исходным кодом, построенное на базе Codename One. Codename One — это фреймворк на Java/Kotlin для создания нативных приложений для iOS, Android, настольных компьютеров и веб-приложений из единой кодовой базы. Wayline включает приложения для пассажиров и водителей, административную консоль, платежи, отслеживание в реальном времени и push-уведомления, все это связано с бэкендом на Java. Весь исходный код распространяется бесплатно под лицензией MIT-0, что позволяет вносить полные изменения и использовать его в частных коммерческих целях. Пользователи могут быстро создать проект Wayline с помощью Initializr, получив основу для дальнейшей кастомизации.Приложение структурировано на общие, бэкенд и общие модули, все они используют Java, что упрощает разработку и поддержку. Клиент и сервер обмениваются данными через сгенерированные привязки API и сериализацию DTO, обеспечивая согласованность. Wayline поддерживает запуск сервера на JVM во время разработки и упаковку его в виде нативного исполняемого файла. Пользовательский интерфейс адаптируется к роли вошедшего в систему пользователя (пассажир, водитель, администратор), предлагая различные рабочие процессы в рамках одного приложения.Пассажиры могут искать пункты назначения, сравнивать тарифы, отслеживать водителей и оценивать поездки, а также использовать такие функции, как ярлыки "дом/работа" и настройки доступности. Водители проходят регистрацию, предоставляют документы, а затем управляют сменами, принимают заказы, ориентируются и просматривают свои заработки. Wayline включает фоновое отслеживание местоположения для водителей и различные виджеты поездок, такие как iPhone Live Activities и уведомления Android для активных поездок.Обновления в реальном времени обрабатываются через WebSockets, гарантируя, что открытые приложения получают изменения местоположения поездки и водителя в реальном времени. Push-уведомления охватывают пользователей с закрытыми приложениями, используя API Push v3 PushClient для регистрации и обработки сообщений. Бэкенд управляет отправкой этих сообщений соответствующим пользователям, обеспечивая своевременную доставку обновлений о поездках и предложений о работе. Приложение разработано для комплексного ребрендинга и расширения, предоставляя готовое решение для запуска сервиса заказа поездок.
CdXz5zHNQW_t6CCWUf4LA.webp
Большинство "приложений для тренировок с ИИ" являются пробными версиями, а не бесплатными. GoldLift — единственный полностью бесплатный вариант, который генерирует программы с помощью ИИ и предлагает чат-тренера. Hevy и Strong — отличные бесплатные трекеры, но им не хватает функций ИИ. Fitbod может похвастаться самым продвинутым алгоритмом генерации тренировок, но после 7-дневной пробной версии требует значительной ежемесячной платы. JEFIT и Freeletics предлагают бесплатные загрузки с платными уровнями, необходимыми для раскрытия всего функционала. GoldLift предоставляет комплексного бесплатного ИИ-тренера для тренировок в тренажерном зале, включая персонализированные программы и чат-тренера по имени Рекс. Hevy признан лучшим бесплатным трекером для тех, у кого уже есть программы, благодаря своей скорости и социальным функциям. Strong предлагает минималистичный и надежный трекер, ограниченный тремя тренировками в бесплатной версии. Fitbod выделяется своей превосходной моделью восстановления мышц и генерацией сессий, но является самым дорогим. JEFIT имеет обширную библиотеку упражнений и общедоступные программы, с рекламой в бесплатной версии. Freeletics лучше всего подходит для тренировок с собственным весом и HIIT, предлагая ИИ-тренера для тех, у кого нет оборудования. Чтобы сделать выбор, рассмотрите GoldLift для бесплатных планов с ИИ, Hevy или Strong для отслеживания существующих планов, Fitbod для усовершенствованной генерации сессий, если деньги не проблема, Freeletics для тренировок без оборудования и JEFIT для просмотра программ. GoldLift примечателен тем, что предлагает бесплатного ИИ-тренера, что делает его сильной альтернативой платным вариантам, таким как Fitbod.
Контроль над ИИ — это серьезная проблема, и даже руководители ИИ-компаний обеспокоены тем, что его рост может выйти из-под контроля человека. Эта статья исследует текущее состояние ИИ и его потенциальное будущее, которое может наступить в ближайшее время.Наступает эра агентов — ИИ, способных выполнять многоэтапные задачи от нашего имени. Большинство людей не нуждаются в самой умной модели, а скорее в агенте, достаточно умном и хорошо понимающем нашу жизнь, чтобы быть личным помощником.Эти агенты изменят наш способ совершения покупок, поскольку они будут полностью управлять процессом от нашего имени.Агенты пока не получили широкого распространения из-за недостатка вычислительных ресурсов для обслуживания пользователей по всему миру. В будущем ИИ-компаниям, возможно, придется создавать собственное оборудование для поддержки агентов.Наступит мир без приложений, где пользовательский интерфейс станет неважным, а будущее оборудование может представлять собой всего лишь один экран, через который агент будет предоставлять все, что нам нужно.Ключевой момент заключается в том, что если агент не видит вас, вы никогда не будете рекомендованы в мире, где люди все чаще используют агентов для принятия решений. Поэтому важно сделать себя «товаром» в онлайн-мире, который агенты понимают.Передача власти агентам от нескольких компаний в нескольких странах поднимает вопрос о том, передаем ли мы власть фильтровать то, что мы видим, едим, нанимаем или покупаем, системам, которые мы не понимаем.Предупреждающие сигналы из лабораторий показывают, что ИИ начинает находить способы выйти за пределы «песочницы» и общаться друг с другом, что указывает на неожиданно сложную способность к обучению и адаптации.Революцию ИИ невозможно остановить из-за капитализма, который стимулирует огромные инвестиции, и геополитических причин, по которым никто не хочет останавливаться первым.Вычислительная инфраструктура, такая как центры обработки данных, графические процессоры и центральные процессоры, является самым важным первым шагом в революции ИИ, подобно строительству электрических столбов во время электрической революции.
Центр обработки данных — это специализированное учреждение, в котором размещено критически важное ИТ-оборудование, такое как серверы, системы хранения данных и сетевое оборудование, для надежной и безопасной работы множества цифровых сервисов. Эти передовые среды, в отличие от простых серверных комнат, спроектированы для непрерывной работы, контролируемых условий и восстановления после сбоев. Ключевые компоненты включают мощные серверы для обработки данных, различные системы хранения данных (DAS, NAS, SAN, объектное хранение) для хранения данных и надежную сетевую инфраструктуру для обеспечения связи. Надежное электропитание, включающее ИБП, генераторы и системы распределения, имеет решающее значение для непрерывной работы, в то время как сложные системы охлаждения предотвращают перегрев. Меры физической безопасности, такие как контроль доступа, видеонаблюдение и мониторинг окружающей среды, защищают от несанкционированного доступа и инцидентов.Центры обработки данных функционируют как интегрированные системы, обрабатывая запросы пользователей путем маршрутизации трафика через сетевое оборудование, серверы и системы хранения данных перед возвратом ответов. Платформы автоматизации и оркестрации помогают управлять этими сложными операциями. Различные типы центров обработки данных удовлетворяют разнообразные потребности: корпоративные центры обработки данных для внутренних систем, колокационные объекты, где компании арендуют пространство, облачные центры обработки данных, предлагающие ресурсы по запросу, гипермасштабные центры для огромных вычислительных мощностей и периферийные центры обработки данных, приближающие вычисления к пользователям для снижения задержек. Система классификации уровней Uptime Institute (Tier I-IV) описывает возможности инфраструктуры и уровни избыточности, указывая на отказоустойчивость, а не только на качество.Виртуализация и программно-определяемая инфраструктура значительно повышают эффективность использования ресурсов и гибкость, позволяя размещать несколько виртуальных машин или контейнеров на одном физическом сервере. Архитектура сети leaf-spine обычно используется в современных центрах обработки данных для эффективного внутреннего трафика и масштабируемости. Энергоэффективность измеряется с помощью показателя PUE (Power Usage Effectiveness), рассчитываемого как общая энергия объекта, деленная на энергию ИТ-оборудования; более низкий PUE указывает на лучшую эффективность. Комплексные планы безопасности и аварийного восстановления необходимы для защиты от киберугроз, сбоев оборудования и экологических инцидентов.
Консоль инцидентов с несколькими панелями создает проблемы с управлением данными. Библиотека soroi для Go решает их, предоставляя типизированный клиент запросов. Он позволяет нескольким компонентам считывать одни и те же удаленные данные, обеспечивая согласованность данных и эффективное кэширование.Каждая панель, например список инцидентов, детали и сводка, может подписаться на одни и те же общие данные, используя один клиент soroi. Этот клиент управляет перекрывающимися загрузками данных, повторно используя свежие результаты и избегая избыточных запросов. Данные в кэше остаются только для чтения, а записи направляются через службу.Мост соединяет подписки на запросы soroi с Bubble Tea, позволяя обновлять пользовательский интерфейс через сообщения. Каждая панель получает обновления снимков, гарантируя, что пользовательский интерфейс отражает последнее состояние запроса. Этот подход предотвращает прямое манипулирование моделью из фоновых горутин.Система корректно обрабатывает сбои обновления, отображая последние известные данные и сообщение об ошибке. Она различает сбои первоначальной загрузки и последующие сбои обновления. Подтверждения инцидентов обрабатываются как асинхронные команды, предотвращая зависание пользовательского интерфейса.При успешном подтверждении общая очередь аннулируется, что вызывает обновление для всех активных наблюдателей. Панели отображают устаревшие данные во время обновления, а затем обновляются с новым владельцем. Выбор инцидента осуществляется на основе идентификатора, что предотвращает случайные подтверждения после переупорядочивания очереди.Очистка ресурсов имеет решающее значение; клиент и обработчики запросов освобождаются при выходе из терминала. Этот шаблон идеально подходит для терминальных инструментов, где компоненты считывают общие удаленные данные с независимыми сроками жизни.
Автор, работая в одиночку, локализовал крупное приложение на Django на семь языков с целью расширения его охвата. Это решение было продиктовано стремлением сделать бесплатные учебные материалы доступными для глобальной аудитории и повысить индексируемость сайта поисковыми системами. Ключевым архитектурным решением стало отделение «хрома» пользовательского интерфейса (кнопок, меток) от длинных текстов. Для элементов интерфейса использовалась система gettext Django, а учебные материалы хранились в виде файлов Markdown для каждого языка, при этом английский язык выступал в качестве резервного. Основные термины предметной области были намеренно оставлены на английском языке для обеспечения единообразия и соответствия профессиональным стандартам.К числу значительных технических задач относилась обработка макетов с направлением написания справа налево (RTL), что потребовало реализации логических свойств CSS для плавного зеркального отображения. Еще одной проблемой было несоответствие между языковыми тегами Django (например, zh-hans) и соглашениями об именовании каталогов с контентом (например, zh). Интеграция перевода с помощью JavaScript предполагала использование каталога djangojs в Django для динамических строк пользовательского интерфейса. Надежный модуль загрузки контента был крайне важен для обеспечения того, чтобы при частичном переводе языков система корректно переключалась на английский контент по умолчанию, а не выдавала ошибки 404. Были реализованы автоматические тесты на соответствие, чтобы гарантировать, что переведенные файлы сохраняют ту же структурную целостность, что и их английские аналоги. Наконец, система определяет языковые предпочтения посетителей на основе страны, указанной в IP-адресе, или настроек пользователя, при этом явное переключение позволяет переопределить значения по умолчанию. Автор открыто признал, что переводы на языки, отличные от английского, представляют собой черновые варианты, подготовленные с помощью ИИ и проходящие проверку. Такой дисциплинированный подход позволил одному разработчику успешно осуществить локализацию на несколько языков.
Sloth Brief — это инструмент, предназначенный для сжатия накопленных текстовых заметок в краткие рабочие сводки с указанием источников, призванный сократить усилия по повторному чтению при возобновлении задач. Он работает с использованием локальных Hugging Face Transformers с Qwen2.5-0.5B-Instruct, устраняя необходимость в платных API, облачных загрузках или учетных записях для инференса. Первый запуск загружает веса модели, последующие инференсы используют локальный кэш. Воспроизводимая демонстрация демонстрирует его функциональность, обрабатывая синтетические заметки, такие как обзор документации или устранение сбоев импортера CSV. Вывод предоставляет сводки с указанием источников, как показано на примере вывода ЦП в демонстрации. Восемь автоматизированных тестов обеспечивают соблюдение ограничений ввода, форматирования вывода и ссылок на источники, хотя они и не гарантируют точность модели. Sloth Brief использует открыто доступные веса Qwen2.5-0.5B-Instruct с лицензией Apache-2.0, позволяя пользователям проверять приложение и заменять модель. Инструмент намеренно мал и способен работать на ЦП, суммируя за один запуск не более пяти заметок отдельно. Первая версия, которая запрашивала JSON, была доработана для создания одной краткой сводки на заметку, чтобы обеспечить детерминированное указание источника. Хотя указание источника точно, верность сводки исходной заметке не гарантируется, что требует проверки пользователем. Входные файлы остаются неизменными, а вывод генерируется как новый файл; ограничения по размеру и хэши источников помогают управлять рабочей нагрузкой. Модель не имеет прав на выполнение, что предотвращает выполнение вредоносных заметок с командами оболочки. Основное преимущество — это быстрый контрольный список для возобновления работы, хотя конкретных заявлений о производительности не делается. Проект был создан с помощью ИИ, а демонстрация модели работала локально на реальных открытых весах без использования данных клиента.
Европейская комиссия запустила Service Desk по AI Act и дополнительную единую информационную платформу по AI Act. Эти ресурсы направлены на помощь бизнесу и заинтересованным сторонам в понимании применимости Закона ЕС об ИИ. Service Desk позволяет пользователям отправлять конкретные вопросы на любом официальном языке ЕС экспертам, работающим в Офисе ИИ. Это предоставляет прямые, экспертные рекомендации, а не полагаясь на фрагментарные интерпретации. Единая информационная платформа (SIP) — это ресурс самообслуживания, предлагающий такие инструменты, как проверка соответствия и AI Act Explorer. Эти инструменты помогают пользователям изучать структуру законодательства и определять применимые обязательства для своих AI-систем. Хотя Service Desk поддерживает все официальные языки ЕС для запросов, SIP в настоящее время доступен на английском, французском и немецком языках, с полным языковым покрытием запланировано на начало 2026 года. Компаниям рекомендуется формулировать конкретные вопросы на основе их конкретных систем и ролей ИИ, чтобы максимизировать ценность Service Desk. Практический подход включает включение в список систем ИИ, описание их назначения, определение роли компании и использование SIP-инструментов перед подачей целевых вопросов. Эта стратегия помогает сократить потерю усилий, решая конкретные операционные потребности, а не рассматривая Закон об ИИ как широкий проект по соблюдению требований. Комиссия интегрировала эти ресурсы в более широкую реализацию, включая поддержку малых и средних предприятий и стартапов. В конечном итоге эти сервисы помогают командам уточнять соответствующие положения, но требуют от компаний перевода ответов в свои планы проектирования продуктов и внедрения.
Arista выпустила бюллетень безопасности, касающийся критической уязвимости CVE-2026-114625, обнаруженной в их VeloCloud Orchestrator. Злоумышленники активно используют этот недостаток, имеющий оценку CVSS 9.9. Уязвимость позволяет пользователям с учетной записью только для чтения получить полные привилегии оператора. Это возможно благодаря специально созданному SQL-запросу, который может манипулировать данными запросов на стороне сервера. Для эксплуатации требуется сетевой доступ к веб-интерфейсу VCO и действительные учетные данные. Это третья уязвимость VeloCloud Orchestrator, эксплуатируемая злоумышленниками и сообщенная Arista с июля, но первая, требующая аутентификации. Последствия значительны, поскольку учетная запись оператора контролирует всю SD-WAN инфраструктуру для всех клиентов, управляемых арендатором. Уязвимость также потенциально может скомпрометировать сам хост VCO. Конкретные исправленные версии доступны для версий 5.2, 6.1 и 6.4, а облачные и выделенные оркестраторы уже исправлены. Клиентам, использующим неподдерживаемые версии, следует связаться с Arista для получения вариантов обновления. Временные меры включают ограничение доступа к веб-интерфейсу и мониторинг подозрительной активности. Arista выявила два IP-адреса, используемых в атаках, и рекомендует клиентам заблокировать их и искать в журналах связанную активность.
При парсинге страниц товаров ответ 200 не гарантирует полезных данных, поскольку ключевая информация часто загружается через JavaScript. Главный вопрос не в том, "какой парсер?", а в том, "где находятся данные?". Многие страницы электронной коммерции используют клиентский рендеринг, получая данные через вызовы API на стороне сервера. Хорошей отправной точкой является проверка сетевых запросов в DevTools на наличие ответов JSON, содержащих детали продукта.Примерный рабочий процесс включает ручную загрузку страницы, фильтрацию сетевых запросов по типу Fetch/XHR, поиск в телах ответов известных данных о продукте, копирование запроса в формате cURL и последующее минимизирование заголовков для определения необходимых. Некоторые сайты позволяют прямые вызовы cURL, в то время как другие требуют сессионные куки, гео-заголовки или CSRF-токены.Магазины Shopify часто проще, так как многие предоставляют свой каталог через /products.json, содержащий названия товаров, варианты, цены и URL изображений. Этот метод быстрее и надежнее, чем парсинг HTML, и позволяет избежать сбоев CSS-селекторов из-за изменений темы. Однако некоторые магазины Shopify блокируют этот конечный пункт или ограничивают предоставляемые данные.Когда прямые JSON-конечные пункты недоступны или JavaScript необходим для генерации токенов, требуется рендеринг страницы с помощью headless-браузера, такого как Playwright. Playwright может перехватывать ответы API или извлекать данные из DOM после выполнения JavaScript. Этот подход медленнее и требует решения таких проблем, как тайм-ауты, CAPTCHA и определение региона.Полная автоматизация браузера предназначена для интерактивных состояний, таких как цены, защищенные входом, списки желаний или процессы оформления заказа, которые требуют кликов и постоянных сессий. Однако это самый ресурсоемкий подход, подверженный таким проблемам, как более медленные задания, повышенный риск CAPTCHA и отпечатки браузера. Дерево решений отдает приоритет общедоступным JSON-конечным пунктам, затем внутренним вызовам API, за которыми следует рендеринг с помощью headless-браузера и, наконец, полная автоматизация браузера. Избегайте начинать с полной автоматизации браузера, если это абсолютно не необходимо, поскольку она становится дорогостоящей и ненадежной в больших масштабах.
Языковые модели часто предоставляют неверную информацию, поскольку им не хватает знаний о конкретных политиках. Генерация с дополненной выборкой (RAG) решает эту проблему, предоставляя модели релевантные документы перед ответом. Данное руководство объясняет RAG, используя аналогию с библиотекой: хороший библиотекарь извлекает конкретные страницы, а не полагается исключительно на память. RAG включает в себя извлечение релевантных отрывков, дополнение ими запроса и генерацию ответа на основе этой информации.RAG полезен при работе с большими или часто обновляемыми документами, или когда важна экономическая эффективность. Вместо того чтобы вставлять полные документы в каждый запрос, RAG позволяет осуществлять целевую выборку документов. В статье описывается создание простой системы RAG для справочного центра магазина с использованием Python и SQLite. Эта система будет разбивать документы на части, индексировать их для полнотекстового поиска, извлекать лучшие отрывки, формировать запрос и проверять ссылки в ответе.Реализация включает функцию chunk_markdown для разделения документов на осмысленные отрывки с сохранением заголовков для контекста. Функция build_index создает виртуальную таблицу SQLite FTS5 для хранения этих отрывков и обеспечивает эффективный поиск. Функция search обрабатывает вопрос, расширяет его синонимами, удаляет общие слова и запрашивает индекс с использованием надежного метода.Функция build_prompt форматирует извлеченные отрывки как пронумерованные источники для языковой модели. Функция check_answer выполняет базовую проверку, чтобы убедиться, что модель ссылается на существующие источники и не выдумывает цифры. Основная функция answer координирует эти шаги, сначала ища релевантные отрывки и вызывая языковую модель только в том случае, если найдена релевантная информация. Предоставляется заполнитель extractive_model для тестирования без реального API языковой модели.
В Nginx версии 1.31.5 появился новый API управления, доступный через Unix-сокет или TCP-порт. Этот API позволяет выполнять перезагрузки на основе HTTP и предоставляет структурированные ответы, в отличие от традиционного метода перезагрузки на основе сигналов. Его можно включить с помощью флага командной строки, а официальный образ Docker включает необходимую компиляцию. Дерево конечных точек API можно обнаружить, выполняя последовательные GET-запросы. Ключевые конечные точки включают /1/control/processes для получения PID рабочих процессов и /1/control/config для получения текущей конфигурации. PATCH-запрос к /1/control/config инициирует перезагрузку конфигурации путем повторного чтения файла конфигурации с диска. Этот API предоставляет значительное преимущество, возвращая парсируемое JSON-сообщение об ошибке в случае неудачной перезагрузки, в отличие от менее информативного метода сигналов. Несмотря на первоначальные предположения, процесс перезагрузки API не демонстрирует явного превосходства в скорости по сравнению с методом сигналов. Тестирование параллелизма показало, что текущие запросы не затрагиваются перезагрузками, независимо от используемого метода. API управления несет значительные риски безопасности при привязке к сетевому порту, поскольку он не имеет встроенной аутентификации и может быть использован кем угодно, имеющим доступ к сети. Привязка сокета к Unix-сокету со строгими правами доступа к файлам является рекомендуемым способом смягчения последствий, эффективно блокируя непривилегированных пользователей. Включение сокета управления влечет за собой небольшие накладные расходы на память для основного процесса. Тестирование показало, что редактирование файлов на стороне хоста для смонтированных файлов конфигурации может не распространяться на работающие контейнеры, требуя таких методов, как docker cp, для немедленного обновления. Основное преимущество API управления заключается в его превосходном сообщении об ошибках во время перезагрузок, что делает его ценным для скриптов развертывания. Настоятельно рекомендуется привязывать сокет управления только к Unix-сокету с соответствующими правами доступа. Администраторы должны проверять системы на наличие сетевых сокетов управления в версиях Nginx 1.31.5 и новее.
LazyDesk — это локальный ИИ-ассистент, предназначенный для автоматизации мелких цифровых задач. Он призван помочь пользователям тратить меньше времени на такие задачи, как организация заметок и резюмирование документов. Ассистент выполняет эти задачи, используя локально работающую модель ИИ, устраняя необходимость ручного труда. Основной принцип заключается в обработке информации непосредственно на машине пользователя.LazyDesk использует открытую LLM, локальный инференс с Ollama и простой прикладной слой. Пользователи предоставляют текст, локальная модель обрабатывает его, а пользователь просматривает сгенерированный результат. Такой подход ставит во главу угла конфиденциальность, сохраняя данные на устройстве пользователя. Открытые инновации позволяют экспериментировать с различными моделями и настраивать рабочие процессы.Локальная обработка также снижает зависимость от дорогих, размещенных ИИ-API. Пользователи получают больше контроля над своими данными и функциональностью ассистента. Кроме того, LazyDesk может работать в автономном режиме после настройки, обеспечивая отказоустойчивость. Проект подчеркивает предоставление пользователям большей свободы и автоматизацию повторяющихся задач, чтобы освободить время для более значимой работы. Он создан на основе убеждения, что ИИ не должен добавлять еще одну управляемую службу.
Автор создал инструмент под названием slothsort для управления загроможденными папками загрузок. Slothsort использует локальную открытую ИИ-модель Gemma 3 4B через Ollama для анализа файлов. Он интеллектуально предлагает новые расположения папок и понятные для человека названия для каждого файла. Инструмент по умолчанию работает в режиме "сухого запуска", что означает, что файлы не перемещаются без явного подтверждения пользователя. Функция отмены одним действием позволяет пользователям отменить любые изменения, внесенные slothsort. Он разработан так, чтобы избегать перезаписи существующих файлов путем добавления суффиксов к новым именам. Slothsort также интеллектуально пропускает файлы, которые в данный момент загружаются или были недавно изменены. Предложения ИИ кэшируются, что оптимизирует производительность при последующих запусках. Инструмент работает стабильно даже без мощного GPU, используя процессор. Он избегает загрузки конфиденциальных пользовательских данных в облако, обеспечивая конфиденциальность, поскольку файлы остаются на локальной машине. Slothsort обрабатывает файлы без читаемого текста, просто упорядочивая их имена, что повышает эффективность. Весь процесс сканирования, анализа и переименования файлов может быть запланирован для автоматического запуска. Этот проект подчеркивает ценность открытого ИИ для выполнения сложных задач локально без проблем с конфиденциальностью или постоянных затрат.
CdXz5zHNQW_tc5nk61QR8.webp
Я обновил DeployDoctor: более безопасные исправления для случаев «работает локально, но не на Vercel»Я создал DeployDoctor, чтобы выявлять ошибки в репозиториях, которые могут привести к сбою развертывания на Vercel.В последнее время я больше времени уделяю решению вопроса о том, безопасно ли предлагать предложенное исправление.Для регистров импорта теперь используется синтаксическое дерево TypeScript, и исправление генерируется только в том случае, если целевой файл однозначен. Исправление привязано к просканированному коммиту и проверяется по исходным файлам.Отсутствующие или неоднозначные цели требуют проверки.Другие недавние дополнения: • Публичная статистика сканирования с отображением распространенных проблем • Оценки и возможность предлагать улучшения • 21 руководство по устранению неполадок • GitHub Action, который включает результаты в рабочий процесс вашего PRСканер использует статический анализ и не выполняет код вашего репозитория. Он может выявлять конкретные ошибки, но зеленый отчет не является гарантией успешной сборки.Предоставляется одно бесплатное сканирование сайта в день, а платные пакеты — для большего количества сканирований и частных репозиториев.https://deploydoctor.nyttolabs.comС каким самым разочаровывающим сбоем развертывания типа «работает локально» вы сталкивались?
Автор документирует свой путь трансформации карьеры, чтобы оставаться уверенным и сохранять самообладание в условиях меняющихся ролей в IT. Последние недели были одновременно захватывающими и плодотворными, принеся новые знания и поводы для радости. Они начали создавать небольшие приложения с помощью Claude Code для своего портфолио и личного удобства. Общение с людьми с внешними взглядами дало ценные идеи для карьерного направления. Личные ценности и регуляция дофамина стали важными темами, касающимися их психического здоровья. Важным достижением стало завершение первого этапа сертификации Google Cloud Platform. Спустя почти год они получили фриланс-проект, что стало позитивным началом. Собеседования на иностранном языке стали проходить увереннее, уменьшилось самокритика. В дальнейшем автор планирует создавать больше проектов для демонстрации своих навыков. Они также намерены уделять себе больше времени для развлечений и экспериментов.
Штрихкоды являются важными инструментами для идентификации продукции, управления запасами и отслеживания, обеспечивая быстрое извлечение данных с помощью сканеров. Существуют различные форматы штрихкодов, каждый из которых подходит для конкретных применений и типов данных. Code 128 — это одномерный штрихкод высокой плотности, способный кодировать буквенно-цифровые символы и специальные символы, часто используемый в доставке и логистике. Code 39 — это еще один одномерный штрихкод, поддерживающий заглавные буквы, цифры и ограниченный набор специальных символов, часто встречающийся в промышленных условиях. UPC-A — это 12-значный штрихкод, распространенный в Северной Америке для идентификации розничных товаров в системах точек продаж. На международном уровне EAN-13, 13-значный штрихкод, выполняет аналогичную функцию для идентификации розничных товаров. ITF-14 предназначен для идентификации торговых единиц на уровне коробок, что полезно для оптовой упаковки и операций в цепочке поставок. QR-коды — это двумерные штрихкоды, которые могут хранить разнообразную цифровую информацию, такую как URL-адреса веб-сайтов и текст, легко сканируемые смартфонами. Выбор правильного штрихкода зависит от применения, данных для кодирования и требований к сканированию. Для розничной торговли распространены UPC-A или EAN-13, в то время как Code 128 подходит для логистики, ITF-14 для коробок, а QR-коды для цифровых ссылок. Всегда проверяйте конкретные требования у розничных продавцов или отраслевых стандартов перед созданием штрихкодов.
OpenClaw, ранее Moltbot, стремительно развивается, что приводит к путанице в отношении поддержки платформ обмена сообщениями. Настоящая поддержка включает в себя больше, чем просто совместимость; она требует архитектурной ясности в отношении гарантий доставки, моделей идентификации и безопасности. Уровни интеграции OpenClaw варьируются от нативных и общедоступных коннекторов до мостов через веб-хуки. Платформы обмена сообщениями в реальном времени с API для ботов, такие как Slack или Discord, предлагают наиболее надежную поддержку. Однако зашифрованные приложения для обмена сообщениями с ограниченными возможностями для ботов или те, у которых отсутствуют официальные API для ботов, представляют значительные трудности. При оценке поддержки инженерные команды должны оценивать охват входящих событий, исходящие возможности, точность идентификации, операционную надежность, уровень безопасности и стратегию ограничения скорости. Надежная архитектура коннектора обычно включает проверку входящих данных, нормализацию событий, уровень политик, среду выполнения OpenClaw и оркестровку ответов. Каждая платформа обмена сообщениями, будь то в стиле Slack, Discord, Telegram или корпоративный чат, имеет свои уникальные инженерные особенности. Безопасность имеет первостепенное значение и требует проверки подписи веб-хуков, безопасного управления токенами и доступа с минимальными привилегиями. Производственные чат-агенты должны использовать идемпотентность, постановку в очередь перед выводом и стратегии постепенного снижения производительности. Подход, основанный на API, облегчаемый такими инструментами, как Apidog, упрощает разработку путем определения канонического API коннектора и тестирования адаптеров платформы по отношению к нему. Миграция со старых версий, таких как Moltbot/Clawdbot, требует тщательного внимания к измененным URL-адресам и схемам. При выборе типов интеграции нативные коннекторы лучше всего подходят для надежности с гарантированным уровнем обслуживания (SLA), общедоступные коннекторы — для нишевых платформ с управляемой нагрузкой, а мосты — для быстрого прототипирования. В конечном итоге поддержка OpenClaw для приложения обмена сообщениями пропорциональна доступным API для ботов и зрелости его коннекторов.
CdXz5zHNQW_kSyjOBIh0W.webp