Google Cloud Blog на русском
Подписаться
От недель до минут: новая эпоха агентов в конвейерах данных
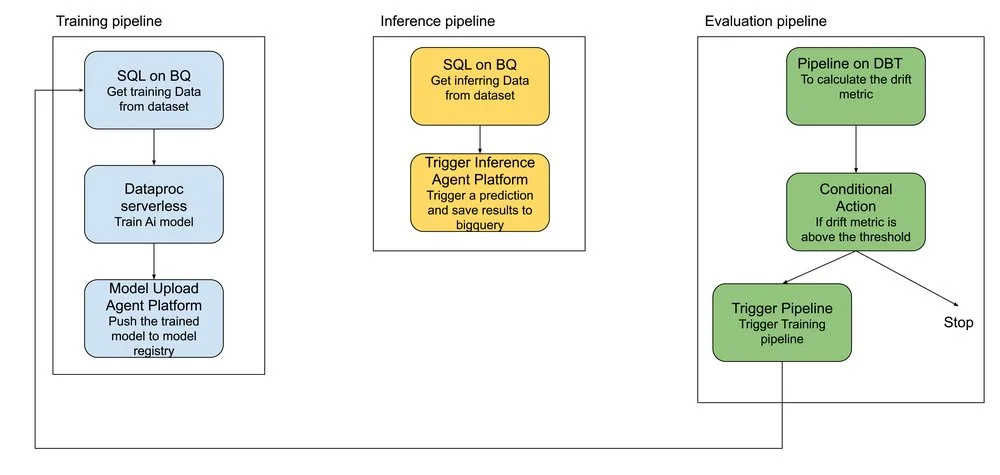
Google Cloud демократизирует оркестрацию конвейеров данных с помощью нового фреймворка Orchestration Pipelines, представленного на Google Cloud NEXT ’26. Этот фреймворк доступен через Data Agent Kit — бесплатную коллекцию инструментов для инжиниринга данных с открытым исходным кодом. Набор интегрируется в популярные IDE и CLI, предоставляя вкладку Data Engineering и агентный навык для Airflow DAG. Он позволяет специалистам по данным создавать, развертывать и устранять неполадки производственных Airflow DAG, используя естественный язык. Фреймворк упрощает MLOps, отделяя логику оркестрации от выполнения вычислений, используя декларативный YAML DSL. Это позволяет всем ролям в работе с данными обойти сложный Python-код Airflow. Практический пример демонстрирует построение MLOps-архитектуры для проактивного управления цепочками поставок. Эта архитектура прогнозирует время в пути, используя BigQuery, Managed Service for Apache Spark, Gemini Enterprise Agent Platform и dbt. Data Agent Kit генерирует PySpark-скрипты и декларативные YAML-конвейеры из запросов на естественном языке. Демонстрируются три различных конвейера: обучающий движок, ежедневный конвейер вывода и автоматизированный конвейер оценки и ветвления. Развертывание автоматизировано через CI/CD, при этом Data Agent Kit генерирует необходимые рабочие процессы. Для операционной деятельности на втором этапе набор предлагает мониторинг в реальном времени и агентное устранение неполадок в IDE. Он диагностирует сбои, определяет первопричины и предлагает исправления проблем непосредственно в коде. Orchestration Pipelines и Data Agent Kit значительно сокращают время и сложность создания и поддержки MLOps-архитектур.