DEV Community на русском
Подписаться
Понимание Prism: Динамическое разреженное внимание для совместной генерации видео и аудио
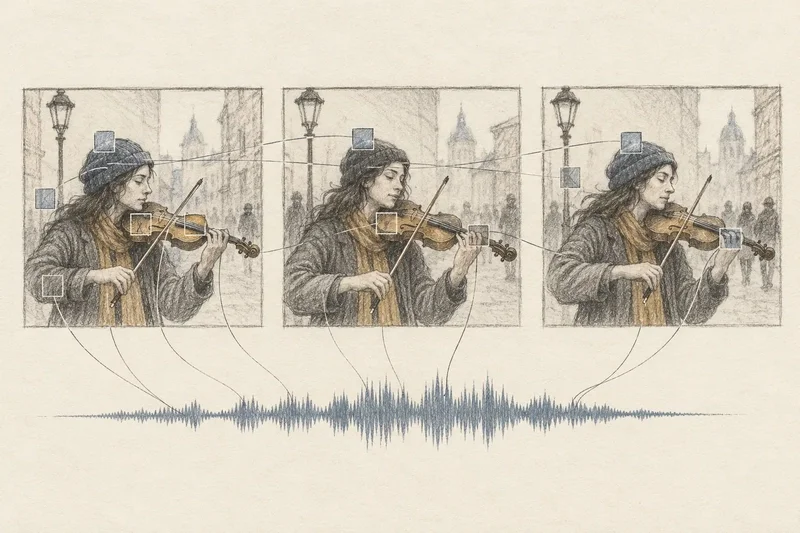
Prism — это новая структура разреженного внимания, разработанная для повышения эффективности обучения моделей генерации видео и аудио высокого разрешения. Видео высокого разрешения содержит огромное количество визуальных токенов, что делает традиционное плотное внимание вычислительно затратным из-за его квадратичной зависимости. Аудио добавляет еще один уровень сложности, требуя от моделей связывать звуки с их визуальными источниками. Prism решает эту проблему, интеллектуально адаптируя свои паттерны внимания на основе локального содержимого видео.Структура делит видеоклипы на пространственно-временные макрозоны, анализируя визуальные вариации и сигналы перекрестного внимания аудио-видео в каждой зоне. На основе этих сигналов Prism динамически формирует свои блоки внимания, концентрируя вычислительные ресурсы на областях со значительными визуальными изменениями или сильной аудиовизуальной корреляцией. Такой подход разреженного внимания позволяет избежать ненужных вычислений на менее информативных частях видео.Предварительная версия Prism доступна на Hugging Face, предлагая скрипты для инференса при генерации изображений в видео, текста в видео и аудио, а также поддержку нативного совместного обучения видео и аудио. Репозиторий в настоящее время требует значительных ресурсов GPU: инференс 720p требует GPU объемом 80 ГБ, а более высокие разрешения — нескольких таких GPU. Нативное обучение для разрешений 1080p и 2K требует соответственно не менее 32 или 64 GPU объемом 80 ГБ.Авторы сообщают, что Prism обеспечивает до 2,5 раз более быстрое обучение по сравнению с полным вниманием, а также улучшенное качество генерации, хотя эти результаты специфичны для их экспериментальной установки. Этот предварительный просмотр исследования предназначен для пользователей, которые комфортно себя чувствуют при загрузке контрольных точек и настройке сред GPU. Основная инновация Prism заключается в его контентно-ориентированном, динамическом разреженном внимании, которое особенно полезно для обучения совместных моделей видео и аудио высокого разрешения.