Построение VLM-сервисного стека Pinterest на NVIDIA Dynamo
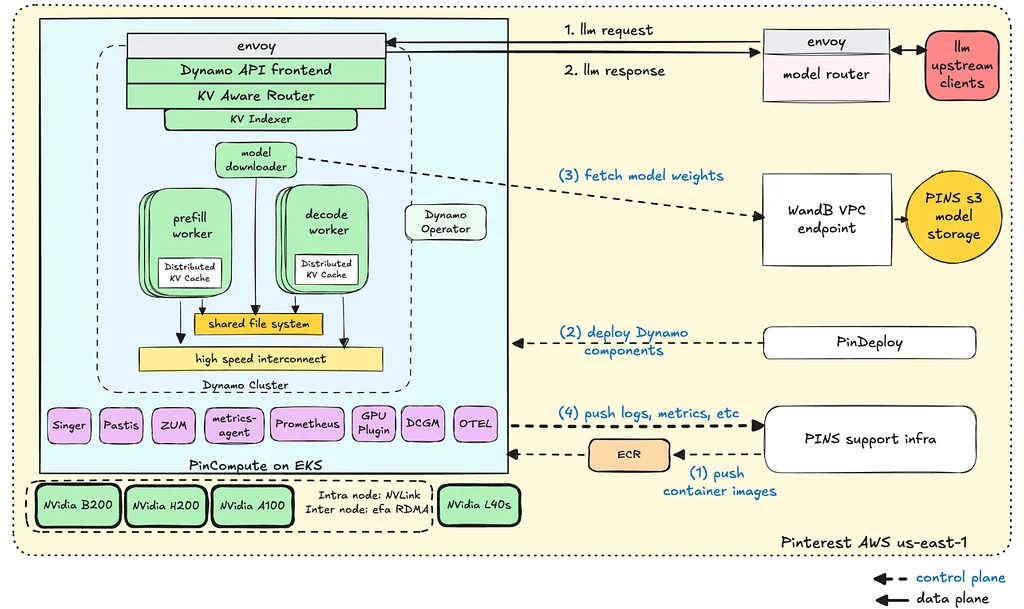
Pinterest использует модели зрения и языка (VLM) для улучшения своей платформы визуального поиска и обнаружения. Эти модели имеют решающее значение для обеспечения работы новых функций, таких как Pinterest Assistant и гибридный поиск. Pinterest настраивает VLM с открытым исходным кодом для удовлетворения своих специфических требований к продукту и масштабу. Обслуживание VLM представляет собой уникальные проблемы, выходящие за рамки традиционных LLM, ориентированных только на текст, включая обработку нескольких изображений и больших KV-кэшей. Для решения этих проблем Pinterest построил свой стек обслуживания VLM на графических процессорах NVIDIA Blackwell и NVIDIA Dynamo. Графические процессоры Blackwell предлагают превосходную вычислительную мощность и емкость памяти для требовательных рабочих нагрузок ИИ. Dynamo предоставляет распределенный уровень оркестрации для оптимизации мультимодального вывода на всем пути обслуживания. Полезные нагрузки запросов для VLM более сложны, требуя загрузки изображений, предварительной обработки и построения подсказок. Этап предварительного заполнения при обслуживании VLM часто является доминирующим и вычислительно затратным, что требует расширенного управления кэшем. Многооборотные взаимодействия VLM еще больше усложняют обслуживание из-за меняющегося визуального контекста и повышенных требований к предварительному заполнению. Управление давлением памяти KV-кэша имеет решающее значение, требуя таких стратегий, как маршрутизация с учетом KV и выгрузка. Решение Pinterest использует раздельное предварительное заполнение и декодирование, выгрузку KV-кэша с помощью LMCache и мультимодальную поддержку в Dynamo и vLLM. Они также реализовали пользовательские проекционные вложения для снижения затрат на обработку больших визуальных контекстов. Этот оптимизированный стек обслуживания VLM значительно повышает производительность, демонстрируя существенный прирост показателя Time-to-First-Token.