Проведение экспериментов с Apache Spark во сне (и в самолете)
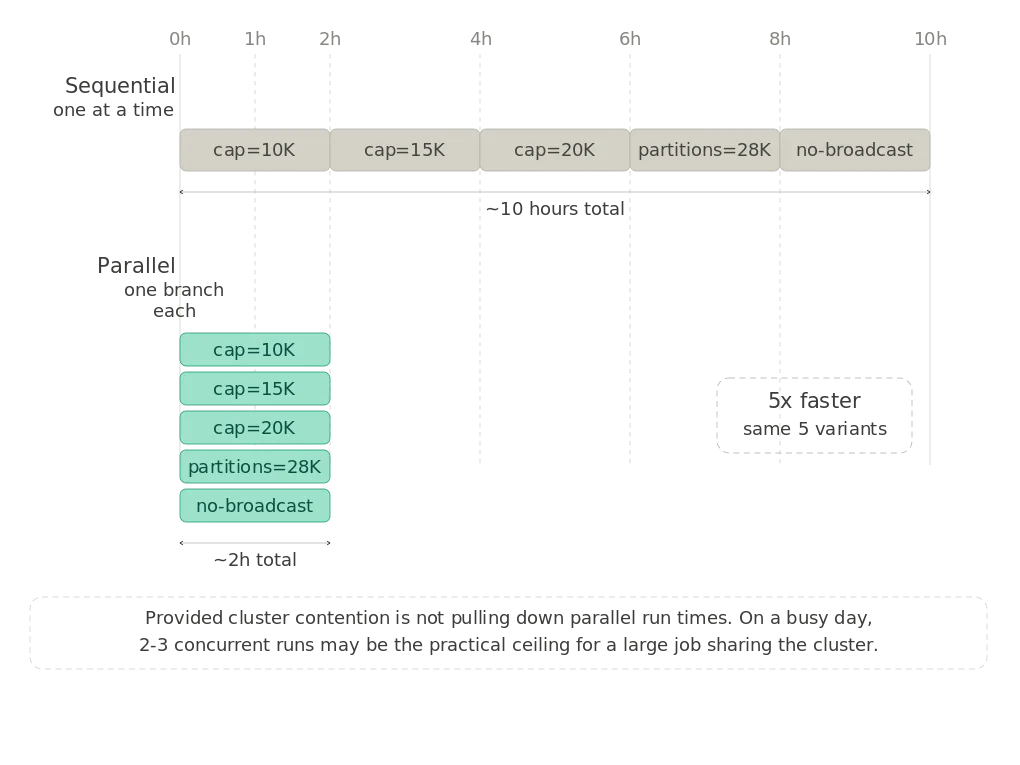
"member-sessionizer" от Netflix, критически важный конвейер данных, обрабатывает миллиарды событий для создания пользовательских сессий просмотра. Стандартные подходы к отладке оказались неэффективными в производственном масштабе Netflix, поскольку такие проблемы, как ошибки нехватки памяти (Out-Of-Memory), проявлялись только на больших, невыборочных наборах данных из-за перекоса данных. Прорывом автора стало смещение фокуса с ускорения одиночных запусков на возможность проведения множества одновременных экспериментов. Это было достигнуто за счет использования ветвления разработки Dataflow для изоляции каждого тестового варианта.Параметризовав планировщик и назначив каждому эксперименту свою ветку и выходную таблицу, можно было одновременно запускать несколько тестов. Это резко сократило общее время выполнения с часов на тест до продолжительности самого длительного одиночного задания. Был использован ИИ-агент для управления операционной сложностью запуска множества параллельных экспериментов, автоматизируя обновление конфигурации, запуск заданий и опрос метрик. Это освободило автора от утомительных ручных проверок, позволив немедленно сравнивать результаты.Постоянные сессии tmux в облачной среде разработки Netflix оказались решающими для предотвращения прерывания многочасовых заданий Spark из-за сбоев сети или закрытия ноутбука. Основными узкими местами производительности были определены оператор collect_list, буферизующий целые пакеты событий в памяти, и неэффективные структуры данных. В частности, изменение идентификаторов сессий на строки UUID и использование Scala Options для полей значительно увеличили потребление памяти. Кроме того, раздутые строковые атрибуты добавляли ненужный вес каждому событию.Исправления включали распаковку примитивных полей из Options и уменьшение пакетов событий путем удаления неиспользуемых атрибутов. Метаданные, не зависящие от сессии, были вынесены в заголовок сессии. Два контринтуитивных вывода подчеркнули сложность управления памятью Spark: сужение строк могло привести к более быстрым OOM, вынуждая использовать широковещательные соединения (broadcast joins), а Adaptive Query Execution (AQE) молчаливо накапливал большие объемы данных в памяти через широковещательные хэш-соединения. Настройка порога широковещания AQE решила эту проблему.Дисциплинированная система журналирования отслеживала каждый эксперимент, его конфигурацию и ключевые метрики, создавая единый источник истины и заставляя вносить изолированные изменения переменных. Была допущена ошибка при тестировании исправления ограничения сессии перед стадией Spark Window, которая буферизовала память перед усечением. Окончательное исправленное исправление переместило усечение вверх по конвейеру, чтобы предотвратить раздувание памяти. Хотя эти усилия по настройке решили непосредственные проблемы, фундаментальная форма данных агрегирования целых сессий в отдельные строки представляет собой будущую проблему масштабирования.

collect_list, буферизующий целые пакеты событий в памяти, и неэффективные структуры данных. В частности, изменение идентификаторов сессий на строки UUID и использование Scala Options для полей значительно увеличили потребление памяти. Кроме того, раздутые строковые атрибуты добавляли ненужный вес каждому событию.Исправления включали распаковку примитивных полей из Options и уменьшение пакетов событий путем удаления неиспользуемых атрибутов. Метаданные, не зависящие от сессии, были вынесены в заголовок сессии. Два контринтуитивных вывода подчеркнули сложность управления памятью Spark: сужение строк могло привести к более быстрым OOM, вынуждая использовать широковещательные соединения (broadcast joins), а Adaptive Query Execution (AQE) молчаливо накапливал большие объемы данных в памяти через широковещательные хэш-соединения. Настройка порога широковещания AQE решила эту проблему.Дисциплинированная система журналирования отслеживала каждый эксперимент, его конфигурацию и ключевые метрики, создавая единый источник истины и заставляя вносить изолированные изменения переменных. Была допущена ошибка при тестировании исправления ограничения сессии перед стадией Spark Window, которая буферизовала память перед усечением. Окончательное исправленное исправление переместило усечение вверх по конвейеру, чтобы предотвратить раздувание памяти. Хотя эти усилия по настройке решили непосредственные проблемы, фундаментальная форма данных агрегирования целых сессий в отдельные строки представляет собой будущую проблему масштабирования.