Netflix TechBlog | Medium на русском
Подписаться
Путешествие по многоуровневому хранению временных рядов: потоки Kafka/Flink к нативным холодным чтениям Cassandra
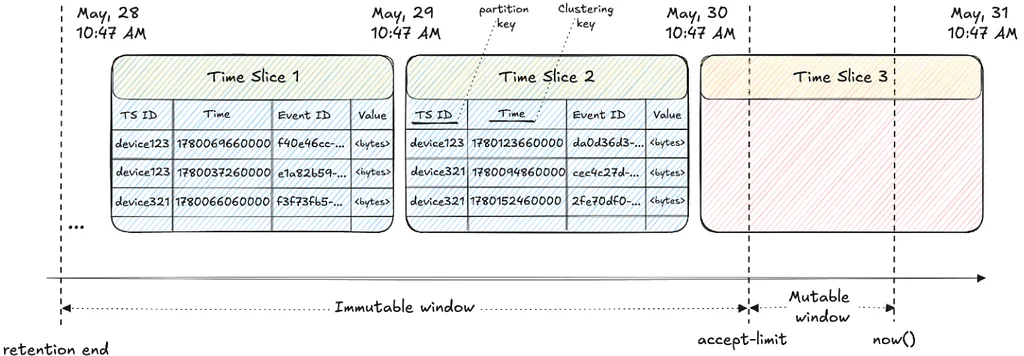
Платформа абстракции временных рядов Netflix, имеющая решающее значение для обработки петабайтных объемов временных данных, сталкивается со значительными проблемами стоимости хранения. Для решения этой проблемы были реализованы два решения для перемещения старых, менее используемых данных в более дешевое объектное хранилище при сохранении доступа с низкой задержкой. Первое решение использует Apache Kafka и Flink для потоковой передачи данных в S3, за которой следует ежедневная задача компактизации, объединяющая и оптимизирующая файлы Parquet. Этот процесс компактизации включает создание небольших групп строк, сортировку событий по времени и использование фильтров Блума для эффективного чтения. Затем компактизированные файлы регистрируются в управляющей плоскости, что позволяет усекать горячее хранилище. Чтения распределяются между горячим и холодным уровнями, причем холодный уровень использует метаданные компактизации для минимизации чтений из S3.Несмотря на успех, потоковая инфраструктура привела к усложнению и увеличению затрат. Это привело к разработке второго, более интегрированного решения, использующего резервные копии Cassandra. Этот подход направлен на чтение данных непосредственно из резервных копий S3 без отдельной передачи данных. Он представил новую стратегию компактизации Cassandra под названием ReadOnlyCompactionStrategy (ROCS) для неизменяемых временных срезов. ROCS выравнивает SSTable по диапазонам токенов, уменьшая разветвление чтений и улучшая задержку на всех уровнях.Cassandra создает резервные копии своих данных в S3, создавая манифесты, которые перечисляют пути к SSTable. Второе решение настраивает Cassandra для чтения непосредственно из этих резервных копий S3 для неизменяемых временных срезов. Оно использует подключаемые Memtable, в частности "backupmemtable", для перенаправления чтений. Этот резервный Memtable загружает необходимые файлы индексов и метаданных из S3 на узел. Надежные механизмы отказоустойчивости обеспечивают надежную загрузку и инициализацию компонентов. Как только локальные компоненты готовы, Cassandra обслуживает чтения из этих резервных копий, параллелизуя чтения из S3 и используя кэширование для дальнейшей оптимизации. Эта стратегия значительно снижает операционные расходы и затраты на инфраструктуру, устраняя отдельную потоковую инфраструктуру.