DEV Community на русском
Подписаться
Реализация RAG с помощью Terraform с использованием AWS S3, Bedrock KnowledgeBase, OpenSearch Serverless, IAM
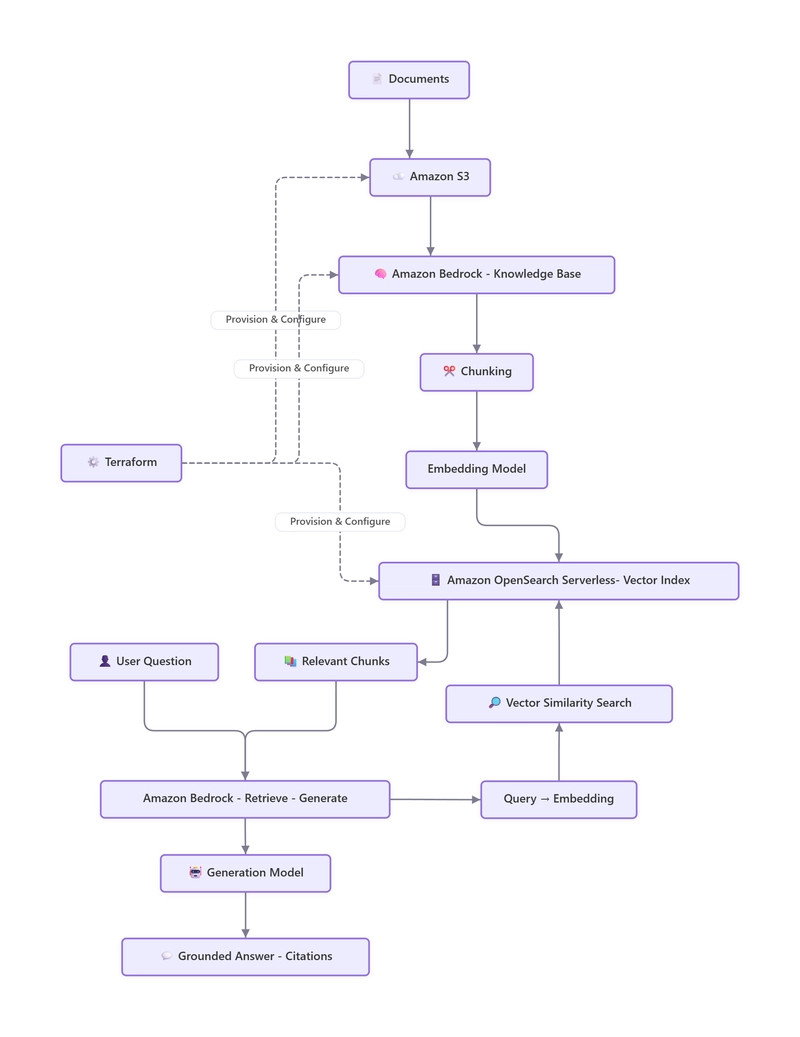
В этом посте подробно описывается реализация системы генерации с дополненной выборкой (RAG) на AWS с использованием Terraform, S3, баз знаний Bedrock и OpenSearch Serverless. RAG позволяет большим языковым моделям (LLM) использовать внешние источники знаний для генерации ответов, повышая точность. Процесс RAG включает два основных этапа: ввод данных и запрос. Во время ввода данных документы из S3 разбиваются на части, преобразуются в числовые вложения с помощью Bedrock и сохраняются в OpenSearch Serverless. Этап запроса включает преобразование вопроса пользователя во вложение, извлечение соответствующих фрагментов документов из OpenSearch и использование их в качестве контекста для LLM для генерации обоснованных ответов с цитатами.Система использует Amazon S3 в качестве источника документов и базы знаний Amazon Bedrock для управления конвейером ввода данных. OpenSearch Serverless настроен как векторная база данных, использующая поле knn_vector для вложений и HNSW с FAISS для эффективного поиска сходства. Индекс OpenSearch также хранит исходный текст и метаданные, поддерживая векторный, лексический поиск и поиск с фильтрацией по метаданным. Косинусное сходство используется для сравнения векторов. Скрипты Terraform определяют инфраструктуру AWS, включая роли IAM, корзины S3, конфигурации баз знаний Bedrock и политики доступа к OpenSearch Serverless. Приложение Streamlit предоставляет пользовательский интерфейс для загрузки документов в S3, запуска синхронизации базы знаний и отправки запросов в систему RAG. Эта комплексная настройка предлагает практическую отправную точку для создания пользовательских систем RAG.