Kubernetes Blog на русском Заметка

Kubernetes Blog на русском

Официальная домашняя страница Kubernetes, системы оркестровки контейнеров для автоматизации развертывания, масштабирования и управления контейнерными приложениями. На этой платформе представлена исчерпывающая документация по Kubernetes, проекту, поддерживаемому Cloud Native Computing Foundation. Она включает в себя подробную информацию о запуске приложений без состояния и с состоянием, пакетных заданиях и рабочих процессах CI/CD с использованием Kubernetes. Сайт содержит подробные руководства, учебники, справочные материалы, документацию по API и инициативы по вовлечению сообщества, чтобы помочь пользователям начать работу с Kubernetes и эффективно использовать его возможности для управления облачными приложениями.

Трэд заметок

Когда задание Kubernetes находится в состоянии ожидания, это может быть связано с тем, что Kueue все еще определяет доступность ресурсов. Плагин Headlamp Kueue помогает исследовать это, интегрируя представления ресурсов Kueue в пользовательский интерфейс. Это позволяет пользователям отслеживать путь приема Workload через LocalQueues, ClusterQueues, ResourceFlavors и Cohorts без обширного использования командной строки. Исследование начинается с изучения статуса и условий Workload, чтобы увидеть, был ли он принят Kueue. Если Workload не принят, проблема заключается в процессе приема Kueue. Если он принят, но Pod'ы находятся в состоянии ожидания, проблема переходит к планировщику Kubernetes. Представление Workload в Headlamp показывает запрошенные ресурсы, а переход по ссылке LocalQueue раскрывает точку входа для запроса задания. Проверка связанной ClusterQueue имеет решающее значение, поскольку ее квота и политики определяют распределение ресурсов. В конкретном примере ClusterQueue с ограниченным количеством слотов для ЦП и Pod'ов привела к тому, что задание, запрашивающее больше, оставалось приостановленным Kueue. ResourceFlavors и Cohorts исследуются для более сложных проблем с квотами или классами оборудования. Если Workload принят, устранение неполадок затем переходит к стандартным представлениям заданий и Pod'ов в Headlamp для проверки событий, связанных с планировщиком. Этот подход, ориентированный на Headlamp, направлен на обеспечение более быстрого и интегрированного опыта устранения неполадок, связанных с задержками в Kueue.
Kubernetes использует cgroups Linux для управления ресурсами контейнеров, с существенным переходом на cgroup v2. Поддержка cgroup v1 находится в режиме обслуживания и будет полностью удалена в будущих релизах Kubernetes. Cgroup v2 предлагает унифицированную иерархию, более согласованный интерфейс и улучшенную изоляцию ресурсов. Kubernetes v1.31 перевел управление cgroup v1 в режим обслуживания, в то время как v2 стабилен с v1.25. Более новые версии Kubernetes, такие как v1.35, по умолчанию приводят к сбою запуска kubelet на узлах с cgroup v1, если это явно не переопределено. Проверки системной верификации в kubeadm также будут отмечать использование cgroup v1 начиная с v1.35. Cgroup v2 включает новые функции, такие как Memory QoS с многоуровневой защитой, предлагая лучшее управление памятью, чем cgroup v1. Он также улучшает обработку OOM (out-of-memory) с учетом контейнеров, гарантируя, что все процессы внутри контейнера будут завершены одновременно. Поддержка rootless-контейнеров также официально лучше обрабатывается благодаря возможностям делегирования cgroup v2. Миграция требует обеспечения совместимости с версиями ядра, средами выполнения контейнеров и конфигурацией kubelet.
Кластеры Kubernetes часто сталкиваются с ограничениями по памяти раньше, чем с ограничениями по ЦП, что усугубляется новыми рабочими нагрузками на основе агентского ИИ. Эти ИИ-нагрузки требуют значительного объема памяти для запуска и выполнения недоверенного кода, а затем остаются в режиме ожидания. Эта неиспользуемая память дорого обходится и ограничивает количество подов, которые может разместить узел. Подкачка памяти, особенно при использовании быстрых NVMe SSD, может решить эту проблему, выгружая неактивную память. Поддержка подкачки в Kubernetes, которая теперь общедоступна, позволяет узлам размещать больше подов. Тестирование на сборках CI/CD, изолированных браузерах и средах выполнения Python продемонстрировало увеличение плотности до трех раз при минимальном влиянии на задержку. Исторически подкачка избегалась из-за проблем с учетом памяти и медленных задержек диска. Однако cgroup v2 и быстрые NVMe SSD решают эти проблемы, делая подкачку жизнеспособным решением. Традиционные рабочие нагрузки, такие как сборка ядра, могут выдерживать сниженные лимиты памяти при включенной подкачке. Рабочие нагрузки с высокой плотностью, такие как браузеры без графического интерфейса, демонстрируют значительное увеличение плотности подов при использовании подкачки. Изолированные среды выполнения Python также выигрывают от подкачки, позволяя проводить в три раза больше одновременных сессий. Включение подкачки на узле включает настройку kubelet и использование локальных дисков облачного провайдера. Рабочие нагрузки с QoS Burstable могут использовать подкачку для динамической балансировки памяти. В конечном итоге, быстрая подкачка выгружает неактивные состояния памяти, увеличивая плотность подов и утилизацию узлов для агентских рабочих нагрузок.
Внедрение Kubernetes привело к управлению сложными жизненными циклами приложений, поддержке разнообразных рабочих нагрузок и обеспечению надежности. SIG Apps, состоящая из контроллеров, таких как Deployments и StatefulSets, составляет основу управления приложениями в Kubernetes. Группа сосредоточена на повышении отказоустойчивости рабочих нагрузок, совершенствовании управления жизненным циклом и решении операционных задач. Джанет Куо и Мачей Шулик, председатели SIG Apps, обсуждают эволюцию управления рабочими нагрузками и будущие направления. SIG Apps является фундаментальной для работы приложений на Kubernetes, управляя их созданием, обновлениями, масштабированием и восстановлением. Поскольку Kubernetes поддерживает более разнообразные рабочие нагрузки, такие как ИИ и пакетная обработка, SIG Apps развивает свои API для обеспечения надежности и простоты. Текущие усилия направлены на обслуживание рабочих нагрузок, улучшение производительности развертывания и масштабирования, а также решение проблем, о которых сообщают пользователи. Основное внимание уделяется повышению отказоустойчивости рабочих нагрузок, особенно в отношении сбоев узлов и их влияния на такие рабочие нагрузки, как DaemonSets и Jobs. Новые подпроекты, такие как JobSet и LeaderWorkerSet, направлены на обработку сбоев при крупномасштабном обучении и инференсе ИИ. Успешная реализация этих улучшений сократит ручное вмешательство для команд, управляющих платформами Kubernetes. Ключевая задача для SIG Apps — найти баланс между агрессивным поведением контроллеров, необходимыми сигналами и критической обратной совместимостью для существующей автоматизации пользователей. Чтобы избежать нарушения устаревших систем, SIG Apps предпочитает функции с возможностью выбора и введение новых парадигм через CRD. Группа также пересматривает предложения, такие как KEP-4443, для улучшения API Job, добавив более конкретные причины сбоев для улучшения автоматизации. Новым участникам предлагается присоединиться к каналу #sig-apps в Slack или внести свой вклад в развитие подпроектов, таких как Agent Sandbox.
В Kubernetes v1.37 функция PersistentVolumeClaimUnusedSinceTime переведена в бета-версию и включена по умолчанию. Это улучшение добавляет условие "Unused" к каждому PersistentVolumeClaim (PVC) в его статусе. Это условие напрямую указывает, ссылается ли на PVC какой-либо запущенный pod. Ранее идентификация неиспользуемых PVC была сложной, требовала перекрестной ссылки на несколько объектов Kubernetes и обширных пользовательских скриптов. Новая функция упрощает это, нативно сообщая о статусе использования PVC. PVC помечается как "Unused", если на него не ссылается ни один незавершенный pod, и как "Used", если к нему прикреплен хотя бы один запущенный или ожидающий pod. Завершенные pod, включая те, что из завершенных пакетных заданий, не считаются активно использующими PVC. Условие "Unused" также включает поле lastTransitionTime, которое записывает, когда PVC стал неактивным. Это позволяет администраторам легко идентифицировать PVC, которые не использовались в течение определенных периодов времени, что помогает оптимизировать затраты и управлять хранилищем. Функция, ранее находившаяся в альфа-версии в v1.36, прошла обширное тестирование и теперь включена по умолчанию для бета-версии. Пользователи могут напрямую проверять статус PVC через kubectl, чтобы наблюдать за этими изменениями. Проект Kubernetes планирует перевести эту функцию в общедоступную в будущем выпуске на основе отзывов пользователей.
Kubernetes v1.37 представляет важные улучшения безопасности хранения данных для усиления защиты рабочих нагрузок. Эти функции позволяют настраивать режимы разрешений для томов emptyDir и параметры bind mount непосредственно в Kubernetes. Это дает разработчикам и специалистам по безопасности возможность применять строгие политики безопасности без сложных обходных путей. Улучшения основаны на фундаментальных механизмах безопасности Linux, таких как флаги bind mount и разрешения каталогов.Флаги bind mount, такие как noexec, nosuid и nodev, контролируют действия, разрешенные на смонтированных файловых системах. Разрешения каталогов, включая sticky bit, регулируют доступ и предотвращают несанкционированное удаление файлов в общих каталогах. Основной мотивацией для этих функций является повышение безопасности рабочих нагрузок Kubernetes путем предоставления параметров bind mount, имеющих отношение к безопасности. Ранее тома монтировались без этих защитных флагов, что создавало уязвимости в безопасности.Существенный пробел, который был устранен, — это невозможность установки параметров монтирования для томов emptyDir и режим разрешений по умолчанию 0777 для каталогов. Это позволяло любому процессу получать доступ, изменять или удалять файлы в томах emptyDir независимо от владельца. Новые функции предоставляют нативные решения, например, позволяя устанавливать sticky bit на emptyDir для безопасных общих рабочих пространств, аналогично поведению /tmp. Эти улучшения позволяют разработчикам приложений предотвращать повышение привилегий на записываемых монтированиях и обеспечивать принцип наименьших привилегий для данных приложений.Сценарии использования включают предотвращение произвольного выполнения двоичных файлов из записываемых томов и обеспечение безопасности общего временного пространства в многоконтейнерных подах. Разработчики теперь могут уверенно ограничивать доступ к временному хранилищу, устанавливая определенные режимы, такие как 0750. Обе функции в настоящее время находятся в стадии Alpha в v1.37 и требуют включения feature gates: VolumeBindMountOptions и EmptyDirVolumeMode. Эти новые возможности специфичны для Linux и не затрагивают узлы Windows.
Kubernetes v1.37 выводит менеджеры ресурсов на уровне подов в статус бета, позволяя менеджерам Kubelet использовать объявления ресурсов на уровне подов. Ранее эксклюзивное выравнивание NUMA для критически важных приложений требовало выделения ядер для всех контейнеров, что было неэффективно для сайдкаров. Эта новая функция обеспечивает гибридное распределение, резервируя выровненные по NUMA ресурсы для основных контейнеров, в то время как общие пулы вмещают сайдкары. Сайдкары получают выравнивание по NUMA и защиту без использования выделенных ядер. Бета-релиз включает в себя функцию PodLevelResourceManagers, которая отключена по умолчанию, и улучшения API PodResources. API теперь сообщает о верхнеуровневых cpu_ids и памяти для подов, предотвращая двойной подсчет при мониторинге. Пользователи могут включить эту функцию для более эффективного управления ресурсами. Цель состоит в обеспечении лучшей производительности для критически важных рабочих нагрузок и более эффективного использования ресурсов. Подробная документация и руководства доступны для пользователей, чтобы начать работу. Обратная связь имеет решающее значение по мере продвижения функции к общедоступности.
Отслеживание измененных блоков (CBT) для драйверов хранилищ CSI Kubernetes изначально было запущено в версии Alpha в сентябре 2025 года. Эта функция улучшает операции с хранилищами, отслеживая изменения в блочных томах. Анонс Alpha содержит подробности о мотивации, основных компонентах и использовании. В настоящее время CBT поддерживает только блочные тома, исключая файловые хранилища. Недавний выпуск v1.0.0 проекта external-snapshot-metadata перевел эту функциональность в стадию Beta.Основным обновлением на этапе Beta является обновление пользовательского определения ресурсов (CRD) SnapshotMetadataService с v1alpha1 до v1beta1. Хотя схема остается прежней, старая версия v1alpha1 была удалена, что требует адаптации пользователей. Для перехода с Alpha на Beta пользователи должны повторно применить определение CRD, обновить свои манифесты для использования новой версии API и скорректировать любой клиентский или контроллерный код. Эта миграция является ручным, одноразовым процессом.Версия Beta требует минимальной версии Kubernetes 1.33 и версии спецификации CSI 1.10 или новее. Совместимым образом контейнера является csi-snapshot-metadata:v1.0.0. Чтобы протестировать функцию, убедитесь, что ваш драйвер CSI поддерживает снимки и включает сайдкар external-snapshot-metadata. Установите CRD v1beta1 и создайте ресурс SnapshotMetadataService для вашего драйвера. Затем используйте инструмент листера или пользовательскую реализацию для взаимодействия с функциями GetMetadataAllocated и GetMetadataDelta.Команда разработчиков в настоящее время сосредоточена на более широком внедрении драйверов CSI и сборе оперативной обратной связи в период Beta. Они призывают сопровождающих драйверов CSI оценить добавление поддержки, а разработчиков резервных приложений — предоставить отзывы о потоковых клиентах и пакете итератора. Дополнительную информацию можно найти в документации для разработчиков CSI, KEP-3314, репозитории external-snapshot-metadata, схеме gRPC и примере snapshot-metadata-lister. Вклад в эту функцию был значительным, и заинтересованным лицам рекомендуется взаимодействовать с SIG Storage и рабочей группой по защите данных.
Kubernetes v1.37 отмечает переход Memory QoS в бета-версию, которая теперь включена по умолчанию на узлах Linux, использующих cgroup v2. Эта функция улучшает управление памятью контейнеров, используя контроллер памяти ядра для лучшего руководства. Изначально представленная как альфа-версия в v1.22, она получила расширенную функциональность в v1.36 с многоуровневым резервированием памяти. Переход в бета-версию означает, что функция MemoryQoS активна во всех kubelet v1.37 без необходимости явных изменений в конфигурации. Важно отметить, что конфигурация kubelet по умолчанию не включает ограничение или резервирование памяти, если пользователи явно не выбирают эту опцию.Пользователи могут включить определенные режимы работы Memory QoS через поля конфигурации kubelet. Например, установка memoryThrottlingFactor активирует ограничение memory.high для контейнеров Burstable и BestEffort. Альтернативно, настройка memoryReservationPolicy на TieredReservation включает многоуровневую защиту памяти через memory.min и memory.low. Важным изменением в v1.37 является изменение значения по умолчанию для memoryThrottlingFactor с 0.9 на null, что предотвращает автоматическое ограничение памяти для существующих кластеров при обновлении. Это гарантирует, что поведение во время выполнения остается неизменным, если явно не настроено иначе.Для настройки Memory QoS операторы кластера могут установить memoryThrottlingFactor для ограничения и memoryReservationPolicy для многоуровневого резервирования. Оба параметра могут быть включены одновременно или независимо. Полное отключение Memory QoS возможно путем установки параметра функции в false и соответствующей корректировки конфигурации kubelet. Известным ограничением является то, что резервирование памяти осуществляется в масштабе всего узла, применяясь одинаково ко всем подам независимо от их желаемого поведения, что влияет на контроль отдельных подов. Следующим этапом разработки Memory QoS является переход к общедоступности, а текущие отзывы формируют будущие корректировки.
Нативные гистограммы переходят в бета-версию в Kubernetes v1.37, предлагая наблюдаемость с высоким разрешением и низкой кардинальностью. Это усовершенствование заменяет устаревшие статические гистограммы Prometheus, которые страдали от угадывания корзин, высокой кардинальности и ошибок интерполяции. Нативные гистограммы Prometheus используют динамические экспоненциальные корзины, хранящиеся в одной временной серии, сокращая количество временных серий до 90%. Это автоматически обеспечивает высокое разрешение и точные расчеты квантилей. В Kubernetes нативные гистограммы интегрированы в общие метрики с двойной экспозицией, обеспечивая совместимость с существующими стеками наблюдаемости. Классические корзины по-прежнему выдаются вместе с новыми нативными интервалами для перехода без нарушения совместимости. Стандартные экспоненциальные опции применяются автоматически, обеспечивая ограниченную погрешность для расчетов квантилей. Эта функция автоматически поддерживает основные компоненты Kubernetes, такие как API-сервер, планировщик и Kubelet. Обновление до Kubernetes v1.37 включает эту функциональность, а конфигурации сбора Prometheus адаптируются для приема нового формата. Миграция панелей мониторинга и оповещений включает обновление запросов PromQL от ссылок на классические корзины к прямому использованию имен метрик. Рекомендуемый рабочий процесс миграции включает первоначальное включение обоих форматов, затем обновление запросов, проверку и, наконец, отключение сбора классического формата для экономии места. Отказ от участия или откат возможны путем корректировки конфигураций сбора Prometheus или управляющих элементов функций компонентов. Эта функция движется к общедоступности, и приветствуется участие сообщества.
В Kubernetes v1.35 было представлено изменение размера Pod "на месте" (in-place), позволяющее динамически регулировать CPU и память без перезапуска. Однако увеличение размера Pod на полностью загруженном узле могло привести к статусу "Отложено" (Deferred) при недостатке ресурсов. Это означало, что Pod бесконечно ожидал освобождения ресурсов. Для решения этой проблемы в Kubernetes v1.37 представлена функция предварительного вытеснения (preemption) планировщиком для изменения размера Pod "на месте", которая в настоящее время находится в стадии Alpha. Эта функция позволяет планировщику Kubernetes проактивно освобождать ресурсы узла. Если запрос на изменение размера Pod "на месте" превышает доступные ресурсы, планировщик может вытеснить Podы с более низким приоритетом. Это гарантирует, что критически важные приложения смогут масштабироваться даже на загруженных узлах. Вытеснение локализовано для текущего узла Podа, нацеливаясь на подходящие рабочие нагрузки с более низким приоритетом. Это позволяет операторам кластера максимально эффективно использовать ресурсы, упаковывая задачи с низким приоритетом. Без этой функции операторы сталкивались с дилеммой между недоиспользованием ресурсов или риском сбоя масштабирования критически важных приложений. Функция интегрируется с существующими механизмами отслеживания планировщика. Она отличает вытеснение для изменения размера от стандартного вытеснения при размещении Podа. Резервирование ресурсов обрабатывается безопасно для предотвращения состояний гонки во время изменения размера. Для использования этой функции требуется Kubernetes v1.37 или более поздняя версия, а также включенный флаг функции InPlacePodVerticalScalingSchedulerPreemption. Администраторы могут отключить вытеснение для изменения размера на определенных узлах, используя поле podPreemptionPolicy.
Традиционно Kubernetes не хватало унифицированного способа описания состояний жизненного цикла узла, выходящего за рамки базовой информации о статусе. Это часто приводило к фрагментированному пониманию и потенциальным конфликтам между различными компонентами кластера. Kubernetes v1.37 представляет пять общеизвестных состояний узла для устранения этого пробела. Эти новые состояния: DrainInProgress, Drained, MaintenancePlanned, MaintenanceInProgress и GracefulNodeShutdownInProgress. Каждое состояние использует статус True, False или Unknown для указания своего текущего состояния. Администраторы или авторизованные контроллеры несут ответственность за установку и снятие этих состояний. В настоящее время основные контроллеры рабочих нагрузок не действуют на основе этих состояний, но они обеспечивают операционную ясность, сигнализируя о событиях жизненного цикла узла. Например, автоматизация может установить MaintenancePlanned перед началом работ и MaintenanceInProgress после их начала. Аналогично, автоматизация дренирования может соответствующим образом установить DrainInProgress и Drained. Рекомендуемый подход заключается в использовании этих состояний для отчетности о статусе, при этом продолжая использовать существующие механизмы Kubernetes для фактических операций, таких как изоляция (cordoning) и дренирование (draining). Этот общий сигнал имеет решающее значение, поскольку различные компоненты кластера, от планировщика до внешних систем обслуживания, должны понимать статус узла. Без него компоненты могут принимать противоречивые решения, например, контроллер DaemonSet может заменить Pod, намеренно завершенный во время корректного завершения работы. Эти новые состояния обеспечивают стабильную основу для будущих улучшений в управлении жизненным циклом узла. Сообщество Kubernetes активно собирает отзывы об этих новых состояниях для улучшения сценариев, таких как корректное завершение работы узла и обслуживание.
Kubernetes v1.37 знаменует собой важную веху для планирования с учетом нагрузки, улучшая поддержку сложных пакетных и AI/ML рабочих нагрузок. Основные API Workload и PodGroup, необходимые для пакетного планирования, перешли в стадию Beta. Этот релиз представляет API CompositePodGroup для управления иерархическими требованиями к планированию для гетерогенных групп Pod. Новые API интеграции контроллеров и библиотека Go workloadbuilder упрощают интеграцию внешних контроллеров с функциями планирования с учетом нагрузки. Нативный контроллер Job теперь полностью использует эти расширенные API для продвинутых политик планирования и учета топологии. Пакетное планирование и API Workload/PodGroup стали более надежными благодаря переходу в стадию Beta и обновленному версионированию. Очередь PodGroup была улучшена, что сделало PodGroup полноправными участниками очереди планирования. Поле minCount для PodGroup теперь изменяемо, что позволяет динамически настраивать эластичные рабочие нагрузки. Прерывание с учетом нагрузки теперь интегрировано в функцию GenericWorkload и учитывает режимы прерывания PodGroup. API CompositePodGroup позволяет осуществлять многоуровневое планирование с учетом топологии, обеспечивая сложные ограничения совместного размещения на различных уровнях инфраструктуры.
Kubernetes v1.37 продвигает KubeletInUserNamespace в бета-версию, позволяя компонентам узлов, таким как Kubelet и runtime, работать как некорневые пользователи. Этот rootless-режим, развивший эксперимент 2018 года, повышает безопасность, ограничивая потенциальные уязвимости контейнера. В отличие от под-пространств имён, этот режим сосредоточен на компонентах узлов хоста. Эта функция снижает риски уязвимостей, таких как CVE-2022-0811 и CVE-2023-27561, которые исторически могли предоставлять злоумышленникам корневые права. Работая в пользовательском пространстве имён, злоумышленник ограничивается учетной записью пользователя, не относящегося к корневому пользователю, препятствуя модификации ядра или прошивки. Пользовательские пространства имён сами по себе не защищают от уязвимостей ядра и должны сочетаться с другими мерами ужесточения, такими как seccomp. Эта функция имеет различные сценарии, включая производственные кластеры, общие машины, ноутбуки и песочницы ИИ. Он работает путём отображения пользователя хоста, не входящего в root, на фальшивый корень внутри пространства имён, что достаточно для большинства задач компонентов узлов. Пользовательское пространство имён должно быть создано внешне, например, с помощью Rootless Docker. Функция KubeletInUserNamespace, теперь включенная по умолчанию, позволяет Kubelet игнорировать определённые ошибки разрешения. Недавние улучшения включают лучшую поддержку idmapped tmpf, пользовательских подов с пространственными именами и записываемых cgroups, что позволяет внедрять вложенные Kubernetes. Инструменты, такие как kind, minikube, Usernetes и k3s, предлагают простые способы создания rootless кластеров Kubernetes. Проект планирует в будущем перейти эту функцию к статусу General Availability и приветствует участие сообщества.
Kubernetes 1.37 представляет значительные усовершенствования для динамического выделения ресурсов (DRA), при этом поддержка расширенных ресурсов достигла общего доступа. Это позволяет драйверам DRA управлять традиционными расширенными ресурсами без отдельных плагинов устройств. ResourceClaims теперь включают поле devices в своем статусе, обеспечивая лучшую видимость состояний устройств, таких как имена сетевых интерфейсов и IP-адреса. Taints и tolerations устройств DRA теперь стабильны, отражая taints узлов для управления доступностью и обслуживанием устройств. Стандартизированный атрибут устройства numaNode обеспечивает единообразное именование между различными драйверами.Поддержка рабочих нагрузок ResourceClaim перешла в бета-версию, позволяя использовать один claim несколькими Pod'ами, преодолевая предыдущие ограничения. DRA Device Attributes Downward API, теперь в бета-версии, облегчает внедрение атрибутов устройств непосредственно в рабочие нагрузки, упрощая пользовательские контроллеры. Альфа-функции включают списковые типы для атрибутов, позволяя более сложное сопоставление устройств, и запросы ресурсов, выделяемых узлом, для предотвращения чрезмерного выделения ресурсов узла.Видимость доступности ресурсов находится во второй альфа-версии, предлагая снимки состояния в определенный момент времени. Необязательные операции узлов DRA позволяют драйверам пропускать ненужные вызовы настройки узла. Производные атрибуты, новая альфа-функция, используют выражения CEL для гибкого сопоставления устройств на основе пользовательских правил. Группы совместимости устройств DRA предотвращают планирование несовместимых комбинаций устройств.Расширение PreQueueingHint, также в альфа-версии, оптимизирует планирование pod'ов, сокращая область сканирования при масштабировании. DRA Consumable Capacity теперь поддерживает дробные значения, повышая точность выделения ресурсов. Эти постоянные разработки подчеркивают приверженность Kubernetes улучшению возможностей управления ресурсами.
Kubernetes v1.37 теперь предлагает бета-поддержку API для масштабирования рабочих нагрузок до нуля реплик, по умолчанию. Это позволяет HorizontalPodAutoscaler сокращать неиспользуемые ресурсы до нуля, а затем масштабироваться обратно при необходимости. Ранее эта функциональность требовала внешних дополнений или альфа-флагов функций. Масштабирование до нуля особенно выгодно для таких рабочих нагрузок, как потребители очередей, где экономия ресурсов может быть значительной, особенно при использовании дорогостоящего выделенного оборудования.Основным компромиссом является увеличение времени холодного старта, поскольку системе необходимо наблюдать за метриками, планировать pod и запускать приложение. Этот подход наиболее эффективен, когда работа может быть временно удержана в долговечной очереди. В отличие от метрик CPU или памяти, которые перестают существовать при исчезновении pod, объектные и внешние метрики сохраняются независимо. Это позволяет HorizontalPodAutoscaler продолжать отслеживать метрики, такие как длина очереди, даже когда рабочие pod не запущены.Для масштабирования с нуля необходим адаптер внешних метрик, такой как Prometheus Adapter, для предоставления метрик, таких как отставание потребителя очереди, в Kubernetes. Затем HorizontalPodAutoscaler настраивается с минимальным количеством реплик, равным нулю, и нацеливается на внешнюю метрику для управления масштабированием. Специальное условие состояния ScaledToZero отличает автоматическое масштабирование вниз от ручной паузы, гарантируя, что HorizontalPodAutoscaler может возобновить управление. Эта функция, ранее находившаяся в альфа-версии, перешла в бета-версию в v1.37 и включена по умолчанию для повышения эффективности использования ресурсов.
etcd RangeStream переходит в бета-версию в Kubernetes v1.37, работая с etcd v3.7. Эта функция значительно снижает потребление памяти API-сервером и etcd при чтении больших коллекций ресурсов. Ранее заполнение кэша наблюдения API-сервера включало дорогостоящее полное чтение из etcd. Хотя пагинация существовала, она основывалась на количестве ключей, а не на размере объектов, что приводило к непредсказуемым скачкам потребления памяти и возможным ошибкам Out-Of-Memory. Унитарный RPC Range в etcd собирал целые страницы перед отправкой, усугубляя нагрузку на память как etcd, так и API-сервера.Новый RPC RangeStream в etcd v3.7 решает эту проблему, передавая результаты по частям. Размер части адаптивно настраивается в зависимости от размеров значений, ограничивая чтение по байтам, а не по количеству ключей. Это позволяет постепенно освобождать память по мере продвижения потока. Когда включен флаг функции EtcdRangeStream, API-сервер использует RangeStream как для инициализации кэша наблюдения, так и для резервных запросов списка. Он декодирует и освобождает части по мере их поступления, предотвращая одновременное хранение всей коллекции в памяти. Эта функция требует Kubernetes v1.37+ и etcd v3.7+. API-сервер автоматически определяет поддержку etcd и переключается на резервный вариант, если RangeStream не реализован. Чтобы убедиться, что RangeStream активен, отслеживайте метрику etcd_request_duration_seconds_count{operation="listStream"} на наличие ненулевых значений.
Миграция версий хранения (SVM) достигла общего доступа в Kubernetes v1.37 и теперь включена по умолчанию. Эта функция решает проблему обновления версии хранения ресурсов API Kubernetes. Ресурсы хранятся с использованием определенного представления схемы, и изменения в этом представлении требуют перезаписи существующих объектов. Распространенным сценарием использования является продвижение пользовательского определения ресурсов (CRD) к более новым версиям API при одновременной отмене устаревших. Без SVM удаление старых версий было небезопасным, если ресурсы все еще использовали их для хранения. Аналогично, шифрование в состоянии покоя или ротация ключей требовали перезаписи хранимых данных для применения нового шифрования. Ранее это требовало ручного написания скриптов или использования внешних инструментов, которые были подвержены ошибкам и сложны в управлении. SVM упрощает это, вводя декларативный объект API StorageVersionMigration. Встроенный контроллер отслеживает эти объекты и автоматически мигрирует ресурсы к указанной версии хранения по умолчанию. Инициирование миграции включает создание объекта StorageVersionMigration, который затем обрабатывается контроллером. Статус миграции можно отслеживать, а успешное завершение означает, что все ресурсы обновлены. Авторы CRD теперь могут включать манифесты миграции непосредственно с обновлениями CRD для оптимизации процесса.
Kubernetes представил сертификаты подов и пакеты доверия кластера как новый механизм идентификации для производственных сред. Эта функция, теперь общедоступная, интегрирует выдачу сертификатов X.509 для TLS и mTLS непосредственно в ядро Kubernetes. Это значительный шаг вперед по сравнению с предыдущим основным механизмом — JWT учетных записей служб. В то время как JWT предлагают простоту использования и широкую совместимость, они страдают от критического недостатка: это токены-носители, что делает их уязвимыми для несанкционированного доступа в случае компрометации. Сертификаты подов, с другой стороны, используют учетные данные с подтверждением владения, основанные на асимметричной криптографии, в первую очередь сертификатах X.509. Это повышает безопасность, требуя демонстрации владения, а не простого обмена самой учетной записью.Цель состоит в том, чтобы сделать использование сертификатов X.509 из рабочих нагрузок Kubernetes таким же простым, как и JWT, при сохранении высоких стандартов безопасности. Сертификаты подов разработаны с учетом гибкости, позволяя использовать различные типы сертификатов в одном кластере через подключаемый интерфейс. Это контрастирует с единым, стандартизированным форматом JWT учетных записей служб. Ожидается, что будущие версии Kubernetes предложат встроенные поставщики сертификатов для DNS-имен служб и клиентских сертификатов SPIFFE.Архитектура включает в себя приложение, запрашивающее сертификаты, Kubelet, выдающий запросы и управляющий пакетами доверия, и контроллер подписи, выполняющий эти запросы и публикующий пакеты доверия. Процесс выдачи является хронологическим, начиная с планирования пода и заканчивая доступом приложения к своим ключам и сертификатам. Автоматическое обновление встроено, и приложениям необходимо обрабатывать эти обновления. Проверки безопасности интегрированы в kube-apiserver для обеспечения изоляции и предотвращения получения необоснованного доступа скомпрометированными узлами. Чтобы поэкспериментировать с этими функциями, пользователям необходимо установить сторонний подписант, такой как Tinycert, который предоставляет примеры подписантов и библиотеку для помощи приложениям в загрузке сертификатов SPIFFE.
Kubernetes v1.37 перевел API metrics.k8s.io в стабильную версию v1. Этот API предоставляет важные данные об использовании ЦП и памяти для узлов и подов. Он лежит в основе таких критически важных функций, как kubectl top и автомасштабирование на основе метрик ресурсов. Для операторов кластеров и разработчиков этот переход означает гарантированную стабильность API. API v1 сохраняет те же типы ресурсов и поля, что и его предшественник v1beta1. API метрик ресурсов, представленный как альфа-версия в v1.6, стал бета-версией в v1.8 и надежно используется в производстве в течение многих лет. API предоставляет NodeMetrics для использования ресурсов узла и PodMetrics для использования ресурсов пода, включая разбивку по контейнерам. Он намеренно предлагает только метрики, необходимые для автомасштабирования и базового анализа, а не полноценное решение для мониторинга. Поверхность API v1 идентична v1beta1, за исключением самой версии API. В то время как kubectl top поддерживает обе версии, отдавая предпочтение v1, контроллер Horizontal Pod Autoscaler в настоящее время поддерживает только v1beta1. Никакие функциональные ворота не должны быть включены, так как API предоставляется через агрегацию API реализациями, такими как metrics-server. Чтобы сделать v1 доступным, реализации должны предоставлять его и иметь зарегистрированный соответствующий APIService. Во время этого перехода реализации должны продолжать предоставлять как v1, так и v1beta1 для обратной совместимости.
Выпущена Kubernetes v1.37 под названием Garhwal с 67 улучшениями. Шестнадцать функций перешли в стабильную версию, 23 — в бета-версию, а 27 — в альфа-версию. Тема релиза символизирует взаимосвязь вклада сообщества. Ключевым обновлением в стабильной версии является инициализация кэша отслеживания с повышенной отказоустойчивостью, улучшающая запуск и восстановление API-сервера за счет предотвращения перегрузки etcd. Поддержка масштабирования до нуля для Horizontal Pod Autoscaler, теперь в бета-версии, позволяет снижать нагрузку при простое для сокращения расходов, за исключением метрик ЦП и памяти. Конфигурация управления доступом на основе манифестов также переходит в бета-версию, позволяя загружать политики и вебхуки с диска. В альфа-версии представлены контрольные точки и восстановление на уровне Pod, расширяющие CRI новыми RPC для сред выполнения контейнеров. Среди заметных переходов в стабильную версию — KYAML для более безопасных подмножеств YAML и API metrics.k8s.io для использования ресурсов. Флаги SELinuxMount и SELinuxChangePolicy теперь стабильны и включены по умолчанию для томов. Несколько функций распределения ресурсов устройств (DRA) достигли стабильной версии, включая статус ResourceClaim для конфигурации устройств, обработку запросов расширенных ресурсов, метки и допуски устройств, а также стандартизированный атрибут устройства узла NUMA. Функции, объявленные узлом, — фреймворк для объявления возможностей узла с контролем доступа по функциям — также переходят в стабильную версию.
KYAML предлагает более строгий и последовательный способ написания манифестов Kubernetes, устраняя проблемы, присущие стандартному YAML. Разработанный как подмножество YAML, KYAML сохраняет совместимость с существующими парсерами, одновременно сужая стилистические возможности. Он призван предотвратить распространенные ловушки, такие как чувствительность к пробелам и неявное приведение типов, которые могут привести к неожиданному поведению. В отличие от стандартного YAML, KYAML явно определяет структуру и типы, используя фигурные скобки для словарей и квадратные скобки для списков. Он требует заключения строковых значений в кавычки, чтобы избежать неявного преобразования типов, такого как "Норвежская ошибка", когда "NO" интерпретируется как логическое значение false. KYAML также поддерживает комментарии и завершающие запятые, улучшая процесс написания конфигураций по сравнению с JSON. Kubernetes 1.34+ позволяет генерировать вывод KYAML с помощью kubectl -o kyaml. Такие инструменты, как sigs.k8s.io/yamlfmt и google/yamlfmt, могут преобразовывать существующие файлы YAML в формат KYAML. Принятие KYAML — это выбор в пользу большей согласованности и меньшего количества ошибок, особенно в командной среде, без необходимости внесения изменений в существующие инструменты или конвейеры Kubernetes. Это новая привычка для написания более надежных конфигураций, а не обязательная миграция.
Kubernetes Gateway API выпустил версию 1.6.0, расширив свои возможности для сетевого взаимодействия сервисов. Этот новый релиз знаменует собой значительный прогресс за счет стандартизации маршрутизации протоколов уровня 4. Ранее стабильная основа Gateway API предназначалась в основном для HTTP и TLS трафика. Версия 1.6.0 теперь включает ресурсы TCPRoute и UDPRoute в стабильный API версии 1. Эти ресурсы позволяют маршрутизировать необработанный TCP и UDP трафик, устраняя пробел для таких рабочих нагрузок, как базы данных и телеметрия IoT. Экспериментальные инновации также оптимизируются за счет более четких границ API. Новые экспериментальные ресурсы теперь находятся в отдельной группе API, gateway.networking.x-k8s.io, и используют префикс 'X'. Это различие облегчает идентификацию экспериментальных и стандартных ресурсов. Например, ресурс XBackend является новым экспериментальным дополнением, обеспечивающим расширенные конфигурации бэкенда. Он позволяет использовать такие назначения, как ExternalHostname, которые ранее вызывали проблемы для стабильного ресурса Service. Эта экспериментальная функция предназначена для таких сценариев использования, как исходящий трафик к облачным API. Переход маршрутизации TCP и UDP в стандартный формат укрепляет Gateway API как универсальное сетевое решение. Пользователи теперь могут использовать версию 1.6.0 с различными совместимыми реализациями контроллеров Gateway. Сообщество Gateway API приветствует отзывы и вклад от пользователей и разработчиков.
Контроллеры Kubernetes, обычно написанные на Go с использованием kubebuilder и controller-runtime, обеспечивают эффективную разработку распределенных рабочих нагрузок. Однако по мере увеличения нагрузки понимание внутреннего устройства controller-runtime становится критически важным для предотвращения производственных проблем. Основная концепция заключается в том, что r.Get() и r.List() в реконсилере не обращаются напрямую к API-серверу; вместо этого они получают доступ к локальному кэшу в памяти. Этот кэш изначально заполняется операцией списка, а затем поддерживается с помощью отслеживания (watches).Такая конструкция делает локальные чтения исключительно быстрыми, избегая нагрузки на управляющий узел. Однако компромиссом является то, что локальный кэш может потреблять значительный объем памяти и возвращать устаревшие данные. Записи, напротив, всегда направляются на API-сервер, минуя кэш. Размер этого локального кэша и стратегии индексирования напрямую влияют на использование памяти. Неэффективная операция List() может непреднамеренно привести к медленному линейному сканированию большого количества объектов.Цикл реконсиляции непрерывно сравнивает желаемые состояния с фактическими, чтобы привести их в соответствие. События ставятся в очередь, что приводит к функции реконсиляции, которая считывает текущее состояние, определяет необходимые действия и потенциально генерирует новые события. Основная цель кэша — обеспечить быстрое и актуальное представление состояний объектов для этих циклов реконсиляции. Эта модель отслеживания, унаследованная от client-go, предотвращает постоянное опрашивание API, поддерживая одно долгоживущее соединение для обновлений.controller-runtime абстрагирует сложности низкоуровневых компонентов client-go, таких как Reflector, DeltaFIFO и Indexer. Менеджер (Manager) оркестрирует общий кэш, контроллеры и другие службы. Информатор (Informer) отслеживает определенный GVK, поддерживая локальное хранилище (Indexer) и отправляя события подписчикам. ResourceEventHandlers обрабатывают эти события, обновляя хранилище, которое затем отражается в представлении контроллера. Очередь задач (workqueue) управляет ключами объектов для обработки рабочими, а предикаты (Predicates) фильтруют события перед постановкой в очередь.Reflector является единственным компонентом, напрямую взаимодействующим с API-сервером, выполняя первоначальный список, а затем устанавливая отслеживание. Он использует resourceVersion для возобновления отслеживания и обеспечения того, чтобы ни одно событие не было пропущено. Если соединение отслеживания теряется или API-сервер указывает устаревший resourceVersion, выполняется повторный список (relist). DeltaFIFO действует как упорядоченный буфер для изменений, группируя дельты по ключу объекта. Он предоставляет все накопленные изменения для объекта с момента последнего вызова Pop(), обеспечивая упорядоченную пакетную обработку. Однако он не сворачивает последовательные события "Добавлено" или "Обновлено", что может привести к нескольким раундам обработки для быстро меняющихся объектов.
Kubernetes масштабируется на основе ЦП и памяти, но реальные потребности часто требуют пользовательских метрик, таких как глубина очереди или активные соединения. Экспортер метрик Prometheus заполняет этот пробел, предоставляя состояние приложения в виде обычного текста в конечной точке HTTP /metrics для сбора Prometheus.Экспортеры могут быть автономными службами или встраиваться непосредственно в приложение, в зависимости от источника данных и контроля над кодом приложения. Prometheus ожидает метрики в определенных форматах: счетчики для постоянно увеличивающихся значений, датчики для колеблющихся значений и гистограммы для распределений. Имена метрик должны следовать четкому соглашению " __ " snake_case. Создание экспортера на Go включает инициализацию модуля, настройку библиотеки клиента Prometheus и регистрацию метрик, таких как счетчики, датчики и гистограммы. Затем эти метрики обновляются циклом опроса, который считывает данные из источников данных вашего приложения. HTTP-сервер предоставляет конечную точку /metrics, а также конечную точку /healthz для проверок работоспособности. Экспортер упаковывается в минимальный образ контейнера с использованием многоступенчатой сборки Docker, обеспечивая небольшой размер. Развертывание в кластере Kubernetes включает Deployment для управления подами и Service для предоставления стабильного адреса для Prometheus. Prometheus обнаруживает эти метрики через ServiceMonitor при использовании Prometheus Operator или через обнаружение на основе аннотаций в шаблоне Pod. Проверка включает проверку страницы целей Prometheus, чтобы убедиться, что экспортер находится в состоянии "UP", и запрос метрик в браузере выражений. Эта основа позволяет использовать автоматическое масштабирование с помощью HorizontalPodAutoscaler, который использует адаптер метрик (например, Prometheus Adapter) для интеграции пользовательских метрик с Kubernetes Custom Metrics API. Это позволяет рабочим нагрузкам масштабироваться на основе бизнес-значимых сигналов, а не только базового использования ресурсов.
Kubernetes все чаще становится стандартной платформой для рабочих нагрузок в области искусственного интеллекта и машинного обучения. Kubeflow — популярный инструмент, который использует пользовательские определения ресурсов (CRD) Kubernetes для управления этими задачами машинного обучения. Хотя специализированные панели управления Kubeflow помогают специалистам по данным, они часто скрывают базовый уровень Kubernetes, заставляя операторов использовать kubectl для устранения неполадок. Плагин Headlamp Kubeflow устраняет этот разрыв, отображая пользовательские ресурсы Kubeflow непосредственно в универсальном пользовательском интерфейсе Kubernetes. Это позволяет операторам наблюдать и управлять ресурсами машинного обучения, используя те же примитивы, что и другие компоненты кластера. Сам Headlamp — это расширяемый веб-интерфейс Kubernetes, поддерживаемый в рамках Kubernetes SIG UI. Плагин предоставляет информацию на уровне кластера, напрямую запрашивая API-сервер Kubernetes, предлагая подробные сведения о состояниях Pod, причинах сбоев и состояниях ресурсов в различных пространствах имен. Он поддерживает различные компоненты Kubeflow, такие как Notebooks, Pipelines, Katib для настройки гиперпараметров, Training и Spark. Плагин позволяет просматривать сведения о Pod ноутбуков, состояния проб Katib и состояния конвейеров без обращения к базе данных бэкенда Kubeflow. Он также отображает ресурсы машинного обучения в виде узлов графа в Headlamp, визуализируя взаимосвязи между ними. Этот подход демонстрирует шаблон для любой платформы с большим количеством CRD, позволяющий операторам получать необходимую видимость на уровне кластера непосредственно в их привычных инструментах.
Kubernetes Dashboard и Headlamp предоставляют видимость кластера, но работают по-разному. Headlamp — это клиент для рабочего стола или внутри кластера, который использует kubeconfig для подключения к нескольким кластерам, учитывая идентификацию пользователя. Kubernetes Dashboard — это веб-приложение внутри кластера, обычно доступное через аутентификацию по токену. Для миграции задокументируйте текущее использование Dashboard, проверьте работоспособность kubeconfig и выберите план развертывания, например, параллельное развертывание. Решите, будет ли Headlamp работать на вашем рабочем столе или внутри кластера; настольный вариант быстрее для индивидуального использования, а внутрикластерный лучше подходит для общего доступа. Установка на рабочий стол проста через менеджеры пакетов, в то время как установка внутри кластера использует Helm или YAML-манифесты. Аутентификация для настольного Headlamp зависит от kubeconfig, тогда как внутрикластерные настройки часто используют OpenID Connect (OIDC) или внешний слой аутентификации для входа. Headlamp уважает разрешения RBAC, что означает, что пользователи видят и могут выполнять только те действия, на которые они уполномочены. Headlamp превосходно справляется с управлением несколькими кластерами, позволяя пользователям переключаться между кластерами непосредственно в пользовательском интерфейсе, используя свой kubeconfig. Это обеспечивает более интегрированный опыт по сравнению с фокусировкой Kubernetes Dashboard на одном кластере.
SIG etcd объявляет о выпуске etcd v3.7.0, значительного обновления распределенного хранилища ключ-значение. Этот выпуск представляет долгожданную функцию RangeStream, обеспечивающую эффективную потоковую передачу больших наборов результатов. Он также включает различные улучшения производительности, в том числе более быстрые операции с арендой и оптимизированные запросы диапазона только для ключей. Зависимость от устаревшего хранилища v2 полностью устранена, теперь etcd загружается исключительно из v3store, что упрощает операции. Комплексный пересмотр protobuf заменяет устаревшие библиотеки поддерживаемыми версиями, улучшая безопасность и удобство сопровождения. В выпуске также обновлены основные зависимости: bbolt до v1.5.1 и raft до v3.7.0. Дополнительные улучшения включают поддержку Unix-сокетов для локальной разработки и тестирования. Команды etcdutl теперь имеют аргументы тайм-аута для предотвращения бесконечной блокировки. Клиент v3 предлагает большую гибкость аутентификации с прямой установкой JWT и возможностью получения AuthStatus без предварительной аутентификации. Добавлены новые метрики длительности наблюдения и запросов для улучшения наблюдаемости. Команды etctl были реорганизованы для ясности, а устаревшие экспериментальные флаги удалены. Также проведена значительная очистка устаревших пакетов и кода API v2.
ИИ преобразует разработку программного обеспечения, позволяя большему количеству участников благодаря генерации кода. Однако это развитие опережает улучшения в обслуживании кода, что представляет собой проблему. Сообщество Kubernetes активно адаптируется к кодированию с помощью ИИ, устанавливая комплексную политику ИИ. Эта политика направлена на баланс инноваций и подотчетности, обеспечивая качество кода и человеческий надзор. Основным принципом является прозрачность, которая требует от участников раскрытия использования ИИ в их запросах на включение.Критически важно, что человеческая подотчетность остается главной; ИИ не может быть указан в качестве соавтора или соавторства. Участники также должны лично объяснить любой код, сгенерированный ИИ, предотвращая пробелы в знаниях. Проект обеспечивает соблюдение соглашений о лицензии участников для всех соавторов, включая те, которые используют ИИ, помечая неполные запросы на включение. Автоматические обзоры ИИ исследуются для улучшения качества кода и предоставления первоначальной обратной связи.Инструменты, такие как GitHub Copilot и CodeRabbit, оцениваются и тестируются в конкретных проектах Kubernetes. Эти инструменты могут действовать как ворота качества, предлагая быстрые проверки перед человеческим обзором. Сообщество активно ищет помощь в настройке инструментов обзора, оценке новых технологий ИИ и изучении потенциала ИИ в снижении выгорания обслуживающих и помощи в тестировании.
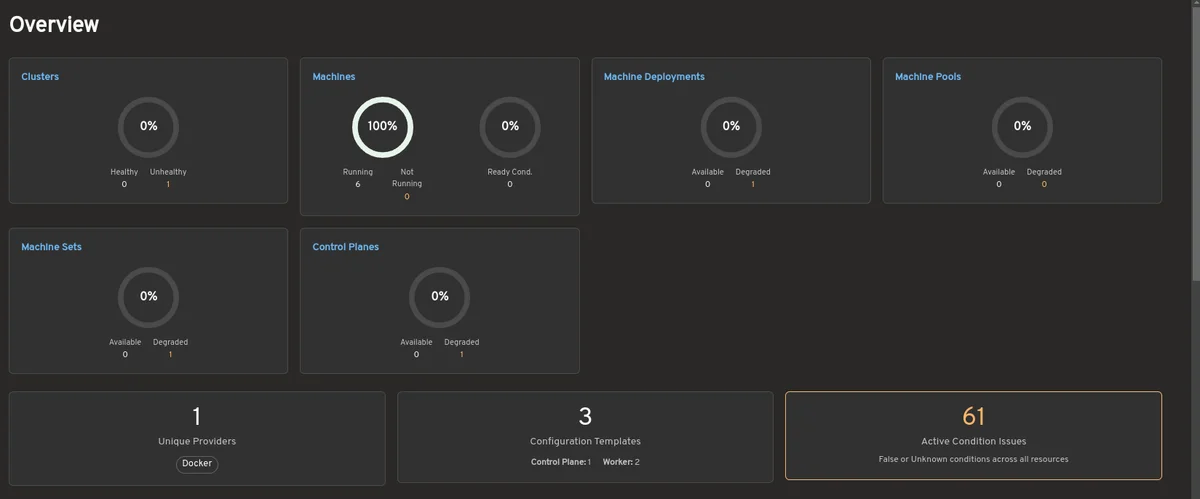
Налобный фонарь — это проект пользовательского интерфейса Kubernetes с открытым исходным кодом для управления ресурсами кластера из браузера. Cluster API (CAPI) предоставляет декларативные API в стиле Kubernetes для управления жизненным циклом кластера. Плагин Headlamp Cluster API упрощает управление ресурсами CAPI, устраняя необходимость в необработанных командах kubectl. Этот плагин добавляет выделенный раздел CAPI в Headlamp, предлагая полную видимость основных ресурсов CAPI через согласованные представления списка и деталей. Ключевые функции включают обзор кластера, видимость машин и централизованную панель мониторинга Cluster API для мониторинга состояния. Пользователи могут отслеживать реплики KubeadmControlPlane, масштабировать MachineDeployments и MachineSets, а также визуализировать иерархии принадлежащих ресурсов. Плагин также позволяет проверять KubeadmConfig без необработанного YAML и обеспечивает осведомленность о топологии. Представление карты визуализирует отношения кластера, плоскости управления и рабочих узлов, поддерживая версии Cluster API как v1beta1, так и v1beta2. Метрики Prometheus интегрированы для получения оперативных данных о производительности непосредственно на страницах с подробностями. Разработанный в рамках программы наставничества CNCF LFX, плагин призван улучшить опыт управления Cluster API. Это альфа-версия, и сообществу предлагается оставлять отзывы для дальнейшего развития.
CdXz5zHNQW_bupmQg41I4.png
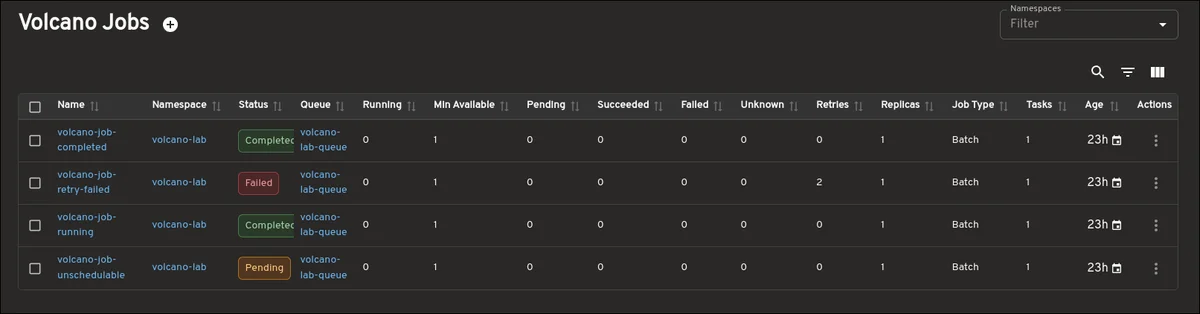
Volcano — это облачный планировщик пакетных заданий для Kubernetes, разработанный для высокопроизводительных вычислений, ИИ/МО и других пакетных рабочих нагрузок. Kubernetes изначально был создан для долгоживущих сервисов, тогда как пакетные рабочие нагрузки часто требуют динамического поступления заданий, конкуренции за ресурсы и одновременного запуска нескольких рабочих процессов. Volcano расширяет Kubernetes такими концепциями, как очереди, приоритеты, квоты и групповое планирование, рассматривая рабочие нагрузки как единое целое, а не как независимые поды. Плагин Volcano для Headlamp, расширяемого веб-интерфейса Kubernetes, выводит эти детали планирования в единый интерфейс.Плагин предоставляет специализированные представления для заданий Volcano, очередей и групп подов, что упрощает эксплуатацию и устранение неполадок пакетных рабочих нагрузок. Представление заданий отображает статус рабочей нагрузки, детали задач, статус подов и позволяет выполнять прямые действия, такие как приостановка/возобновление и доступ к журналам. Представление очередей предоставляет информацию о распределении ресурсов, емкости и деталях резервирования. Представление групп подов разъясняет состояния группового планирования и потенциальные блокировки.Ключевой особенностью является представление карты, которое визуально отображает взаимосвязь заданий, очередей, групп подов и подов, помогая быстро выявлять проблемы в ожидающих или не продвигающихся рабочих нагрузках. Этот плагин улучшает интерактивное устранение неполадок, централизуя связанные ресурсы, структурированные детали и выходные данные времени выполнения, не заменяя инструменты командной строки для автоматизации. Будущие улучшения могут включать интеграцию с Prometheus и более глубокое понимание планирования. Пользователи могут установить плагин через каталог плагинов Headlamp и предоставить обратную связь для формирования его развития.
CdXz5zHNQW_lVauTs2nj6.png
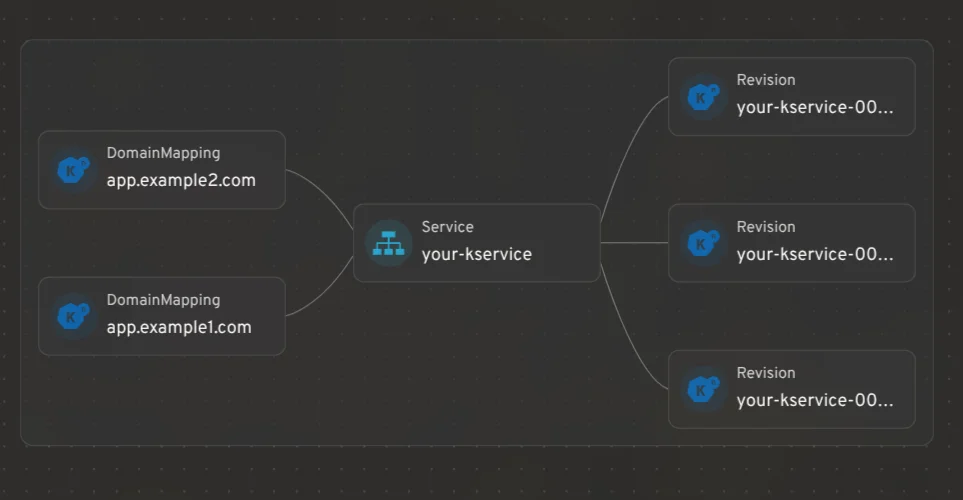
Headlamp — это проект с открытым исходным кодом, предназначенный для управления и отладки ресурсов Kubernetes. Knative позволяет запускать бессерверные рабочие нагрузки на Kubernetes, но может быть сложным в эксплуатации с использованием нескольких инструментов. Для решения этой проблемы был разработан плагин Headlamp для Knative. Этот плагин позволяет пользователям всесторонне управлять Knative из Headlamp. Он интегрирует ресурсы Knative в представление сопоставления ресурсов Headlamp, показывая взаимосвязи между KServices, Revisions и DomainMappings. Плагин предлагает подробное представление для KServices, позволяя вносить изменения в режиме реального времени в распределение трафика и конфигурации автомасштабирования. Пользователи также могут перезапускать поды и получать доступ к логам непосредственно из заголовка KService. Плагин облегчает детальное распределение трафика между ревизиями для поэтапных развертываний и A/B-тестирования. Он визуально отображает распределение трафика, статус готовности и теги для каждой ревизии. Конфигурации автомасштабирования четко представлены, указывая, являются ли настройки явными или унаследованными от кластерных значений по умолчанию. В сочетании с плагином Prometheus он предоставляет метрики, такие как частота запросов и задержка для KServices и Revisions. Плагин также предлагает представления списка и деталей для других CRD Knative, включая Revisions, DomainMappings и обзор сети. Установка включает поиск и установку плагина Knative из каталога плагинов Headlamp. Отзывы и сообщения об ошибках можно отправлять через проблемы GitHub или канал Kubernetes Slack.
CdXz5zHNQW_uA3Yt1MH58.png
Рабочая группа по управлению устройствами занимается растущей потребностью в специализированном управлении аппаратным обеспечением в Kubernetes. Традиционные методы распределения ресурсов недостаточны для рабочих нагрузок в области ИИ, периферийных вычислений и телекоммуникаций, требующих графических процессоров, тензорных процессоров и специфических сетевых интерфейсов. Основной проект группы, Динамическое распределение ресурсов (DRA), достиг общей доступности, что является значительным достижением. DRA предоставляет структурированную четырехэтапную основу для управления устройствами: моделирование, запрос, планирование и активация. Этот новый подход позволяет поставщикам рекламировать детальные аппаратные возможности, а пользователям — указывать точные аппаратные потребности. Затем планировщик Kubernetes интеллектуально сопоставляет эти требования с доступным аппаратным обеспечением. DRA заменяет устаревший API плагинов устройств, который рассматривал устройства как простые целые числа, гибким и декларативным API. Рабочая группа представляет собой меж-SIG усилия, в которых участвуют несколько SIG для обеспечения комплексной интеграции компонентов Kubernetes. Текущие инициативы сосредоточены на повышении выразительности DRA, поддержке операционной видимости и улучшении управления многоузловыми и сложными аппаратными топологиями. Будущая работа включает мониторинг состояния устройств и лучшую поддержку использования сгруппированных устройств. Рабочая группа стремится создать более программируемое и аппаратное-ориентированное будущее для Kubernetes.
Статья подчеркивает SIG Storage, группу специальных интересов Kubernetes, ответственного за постоянное хранение данных и управление томами. Син Ян, сопредседатель SIG Storage, обсуждает эволюцию группы от обработки основных постоянных томов до продвижения сложных функций хранения. Первоначально разработанный для безсостояний рабочих нагрузок, Kubernetes теперь поддерживает состоянийные приложения, требующие выделенных решений хранения. SIG Storage была сформирована для решения этих проблем, введя примитивы, такие как PersistentVolumes и PersistentVolumeClaims.Значительным достижением стало Container Storage Interface (CSI), которое позволяет сторонним поставщикам хранения интегрировать свои системы без изменений в ядре Kubernetes. Текущая работа включает Volume Group Snapshot для согласованных сбоем снимков нескольких томов и Changed Block Tracking для эффективных резервных копий, оба из которых недавно стали стабильными версиями. Container Object Storage Interface (COSI) также продвигается для стандартизации интеграции объектного хранения.Недавние успехи для пользователей включают выпуск VolumeAttributesClass в общедоступную версию, позволяющую динамически настраивать свойства хранения, такие как IOPS. Будущие планы развития включают Volume Health для улучшения операционной видимости и потенциального автоматического исправления. SIG Storage ищет помощь сообщества в исправлении ошибок, тестировании, проверке и предоставлении обратной связи о функциях, таких как Mutable PV Affinity и репликация томов.Проблемы для состоянийных рабочих нагрузок включают гравитацию данных, операционную сложность на второй день и подвижность данных. По мере роста рабочих нагрузок ИИ хранение в Kubernetes, как ожидается, станет более интеллектуальным, с растущей популярностью объектного хранения. Высокопроизводительное, низкозадержечное хранение и осведомленное о данных планирование также являются ожидаемыми тенденциями. SIG Storage приглашает сообщество участвовать в решении этих эволюционирующих требований к хранению.
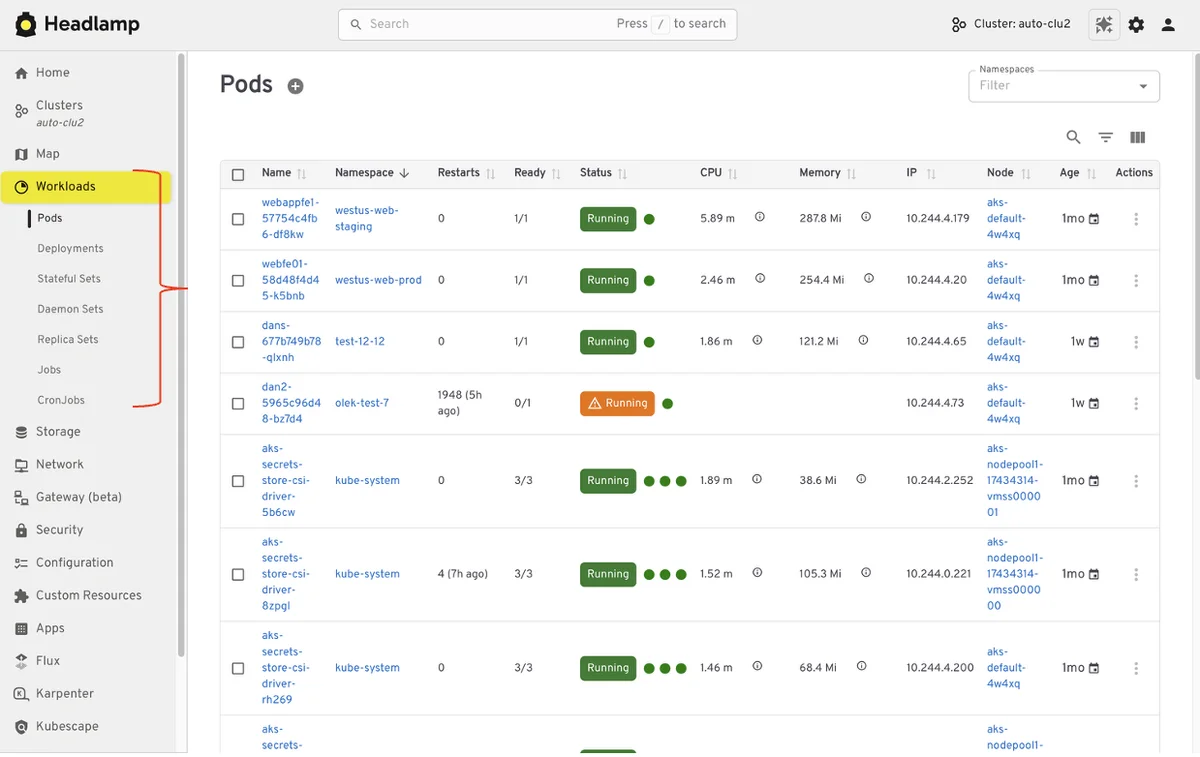
Kubernetes Dashboard, ранее являвшийся основным визуальным интерфейсом для Kubernetes, был архивирован. Он служил важным инструментом для многих пользователей, упрощая обзор кластера и проверку ресурсов. Headlamp теперь продолжает это наследие, опираясь на основу Dashboard. Он предлагает четкий визуальный интерфейс, учитывая современные шаблоны использования Kubernetes. Headlamp обеспечивает обзор нескольких кластеров, представление приложений через проекты и расширяемость с помощью плагинов. Переход призван сохранить ориентированное на пользователя наследие Dashboard и предложить развивающееся решение для пользовательского интерфейса. Многие привычные рабочие процессы из Kubernetes Dashboard сохранены в Headlamp, обеспечивая преемственность и простоту использования. Headlamp расширяет возможности, позволяя управлять несколькими кластерами из одного интерфейса, снижая сложность для распределенных сред. Проекты в Headlamp предлагают представление приложений, группируя связанные ресурсы для лучшего понимания и устранения неполадок. Платформа также расширяема с помощью плагинов, таких как плагин Flux для рабочих процессов GitOps или AI-ассистент для получения рекомендаций. Headlamp предлагает гибкие варианты развертывания, его можно использовать как инструмент внутри кластера или как настольное приложение. Понимание текущего использования Dashboard, включая кластеры, пространства имен и аутентификацию, способствует плавному переходу на Headlamp.
CdXz5zHNQW_NGyZ88sXD3.png
Kubernetes улучшает прозрачность, уточняя свои записи CVE для повышения точности. Они обнаружили несоответствия в старых записях CVE, в некоторых из которых некорректно указаны исправленные версии. Комитет по реагированию на угрозы безопасности Kubernetes исправит эти записи 1 июня 2026 года. Это может привести к тому, что сканеры уязвимостей выявят ранее необнаруженные проблемы. Этот пост предлагает технические подробности о трех неисправленных уязвимостях: CVE-2020-8561, CVE-2020-8562 и CVE-2021-25740. Обновления обеспечивают корректное сканирование уязвимостей и разъясняют постоянные потребности в административном смягчении последствий. CVE-2020-8554, также неисправленная, получит стандартизированный формат номера версии. Выявленные уязвимости остаются неисправленными, потому что их исправление нарушит основную функциональность Kubernetes. Каждая уязвимость имеет конкретные меры по смягчению последствий, которые администраторы должны реализовать для защиты своих кластеров. Эти действия имеют решающее значение, учитывая архитектурный характер уязвимостей. Проект подчеркивает подход "безопасность через конфигурацию" для управления этими рисками. Обновление этих записей демонстрирует развитие экосистемы безопасности, способствующей прозрачности и точной оценке рисков.
SIG-Etcd выпустил первую бета-версию etcd v3.7.0, значительное обновление для распределенной базы данных. Эта версия вводит RangeStream, функцию, предназначенную для улучшения обработки больших наборов результатов, повышения задержки и управления памятью. В выпуске также включены рефакторинг и очистка устаревших компонентов и интерфейсов, улучшающих общую производительность. Разработчики призывают пользователей протестировать бета-версию и сообщить о любых проблемах, найденных в репозитории etcd. Одним из ключевых моментов является удаление последних остатков etcd v2store, завершение перехода на v3store. Этот переход может ввести изменения, нарушающие совместимость, особенно для пользователей, не использующих v3.6.11, поэтому запрошена обратная связь о любых проблемах, с которыми они столкнулись. Этот выпуск бета-версии также включает обновления библиотек bbolt и raft. Кроме того, график выпуска связан с датой окончания поддержки (EOL) для etcd v3.4, который перестанет получать обновления после мая. Сообщество готово выпустить дополнительный патч безопасности для v3.4, если это необходимо, до его окончательного устаревания. Пользователям рекомендуется обновиться с v3.4. Планируются будущие бета-версии, потенциально с дальнейшим рефакторингом protobuf, что приведет к кандидатам на выпуск и окончательной версии в июне или начале июля. Обратная связь активно запрашивается через проблемы GitHub, канал Kubernetes Slack и список рассылки etcd-dev.
Эта статья, изначально датированная неверно, теперь отражает дату публикации 15 мая 2026 года. Kubernetes v1.36 представляет новую альфа-метрику, route_controller_route_sync_total, для контроллера маршрутов Cloud Controller Manager. Эта метрика отслеживает операции синхронизации маршрутов с облачным провайдером, помогая в мониторинге функционального переключателя CloudControllerManagerWatchBasedRoutesReconciliation. Эта функция, представленная в v1.35, переключает контроллер маршрутов на подход, основанный на наблюдении. Это изменение уменьшает количество вызовов API, выполняя согласование маршрутов только при изменении узлов. Чтобы протестировать новую функцию, сравните поведение метрики с отключенным и включенным функциональным переключателем. С отключенным функциональным переключателем счетчик увеличивается через фиксированный интервал. И наоборот, с включенной функцией счетчик увеличивается только при изменении узлов. Эта разница наиболее заметна в стабильных кластерах с нечастыми изменениями узлов. Обратную связь можно предоставить через Kubernetes Slack, проблему GitHub и страницу сообщества SIG Cloud Provider. Более подробная информация доступна в KEP-5237.
Прокси смешанных версий (MVP) улучшает обновление кластеров Kubernetes, безопасно направляя запросы для неизвестных ресурсов на более новые API-серверы, предотвращая ошибки 404. Первоначально представленный как Alpha-функция в Kubernetes 1.28, MVP теперь переходит в Beta в версии 1.36 и будет включен по умолчанию. MVP решает проблему API-серверов с разными версиями во время обновлений, когда запросы для новых ресурсов могут завершиться неудачей на старых серверах. Вместо некорректной ошибки 404 запрос проксируется на сервер, способный его обработать. Бета-версия MVP использует агрегированное обнаружение вместо API StorageVersion для определения возможностей одноранговых узлов, улучшая функциональность. Это обновление также включает агрегированное обнаружение одноранговых узлов, предоставляя клиентам унифицированное представление всех доступных API. Чтобы включить MVP, API-серверам требуется флаг --peer-ca-file, а также --peer-advertise-ip и --peer-advertise-port, если необходимо. С kubeadm вы можете включить эти флаги в файл ClusterConfiguration, чтобы упростить процесс. Пользователям рекомендуется протестировать MVP в промежуточных средах и предоставить обратную связь SIG API Machinery в рамках обновления 1.36.
Поле .spec.externalIPs в сервисах Kubernetes, первоначально предназначенное для функциональности, не связанной с облачными балансировщиками нагрузки, теперь устарело из-за уязвимостей безопасности, выявленных в CVE-2020-8554. Это поле позволяет указывать дополнительные IP-адреса, на которые отвечает сервис, но оно имеет присущие ему риски безопасности, поскольку предполагает доверие между всеми пользователями. Kubernetes 1.21 уже рекомендовал отключить .spec.externalIPs, и был представлен контроллер допуска для обеспечения этого. Альтернативы, такие как сервисы LoadBalancer, управляемые вручную, или контроллеры балансировки нагрузки, не связанные с облаком, такие как MetalLB, предлагают лучшую безопасность и контроль. MetalLB позволяет администраторам контролировать назначение IP-адресов, смягчая проблемы безопасности. Gateway API также предоставляет безопасное решение, предоставляя администраторам контроль над IP-адресом через ресурс Gateway. Kubernetes 1.36 официально объявил .spec.externalIPs устаревшим и начал выдавать предупреждения об его использовании. Поддержка этой функции в kube-proxy будет отключена в будущей версии, а полное удаление запланировано в последующих версиях. Пользователям рекомендуется перейти от этой небезопасной функции.
Kubernetes v1.35 представил улучшения планирования с учетом рабочих нагрузок, включая Workload API и базовое групповое планирование для идентичных Pod'ов. Kubernetes v1.36 уточняет эту архитектуру, отделяя Workload API (статический шаблон) от нового PodGroup API (состояние во время выполнения). Это разделение упрощает kube-scheduler, позволяя ему напрямую считывать информацию PodGroup для повышения производительности.Новый цикл планирования PodGroup позволяет атомарно обрабатывать рабочие нагрузки, оценивая целые группы как единую операцию для предотвращения взаимоблокировок. Если найдено допустимое размещение и соблюдены ограничения группы, Pod'ы связываются вместе; в противном случае вся группа считается непланируемой и повторяет попытку позже. Это формирует основу для группового планирования, обеспечивая размещение "все или ничего" для строгих требований к рабочей нагрузке.Топологически-ориентированное планирование в v1.36 позволяет определять топологические ограничения на PodGroup, размещая Pod'ы в определенных физических или логических доменах для уменьшения задержки сети. Это включает в себя генерацию, оценку и ранжирование кандидатов на размещение на основе ограничений планирования.Предварительное вытеснение с учетом рабочей нагрузки введено для поддержки цикла планирования PodGroup, вытесняя Pod'ы с нескольких узлов одновременно, чтобы освободить место для всей PodGroup. Оно рассматривает PodGroup как единую единицу вытеснения, с полями приоритета PodGroup и disruptionMode, управляющими поведением вытеснения.Наконец, v1.36 интегрирует Dynamic Resource Allocation (DRA) с Workload API, позволяя PodGroup запрашивать и совместно использовать специализированные аппаратные ресурсы через ResourceClaims. Эти улучшения закладывают прочную основу для создания расширенных возможностей планирования рабочих нагрузок в будущих выпусках Kubernetes.
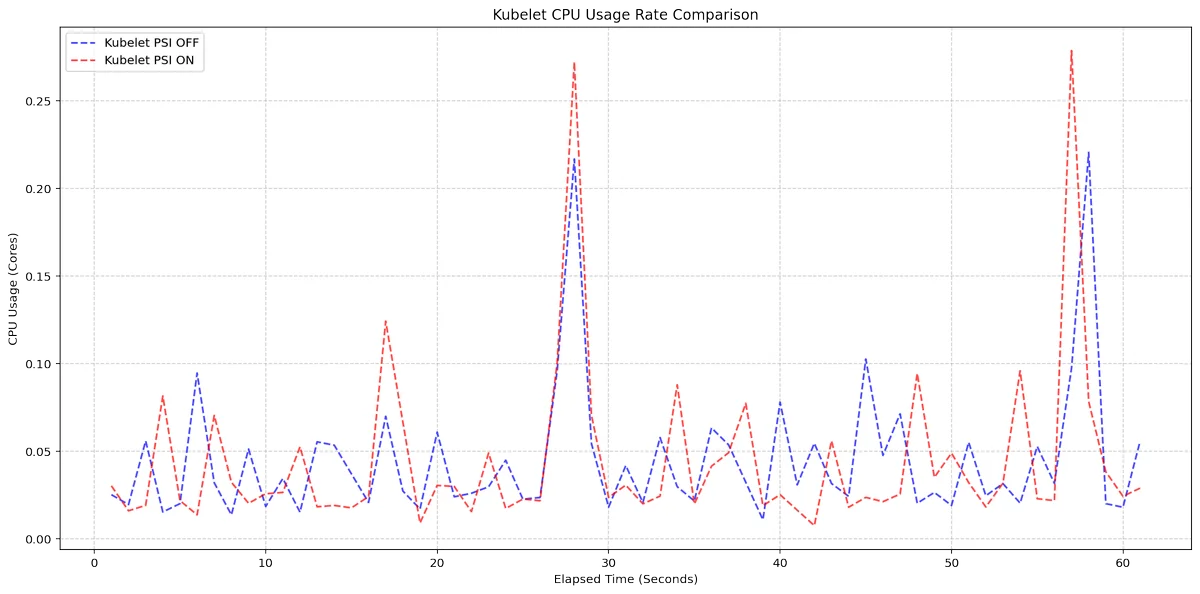
Информация о давлении (PSI) интегрирована в ядро Linux с 2018 года, предоставляя высокоточные сигналы для выявления насыщения ресурсов до того, как это приведет к сбоям. В отличие от традиционных метрик использования, PSI количественно оценивает зависшие задачи и потерянное время для CPU, памяти и ввода-вывода. С Kubernetes v1.36 теперь доступен стабильный интерфейс для наблюдения за борьбой за ресурсы на уровне узлов, подов и контейнеров. PSI предлагает совокупные итоги зависшего времени и скользящие средние (10 с, 60 с, 300 с), чтобы различать кратковременные всплески и устойчивое напряжение ресурсов.Обширное тестирование производительности, проведенное SIG Node на рабочих нагрузках высокой плотности (80+ подов), доказало готовность PSI к производству. Накладные расходы Kubelet, измеренные путем переключения флага функции KubeletPSI, показали незначительное влияние на использование ресурсов. Логика сбора данных Kubelet оказалась легкой, органично вписываясь в стандартные циклы обслуживания, потребляя менее 0,1 ядра или 2,5% от общей емкости узла.Что касается накладных расходов ядра, включение PSI в ядре Linux (psi=1 против psi=0) привело к стабильной дельте от 0,037 до 0,125 ядер (0,925% - 3,125% от емкости узла) при высокой нагрузке. Процесс kubelet, как основной сборщик, также поддерживал удивительно низкое использование CPU, при этом пики не превышали 0,25 ядер (6,25%) более чем на секунду.Улучшения в v1.36 включают более интеллектуальную выдачу метрик; Kubelet теперь обнаруживает поддержку PSI на уровне ОС через конфигурации cgroup перед отчетом, предотвращая вводящие в заблуждение метрики с нулевым значением. Чтобы использовать PSI, узлы должны работать под управлением ядра Linux 4.20+, использовать cgroup v2 и иметь включенную PSI на уровне ОС (CONFIG_PSI=y, без параметра загрузки psi=0).Метрики PSI обычно доступны в v1.36 и не требуют включения флага функции. Пользователи могут собирать данные с конечной точки /metrics/cadvisor или запрашивать Summary API. PSI является функцией ядра Linux и недоступна на узлах Windows. Проксирование к HTTP API Kubelet через API-сервер плоскости управления позволяет получать данные о давлении в реальном времени из Summary API, но является привилегированной операцией.
CdXz5zHNQW_xWB13lRlZh.png
Kubernetes v1.36 вводит общедоступность (GA) для снимков групп томов, функцию, которая ранее была Alpha, а затем Beta-улучшением. Эта функциональность использует расширения API для включения согласованных сбоев снимков нескольких томов одновременно. Система группирует объекты PersistentVolumeClaim с помощью селекторов меток, что позволяет восстановить рабочие нагрузки до согласованной точки восстановления. Эта функция поддерживается исключительно для драйверов томов CSI, что дает значительное преимущество для приложений, использующих несколько томов, требующих согласованности порядка записи.Ранее индивидуальные снимки томов могли привести к несоответствиям, если они были сделаны в разное время, особенно для приложений с несколькими томами. Групповые снимки устраняют необходимость ручного приостановления приложений, обеспечивая согласованность сбоев во всех томах группы без утомительных, последовательных индивидуальных снимков. Kubernetes управляет групповыми снимками через три пользовательских вида API: VolumeGroupSnapshot, VolumeGroupSnapshotContent и VolumeGroupSnapshotClass. Эти CRD, теперь продвигаемые до v1 в выпуске GA, позволяют пользователям запрашивать групповые снимки, отслеживать их выделенные ресурсы и определять их политику создания соответственно.Выпуск GA приносит улучшенную стабильность, исправления ошибок и улучшенное отчетность о размере восстановления на основе обратной связи от предыдущих бета-версий. Чтобы использовать эту функцию, пользователи должны пометить свои PersistentVolumeClaims, чтобы сгруппировать их, а затем определить объект VolumeGroupSnapshot с селектором, соответствующим этим меткам, вместе с VolumeGroupSnapshotClass. Для восстановления создаются новые PersistentVolumeClaims из отдельных объектов VolumeSnapshot, которые являются частью более крупного VolumeGroupSnapshot. Поставщики хранилищ могут добавить поддержку, реализовав новые службы контроллера групп и RPC в своих драйверах CSI.
Динамическое распределение ресурсов (DRA) в Kubernetes v1.36 вводит значительные улучшения, расширяя свои возможности за пределы специализированного оборудования до родных ресурсов, таких как CPU и память. Поддержка драйверов для различных типов оборудования, включая сетевое оборудование, расширяется, что делает DRA более независимым от оборудования решением. Несколько ключевых функций стали доступны, повышая гибкость планирования и использование кластера. Функция списка с приоритетом позволяет задавать предпочтения для запросов устройств, улучшая эффективность распределения ресурсов. Расширенная поддержка ресурсов позволяет постепенно перейти на DRA, разрешая запросы ресурсов через традиционные расширенные ресурсы. Разделяемые устройства обеспечивают родную поддержку DRA для динамического разделения физического оборудования на более мелкие логические экземпляры. Метки устройств позволяют администраторам более эффективно управлять оборудованием, предотвращая выделение неисправных устройств или резервирование конкретного оборудования. Условия привязки устройств улучшают надежность планирования, задерживая привязку Pod до тех пор, пока внешние ресурсы не будут полностью подготовлены. Состояние здоровья ресурсов раскрывает информацию о здоровье устройства напрямую в статусе Pod, помогая быстро выявлять и реагировать на отказы оборудования. Новые функции альфа-версии включают поддержку ResourceClaim для рабочих нагрузок, оптимизирующую крупномасштабные задачи ИИ/МЛ путем управления общими ресурсами в группах Pod. Распределение ресурсов узла объединяет распределение CPU и памяти под зонтиком DRA, позволяя выполнять тонкую настройку производительности. Видимость доступности ресурсов DRA обеспечивает администраторам информацию о емкости устройств в режиме реального времени для лучшего планирования. Определенный выбор устройства позволяет драйверам влиять на планирование через лексикографический порядок. Метаданные устройств, обнаруживаемые в контейнерах, обеспечивают стандартный протокол для драйверов, чтобы раскрывать атрибуты устройств контейнерам. Будущая дорожная карта фокусируется на совершенствовании существующих функций, повышении производительности, масштабируемости и интеграции с планированием, осведомленным о рабочих нагрузках и топологии, с сильным акцентом на миграции пользователей с Device Plugin на DRA.
Контроллеры Kubernetes сталкиваются с проблемами масштабирования по мере увеличения размеров кластеров, особенно при наблюдении за ресурсами с высокой кардинальностью. Шардинг на стороне клиента, хотя и функционален, не уменьшает объем данных от сервера API, что приводит к неэффективности. Шардинг списка и наблюдения на стороне сервера, представленный в Kubernetes v1.36 в качестве альфа-функции (KEP-5866), решает эту неэффективность. Сервер API фильтрует события на основе указанного контроллером диапазона хэша, отправляя только релевантные данные каждой реплике. Контроллеры используют информеры для перечисления и наблюдения за ресурсами, включая селектор шардинга через WithTweakListOptions. Селектор шардинга используется для фильтрации ресурсов на основе metadata.uid или metadata.namespace объекта. Сервер API возвращает поле shardInfo в метаданных ответа списка для подтверждения правильного применения селектора шардинга. Если оно отсутствует, клиент должен обрабатывать полную, нефильтрованную коллекцию, потенциально прибегая к фильтрации на стороне клиента. Эта функция требует включения функционального переключателя ShardedListAndWatch. Сообщество Kubernetes ищет обратную связь от авторов контроллеров и операторов, особенно тех, кто управляет большими кластерами. Этот подход предназначен для улучшения производительности и масштабируемости контроллера в требовательных средах Kubernetes.
Kubernetes v1.36 представляет декларативную валидацию для нативных типов, теперь общедоступную. Это переходит от написанного вручную кода Go к тегам IDL для определения правил валидации, повышая надежность и предсказуемость API. Предыдущая зависимость от написанного вручную кода приводила к техническому долгу, несоответствиям и непрозрачным API. Решение использует validation-gen, генератор кода, который анализирует теги для автоматической генерации функций валидации Go. Эта структура включает различные маркерные теги для присутствия, ограничений, коллекций, объединений и неизменяемости. Ключевым преимуществом является "фоновое затягивание", позволяющее немедленно ужесточать или ослаблять валидацию, не нарушая существующие объекты. Декларативная валидация делает обзоры API проще и более согласованными с такими инструментами, как kube-api-linter. Проект планирует перенести оставшийся устаревший код и ввести обязательную декларативную валидацию для новых API. Это также открывает будущие преимущества экосистемы, такие как валидация на стороне клиента с помощью таких инструментов, как kubectl, и интеграция с такими инструментами, как Kubebuilder. Миграция продолжается, с возможностями внести вклад в кодовую базу Kubernetes. Документ завершается благодарностью участникам, приветствуя декларативное будущее валидации Kubernetes.
Механизм контроля доступа на основе манифестов Kubernetes, представленный в версии v1.36, устраняет пробелы в обеспечении безопасности политики во время инициализации кластера. Существующий контроль доступа на основе API имеет уязвимости: политики являются объектами API и могут быть удалены, создавая окно безопасности. Эта новая функция позволяет определять веб-хуки и политики на основе CEL как файлы, загружаемые сервером API при запуске. Это гарантирует, что политики активны до того, как будут обработаны какие-либо запросы, защищая от несанкционированных изменений. Она использует поле staticManifestsDir в файле AdmissionConfiguration для указания каталога, содержащего файлы YAML-политик. Эти файлы должны иметь имена, оканчивающиеся на .static.k8s.io, чтобы отличать их от конфигураций на основе API. Эта функция может защитить сами конфигурации доступа от удаления или изменения. Изменения в файлах манифеста автоматически обновляются во время выполнения. Сервер API обеспечивает строгую проверку при запуске и обрабатывает обновления во время выполнения атомарно. Чтобы реализовать эту функцию, необходимо включить функциональный переключатель ManifestBasedAdmissionControlConfig.
Kubernetes v1.36 вводит менеджеры ресурсов на уровне подов в качестве функции альфа-тестирования, улучшая управление ресурсами для задач, чувствительных к производительности. Он расширяет возможности менеджеров топологии, CPU и памяти kubelet до модели распределения ресурсов, ориентированной на под, выходя за рамки спецификаций на уровне контейнеров. Это решает проблему обеспечения эксклюзивных, выровненных по NUMA ресурсов для основных контейнеров приложений, а также поддержки легковесных sidecar-компонентов эффективно. Ранее достижение предсказуемой производительности часто означало выделение эксклюзивных ресурсов всем контейнерам, что было расточительным для sidecar-компонентов. Альтернативно, не делая этого, жертвовала гарантированным качеством обслуживания (QoS) пода. Менеджеры ресурсов на уровне подов позволяют использовать гибридное распределение, позволяя задачам с высокой производительностью достигать выравнивания по NUMA без расточительства ресурсов. Например, под базы данных, чувствительный к задержке, может иметь основной контейнер, получающий эксклюзивный CPU и память, в то время как sidecar-компоненты делят отдельный общий пул пода, изолированный от других ресурсов узла. Другой случай использования включает задачи машинного обучения, где контейнер обучения получает эксклюзивные ресурсы, выровненные по NUMA, а sidecar-компонент сервисной сетки запускается в общем пуле узла. Изоляция CPU управляется путем отключения принудительного выполнения квоты CFS для эксклюзивных контейнеров и принудительного выполнения на уровне пода для контейнеров общего пула. Включение требует конкретных функциональных возможностей kubelet, политик менеджера топологии и статических конфигураций менеджеров CPU и памяти. Новые метрики kubelet обеспечивают наблюдаемость распределения ресурсов и назначения контейнеров. В настоящее время эта функция находится в стадии альфа-тестирования, имеет известные ограничения и оговорки, и пользовательская обратная связь приветствуется через каналы сообщества Kubernetes.
Kubernetes v1.36 вводит масштабирование ресурсов на уровне подов в месте, теперь в бета-версии и включено по умолчанию. Эта функция позволяет пользователям динамически регулировать агрегированные ограничения ресурсов работающего пода. Это особенно полезно для подов с общими ресурсами и без ограничений, специфичных для контейнеров. Kubelet определяет метод обновления на основе политики изменения размера (resizePolicy) каждого контейнера, выбирая между обновлениями в месте или перезапусками. Когда происходит изменение размера, Kubelet сначала проверяет, достаточно ли ресурсов на узле. Затем он последовательно обновляет cgroup, чтобы предотвратить превышение ресурсов, расширяя cgroup на уровне пода до того, как будут увеличены cgroup отдельных контейнеров. Состояния подов, такие как PodResizeInProgress, отслеживают прогресс и статус изменения размера. Эта функция требует cgroup v2, поддержки CRI, определенных флагов функций и узлов на основе Linux. Следующий шаг - интеграция этой функции с вертикальным автомасштабированием подов (VPA). Пользователям рекомендуется протестировать эту функцию и предоставить обратную связь через каналы сообщества.