Google Cloud Blog на русском
Подписаться
Управление Apache Iceberg в масштабе: как Spanner обеспечивает работу каталога среды выполнения Lakehouse
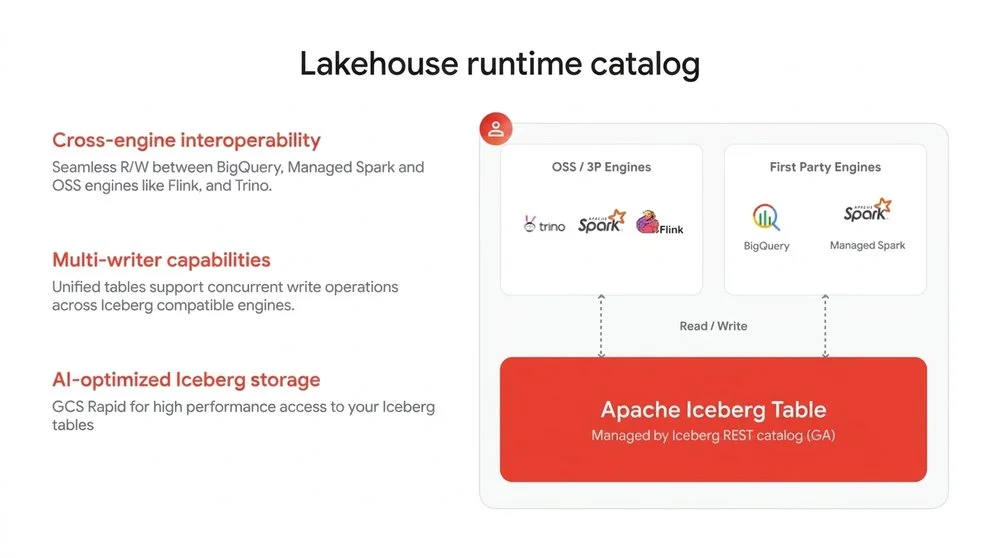
Клиенты внедряют архитектуры lakehouse, стандартизируя открытые форматы, такие как Apache Iceberg, для создания общих сред данных для нативных ИИ-решений. Важным компонентом является Apache Iceberg REST Catalog, отвечающий за управление указателями таблиц, атомарными коммитами и служащий единым источником истины. Предприятиям нужен высокомасштабируемый, доступный и управляемый каталог для поддержки огромного количества мелких, повторяющихся запросов от ИИ-агентов. Такой каталог должен решать такие задачи, как атомарные коммиты, высокая доступность, масштабирование базы данных, обслуживание таблиц и надежное управление. Бессерверный каталог среды выполнения lakehouse в Google Cloud, основанный на Spanner, предлагает решение этих проблем.Этот каталог полностью бессерверный, высокодоступный и унифицирует метаданные, нативно реализуя спецификацию Apache Iceberg REST Catalog. Ключевые преимущества включают открытые API, интероперабельность между различными движками (BigQuery, Managed Spark) и возможности чтения/записи для таблиц Iceberg. Он обеспечивает полностью управляемое хранилище Iceberg с функциями корпоративного уровня и нулевым копированием данных, указывая напрямую на существующие данные в объектном хранилище. Каталог также поддерживает двустороннюю федерацию между облаками (Databricks Unity, Snowflake Horizon, AWS Glue) и безопасный доступ с использованием выдачи учетных данных. Он интегрируется с Knowledge Catalog и Cloud IAM для контекста и управления на основе ИИ, предлагая безопасность на уровне таблиц, поиск и отслеживание происхождения данных.Критически важно, что он обеспечивает атомарные коммиты, контроль параллелизма, высокую доступность и масштабируемость, опираясь на глобальную инфраструктуру Google и Spanner. Spanner предоставляет полные семантические возможности реляционного SQL с горизонтальным масштабированием для чтения и записи, достигая высокой доступности за счет региональных конфигураций. Он автоматически масштабирует вычислительные ресурсы и хранилище, динамически отслеживая объем данных и нагрузку на запросы. Эта основа обеспечивает сериализуемые транзакции, предоставляя ведущие в отрасли гарантии согласованности для операций масштаба агентов. Каталог среды выполнения Lakehouse интегрируется с Knowledge Catalog для эффективного обнаружения таблиц Iceberg, используя полнотекстовый и нативный векторный поиск Spanner для лучшего извлечения информации. Этот интегрированный подход устраняет операционные накладные расходы и ускоряет вывод на рынок для сценариев использования ИИ-агентов. Безграничный lakehouse Google Cloud унифицирует данные, управление и контекст ИИ, одновременно снижая общую стоимость владения.