Google Cloud Blog на русском
Подписаться
ZenteiQ увеличивает пакетное инференс в 4 раза с помощью GKE Inference Gateway на базе llm-d
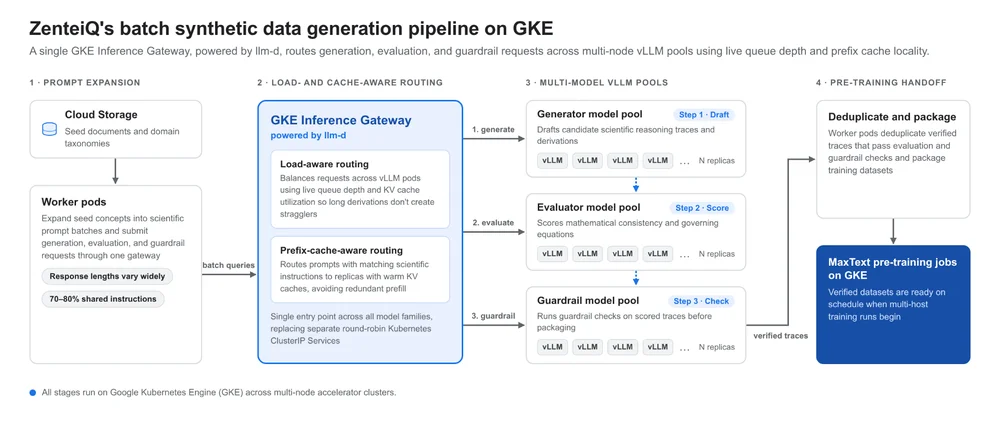
ZenteiQ, стартап в области искусственного интеллекта из Индийского института науки, разрабатывает суверенные научные фундаментальные модели. Эти модели требуют понимания физики, уравнений и численных решателей, что отличает их от общих языковых моделей. ZenteiQ использует масштабный конвейер генерации синтетических данных для предварительного обучения этих моделей. Конвейер генерирует миллиарды токенов рассуждений, включающих сложные научные выводы и проверку решателей.Ранее ZenteiQ сталкивался с узкими местами маршрутизации в Kubernetes, что приводило к неравномерным очередям движков и избыточным вычислениям. Это значительно замедляло генерацию данных и задерживало предварительное обучение. Для решения этих проблем ZenteiQ внедрил GKE Inference Gateway от Google, работающий на базе llm-d. Это решение обеспечивает интеллектуальную маршрутизацию запросов на вывод, учитывающую нагрузку и кэш.GKE Inference Gateway отслеживает глубину очередей в реальном времени и использование KV-кэша на своих серверах. Он эффективно маршрутизирует запросы, предотвращая узкие места и повторно используя кэшированные префиксы запросов. Такая интеллектуальная маршрутизация значительно увеличила пропускную способность: ежедневный объем сгенерированных токенов вырос с 1,47 миллиарда до почти 6 миллиардов. Это также обеспечило предсказуемость их предварительного обучения. ZenteiQ планирует использовать эту конфигурацию для будущих этапов продвинутого обучения ИИ.