AI 模型评估:测试与验证的最佳实践
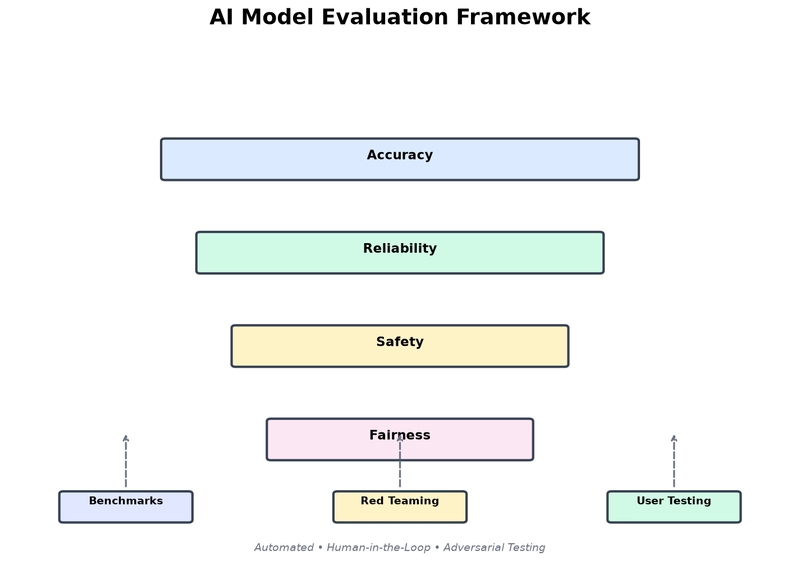
评估 AI 模型对于确保其质量、安全性和可靠性至关重要。它有助于识别错误、偏见及意外行为。主要益处包括验证质量、检测偏见、确保安全以及衡量现实世界中的表现。一个稳健的评估框架包含标准化的基准测试,例如用于知识评估的 MMLU 和用于代码生成的 HumanEval。红队测试(Red teaming)涉及对抗性测试,以揭示安全漏洞、潜在的越狱攻击以及鲁棒性问题。用户测试通过 A/B 测试和调查等方法收集关键的现实世界反馈。重要的评估指标包括准确率、延迟、公平性、鲁棒性和安全性。最佳实践强调多维度测试、持续评估以及纳入人工审查。记录并共享评估结果对于改进和集体学习至关重要。各种工具和框架支持这一过程,例如用于实验追踪的 MLflow 和用于评估的 DeepEval。AI 评估的未来将指向更先进的方法,如自动化红队测试和实时监测。最终,模型评估是一个持续且多面的过程,而非单一事件。