理解 Prism:用于联合视频 - 音频生成的动态稀疏注意力
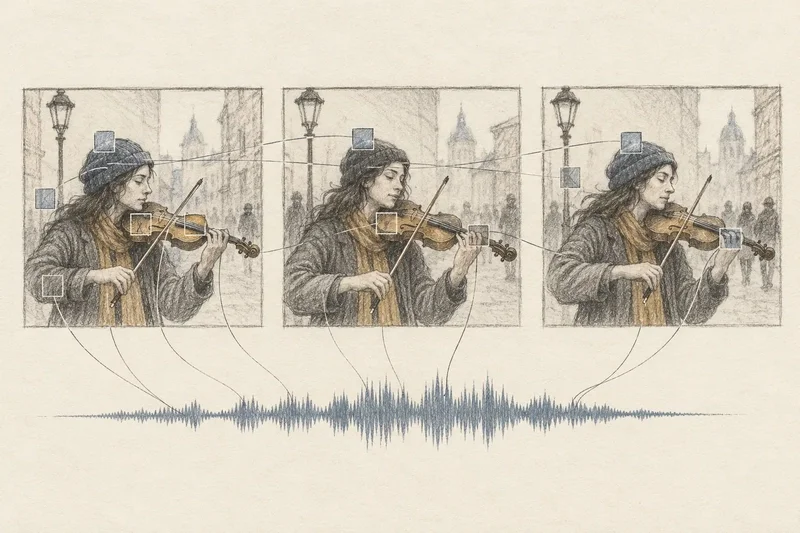
Prism 是一种新颖的稀疏注意力框架,旨在提高高分辨率视频与音频生成模型的训练效率。高分辨率视频包含海量的视觉 token,使得传统稠密注意力因二次方复杂度而计算成本高昂;音频则进一步增加了复杂性,要求模型将声音与其视觉源头建立关联。Prism 通过根据视频局部内容智能调整注意力模式来解决这一问题。该框架将视频片段划分为时空宏观区域(spatiotemporal macro-zones),分析各区域内的视觉变化及音画交叉注意力信号。基于这些信号,Prism 动态构建其注意力块,将计算资源集中于视觉变化显著或音画相关性强的区域。这种稀疏注意力方法避免了在视频信息量较低的部分进行不必要的计算。Prism 的预览版已在 Hugging Face 上线,提供图像到视频、文本到视频与音频生成的推理脚本,并支持原生的联合视频 - 音频训练。当前仓库需要大量 GPU 资源:720p 推理需占用 80GB GPU,更高分辨率则需多个此类 GPU;1080p 和 2K 分辨率的原生训练分别至少需要 32 或 64 个 80GB GPU。作者报告称,Prism 相比全注意力机制训练速度最高提升 2.5 倍,同时生成质量也有所改善,但这些结果仅针对其实验设置。此研究预览面向熟悉下载检查点并配置 GPU 环境的用户。Prism 的核心创新在于其内容感知的动态稀疏注意力机制,这对训练高分辨率联合视频 - 音频模型尤为有益。