LLM 推理优化:更快更廉价的 AI 技术
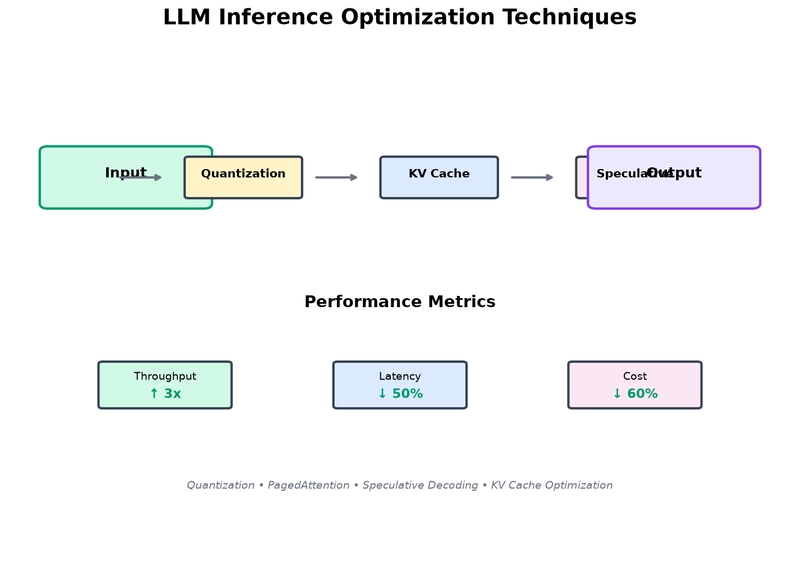
大语言模型(LLMs)在 AI 应用扩展时面临推理速度慢和成本高的挑战。优化 LLM 推理对于降低响应时间、减少计算支出并实现更广泛的部署至关重要。量化是一种关键技术,通过降低模型权重的精度(例如使用 INT8 或 INT4),在仅产生微小精度损失的情况下实现显著加速。KV 缓存优化采用如 PagedAttention 等方法,提升了内存效率,从而加快生成速度,尤其在处理长上下文时效果显著。推测性解码利用一个小模型生成候选 token,再由大模型进行验证,可在不降低质量的前提下实现 2-3 倍的加速。提示词优化侧重于构建更简洁、结构化的提示,以最小化 token 用量及相关成本。批处理通过将多个请求分组,进一步提升了效率。量化能带来显著的加速和成本优势,而 KV 缓存优化和推测性解码则能在不损失质量的前提下实现加速。提示词优化可在不影响质量的情况下提供中等程度的加速和成本改善。实施 KV 缓存优化通常是最佳的起点,随后针对边缘设备采用量化,针对吞吐量采用推测性解码。未来将涌现更多先进的优化方法,包括针对特定硬件的解决方案和动态路由。最终,最优的优化策略取决于具体优先级:速度、成本还是保持模型质量。