AWS Big Data Blog 中文 关注 这个网站来自 AWS,是 Amazon 的云计算平台。它在“博客”中收录了文章和见解,这些基本上是当前计算、人工智能、机器学习、数据分析等领域趋势的文章集合。该特定博客还包含了 AWS 上的大数据信息。访问者可以从 AWS 客户、初创企业、科学研究人员、教育机构和其他专家的社区中找到见解。 AWS Big Data Blog aws.amazon.com RSS aws.amazon.com AWS Big Data Blog 中文 RSS thenote.app
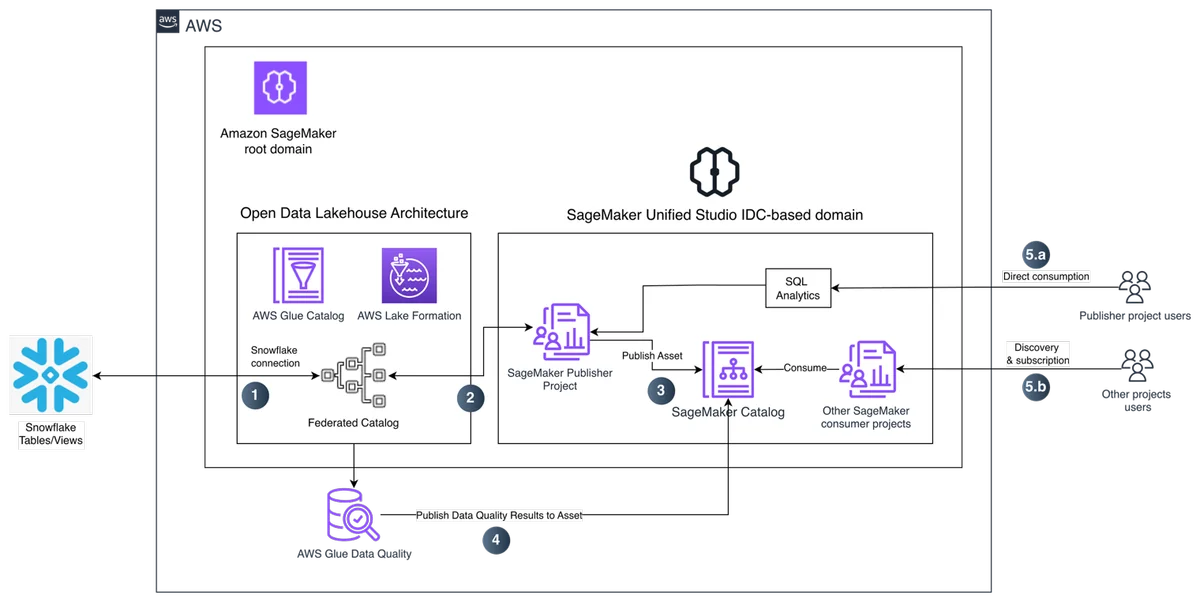
使用 SageMaker Unified Studio 发现并治理 Snowflake 数据 将 Snowflake 连接到 Amazon SageMaker Unified Studio 以构建统一数据目录。在不移动数据的情况下查询联邦 Snowflake 表,将增强型资产发布到 SageMaker Catalog,并利用 AWS Glue Data Quality 验证数据质量,同时保持数据保留在 Snowflake 中。 Discover and govern Snowflake data using SageMaker Unified Studio aws.amazon.com +1
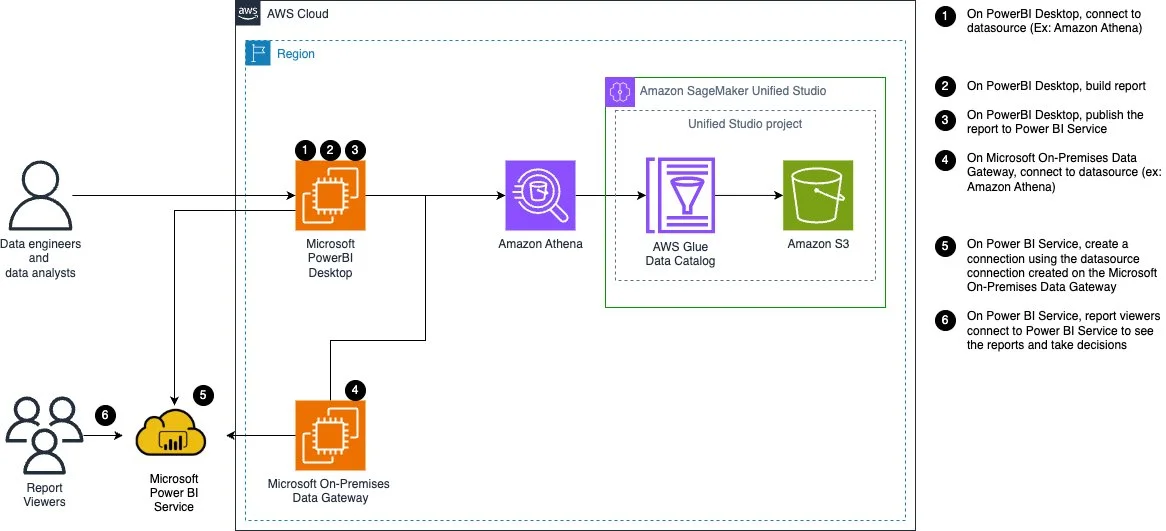
将 Amazon SageMaker Unified Studio 连接到 Microsoft Power BI – 第一部分:基于 IAM Identity Center (IDC) 的域 使用 Amazon Athena ODBC 驱动中的新认证模式,可直接将 Microsoft Power BI 连接到 Amazon SageMaker Unified Studio 中的受管数据,无需第三方 ODBC-JDBC 桥接。第一部分涵盖基于 IAM Identity Center(IDC)的域,并支持基于 DSN 和无 DSN 的连接方式。 Connect Amazon SageMaker Unified Studio to Microsoft Power BI – Part 1: IAM Identity Center (IDC)-based domains aws.amazon.com +1
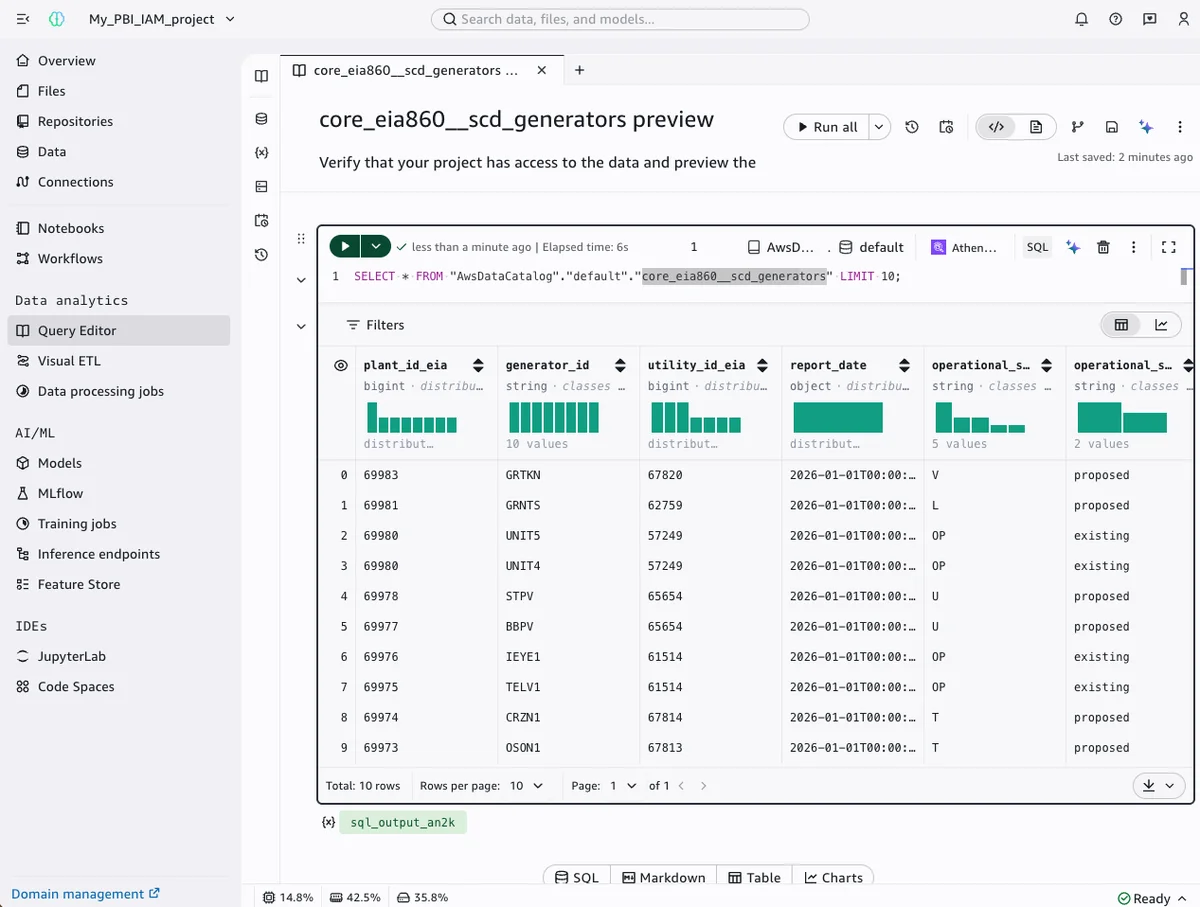
将 Amazon SageMaker Unified Studio 连接到 Microsoft Power BI – 第 2 部分:基于 IAM 的域 使用 Amazon Athena ODBC 驱动程序将 Microsoft Power BI 直接连接到 Amazon SageMaker Unified Studio 中的受管数据。第二部分涵盖基于 IAM 的域及 SageMakerIam 身份验证,包括 AWS IAM Identity Center 管理员设置,适用于基于 DSN 和非 DSN 的连接方式。 Connect Amazon SageMaker Unified Studio to Microsoft Power BI – Part 2: IAM-based domains aws.amazon.com +1
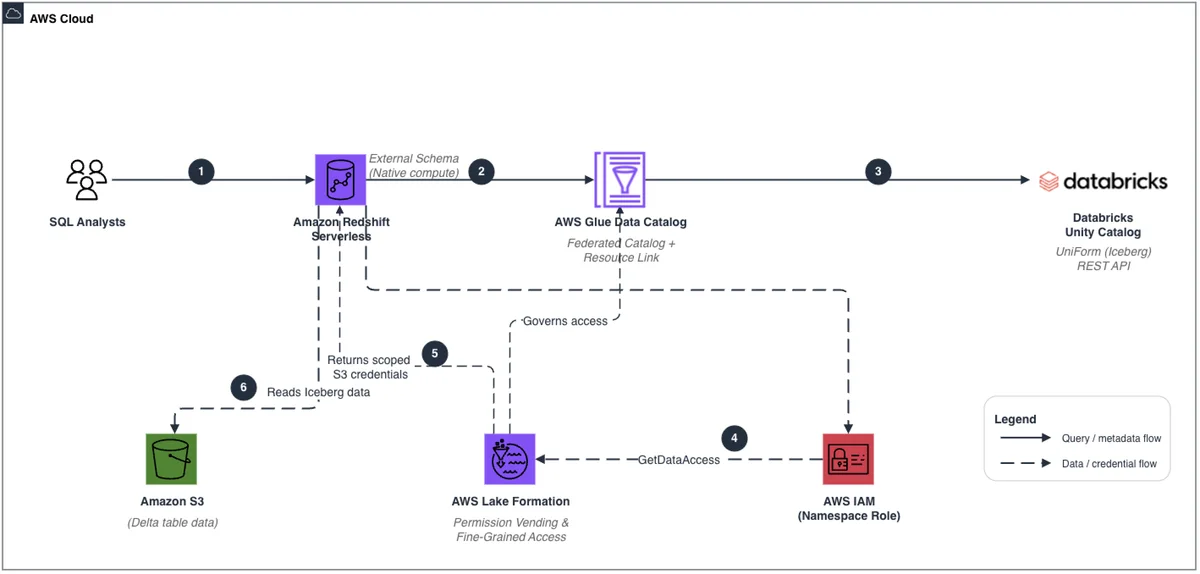
联合航空如何利用 Amazon Redshift 与 AWS Glue 数据目录联合查询由 Databricks 管理的数据 了解联合航空如何利用 AWS Glue 数据目录联邦功能,通过资源链接和 AWS Lake Formation 进行治理,直接从 Amazon Redshift Serverless 查询 Databricks Unity Catalog 数据,而无需重复存储数据。 How United Airlines uses Amazon Redshift and AWS Glue Data Catalog federation to query Databricks-managed data aws.amazon.com +1
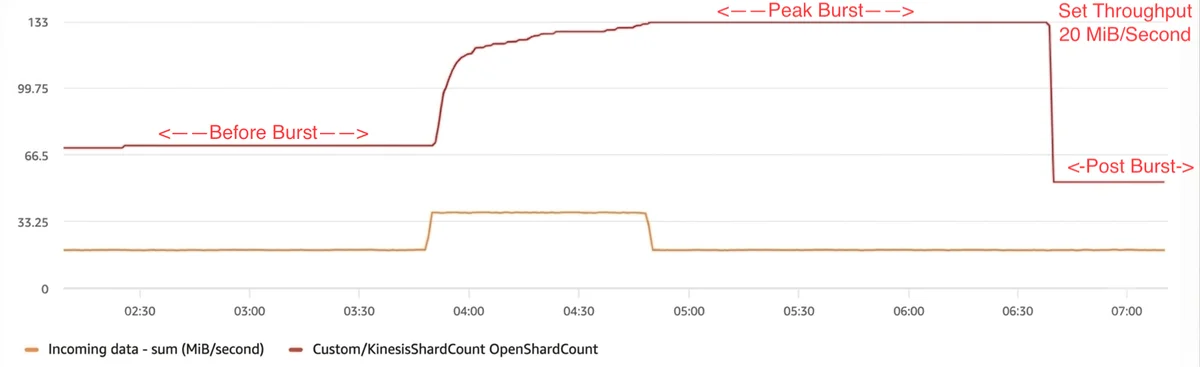
使用 ODA 预热吞吐量按需缩减 Kinesis Data Streams 的按需容量 Amazon Kinesis Data Streams 现已支持为具有预热吞吐量的按需 Advantage 流缩减摄入容量。了解缩减容量的工作原理、如何使用 Amazon CloudWatch 监控流行为,以及在短暂流量突发后释放多余容量的最佳实践。 Scale down Kinesis Data Streams on-demand capacity with ODA warm throughput aws.amazon.com +1
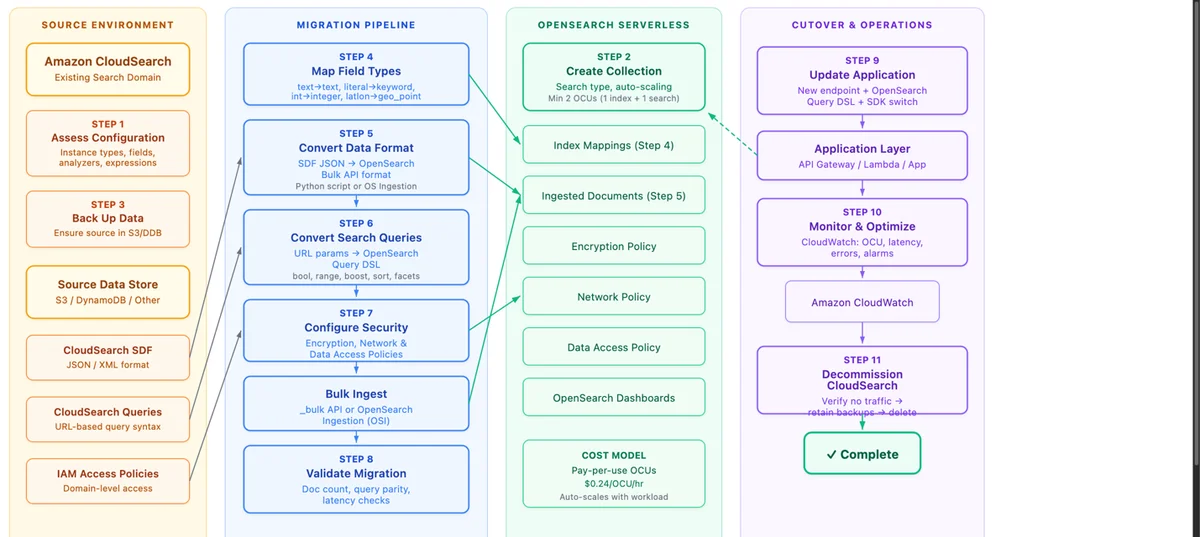
如何将 Amazon CloudSearch 迁移到 Amazon OpenSearch Serverless 学习如何将 Amazon CloudSearch 域迁移到 Amazon OpenSearch Serverless:评估您的配置,创建具有显式索引映射的集合,将文档和查询转换为 OpenSearch 查询 DSL,配置安全性,使用 Amazon OpenSearch Ingestion 加载数据,并在切换前进行验证。 How to migrate from Amazon CloudSearch to Amazon OpenSearch Serverless aws.amazon.com +1
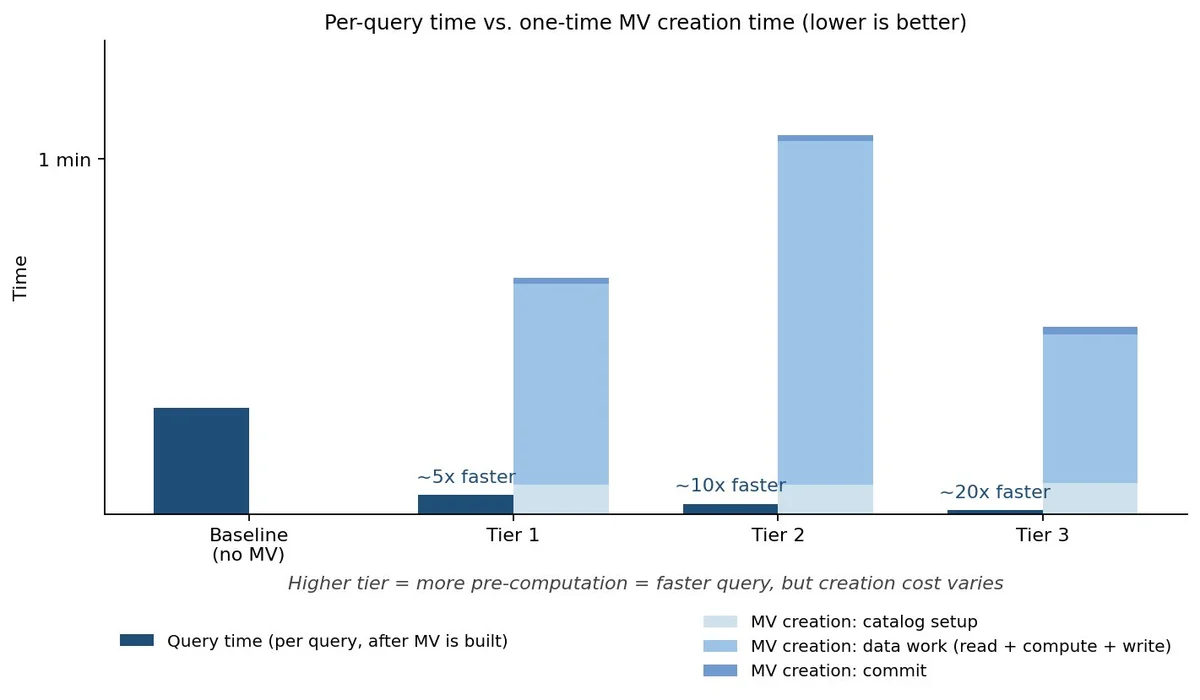
使用 Iceberg 物化视图加速 Spark 查询 无需重写任何 SQL,即可加速在 Apache Iceberg 表上运行的缓慢、重复的 Apache Spark 分析查询。本文介绍如何在 Amazon EMR 和 AWS Glue 中利用自动查询重写功能,通过 AWS Glue 数据目录中的 Iceberg 物化视图透明地替换匹配的查询计划,以及如何设计物化视图以实现最佳加速效果。 Accelerating Spark queries with Iceberg materialized views aws.amazon.com +1
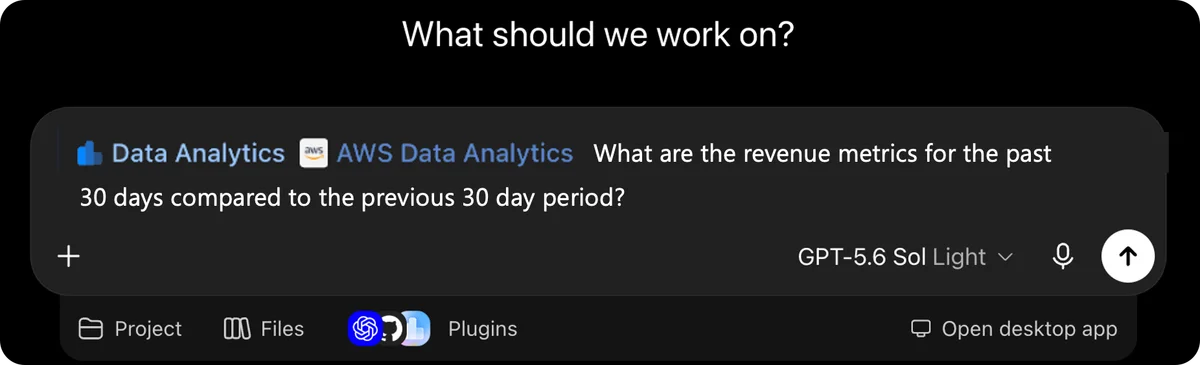
每个团队都是数据团队——将 Amazon Redshift 分析能力引入 ChatGPT 工作流 AWS 宣布推出 AWS 数据分析插件,集成于 ChatGPT Work 中的新数据代理。团队可通过自然语言提问,分析其 Amazon Redshift 数据仓库和数据湖中的受管数据,并构建可共享的仪表板,所有操作均通过 ChatGPT Work 中的对话完成。 Every team is a data team — bring Amazon Redshift analytics to ChatGPT Work aws.amazon.com +1
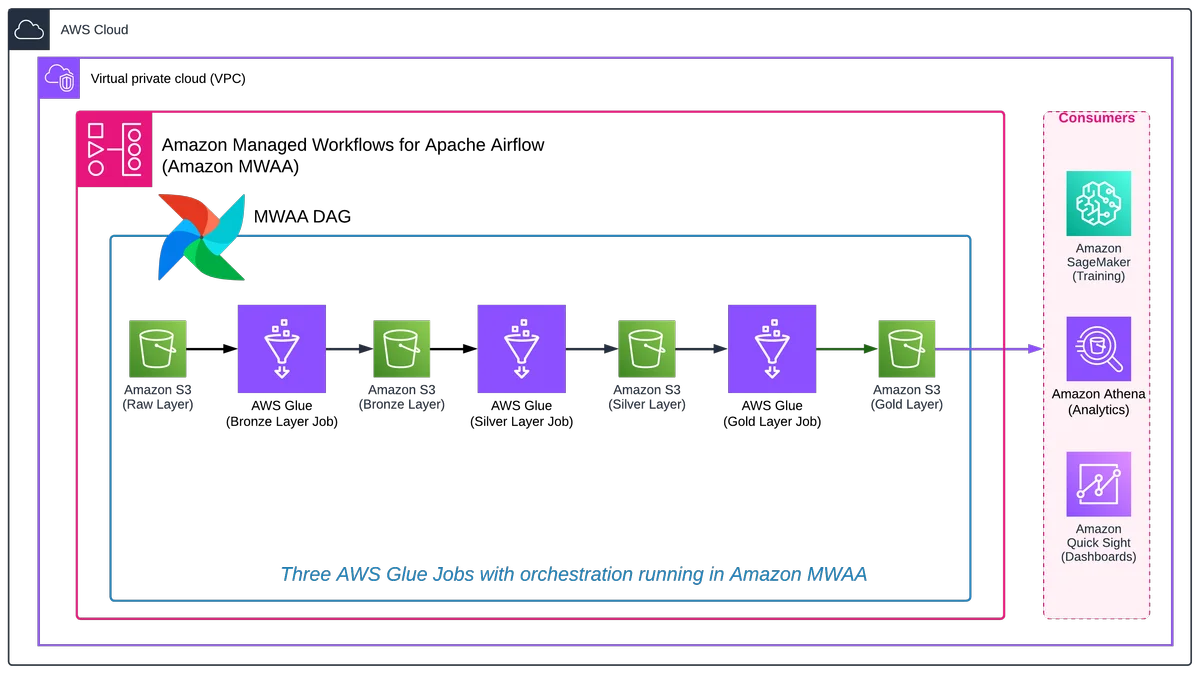
用AWS Glue 6.0构建声明式ETL管道 AWS Glue 6.0 引入了 Spark 声明式管道。在本篇博客中,您将构建一个单一的声明式 AWS Glue 6.0 作业,通过 bronze、silver 和 gold 序列将原始订单记录转换为经过验证和聚合的表,而无需编写任何编排逻辑。 Build declarative ETL pipelines with AWS Glue 6.0 aws.amazon.com +1
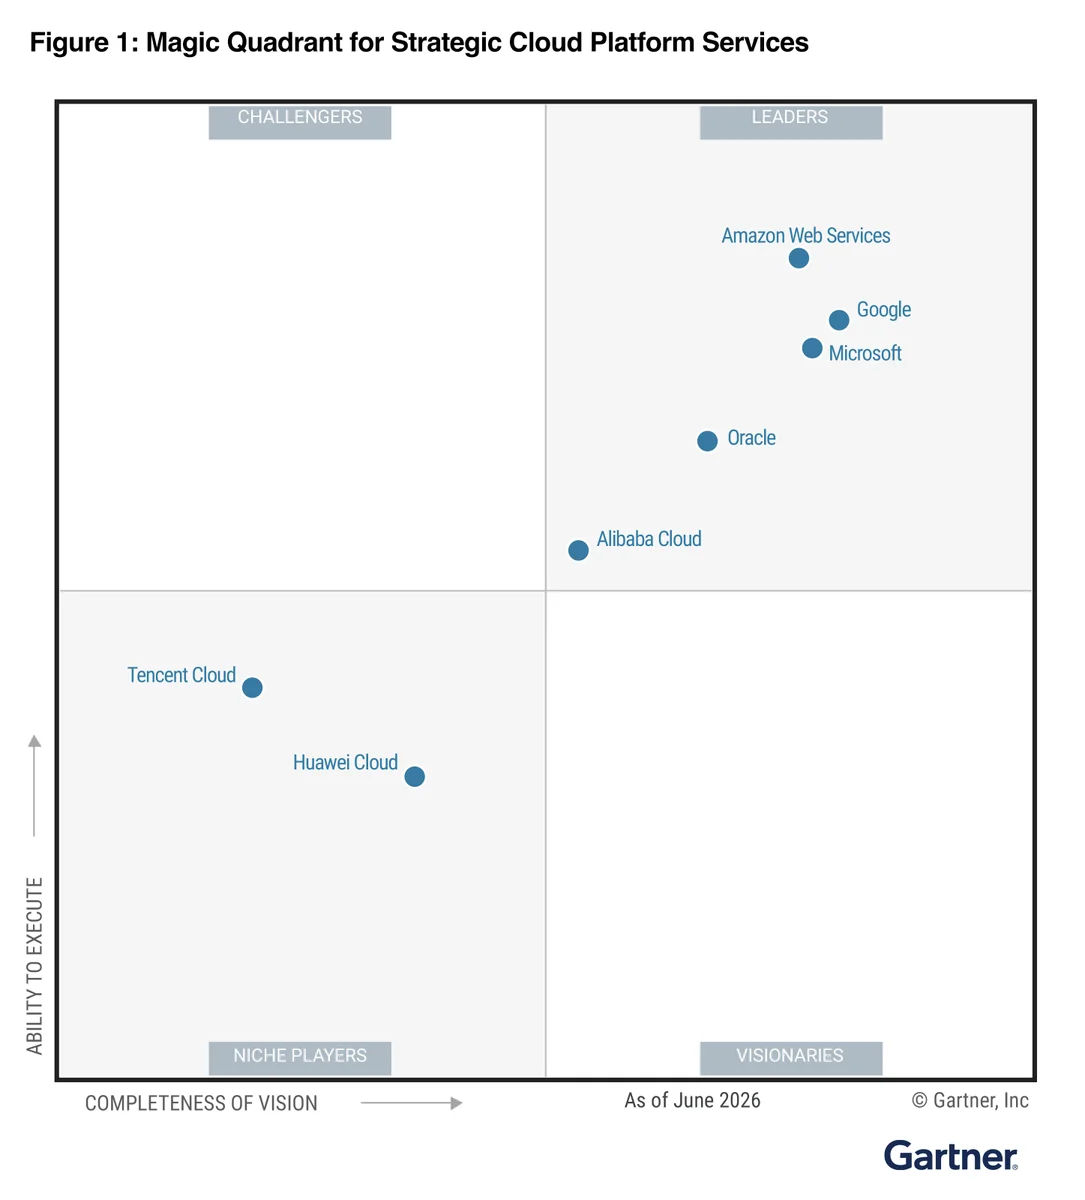
AWS 连续第 16 年被评为 2026 年 Gartner 战略云平台服务魔力象限中的领导者。 9 月 1 日,Gartner 发布了战略云服务平台(SCPS)魔力象限报告。亚马逊网络服务(AWS)是该魔力象限中连续 16 年被评为“领导者”的厂商,Gartner 在报告中再次将 AWS 置于“执行能力”轴的最高位置。我们认为,这体现了我们致力于帮助客户更快创新、更安全地运营,并在任何规模下构建的能力,尤其是在代理型人工智能推动对生产就绪型数据基础架构需求日益增长的背景下。 AWS recognized as a Leader in the 2026 Gartner Magic Quadrant for Strategic Cloud Platform Services for the 16th consecutive year aws.amazon.com +1
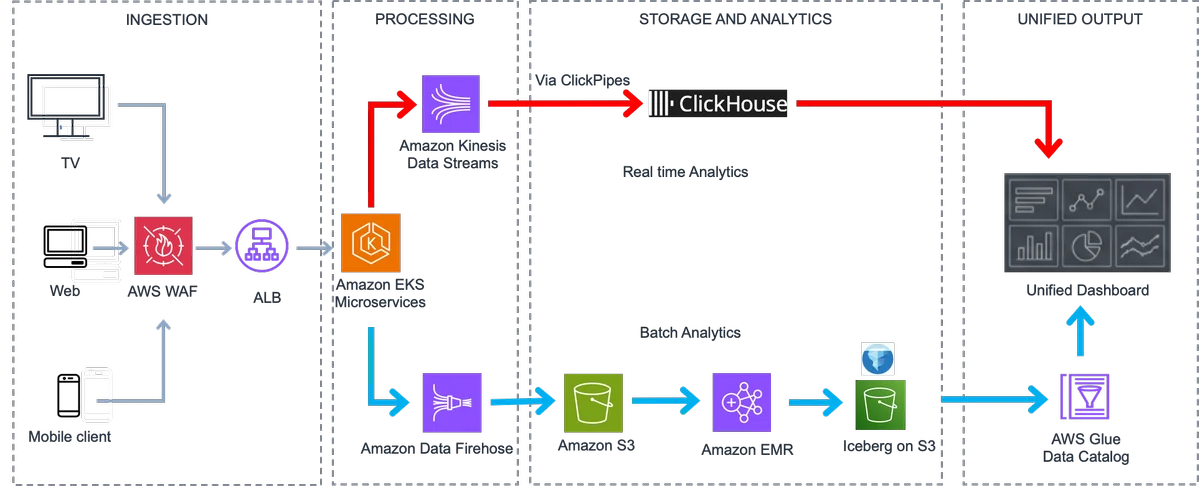
索尼 LIV 如何利用 AWS 构建实时视频流分析 实时数据分析正在改变流媒体平台服务受众的方式。了解索尼 LIV 如何在 AWS 上利用 Amazon Kinesis Data Streams、Amazon EMR 和 Apache Iceberg 构建全面的实时流媒体分析解决方案。 How Sony LIV built real-time video streaming analytics with AWS aws.amazon.com +1
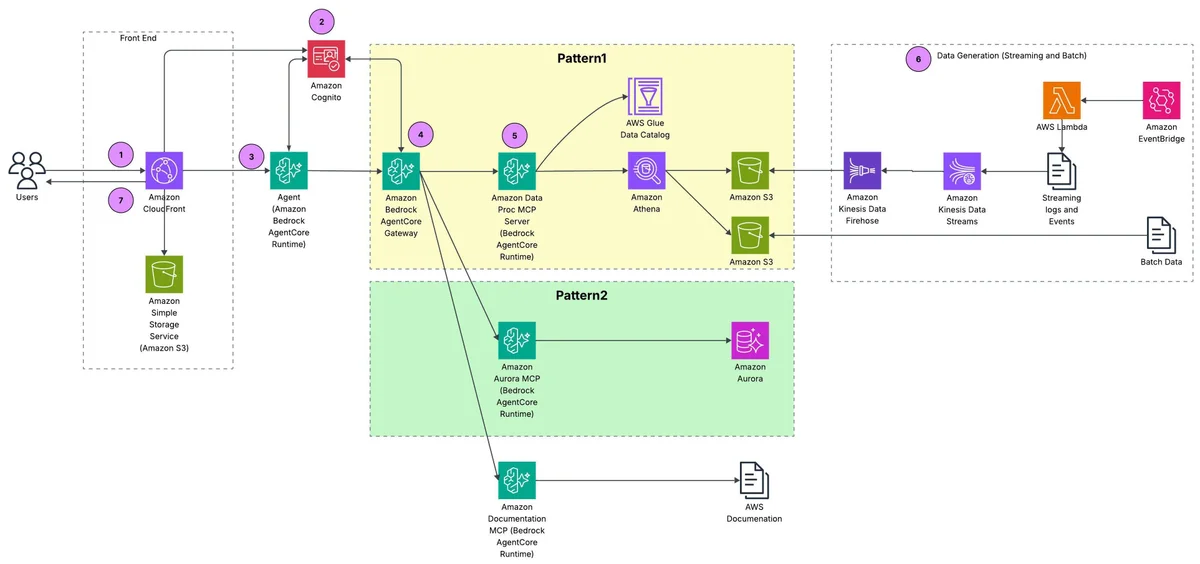
从数据孤岛到洞察:AI 代理的联邦数据访问模式 AI 代理可以直接访问企业数据所在的源头,而无需将每个问题都路由到数据工程师。本文介绍了三种基于模型上下文协议(MCP)服务器和 Amazon Bedrock AgentCore 的联邦数据访问参考模式:目录优先、直接源访问和混合访问。 From silos to insights: Federated data access patterns for AI agents aws.amazon.com +1
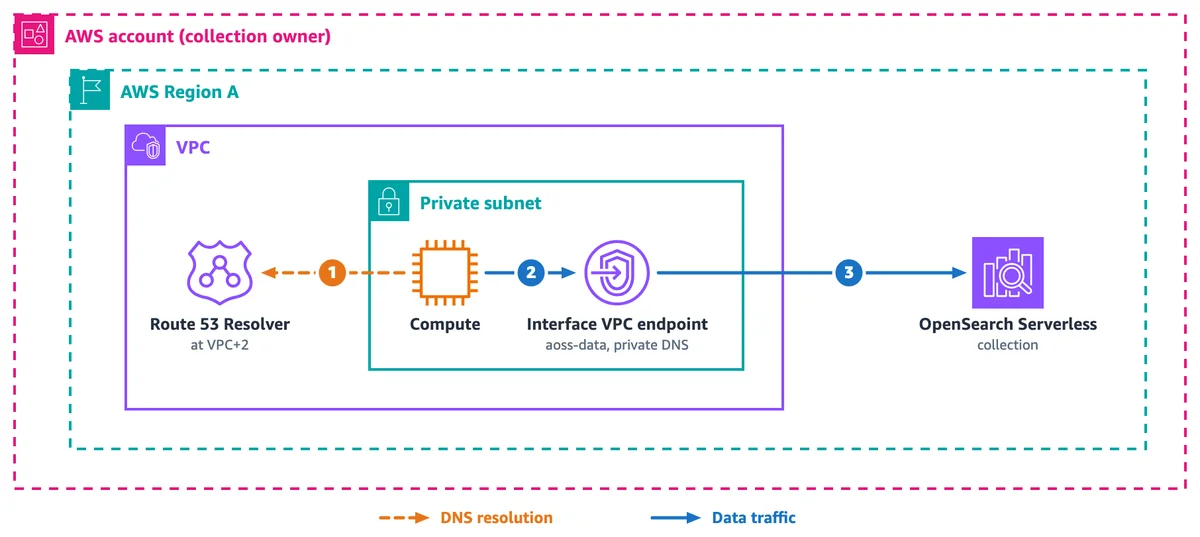
下一代 Amazon OpenSearch Serverless 的网络连接模式 下一代 Amazon OpenSearch Serverless 使用标准 AWS PrivateLink 端点,位于 on.aws 域。本文展示了九种私有访问连接模式,涵盖从单个 VPC 到多个 VPC、跨账户、本地部署以及跨区域的场景,并分别说明了每种模式的 DNS 解析和数据路径。 Network connectivity patterns for the next generation of Amazon OpenSearch Serverless aws.amazon.com +1
Moovit 如何通过架构现代化实现 33% 的成本优化 了解 Moovit 如何通过多引擎湖仓架构现代化其数据平台:将繁重的聚合工作负载从 Amazon Redshift 卸载至使用 Spark SQL 的 Amazon EMR,利用 Amazon Redshift Serverless 隔离工作负载,并将整体数据管道成本降低 33%。 How Moovit achieved 33% cost optimization through architectural modernization aws.amazon.com +1
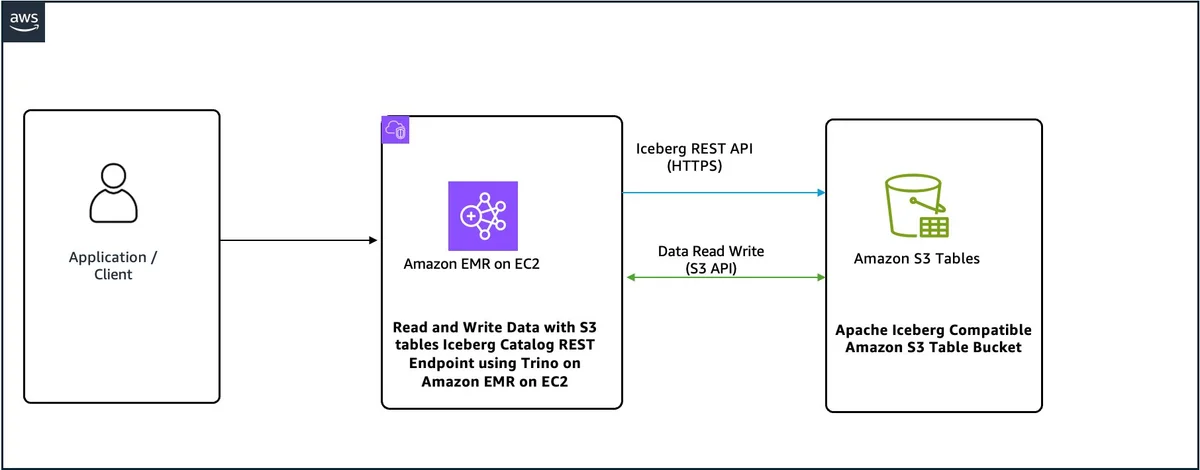
使用 Iceberg REST 端点从 Amazon EMR Trino 查询 Amazon S3 表 学习如何在 Amazon EMR 上的 Trino 中查询 Amazon S3 Tables,方法是使用 Apache Iceberg REST 目录端点。本文展示了如何使用 AWS CloudFormation 部署该集成,配置 Trino 目录,并运行 SQL 语句来创建、查询和管理 Apache Iceberg 表。 Query Amazon S3 Tables from Amazon EMR Trino using the Iceberg REST endpoint aws.amazon.com +1
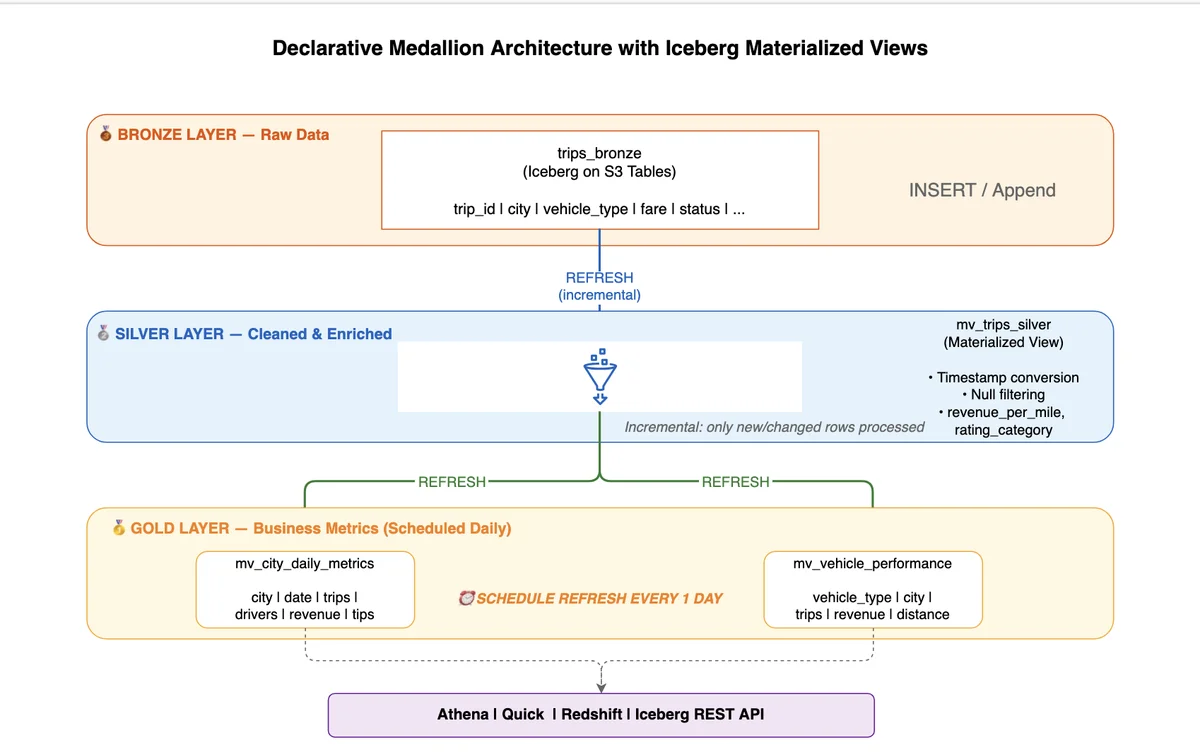
在 Amazon SageMaker 中使用 Iceberg 物化视图构建奖牌架构 借助 Amazon SageMaker 中的 Apache Iceberg 物化视图,您仅需三条 SQL 语句即可构建包含 Bronze、Silver 和 Gold 三个层级的数据中台架构。这种声明式方法将转换、编排和增量处理折叠到各层定义中,无需维护任何 ETL 作业、编排器或变更数据捕获代码。 Building medallion architecture with Iceberg materialized views in Amazon SageMaker aws.amazon.com +1
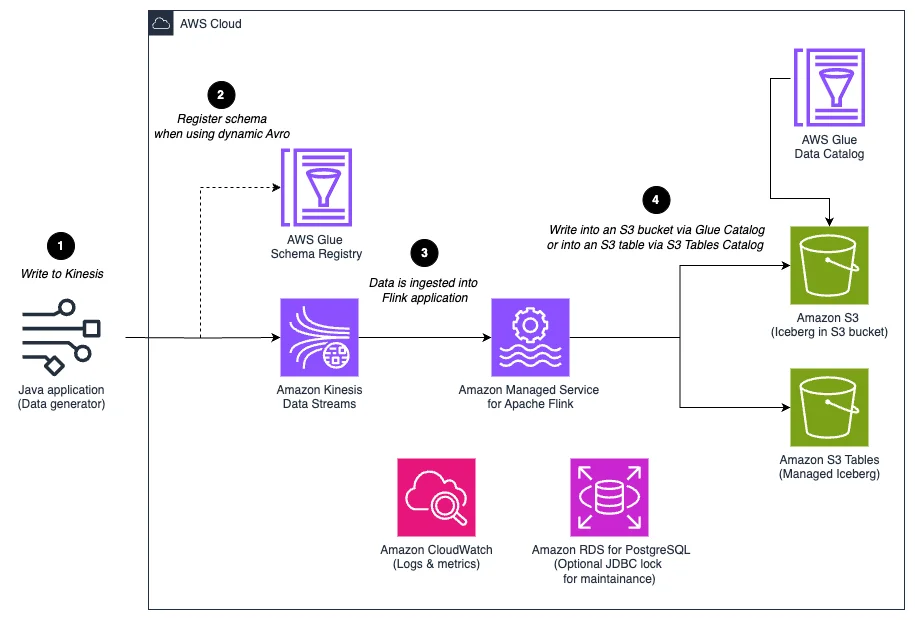
使用 Apache Iceberg 和 Apache Flink 构建动态流式数据湖 学习如何在 Amazon Managed Service for Apache Flink 上构建动态流式数据湖,使其能够适应新事件类型和模式变更而无需停止管道,利用 Apache Iceberg 的动态 Iceberg Sink 实现逐记录表路由和自动模式演进。 Build a dynamic streaming data lake with Apache Iceberg and Apache Flink aws.amazon.com +1
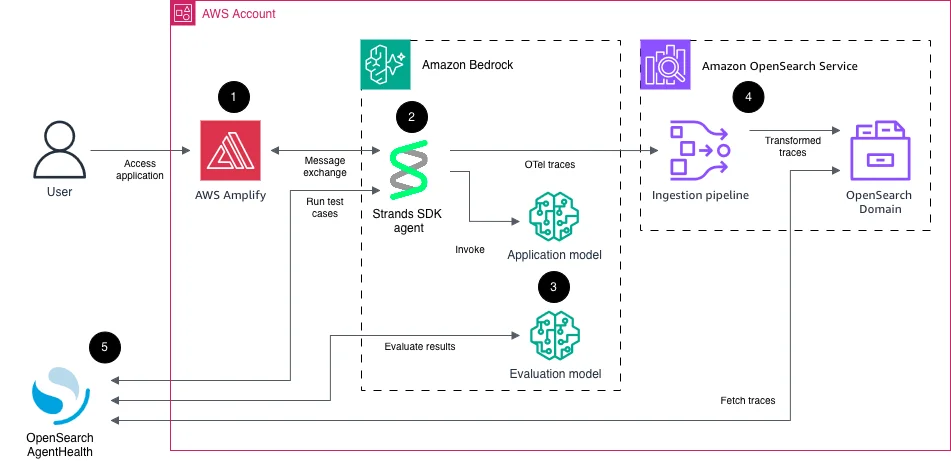
使用 OpenSearch Agent Health 观察和评估生产代理 学习如何通过结合在 AWS 上运行的代理与 OpenSearch Agent Health 来观察和评估生产 AI 代理。本文介绍如何在 AWS 上部署代理及其可观测性管道,然后利用 Agent Health 探索追踪数据并运行评估,以随时间衡量并提升代理质量。 Observing and evaluating production agents using OpenSearch Agent Health aws.amazon.com +1
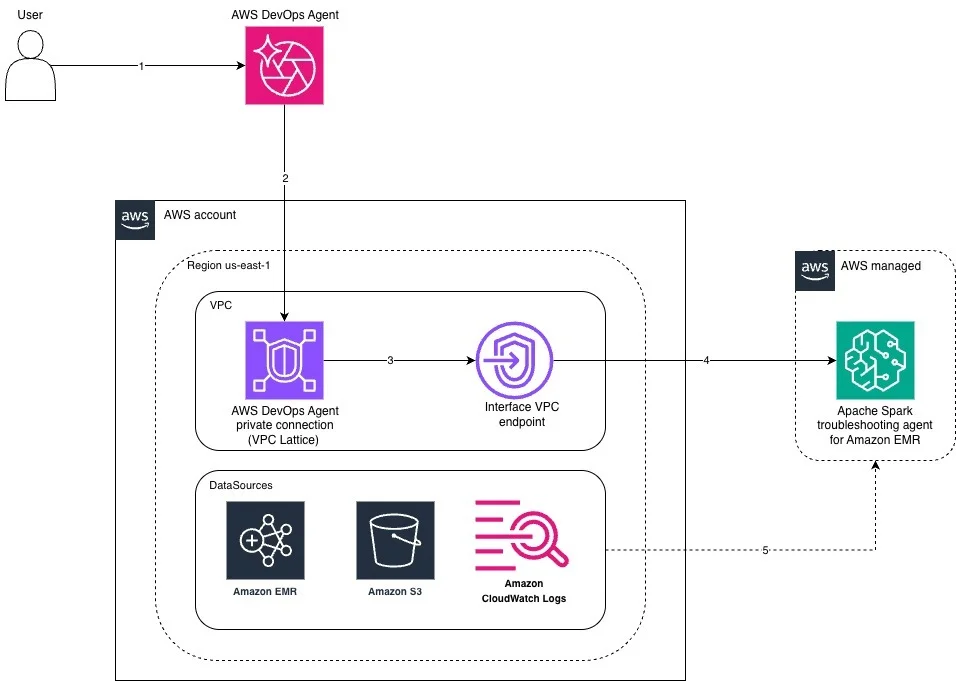
使用 AWS DevOps Agent 加速 Amazon EMR 上的 Apache Spark 调试 扩展 AWS DevOps Agent 以调查 Amazon EMR 上的 Apache Spark 故障。本文展示了如何将 Apache Spark 故障排查代理注册为通过 AWS PrivateLink 提供的自定义 MCP 能力提供者,从而在单个代理聊天会话中,从 Amazon CloudWatch 警报诊断失败的 Spark 作业,直至定位到行号级别的根本原因。 Accelerate Apache Spark debugging on Amazon EMR with AWS DevOps Agent aws.amazon.com +1
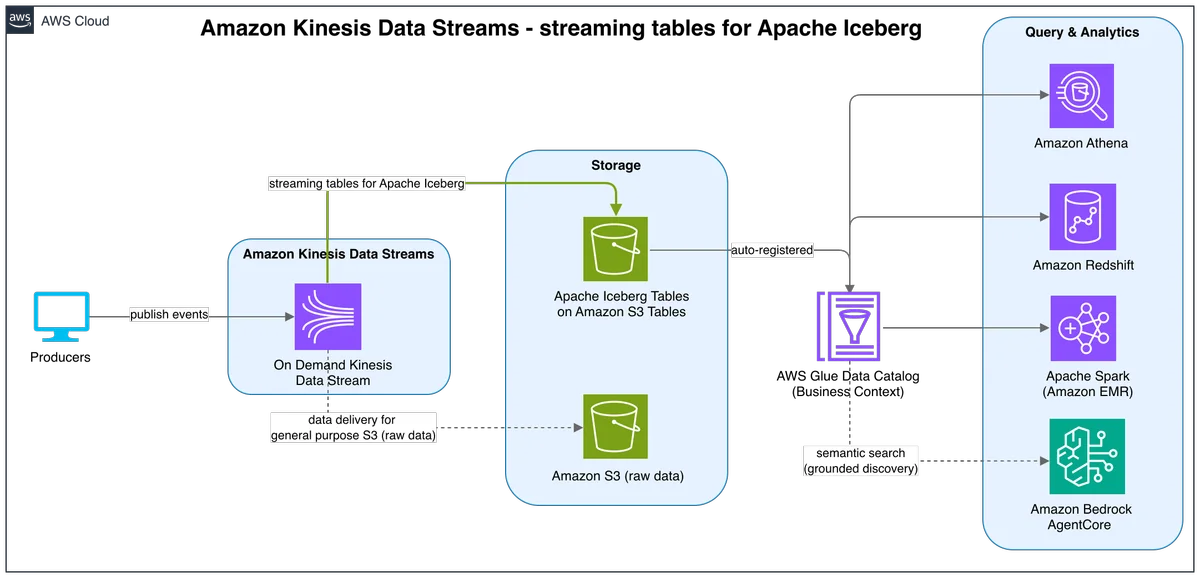
使用 Amazon Kinesis Data Streams 向 Apache Iceberg 流式表提供实时数据 Amazon Kinesis Data Streams 现已支持流式表,这是一种完全托管的功能,可连续将您的流式数据作为可在 Amazon S3 Tables 上查询的 Apache Iceberg 表进行交付。流式表通过内联压缩将交付成本降低高达 25%,查询成本降低高达 30%,且无需运维基础设施。 Deliver real-time data to streaming tables for Apache Iceberg with Amazon Kinesis Data Streams aws.amazon.com +1
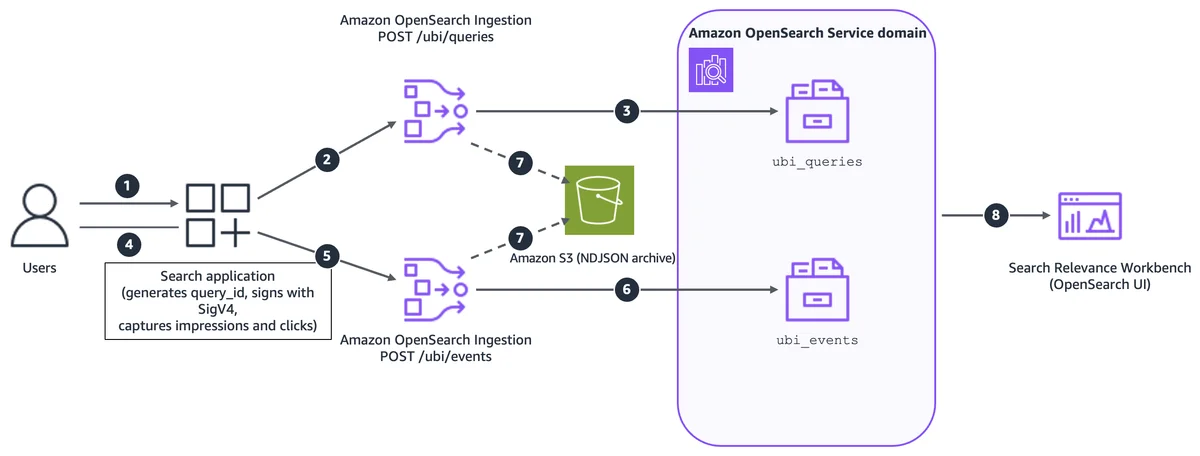
使用 Amazon OpenSearch Service 衡量并改进搜索质量 大多数团队都难以回答一个看似简单的问题:我的搜索是否返回了相关结果?本文介绍如何在 Amazon OpenSearch Service 上捕获用户行为洞察(User Behavior Insights, UBI)数据,并利用搜索相关性工作台(Search Relevance Workbench, SRW)将这些信号转化为相关性判断,从而评估搜索质量。 Measuring and improving search quality with Amazon OpenSearch Service aws.amazon.com +1
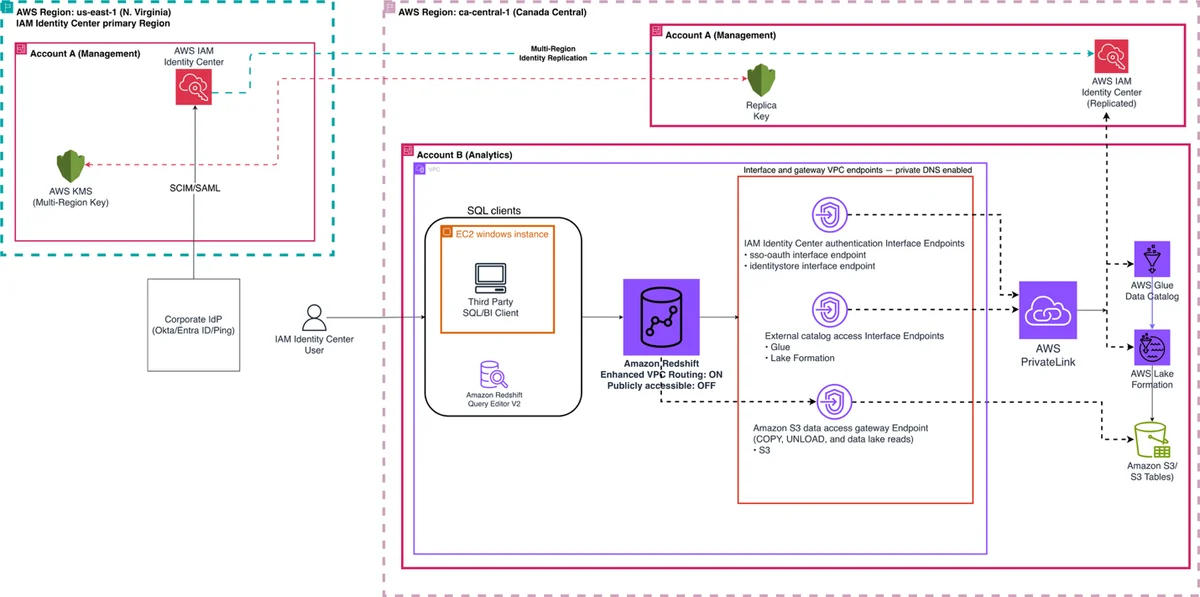
集成 Amazon Redshift 与 IAM Identity Center,并增强 VPC 路由 Amazon Redshift 现已支持在启用增强型 VPC 路由的集群和工作组上使用 AWS IAM Identity Center 进行身份验证。创建两个接口 VPC 端点,使用户能够使用其企业凭证实现单点登录,同时确保所有身份验证流量均保留在 AWS 私有网络内。 Integrate Amazon Redshift and IAM Identity Center with enhanced VPC routing aws.amazon.com +1
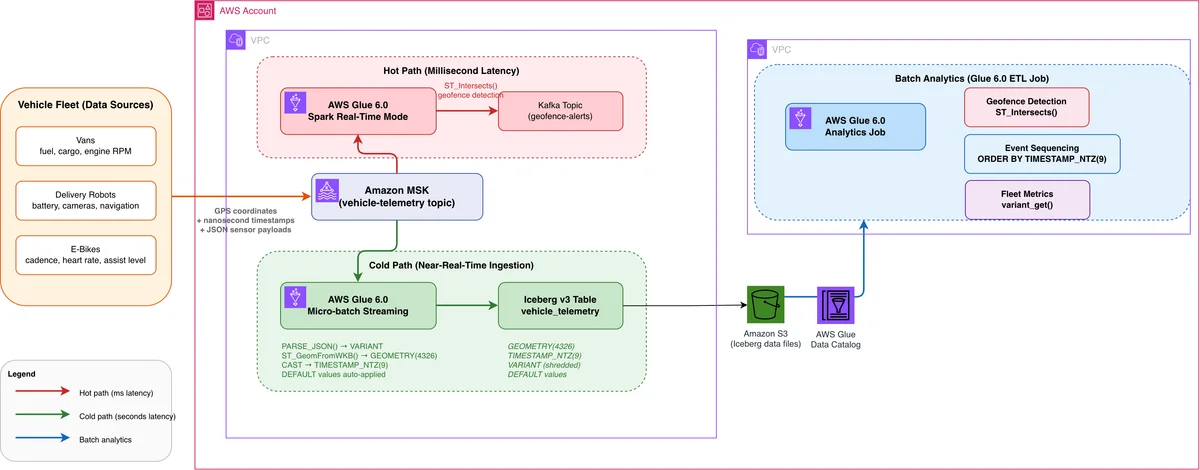
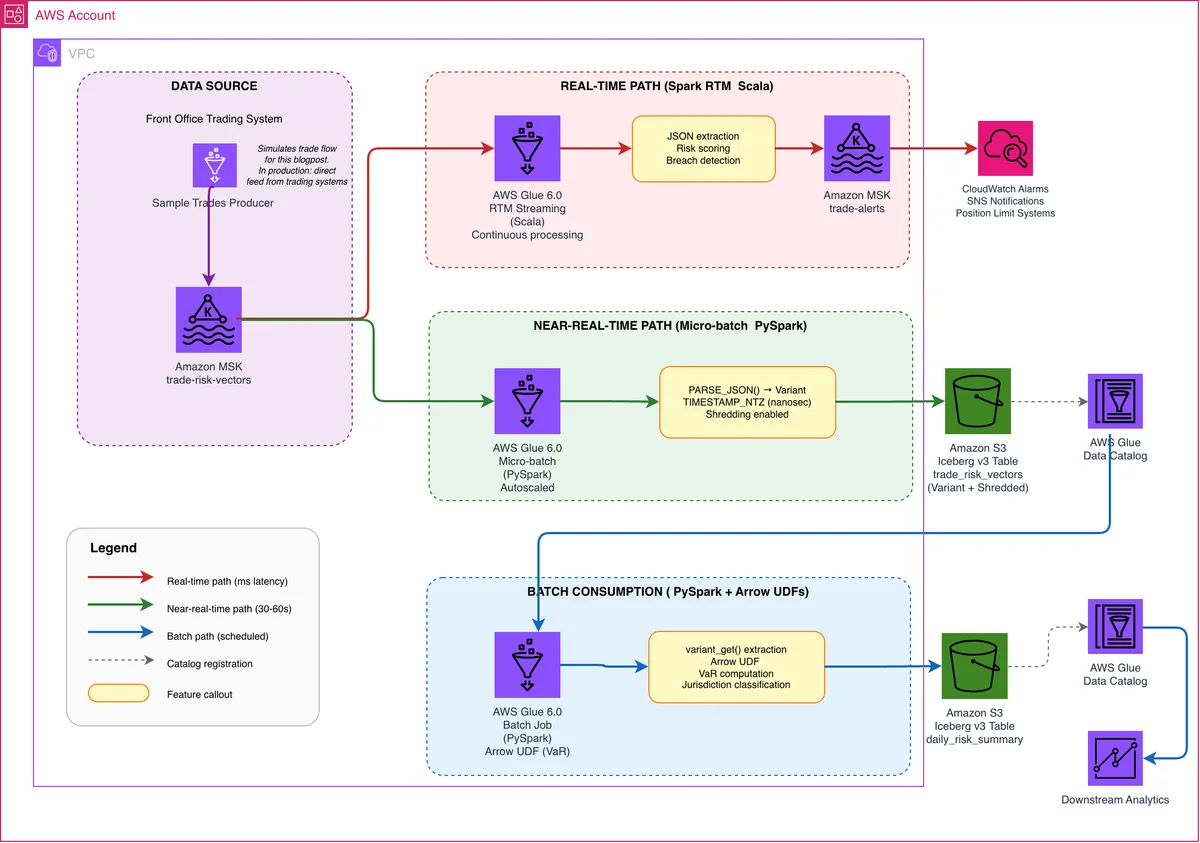
在 AWS Glue 6.0 中使用 Spark 实时模式构建实时事件管道 借助 AWS Glue 6.0,您可以在单一平台上构建实时、准实时和批处理数据管道。以金融市场风险为例,了解如何使用 Spark 实时模式以亚秒级延迟标记高风险交易,如何使用 Apache Iceberg v3 的 Variant 列存储异构价格向量,以及如何运行基于 Arrow 的原生 UDF 进行批处理分析。 Build a real-time event pipeline with Spark Real-Time Mode on AWS Glue 6.0 aws.amazon.com +1
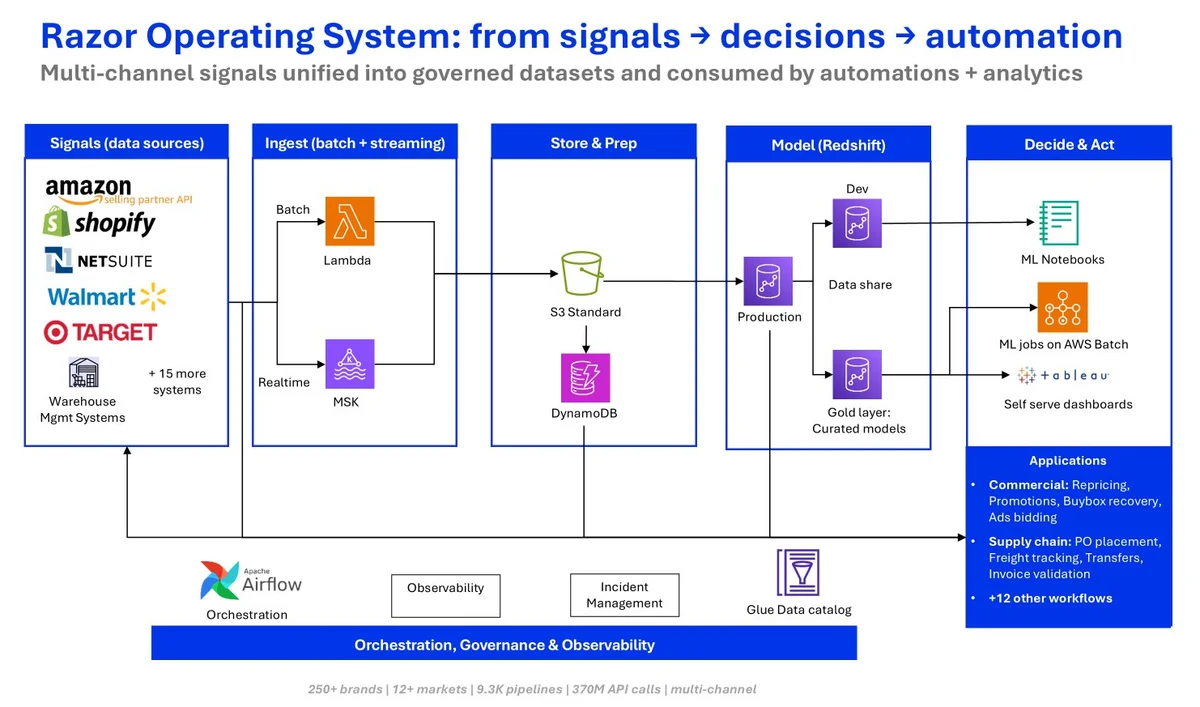
Razor Group 在 AWS 上构建现代化数据湖仓的历程 Razor Group 是欧洲领先的电商聚合商之一,管理着 250 多个品牌,已从始终在线的 Amazon Redshift 集群迁移至基于 Apache Iceberg、Amazon S3 Tables 和 Apache Spark 的开放湖仓架构。了解其架构决策、五阶段迁移过程及成果:P95 查询速度提升 65%,基础设施成本降低 63%。 Razor Group’s journey to a modern data lakehouse on AWS aws.amazon.com +1
Picnic 如何为 Amazon MQ 配置多个 OAuth 提供商 Picnic 在 Amazon MQ for RabbitMQ 上运行 RabbitMQ,作为数百个微服务之间的消息骨干。本文展示了如何配置一个代理以信任多个 OAuth 2.0 身份提供商:为操作员使用 Keycloak,为服务使用 AWS IAM,从而在保持人员和工作负载独立身份路径的同时消除静态凭据。 How Picnic configured multiple OAuth providers for Amazon MQ aws.amazon.com +1
在 AWS Glue 6.0 上构建支持地理空间类型和变体类型的 Iceberg v3 AWS Glue 6.0 结合 Apache Spark 4.1 新增了对 Apache Iceberg v3 的支持,包括原生地理空间类型、纳秒级精度时间戳、VARIANT 类型以及 DEFAULT 列值。本文构建了一个车联网车队遥测数据管道,在单个 Iceberg v3 表中同时应用上述四种特性,涵盖从数据摄入到地理空间、纳秒级及 VARIANT 类型查询的全过程。 Build with geospatial and variant types in Iceberg v3 on AWS Glue 6.0 aws.amazon.com +1
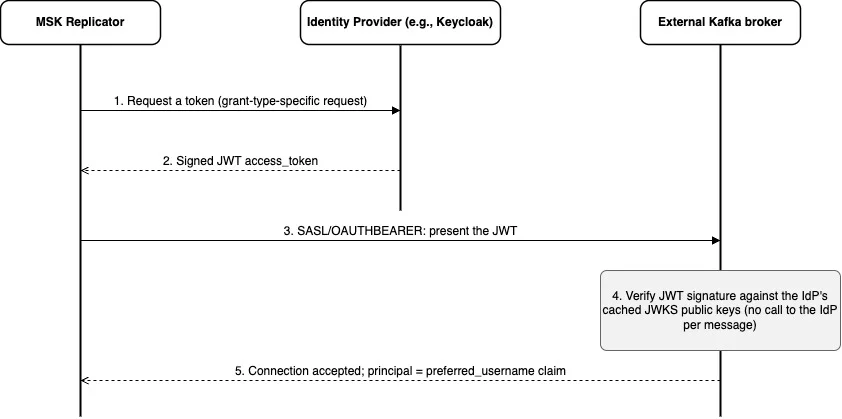
使用 MSK Replicator 将经过 OAuth 2.0 认证的 Apache Kafka 集群迁移到 Amazon MSK MSK Replicator 现已支持通过 OAuth 2.0(SASL/OAUTHBEARER)对外部 Apache Kafka 集群进行身份验证。本文介绍了三种支持的授权类型、针对每种类型配置 Replicator 的方法、常被忽略的网络和 TLS 先决条件,以及如何处理位于额外联邦层之后的身份提供商。 Migrate an OAuth 2.0 authenticated Apache Kafka cluster to Amazon MSK with MSK Replicator aws.amazon.com +1
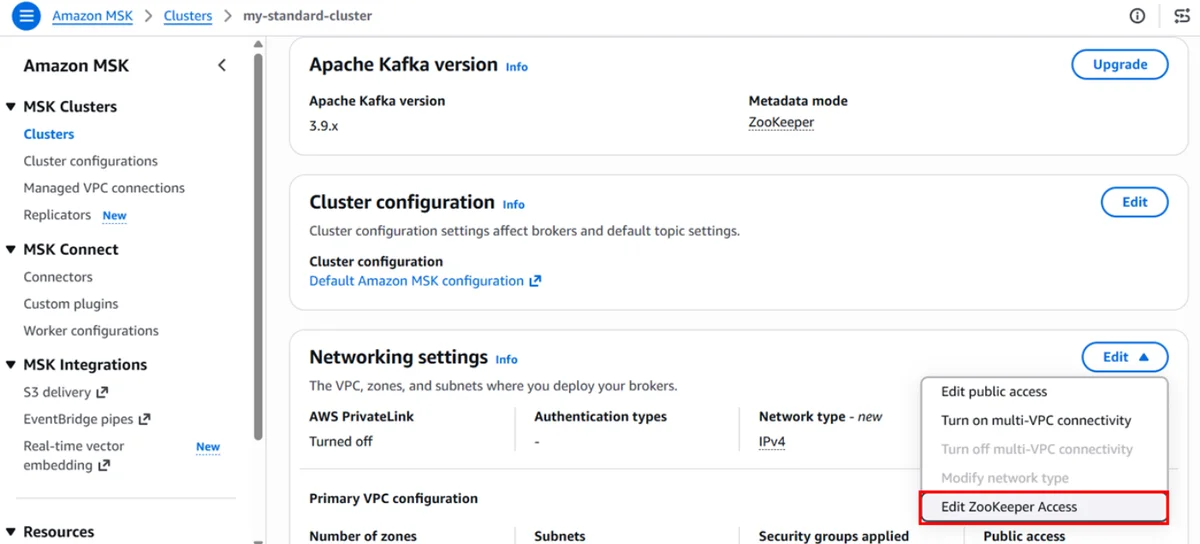
宣布 Amazon MSK 支持原地 ZooKeeper 到 KRaft 集群升级 Amazon MSK 现已支持从 ZooKeeper 到 KRaft 元数据模式的就地升级。您可以通过熟悉的版本升级工作流,对现有集群的元数据管理进行现代化改造,无需创建新集群,也无需进行数据迁移。本文介绍升级的前提条件和逐步升级流程。 Announcing in-place ZooKeeper-to-KRaft cluster upgrades for Amazon MSK aws.amazon.com +1
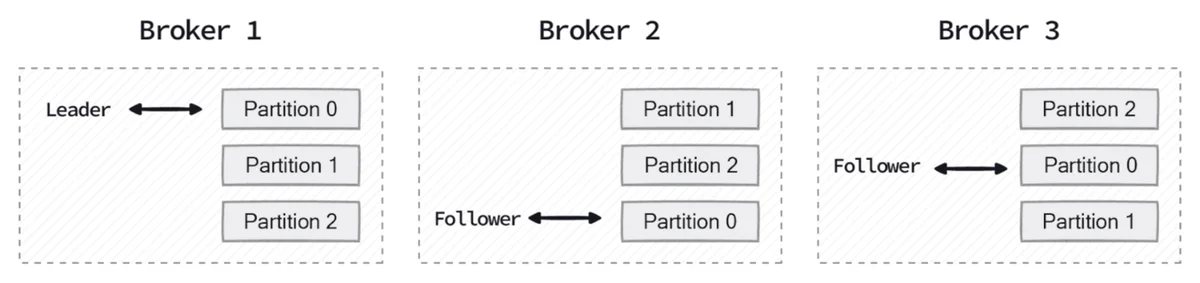
Amazon MSK 服务入门:Amazon MSK 主题需要多少个分区? 您的 Amazon MSK 主题需要多少个分区?选择合适的分区数量会影响吞吐量、可扩展性和运维复杂度。本文提供关于分区规模的实用指导,涵盖每个分区的吞吐量、消费者并行度、分区键以及 Amazon MSK 的每个分区每代理指南。 Amazon MSK Service 101: How many partitions does an Amazon MSK topic need? aws.amazon.com +1
AWS 与 DuckLabs:携手构建分析的未来” 今天,我们宣布亚马逊已签署最终协议,收购阿姆斯特丹的 DuckLabs 公司,该公司是开源分析型数据库 DuckDB 的缔造者。我们预计该交易将在满足惯例交割条件后不久完成。DuckDB 的创建者及 DuckLabs 的联合创始人 Hannes Mühleisen 和 Mark Raasveldt 将继续领导团队,并作为 AWS 的一部分主导该开源项目的技术方向。DuckDB 开源项目仍将由 DuckLabs 团队推动,继续由独立基金会(负责监管 DuckDB 的非营利组织)管理,并保持 MIT 许可协议,一如今日。 AWS and DuckLabs: Building the future of analytics together aws.amazon.com +1
PythonOperator 和 BashOperator 现已在 Amazon Managed Workflows for Apache Airflow(Amazon MWAA)无服务器版中可用 现在,您可以在 Amazon MWAA Serverless 运行时中直接使用 PythonOperator 和 BashOperator 运行自定义 Python 函数和 Shell 脚本,而无需配置额外的基础设施。本文介绍如何构建一个无服务器管道,使用 PythonOperator 将 CSV 文件转换为 JSON,并使用 BashOperator 验证输出结果。 PythonOperator and BashOperator Now Available on Amazon Managed Workflows for Apache Airflow (Amazon MWAA) Serverless aws.amazon.com +1
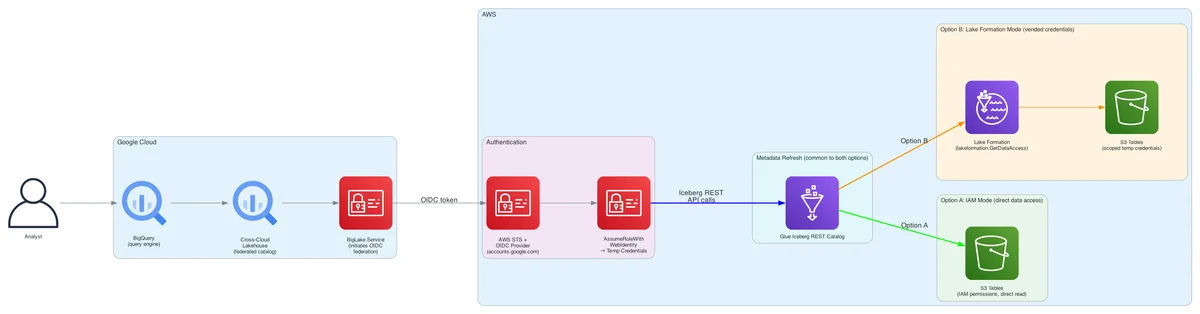
启用基于 Amazon S3 Tables 和 Google BigQuery 的跨云分析,第一部分:基于 IAM 的访问控制 您的 Google BigQuery 用户需要查询存储在 AWS 上 Amazon S3 Tables 中的数据,而无需跨云复制数据。本文展示了如何通过基于 IAM 的访问控制,将 BigQuery 连接到 AWS Glue Iceberg REST Catalog,从而保留单一受管数据集,并从 BigQuery 中实时查询该数据。 Enable cross-cloud analytics with Amazon S3 Tables and Google BigQuery, Part 1: IAM-based access control aws.amazon.com +1
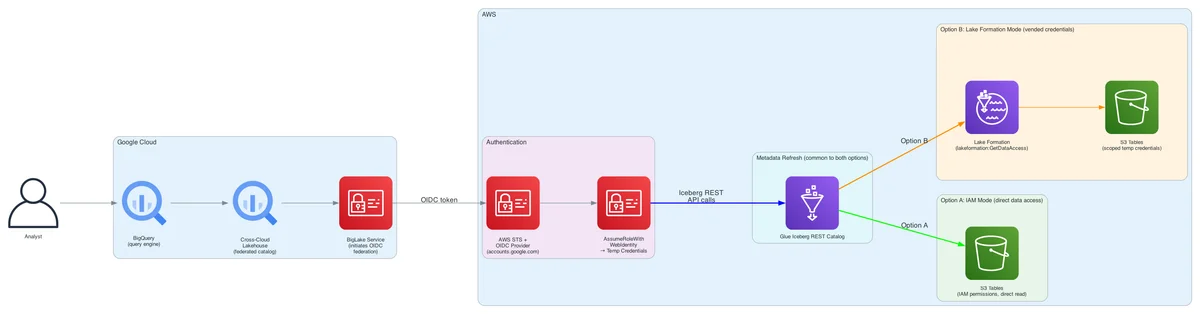
使用 Amazon S3 Tables 和 Google BigQuery 实现跨云分析(第二部分):通过 Lake Formation 实施访问控制 在本系列文章的第二部分中,利用 AWS Lake Formation 凭据分发功能将 Google BigQuery 连接到 Amazon S3 Tables。Lake Formation 可管理细粒度权限,并向外部引擎颁发短生命周期的限定范围凭据,因此您可以集中管控哪些团队和查询引擎可以读取 AWS 上的 Iceberg 表,而无需为每个消费者管理 IAM 策略。 Enable cross-cloud analytics with Amazon S3 Tables and Google BigQuery, Part 2: access control with Lake Formation aws.amazon.com +1
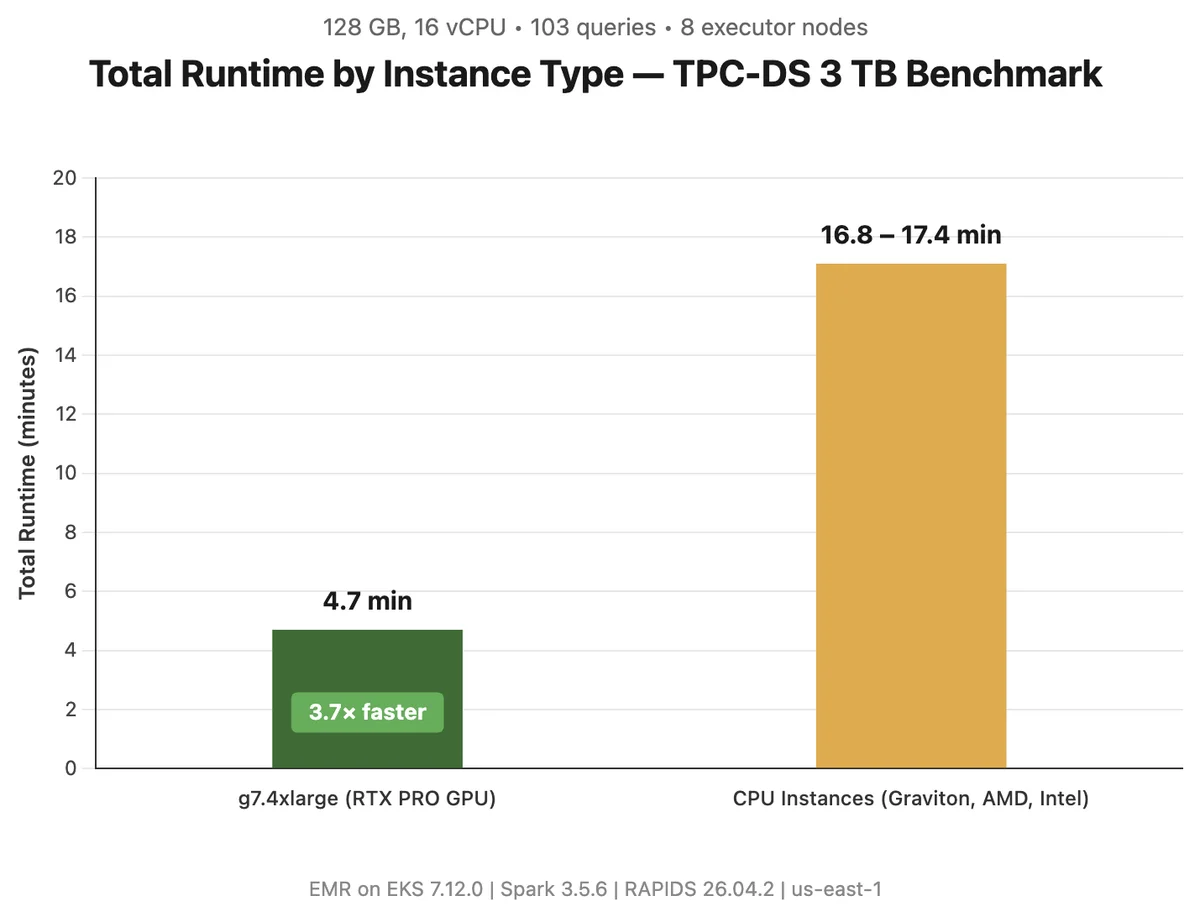
配备 NVIDIA RTX PRO 4500 的 GPU 加速 Apache Spark 在 Amazon EC2 G7 实例上结合 Amazon EMR 运行,速度最高提升 3.7 倍 在 Amazon EC2 G7 实例上搭载 NVIDIA RTX PRO 4500 Blackwell GPU 的 Amazon EMR on EKS 相比同类 CPU 实例,运行 Apache Spark 的速度最高提升 3.7 倍,且无需修改现有 Spark 代码。请参阅 TPC-DS 基准测试结果、成本对比以及入门指南。 GPU-accelerated Apache Spark with Amazon EMR and NVIDIA RTX PRO 4500 on Amazon EC2 G7 instances runs up to 3.7x faster aws.amazon.com +1
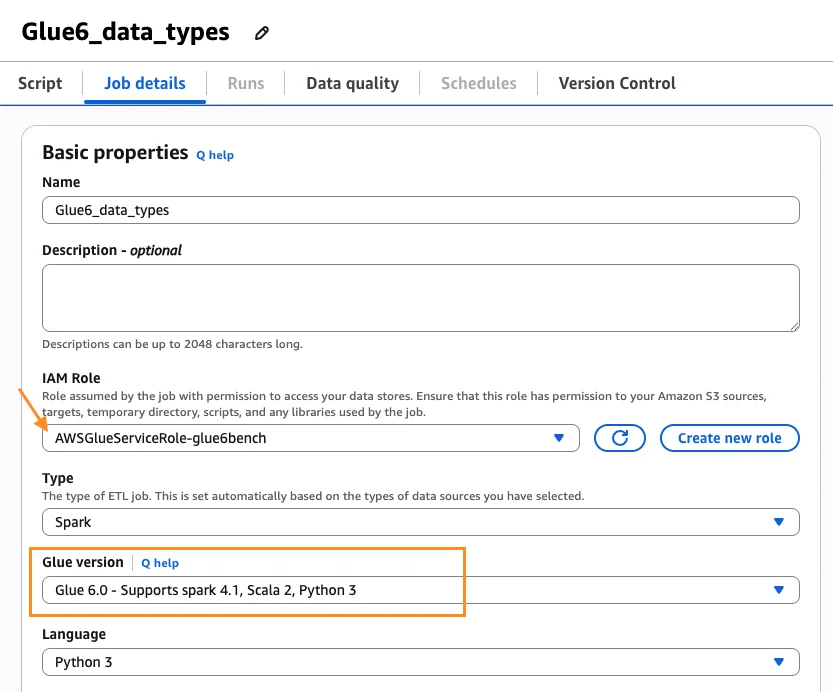
推出 AWS Glue 6.0,实现更快速且更具成本效益的数据集成 现已推出 AWS Glue 6.0,将 AWS Glue 定价降低 30%,新增 AWS 优化的 Apache Spark 4.1 构建版本,并引入适用于企业级采用的 Apache Iceberg V3 功能。本文介绍关键功能与性能优势,并提供代码示例以助您快速上手。 Introducing AWS Glue 6.0 for faster and more cost-effective data integration aws.amazon.com +1
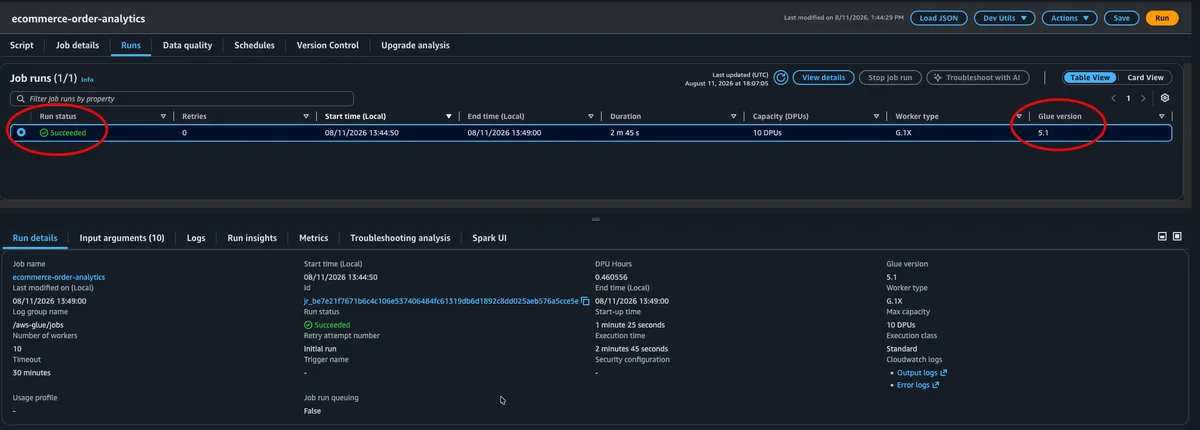
将 AWS Glue 作业升级至 Glue 6.0,并采用 AI 驱动的 Spark 升级 通过生成式 AI 升级 Apache Spark 的 AWS Glue 5.1 至 6.0 版 PySpark ETL 作业。升级分析可自动检测不兼容项、应用修复措施,并通过数据质量检查验证结果。 Upgrade AWS Glue jobs to Glue 6.0 with AI-powered Spark upgrades aws.amazon.com +1
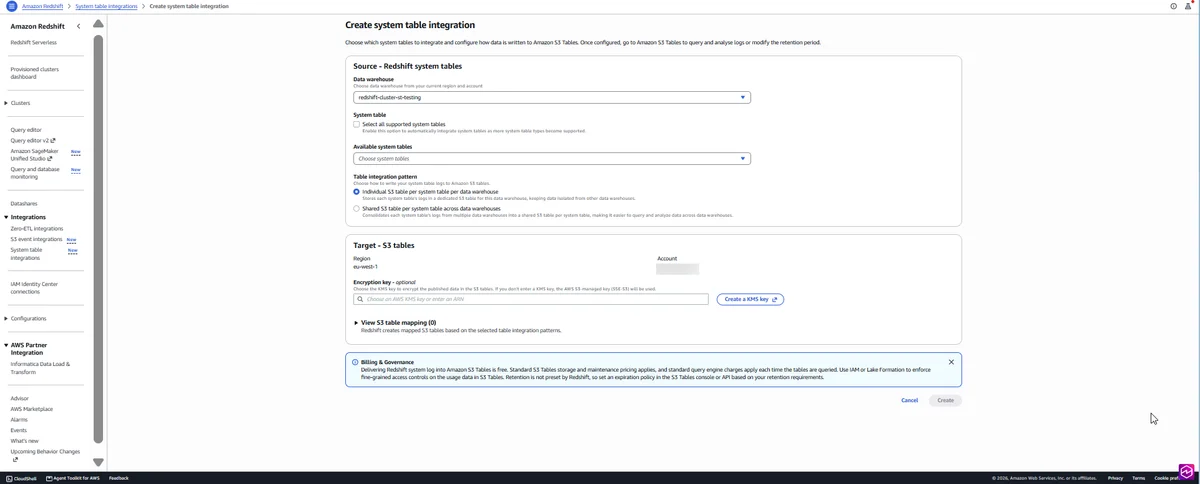
使用 Amazon S3 Tables 在 Amazon Redshift 中实现长期系统表保留 Amazon Redshift 系统表与 Amazon S3 Tables 的集成可自动将系统表日志以 Apache Iceberg 格式交付至 Amazon S3 Tables。您无需自定义 ETL 流程或消耗集群资源,即可将数据保留超过 7 天的限制,以满足合规性、审计及跨仓库可观测性需求。 Long-term system tables retention in Amazon Redshift with Amazon S3 Tables aws.amazon.com +1
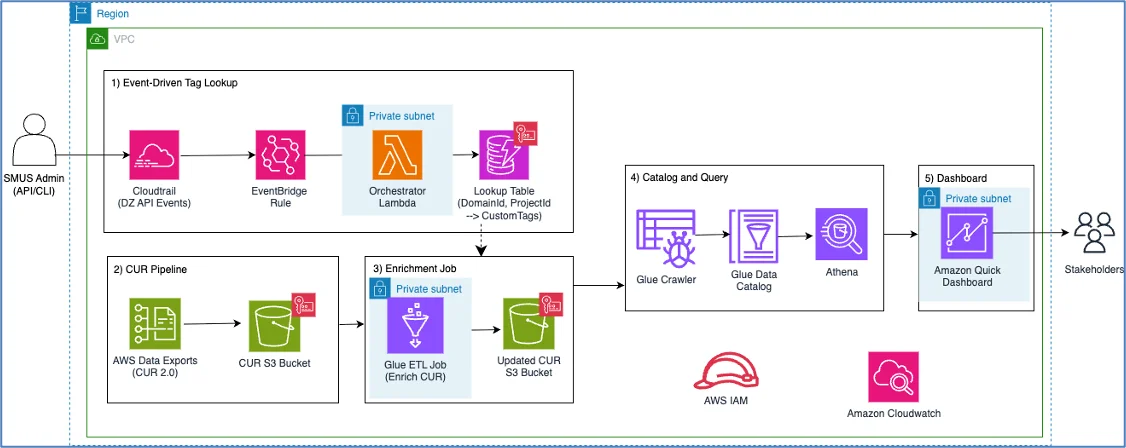
使用自定义标签和 AWS CUR 跟踪 SageMaker Unified Studio 项目的成本 学习如何通过自定义标签跟踪 Amazon SageMaker Unified Studio 项目的成本。此无服务器解决方案通过自定义项目标签丰富 AWS 成本和使用报告(CUR)数据,并在 Amazon QuickSight 仪表板中按成本中心、团队或环境可视化成本。 Track SageMaker Unified Studio project costs with custom tags and AWS CUR aws.amazon.com +1
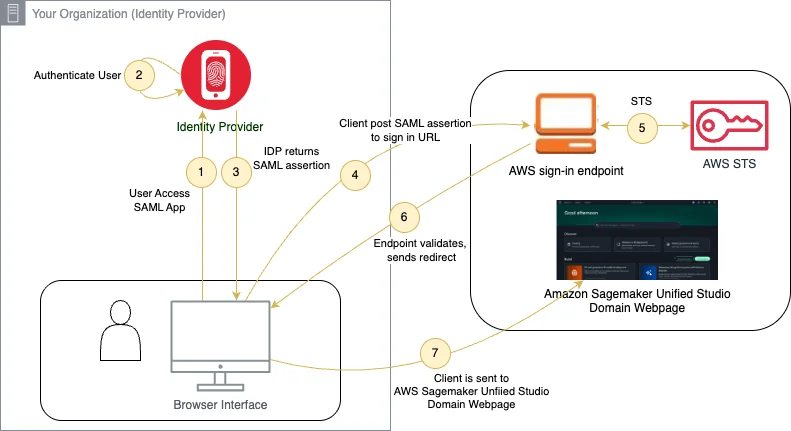
使用 SAML 和条件策略安全地访问 SageMaker Unified Studio 了解如何通过将其与外部 SAML 身份提供商(如 Okta)集成来安全配置 Amazon SageMaker Unified Studio。本文展示了如何应用条件访问策略,以强制实施设备合规性、基于 IP 的限制以及针对您的数据和 AI 工作负载的多因素认证。 Secure SageMaker Unified Studio access with SAML and conditional policies aws.amazon.com +1
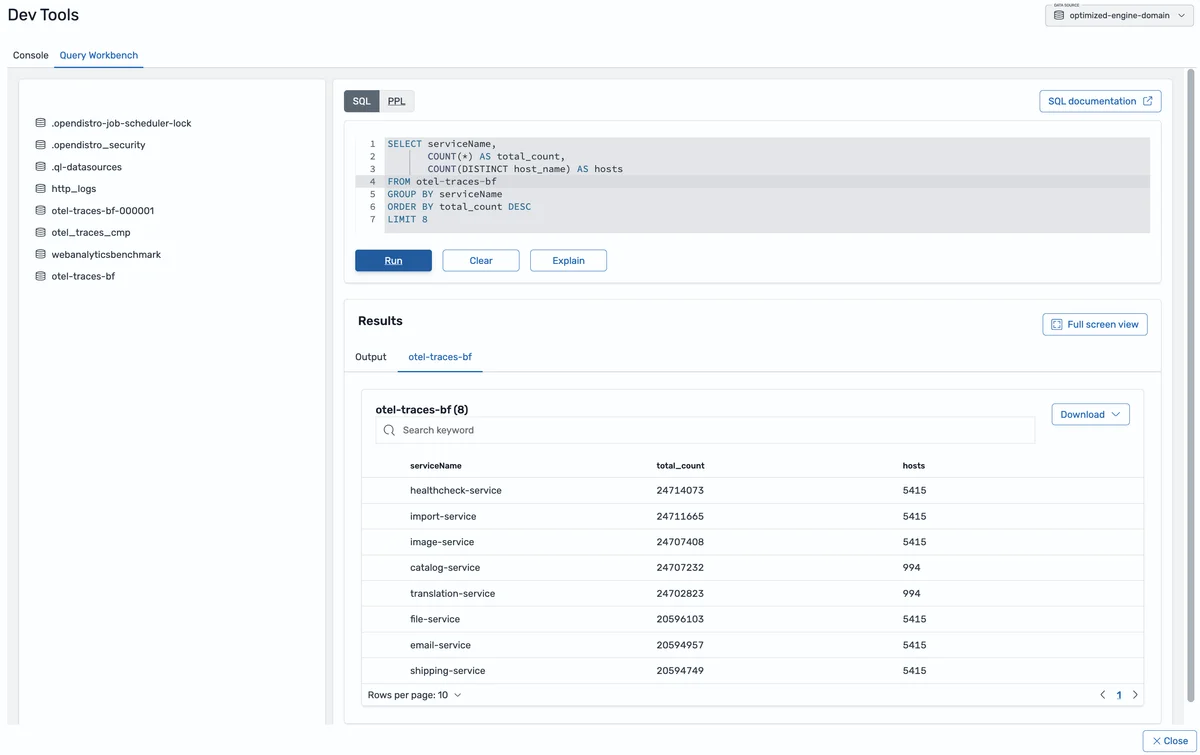
使用优化引擎在 Amazon OpenSearch Service 中通过 SQL 和 PPL 查询原始日志数据 学习如何使用 PPL 和 SQL 直接在 Amazon OpenSearch Service 中的原始日志和跟踪数据上运行快速分析查询。跟随一次单一的事件调查,逐条执行查询,观察新优化的引擎如何直接从原始 span 中回答每个问题。 Querying raw log data using SQL and PPL with the optimized engine in Amazon OpenSearch Service aws.amazon.com +1
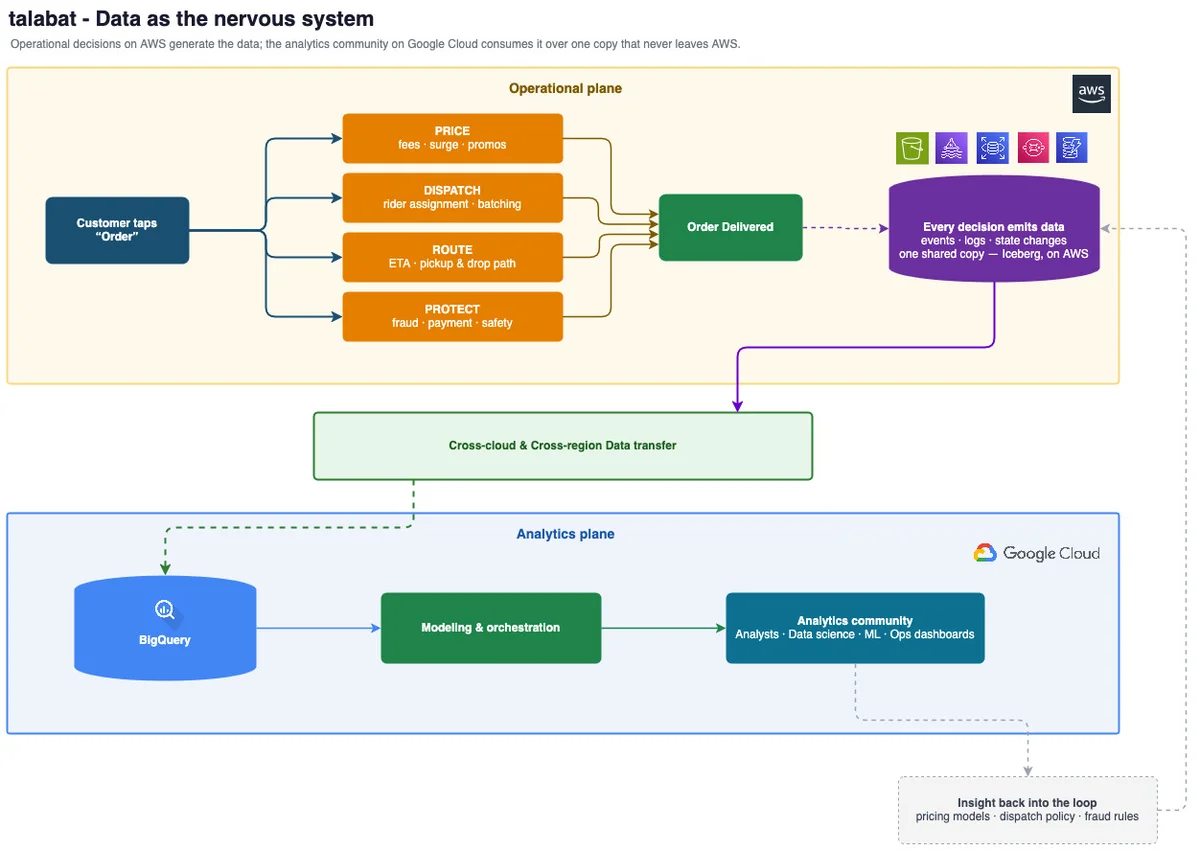
更前沿的洞察,更快的决策:talabat 在 AWS 和 Google Cloud 上的近实时分析 中东和北非领先的日常应用 talabat 构建了一个混合多云数据湖仓,在 Amazon S3 Tables 上保留一份 Apache Iceberg 格式的流式数据副本,同时让 Google BigQuery 就地查询,从而消除了跨云数据重复和模式同步开销。 Fresher insights, faster decisions: talabat’s near-real-time analytics across AWS and Google Cloud aws.amazon.com +1
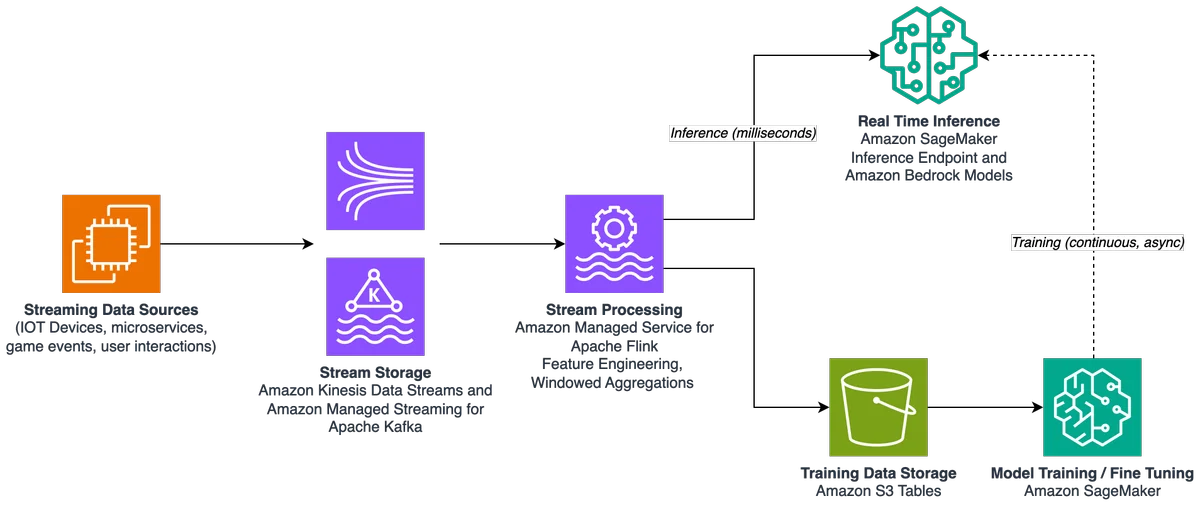
在 AWS 上利用实时流数据驱动智能体 AI 代理型 AI 应用现已能够在生产环境中对流式数据进行观察、推理并执行操作。本文介绍了三种架构模式,它们共同构成了代理型 AI 时代的统一流式骨干:基于实时推理的流式特征工程、事件驱动的代理调用,以及实时上下文同步。 Powering agentic AI with real-time streaming data on AWS aws.amazon.com +1
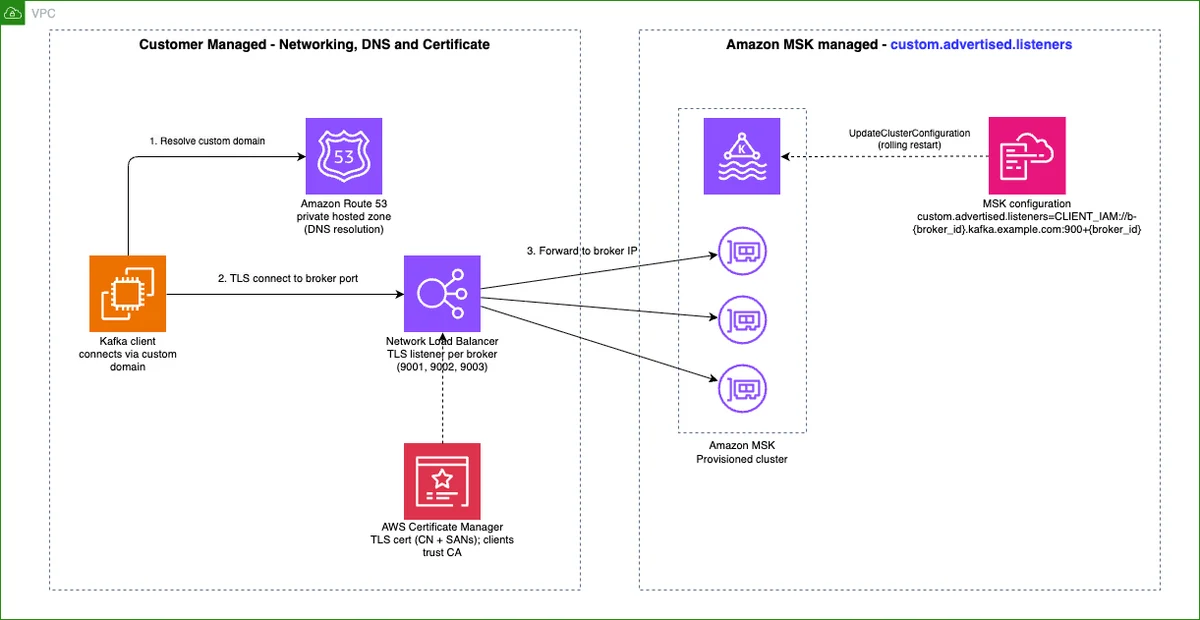
亚马逊MSK简化了自定义域名的配置 使用 Amazon MSK,您现在可以通过单个配置属性为托管集群配置自定义域名,该属性在 ZooKeeper 和 KRaft 上表现完全一致。只需定义一次域名,Amazon MSK 便会将其应用于所有代理节点,从而确保在集群扩展时自定义域名持续可用。 Amazon MSK simplifies configuring custom domain names aws.amazon.com +1
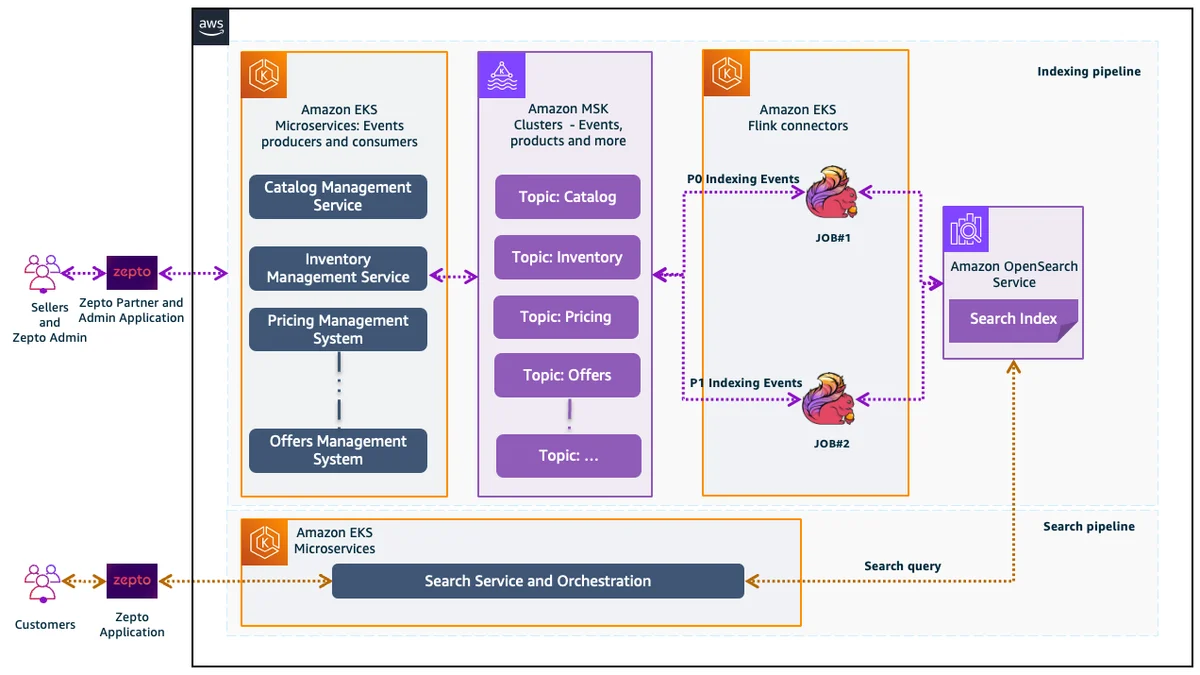
Zepto 如何利用 OpenSearch Service OR2 实例实现亚秒级搜索 了解印度快速增长的即时配送平台 Zepto 如何将 Amazon OpenSearch Service 迁移至 OpenSearch Optimized(OR2)实例,从而在数百个配送中心实现亚秒级商品搜索,在承载相同工作负载的同时,将索引吞吐量提升超过 100%,并节省 30% 的成本,同时将所需数据节点数量减少至原来的三分之二。 How Zepto powers sub-second search using OpenSearch Service OR2 instances aws.amazon.com +1
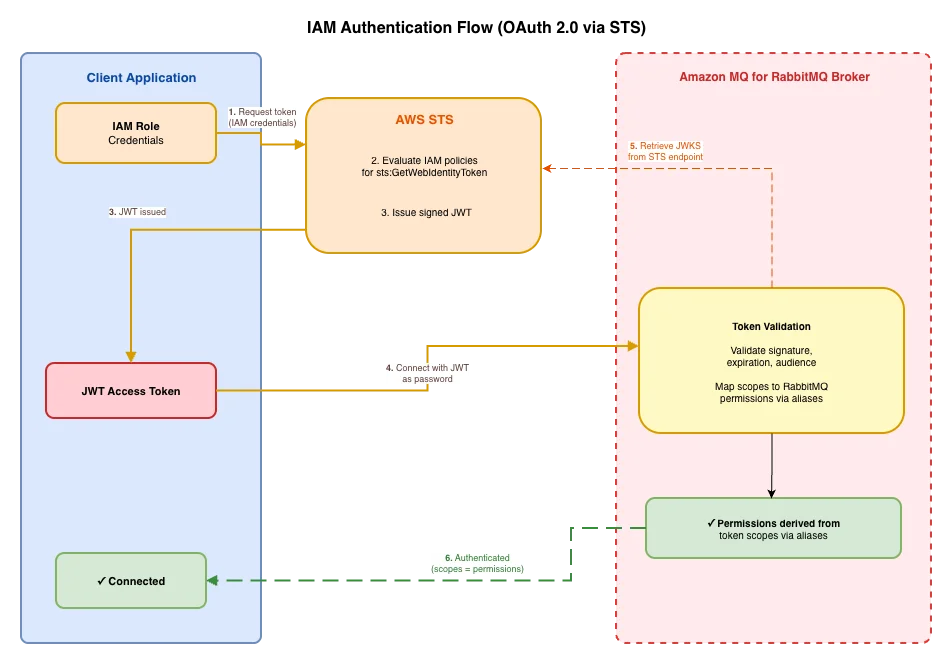
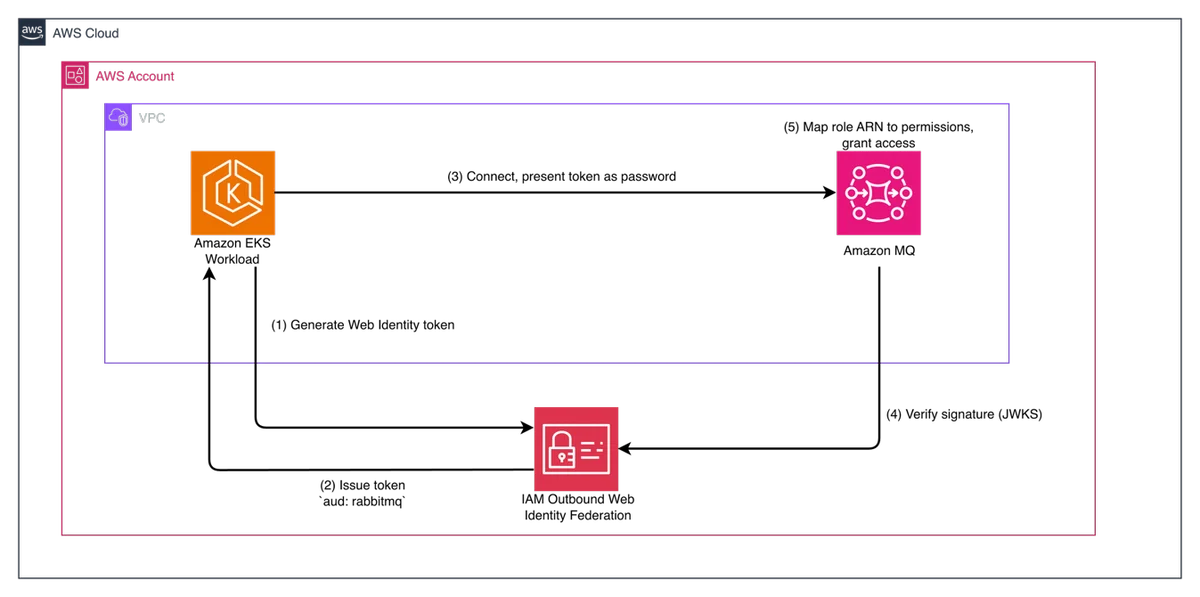
使用 OAuth 2.0 对 Amazon MQ for RabbitMQ 进行 IAM 身份验证 使用 OAuth 2.0 的 IAM 身份验证允许客户端使用其现有的 IAM 身份连接到 Amazon MQ for RabbitMQ,而无需使用静态的代理本地凭据。本文介绍了使用 AWS IAM 作为 OAuth 2.0 提供程序所需的关键 rabbitmq.conf 配置,并展示了一个多租户示例,其中通过 IAM 角色和代理作用域别名强制实施 vhost 隔离。 IAM authentication with OAuth 2.0 for Amazon MQ for RabbitMQ aws.amazon.com +1
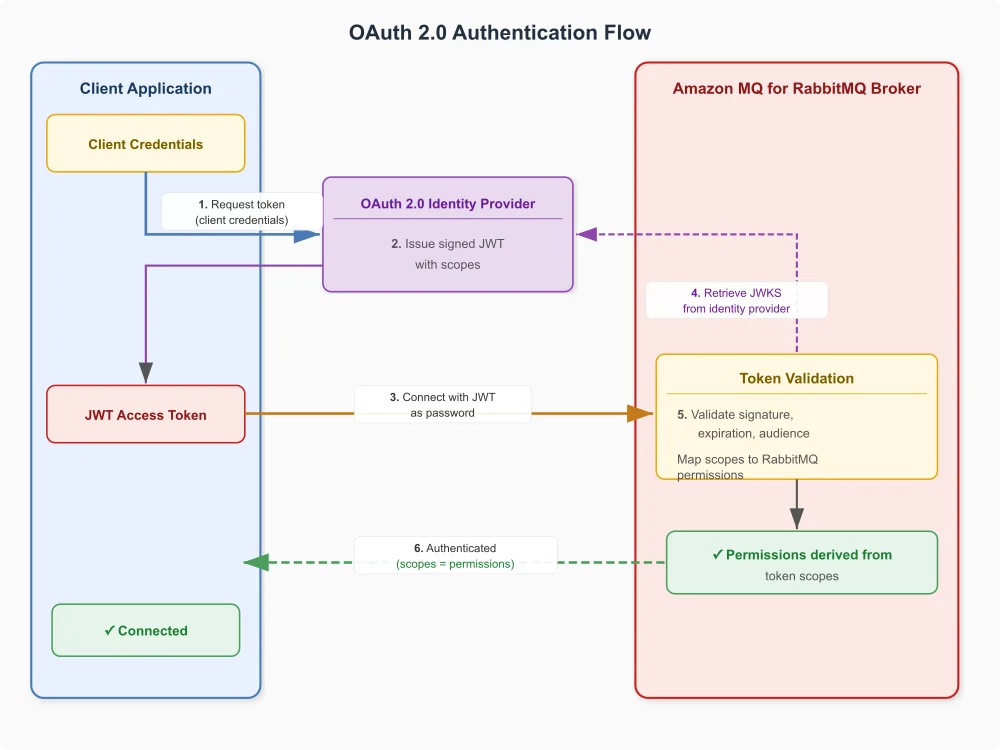
用于 Amazon MQ for RabbitMQ 的 OAuth 2.0、LDAP 和 HTTP 身份验证 Amazon MQ for RabbitMQ 支持 OAuth 2.0、LDAP 和基于 HTTP 的身份验证后端,使您能够将代理连接到已使用的身份基础设施。本文介绍每种方法的工作原理,并帮助您确定哪种方案最适合您的使用场景。 OAuth 2.0, LDAP, and HTTP auth for Amazon MQ for RabbitMQ aws.amazon.com +1
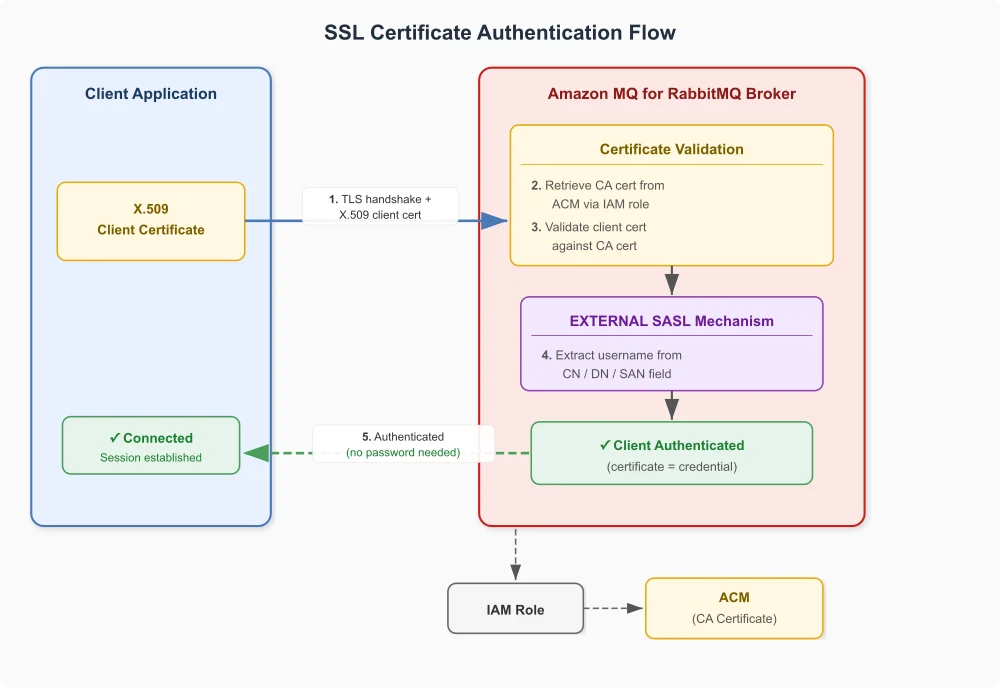
Amazon MQ for RabbitMQ 的相互 TLS 和 SSL 证书认证 了解如何在 Amazon MQ for RabbitMQ 中添加基于证书的标识验证。本文解释了通过 EXTERNAL SASL 机制实现无密码登录的 SSL 证书认证,以及用于双向证书验证的相互 TLS(mTLS),突出了关键的 rabbitmq.conf 配置项,并帮助您根据合规要求选择合适的方法。 Mutual TLS and SSL certificate authentication for Amazon MQ for RabbitMQ aws.amazon.com +1
Amazon MQ for RabbitMQ 的认证和授权选项 Amazon MQ for RabbitMQ 支持多种身份验证和授权方法,因此您可以将代理连接到已使用的身份基础设施。本文介绍了可用的选项,并帮助您为特定用例选择最合适的方法。 Authentication and authorization options for Amazon MQ for RabbitMQ aws.amazon.com +1
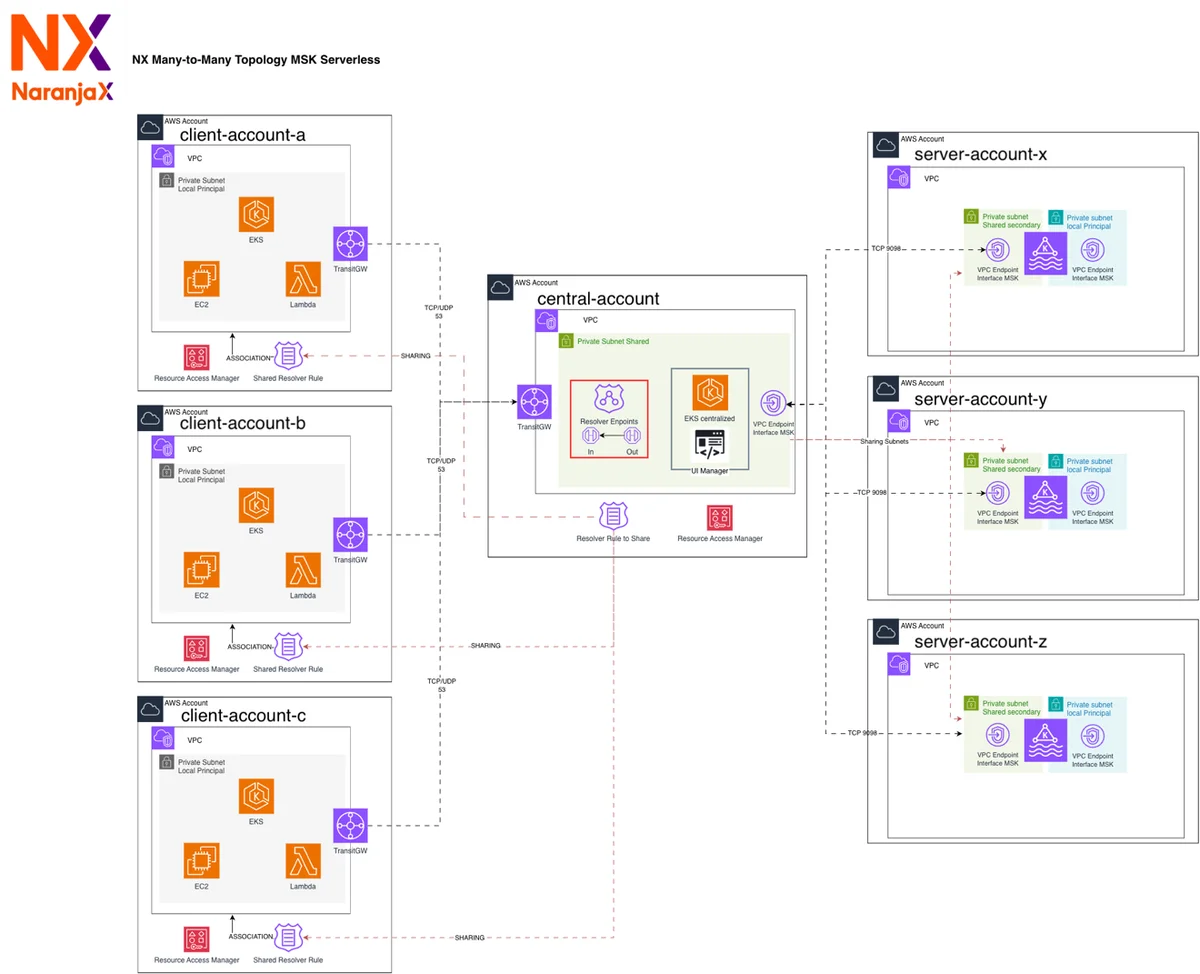
NaranjaX 通过 AWS RAM 和 Route 53,从其身份提供商(IDP)管理分布在多个账户中的多个 Amazon MSK Serverless 集群。 了解 NaranjaX 如何利用 AWS Resource Access Manager 和 Amazon Route 53 Resolver,构建跨账户、多对多连接模型以支持 Amazon MSK Serverless,从而使超过 40 个 AWS 账户中的团队能够从集中式的内部开发者平台采用事件驱动架构。 NaranjaX manages multiple Amazon MSK Serverless clusters in different accounts from their IDP using AWS RAM and Route 53 aws.amazon.com +1
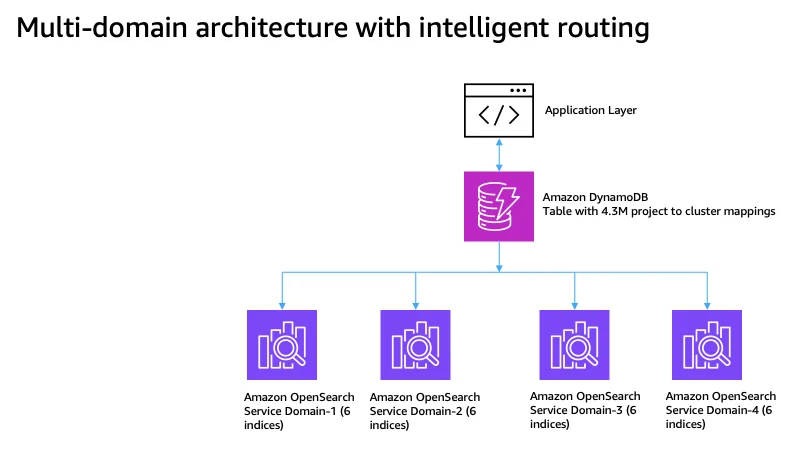
Autodesk 如何利用迁移助手和智能路由将 23 亿份文档迁移至 Amazon OpenSearch Service 本文介绍了 Autodesk 如何将单个索引的 Elasticsearch 7.1.1 域重构为四个多索引的 Amazon OpenSearch Service 域,使用 Amazon OpenSearch Service 迁移助手以及一个路由层,该路由层将每个查询定向到持有该查询所需数据的分片。 How Autodesk migrated 2.3 billion documents to Amazon OpenSearch Service using Migration Assistant and intelligent routing aws.amazon.com +1