AWS Database Blog 中文 关注 网站提供了一个Amazon Web Services(AWS)数据库博客,它旨在帮助用户高效地使用AWS数据库服务,通过提供有价值的教程、建议和常见问题解答。 AWS Database Blog aws.amazon.com RSS aws.amazon.com AWS Database Blog 中文 RSS thenote.app
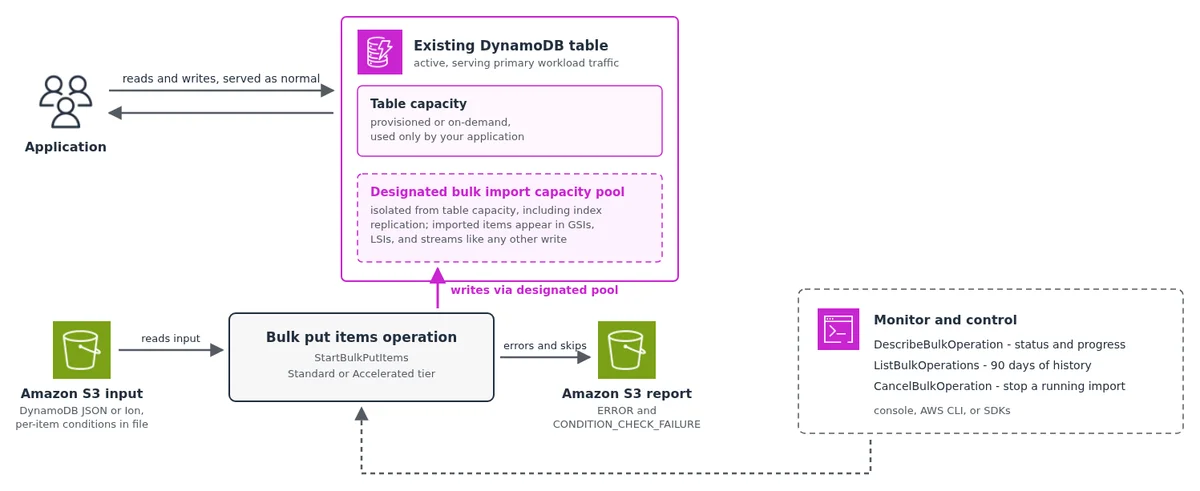
介绍 Amazon DynamoDB 的批量写入项目:从 Amazon S3 向现有表大规模加载数据 批量写入项是一项完全托管的功能,可将数据直接从 Amazon S3 加载到您现有的 Amazon DynamoDB 表中,且不会影响表的读写性能,其成本也低于按请求计费的写入操作。本文介绍该功能,演示如何从头到尾运行导入操作,并分享生产环境中的最佳实践。 Introducing bulk put items for Amazon DynamoDB: Load data from Amazon S3 into existing tables at scale aws.amazon.com +1
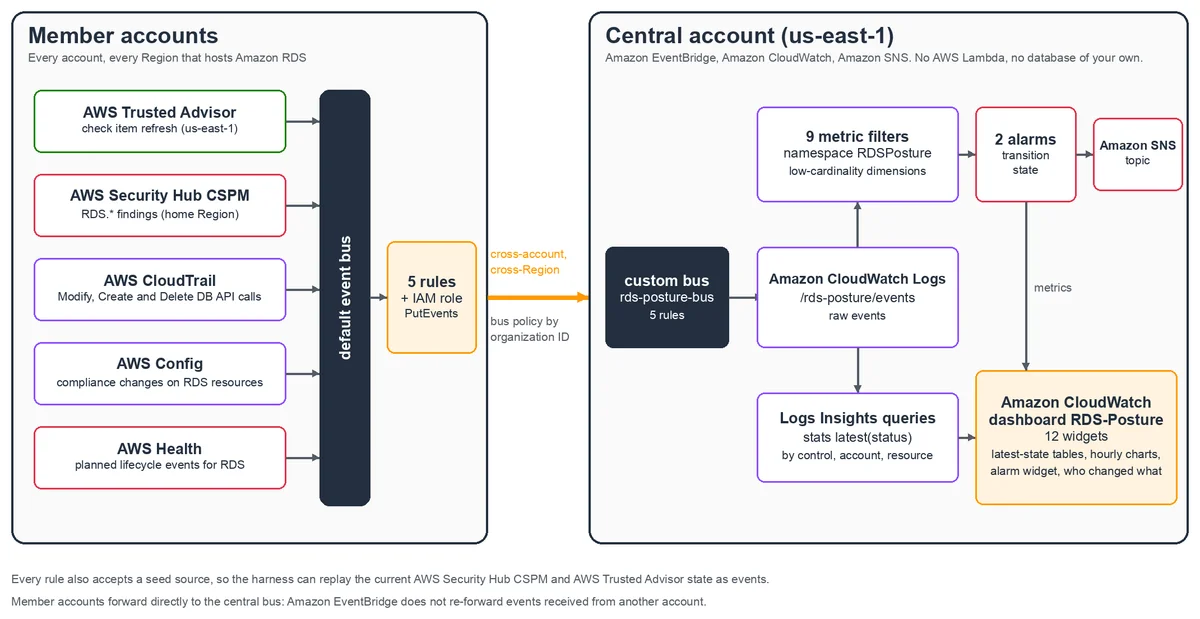
使用 Kiro 构建组织范围的 Amazon RDS 合规性仪表板 Amazon RDS 数据库的删除保护是一项可由任何人关闭的单一设置,在成百上千个账户中,并无单一位置可查看哪些数据库仍未启用该功能。本文展示如何借助 Kiro 构建并验证一个 Amazon CloudWatch 仪表板,以在全组织范围内追踪 Amazon RDS 的合规状态。 Build an organization-wide Amazon RDS posture dashboard with Kiro aws.amazon.com +1
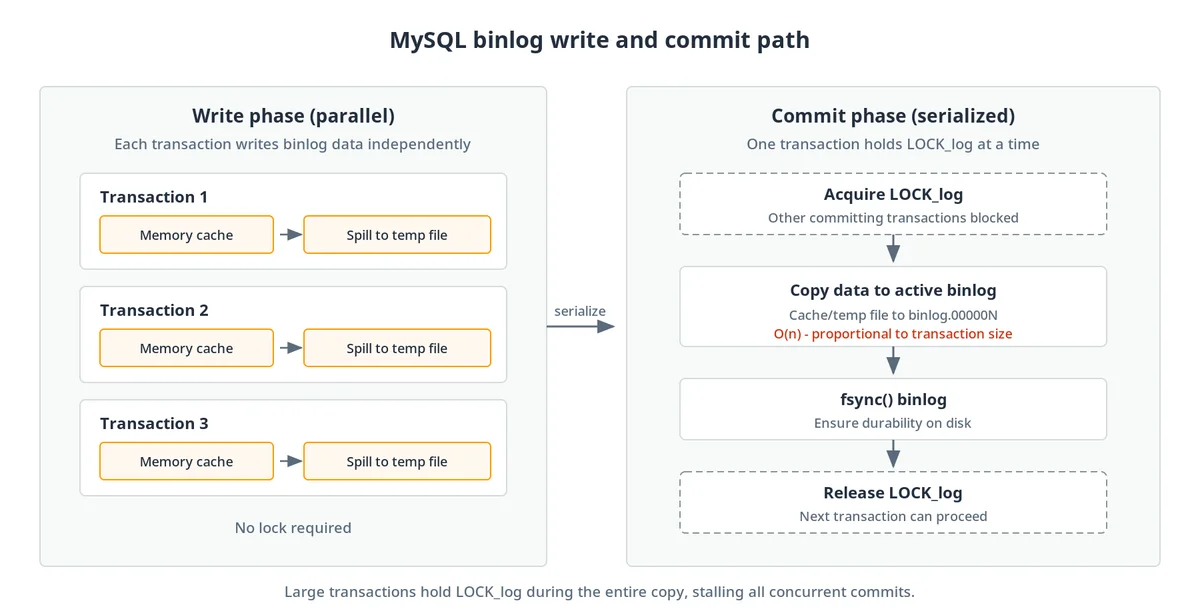
AWS 为 MySQL 贡献了大事务二进制日志优化功能 当 MySQL 提交大事务时,将其写入二进制日志可能会使服务器上的其他所有提交操作冻结数分钟。本文介绍二进制日志大事务优化(BOLT),这是 AWS 为社区版 MySQL 做出的贡献,它使提交延迟与事务大小无关,加速崩溃恢复,并提高吞吐量。 AWS contributes a large-transaction binary log optimization to MySQL aws.amazon.com +1
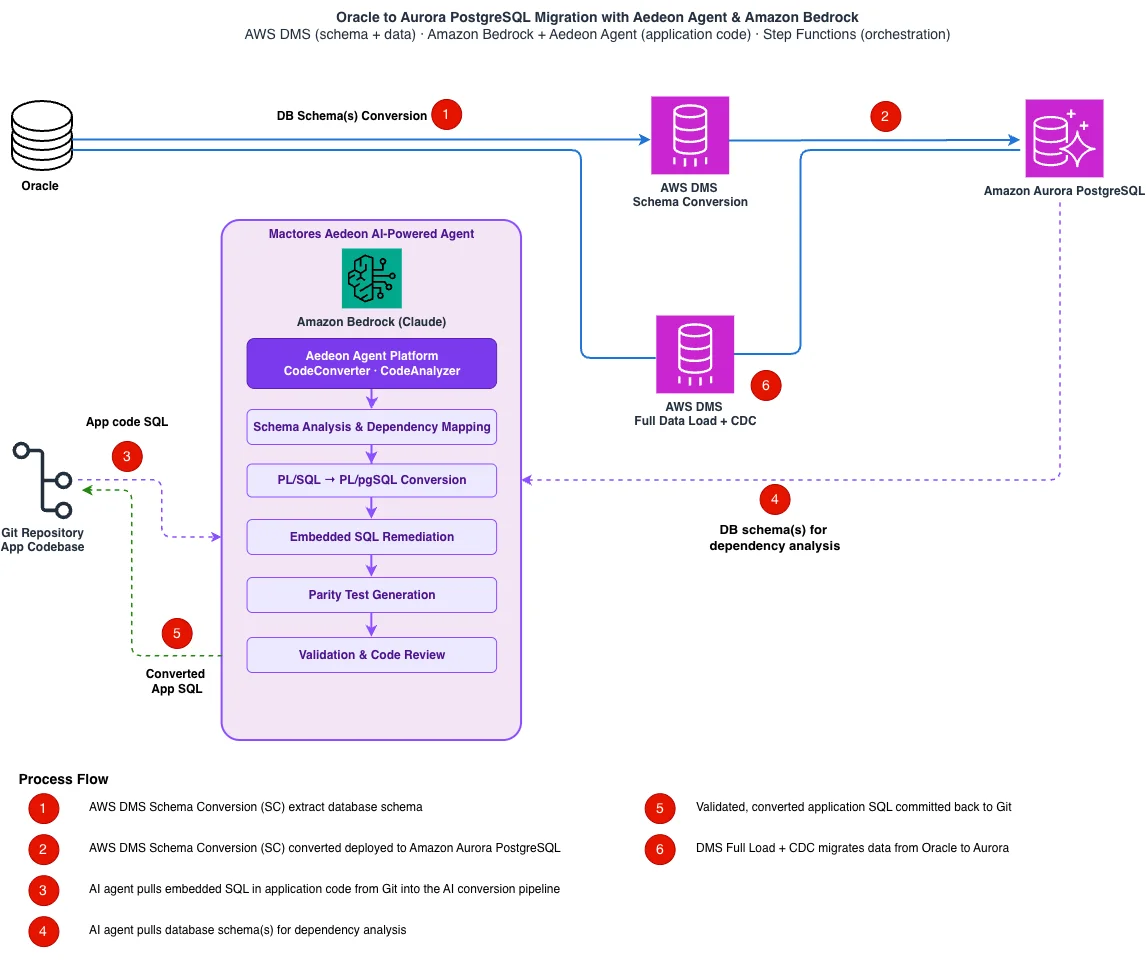
《纽约时报》将 Oracle 迁移时间从 18 个月缩短至 5 个月 了解《纽约时报》如何在约 5 个月内(而非 18 个月)将其 PLATO 订阅收入引擎从 Oracle 迁移至 Amazon Aurora PostgreSQL。该迁移采用基于 AI Agent 的方法,结合 Amazon Bedrock 与 AWS DMS,在大规模企业级场景中自动化了模式转换和多语言代码修复。 The New York Times cut Oracle migration time from 18 to 5 months aws.amazon.com +1
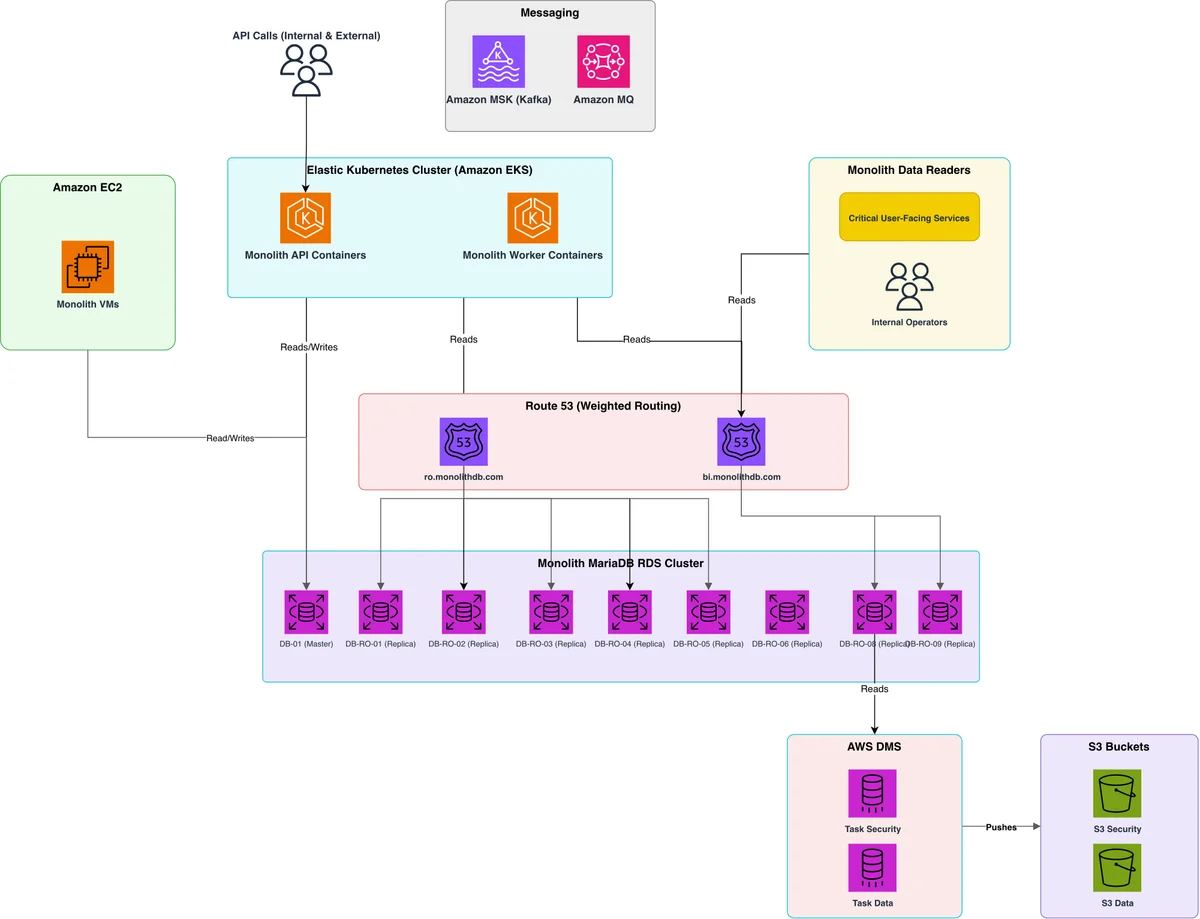
Vestiaire Collective 如何利用 Amazon RDS 蓝/绿部署实现 MariaDB 升级的近乎零停机 RDS Vestiaire Collective,一个全球性的二手奢侈品时尚平台,在将 Amazon RDS for MariaDB 集群从两个主要版本升级的过程中实现了近乎零停机。了解该团队如何利用 Amazon RDS 蓝/绿部署结合 AWS Countdown Premium,在销售旺季期间实现 94 秒和随后 7 秒的切换时间。 How Vestiaire Collective achieved near-zero downtime RDS for MariaDB upgrades with Amazon RDS Blue/Green Deployments aws.amazon.com +1
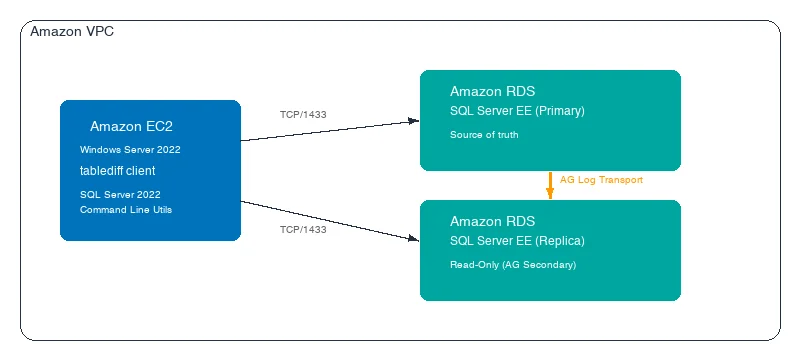
使用 tablediff 在 Amazon RDS for SQL Server 上排查数据不匹配问题 学习如何使用 SQL Server 表差异(tablediff)实用工具,在复制延迟事件后验证 Amazon RDS for SQL Server 只读副本与其主实例的一致性,检测并分类行级数据不匹配,并在提升后的副本实例上应用可审计的 T-SQL 修复脚本。 Troubleshooting Data Mismatches with tablediff on Amazon RDS for SQL Server aws.amazon.com +1
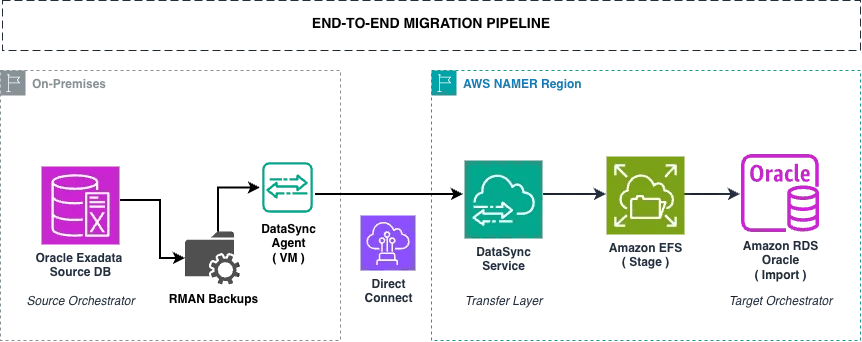
美国银行如何将 119 TB 数据从 Oracle Exadata 迁移至 Amazon RDS for Oracle 美国银行通过带宽受限的 AWS Direct Connect 链路,将 119 TB 数据迁移至四个 Oracle Exadata 数据库到 Amazon RDS for Oracle。本文介绍了他们利用 Oracle Transportable Tablespaces (XTTS)、AWS DataSync 和 Amazon EFS 构建的自动化迁移流程,在 7 天内完成了初始基线复制,且实现零数据丢失。 How U.S. Bank migrated 119 TB from Oracle Exadata to Amazon RDS for Oracle aws.amazon.com +1
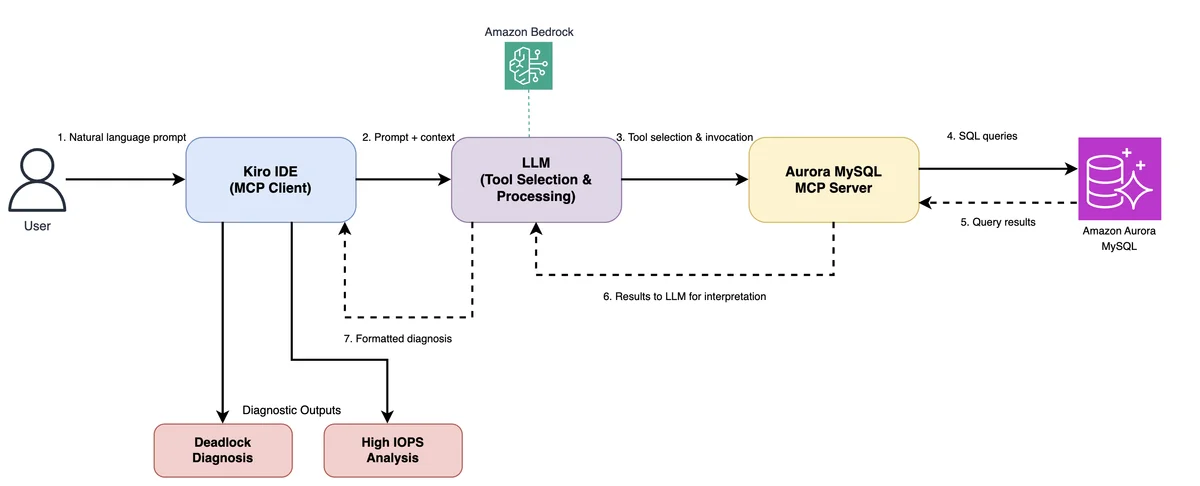
使用 Kiro IDE 和 Aurora MySQL MCP 服务器分析 Aurora MySQL 问题 学习如何使用 Kiro IDE 配合 Amazon Aurora MySQL MCP 服务器,通过自然语言提示诊断死锁和高 IOPS 事件,将原本需要数小时、依赖专家的人工调查转变为几分钟内由 AI 引导的根本原因分析。 Analyzing Aurora MySQL issues with Kiro IDE and Aurora MySQL MCP server aws.amazon.com +1
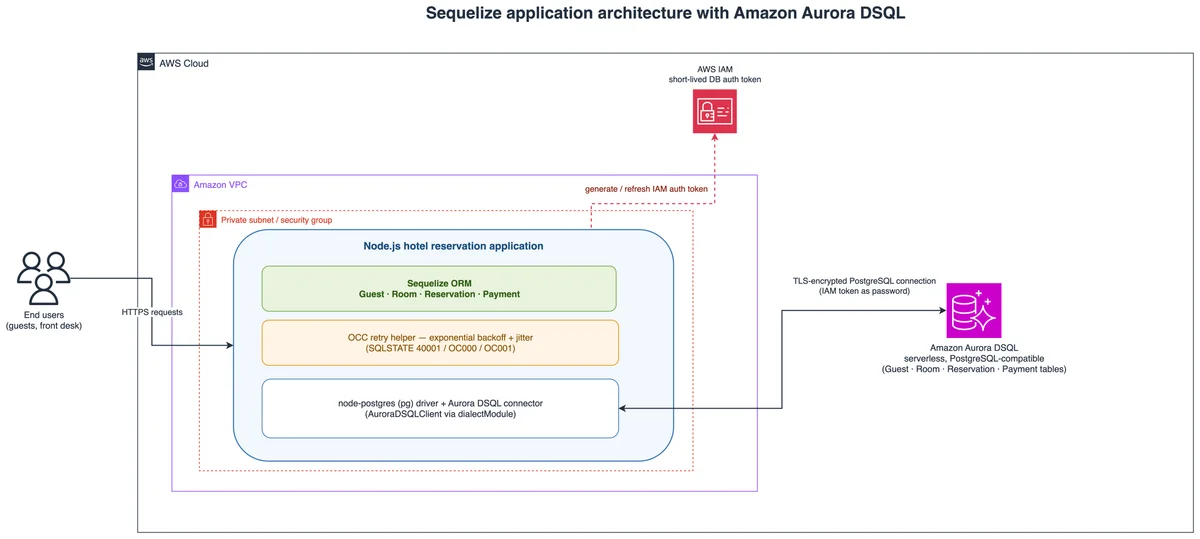
使用 Sequelize ORM 和 Amazon Aurora DSQL 构建 Node.js 应用程序 Node.js 团队只需进行少量适配,即可在 Amazon Aurora DSQL 上运行 Sequelize ORM。本文构建了一个酒店预订应用程序,展示了可复用的模式:UUID 主键、通过 Aurora DSQL 连接器实现 IAM 身份验证、独立的 DDL 执行,以及乐观并发控制的重试逻辑。 Building Node.js applications with Sequelize ORM and Amazon Aurora DSQL aws.amazon.com +1
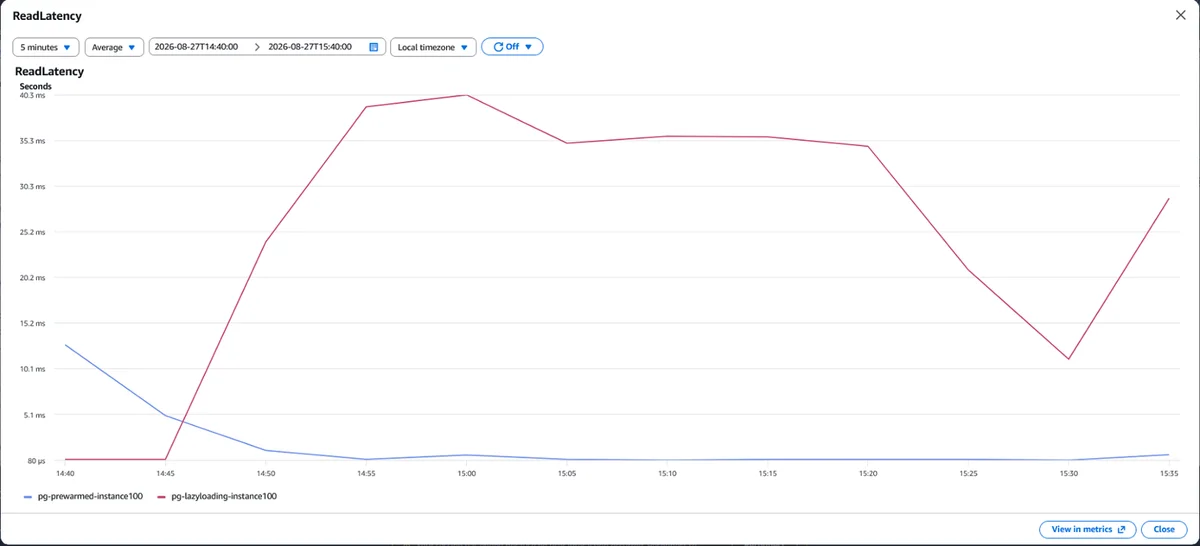
快照恢复后降低 Amazon RDS for PostgreSQL 的存储初始化影响 从快照恢复 Amazon RDS for PostgreSQL 实例时,Amazon EBS 卷会进行惰性水合,导致早期查询速度可能慢 10 至 15 倍。本文介绍 PostgreSQL 原生的预暖技术(pg_prewarm、VACUUM ANALYZE 和全表扫描)以及新的监控字段,以在恢复后更快地恢复可预测的性能。 Reducing storage initialization impact in Amazon RDS for PostgreSQL after snapshot restore aws.amazon.com +1
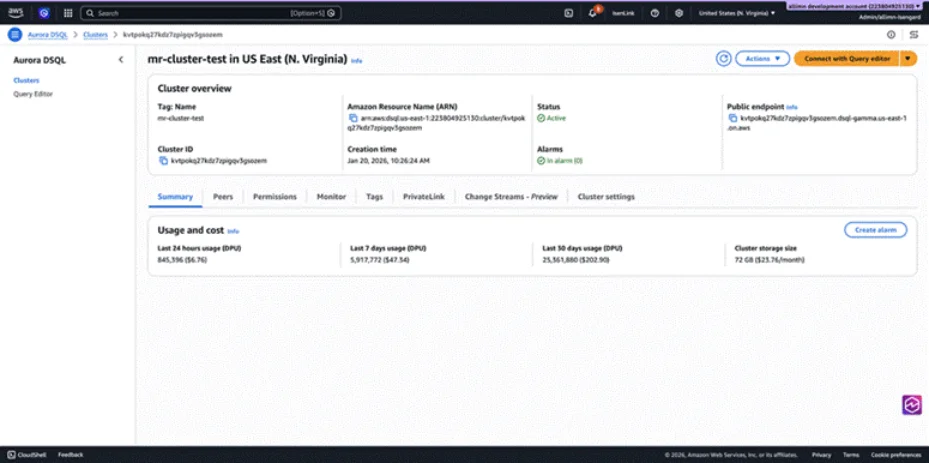
使用 Aurora DSQL 控制台和 CloudWatch 警报监控 Amazon Aurora DSQL 成本 随着您的 Amazon Aurora DSQL 工作负载扩展,DPU 消耗和存储成本可能会在没有固定实例上限的情况下持续增长。本文介绍如何使用内置的使用和成本面板监控 Aurora DSQL 的使用情况和成本,配置每小时 DPU 支出的 Amazon CloudWatch 警报,并通过 AWS CloudFormation 以代码形式部署这些警报。 Monitor Amazon Aurora DSQL costs with the Aurora DSQL console and CloudWatch alarms aws.amazon.com +1
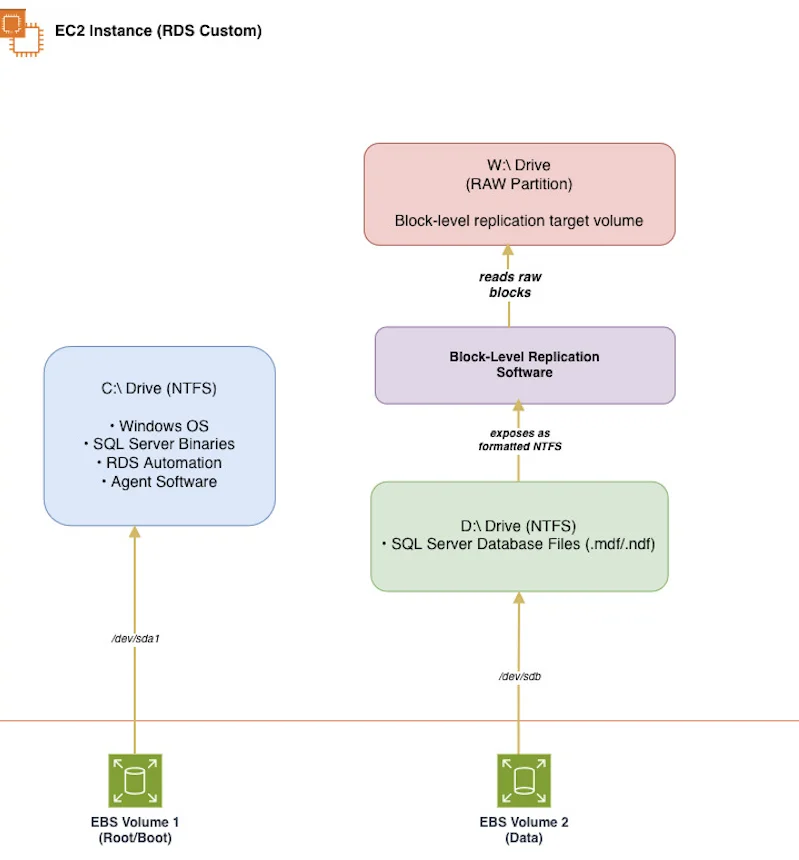
Amazon RDS Custom for SQL Server 的存储布局与最佳实践 Amazon RDS Custom for SQL Server 提供操作系统级访问权限,这也暴露了内部存储卷,其中 W: 驱动器看起来像一个原始且未初始化的磁盘。本文解释了 C:、D: 和 W: 驱动器的架构,这些驱动器如何映射到 Amazon EBS,以及能够防止您意外破坏数据的磁盘操作和安全验证检查。 Storage layout and best practices for Amazon RDS Custom for SQL Server aws.amazon.com +1
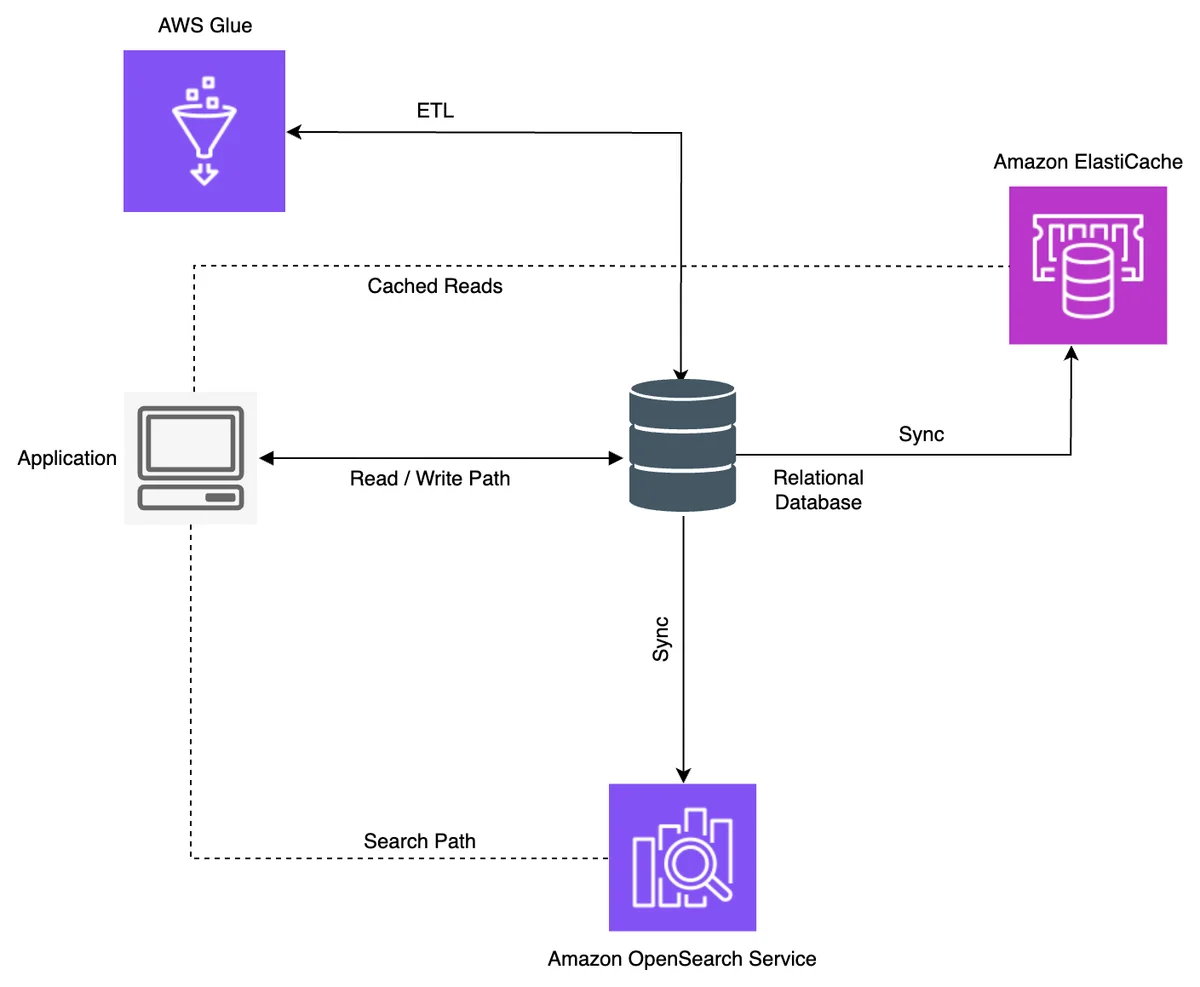
为搜索、扩展性和敏捷性而现代化文档存储 将提取的文档数据存储于关系型 JSON 或 BLOB 列中,在需要搜索和扩展之前是可行的。了解如何识别文档数据何时已超出关系型存储的承载能力,以及如何采用渐进式、低风险迁移模式,在 Amazon DocumentDB 与 Amazon DynamoDB 之间做出选择。 Modernizing document storage for search, scale, and agility aws.amazon.com +1
理解 PgBouncer 与 Amazon RDS Proxy 在 PostgreSQL 连接池方面的差异 在 AWS 上比较 Amazon RDS Proxy 与 PgBouncer 的 PostgreSQL 连接池功能。本文阐述了每种连接池器对池化模式、身份验证、故障转移和会话状态固定的处理方式,并为您提供一个框架,以在完全托管服务与自托管连接池器之间做出选择。 Understanding the differences between PgBouncer and Amazon RDS Proxy for PostgreSQL connection pooling aws.amazon.com +1
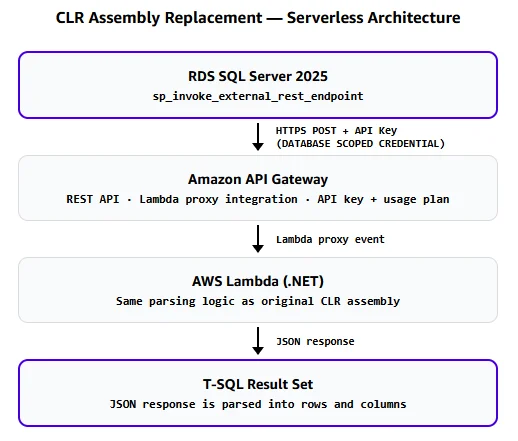
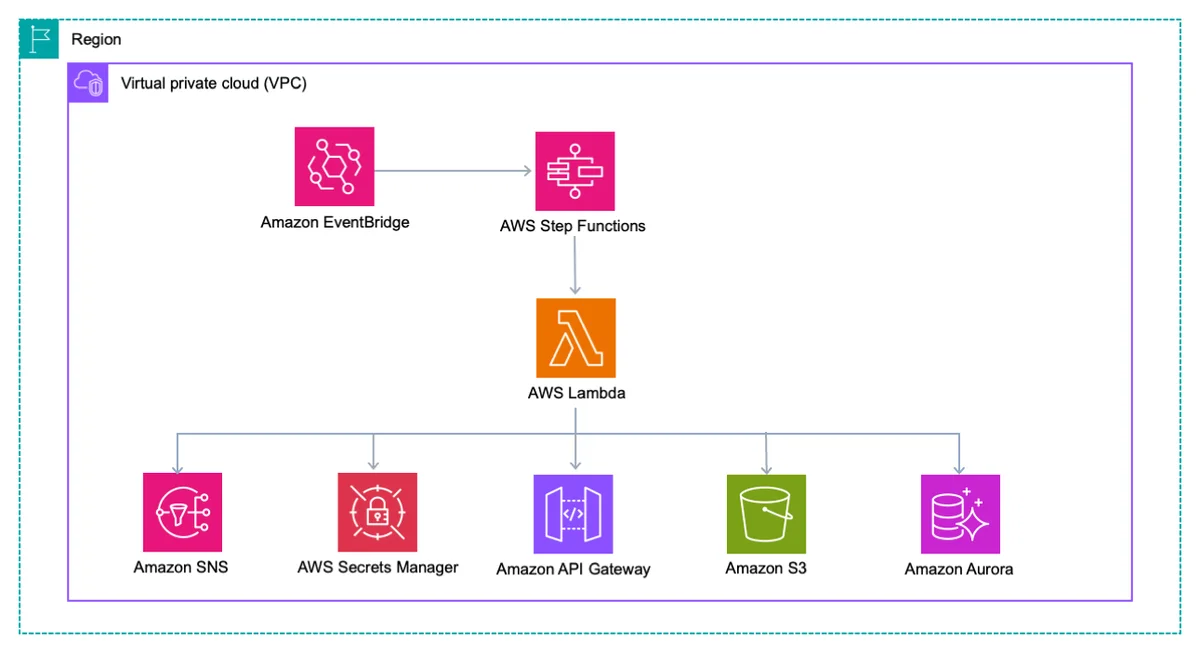
升级 Amazon RDS for SQL Server 至 2025 版时,将 CLR 代码迁移至 AWS Lambda 在将 Amazon RDS for SQL Server 升级到 2017 或更高版本后,CLR 严格安全策略会导致用户定义的 CLR 程序集无法使用。本文介绍如何将没有原生 T-SQL 等效实现的 CLR 逻辑迁移至 AWS Lambda 函数,并通过 Amazon API Gateway 中的 sp_invoke_external_rest_endpoint 由 SQL Server 2025 调用。 Migrate CLR code to AWS Lambda when upgrading Amazon RDS for SQL Server to 2025 aws.amazon.com +1
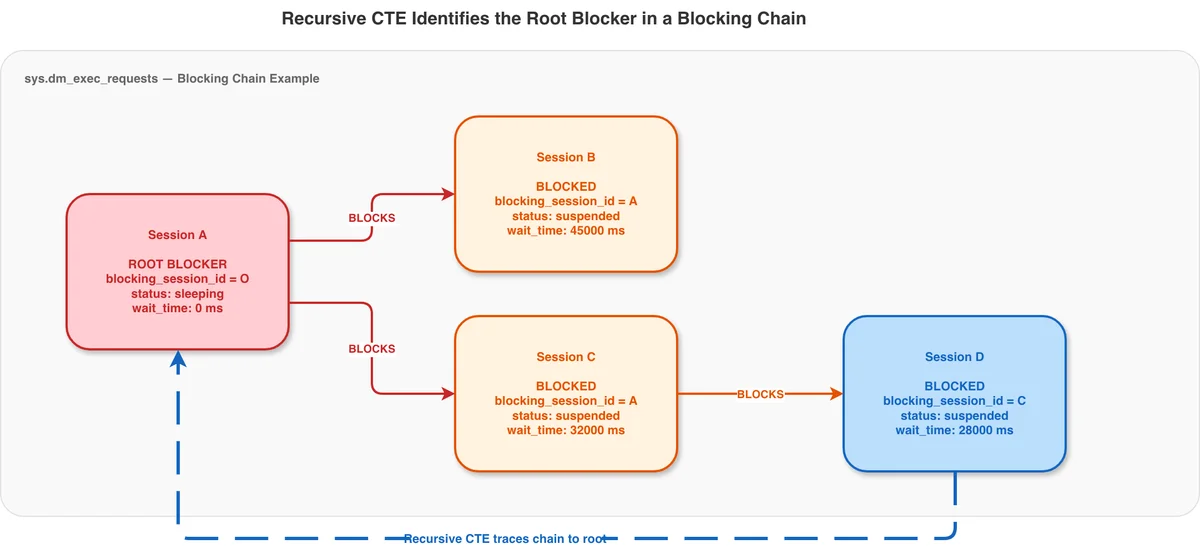
Amazon RDS for SQL Server 的自动阻断和查询警报 学习如何在 Amazon RDS for SQL Server 上构建用于阻塞链和长时间运行查询的自动化邮件警报。此无服务器解决方案利用 AWS Lambda、Amazon CloudWatch 和 Amazon SES 来检测阻塞、识别根本阻塞源,并发送 HTML 格式邮件警报,月成本约为 2.57 美元。 Automated blocking and query alerts for Amazon RDS for SQL Server aws.amazon.com +1
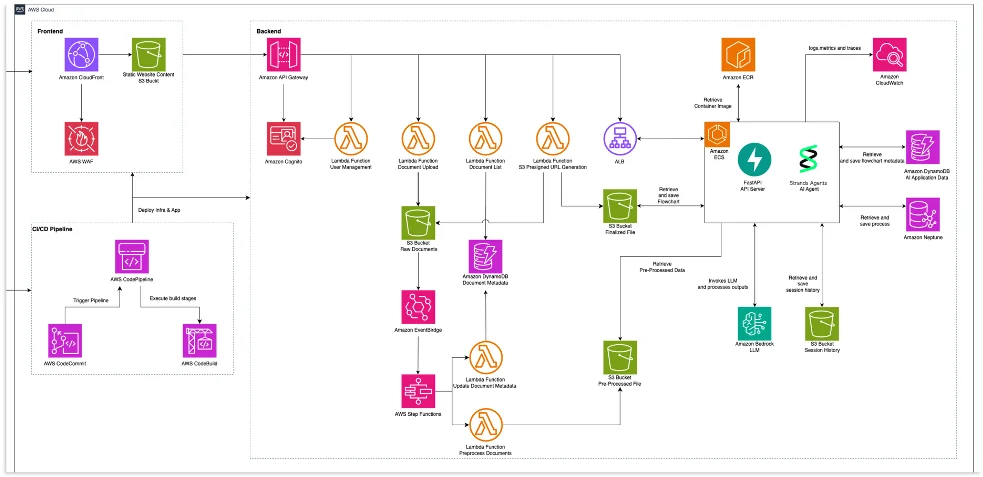
MUFG 银行如何利用基于本体的人工智能,结合 Amazon Neptune 和 Amazon Bedrock,将流程图工作减少高达 90% MUFG 银行通过在 Amazon Neptune 和 Amazon Bedrock 上构建结构化的领域模型,将生成式 AI 应用于海外后台流程,实现了约 30 个国家的标准化。其 AI 流程图应用预计可将每个分支机构流程标准化背后的系统开发工作量从 11 人天减少至 1 人天,降幅高达 90%。 How MUFG Bank aims to cut flowchart work by up to 90% with ontology-grounded AI on Amazon Neptune and Amazon Bedrock aws.amazon.com +1
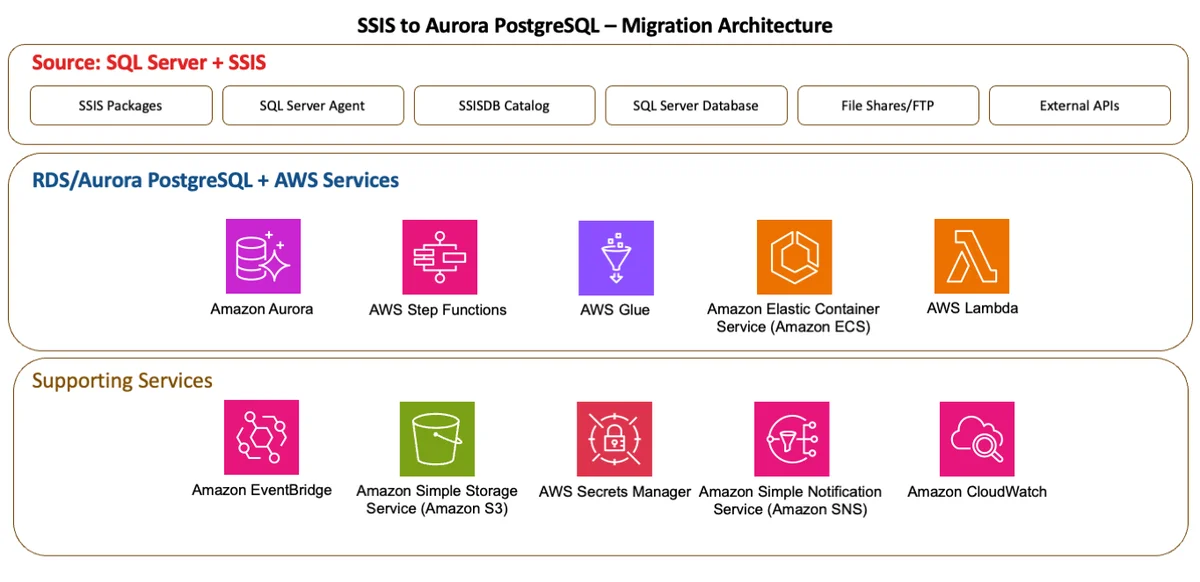
将 SSIS 包迁移到 Aurora PostgreSQL – 第二部分 将 SSIS 包迁移到 Amazon Aurora PostgreSQL 的第二部分针对复杂包展开。学习如何使用 AWS Step Functions 状态机、Map 和 Parallel 状态以及 Lambda 来替换 SSIS 控制流、ForEach 循环容器和脚本任务,并使用 Amazon EventBridge 替代 SQL Server Agent 进行调度。 Migrate SSIS packages to Aurora PostgreSQL – Part 2 aws.amazon.com +1
将 SSIS 包迁移到 Aurora PostgreSQL – 第一部分 迁移 SQL Server 集成服务 (SSIS) 包是从 SQL Server 迁移到 Amazon Aurora PostgreSQL 过程中较为复杂的部分。在本系列文章的第一部分中,您将学习如何利用原生 PostgreSQL 功能、pg_cron 以及 aws_s3 和 aws_lambda 扩展,对 SSIS 包组合进行筛选、分类和简化。 Migrate SSIS packages to Aurora PostgreSQL – Part 1 aws.amazon.com +1
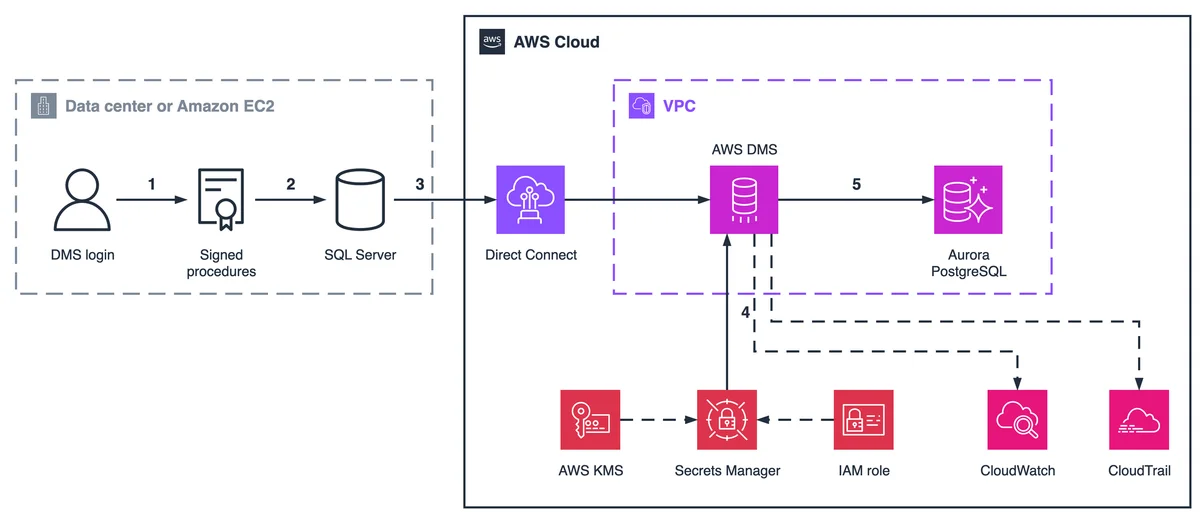
以最小权限从 SQL Server 运行 AWS DMS CDC 迁移 配置 AWS DMS 的变更数据捕获(CDC),无需授予 endpoint 登录账号 sysadmin 权限。此最小权限模式采用证书签名的包装存储过程、细粒度权限以及 AWS Secrets Manager,以满足职责分离要求,同时保留完整的 CDC 功能。 Run least-privilege AWS DMS CDC migration from SQL Server aws.amazon.com +1
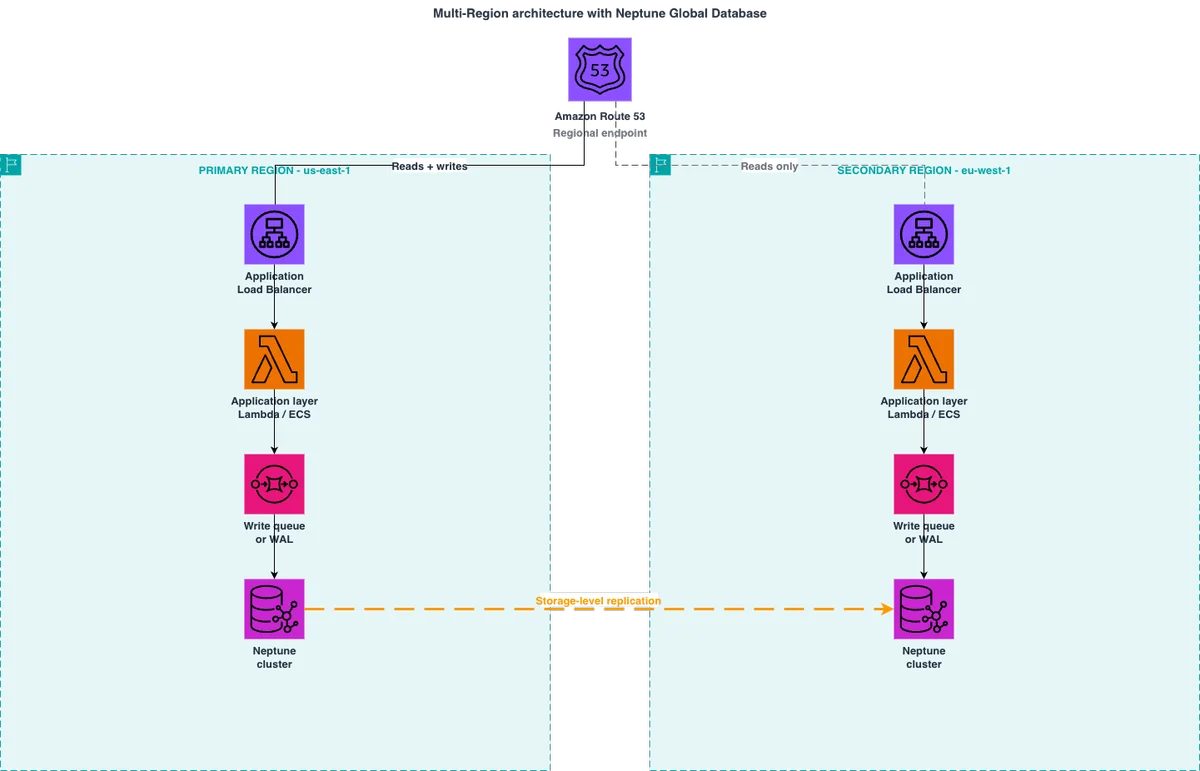
亚马逊 Neptune 可用性的决策框架 当 Amazon Neptune 工作负载需要超越单个集群的弹性时,本文提出一个决策框架,该框架根据您的恢复时间目标(RTO)、恢复点目标(RPO)和预算,将可用性目标映射到 Neptune 架构模式,涵盖多可用区(Multi-AZ)、全局数据库、预写日志和缓存等。 A decision framework for Amazon Neptune availability aws.amazon.com +1
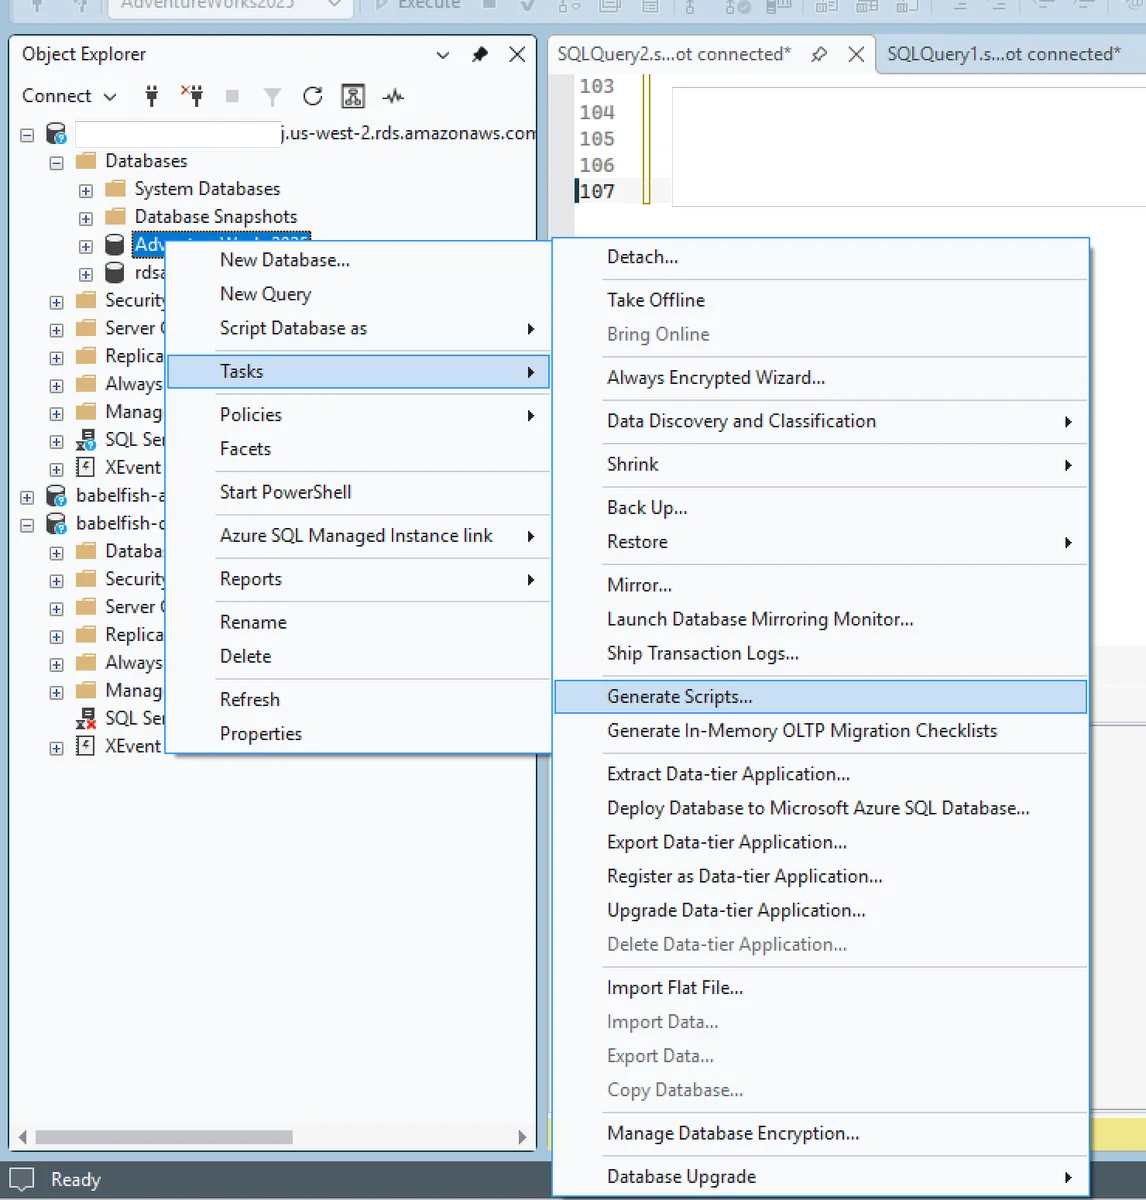
评估并将 SQL Server 全文搜索迁移至 Babelfish 以用于 Aurora PostgreSQL 将 SQL Server 全文搜索迁移到 Babelfish for Amazon Aurora PostgreSQL 是迁移过程中最具挑战性的部分之一。本文介绍了一个包含六个检查点的决策树,用于评估您的全文搜索工作负载是否可以迁移至 Babelfish,哪些内容可直接迁移,哪些需要自定义函数,以及哪些需要采用替代方案。 Assess and migrate SQL Server Full-Text Search to Babelfish for Aurora PostgreSQL aws.amazon.com +1
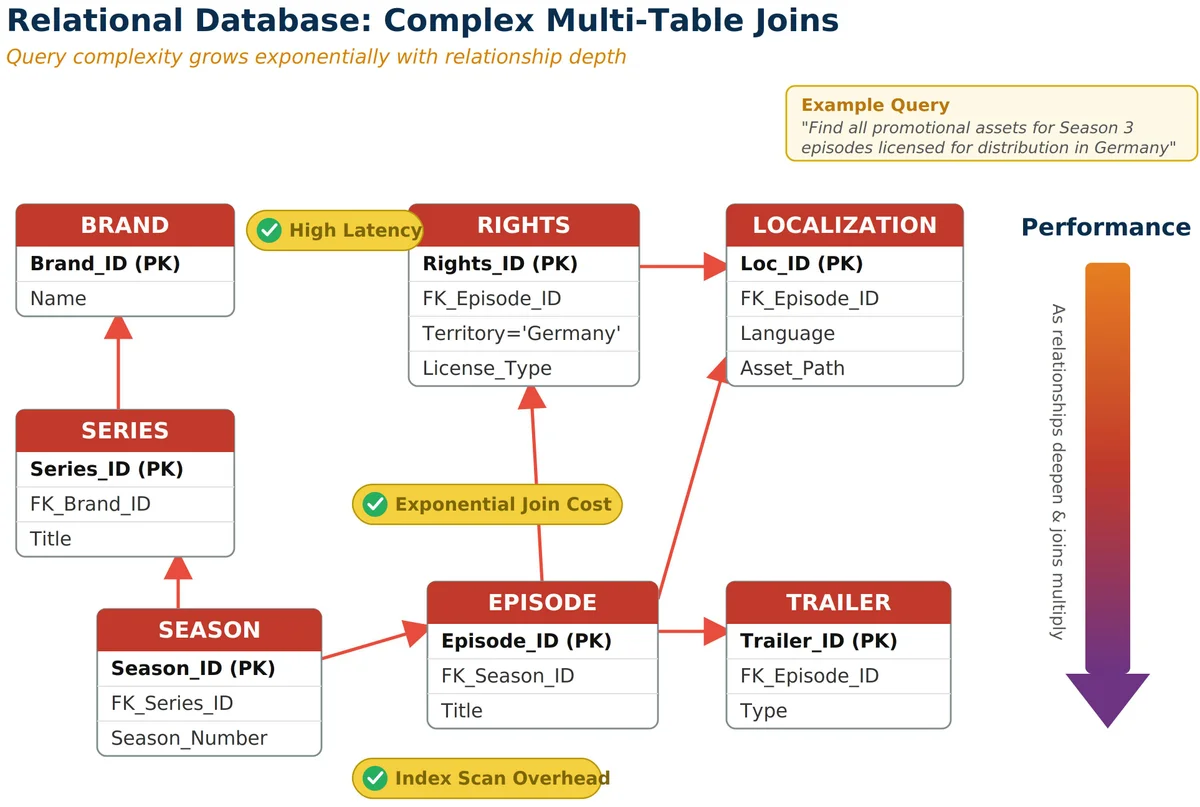
Amagi 借助 Amazon Neptune 开展智能媒体运营 Amagi 在 Amazon Neptune 上构建了全球元数据存储,以建模数十亿个相互关联的媒体元数据关系。了解其 RDF 知识图谱如何与 Amazon OpenSearch Service 及自定义空白节点同步层相结合,在 2,500 多个频道和 150 多个国家实现深度语义查询及低于 500 毫秒的事务性读取。 Amagi’s intelligent media operations with Amazon Neptune aws.amazon.com +1
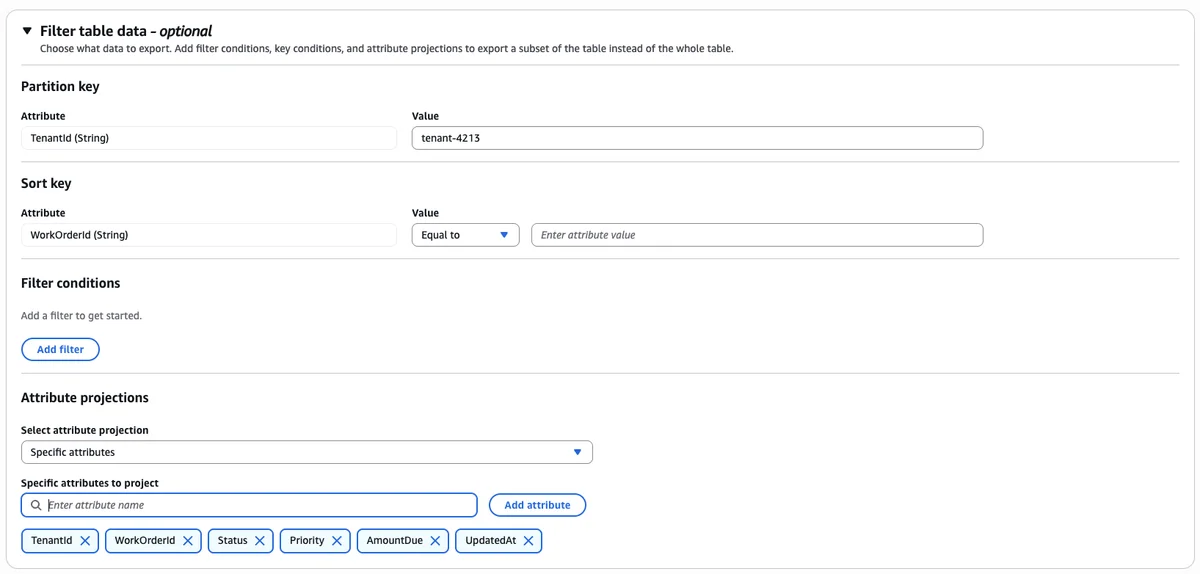
介绍从 Amazon DynamoDB 到 Amazon S3 的过滤导出功能 用于 Amazon DynamoDB 的筛选导出功能可帮助您仅将所需的项和属性导出到 Amazon S3,而无需消耗表容量。本文介绍该功能,并展示如何恢复单个租户的数据、与选定属性共享租户的历史记录,以及将租户迁移到另一个区域。 Introducing filtered export from Amazon DynamoDB to Amazon S3 aws.amazon.com +1
在 Aurora DSQL 中处理外键约束 Amazon Aurora DSQL 支持外键约束,使您能够直接在数据库中强制实施参照完整性。本文涵盖外键的定义、立即执行与延迟执行的对比、向现有表添加约束,以及乐观并发控制如何在分布式工作负载中解决冲突。 Working with foreign key constraints in Aurora DSQL aws.amazon.com +1
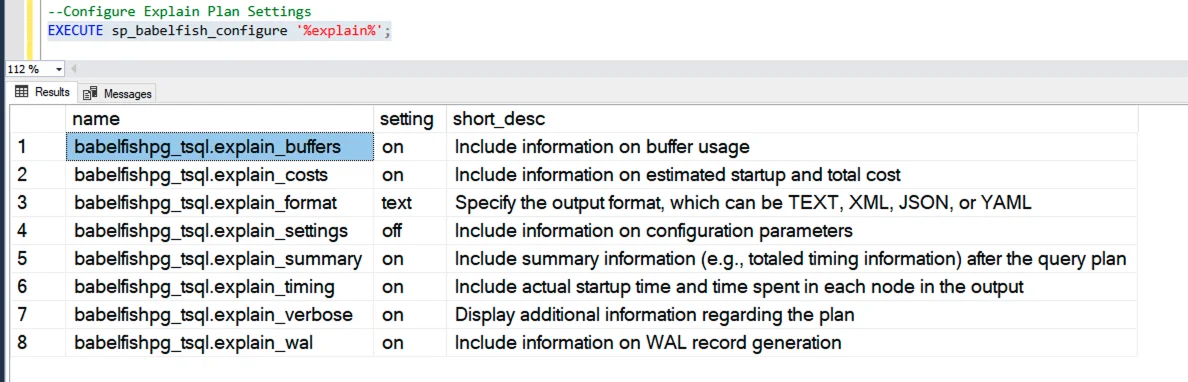
Babelfish 用于 Aurora PostgreSQL 性能调优” 在本文中,我们将展示如何通过监控、查询优化、参数调优和持续维护来调优 Babelfish 的性能。 Babelfish for Aurora PostgreSQL performance tuning aws.amazon.com +1
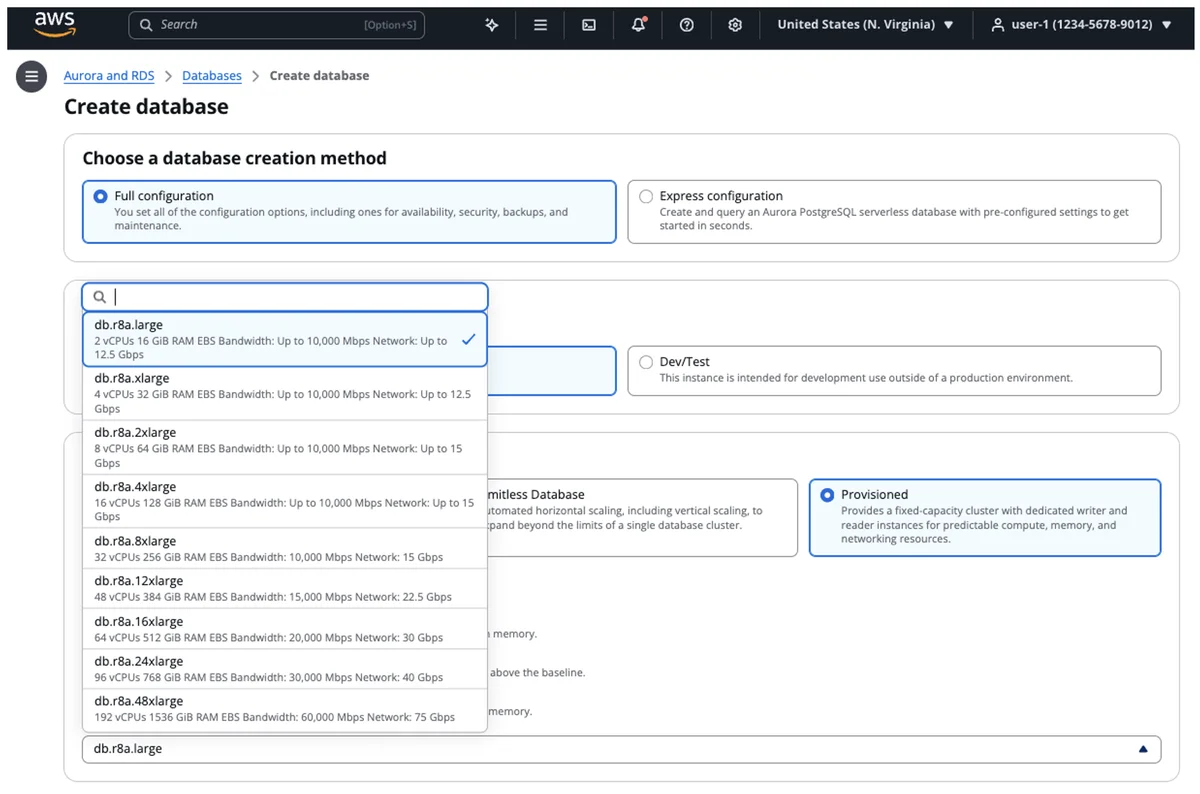
AWS 与 AMD 携手将第五代 AMD EPYC 处理器引入 Amazon Aurora 和 Amazon RDS AWS 今日宣布,基于 AMD 的 R8a 和 M8a 数据库实例已在 Amazon Aurora 和 Amazon RDS 上正式推出,其动力源自第五代 AMD EPYC 处理器。R8a 是一款内存优化型实例家族,可在 Aurora 和 RDS 上使用。M8a 是一款通用型实例家族,可在 RDS 上使用。 AWS and AMD bring 5th generation AMD EPYC processors to Amazon Aurora and Amazon RDS aws.amazon.com +1
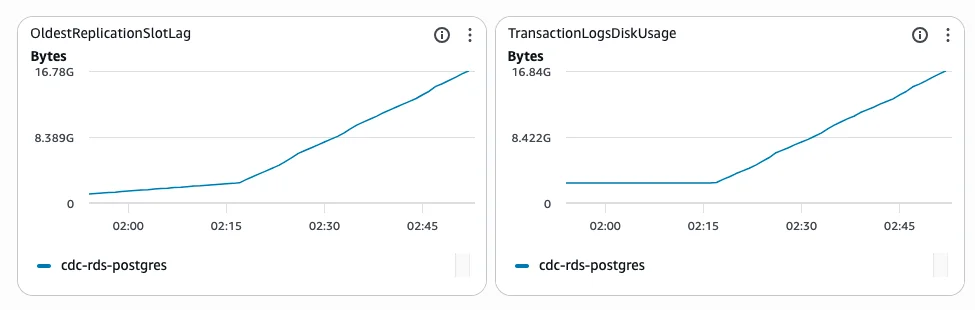
使用心跳表解决变更数据捕获场景中的 PostgreSQL 复制延迟 在变更数据捕获(CDC)迁移过程中,复制延迟可能令人费解:源端繁忙,但复制却落后,且 WAL 文件堆积。本文介绍如何使用 AWS DMS 或 Debezium 通过心跳表解决 PostgreSQL 复制延迟问题,并借助 Amazon CloudWatch 和 SQL 诊断监控复制槽的健康状况。 Resolving PostgreSQL replication lag with heartbeat tables in change data capture scenarios aws.amazon.com +1
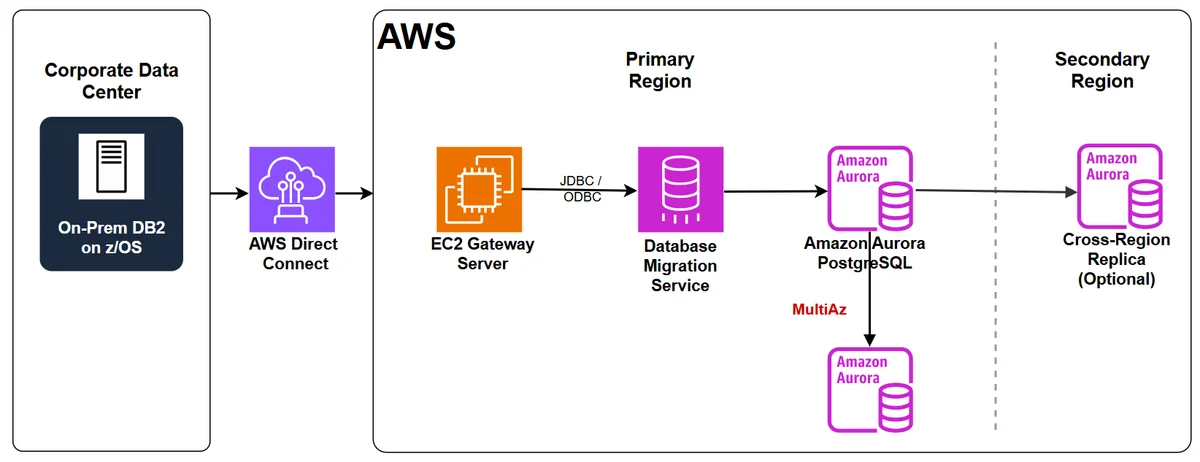
使用 AWS DMS 和网关服务器将 Db2 z/OS 迁移至 Amazon Aurora PostgreSQL 学习如何使用 AWS DMS 和 Amazon EC2 上的 Db2 网关服务器,将本地 z/OS 上的 IBM Db2 数据库迁移并复制到 Amazon Aurora PostgreSQL。本文涵盖配置网关、创建 DMS 资源、执行包含周期性全量刷新的全量加载,以及验证迁移。 Migrate Db2 z/OS to Amazon Aurora PostgreSQL using AWS DMS and gateway server aws.amazon.com +1
MySQL 引擎升级后查询计划回退的解决 在升级 Amazon Aurora MySQL 或 Amazon RDS for MySQL 的主要版本或次要版本后,部分查询的性能会出现回退,这是因为优化器的成本模型、默认设置和执行策略发生了变化。本文介绍了一套诊断工作流程,用于追踪每次性能回退所对应的具体版本变更,并应用正确的修复方案。 Resolving query plan regressions after a MySQL engine upgrade aws.amazon.com +1
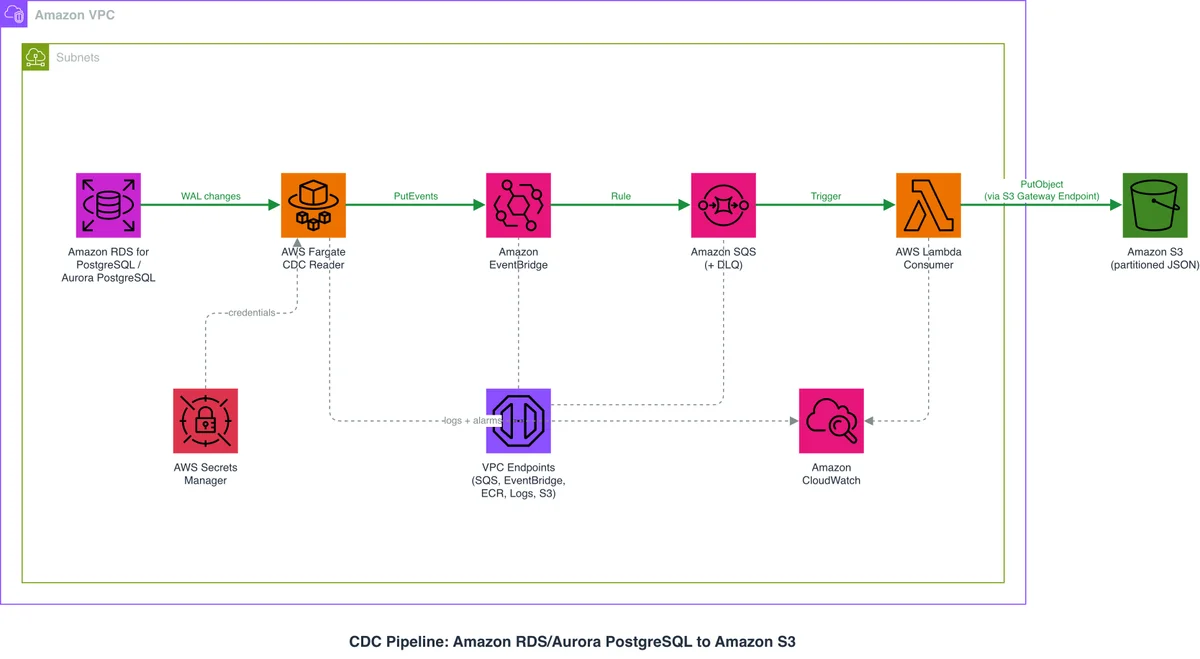
如何使用 AWS Fargate 将 PostgreSQL 变更流式传输到 Amazon S3 在这篇文章中,我们将向您展示如何构建一个全托管、事件驱动的变更数据捕获(CDC)管道。它能以近乎实时的方式,将Amazon RDS for PostgreSQL或Amazon Aurora PostgreSQL的行级变更流式传输到Amazon S3。您可以使用单个AWS CloudFormation模板部署整个管道,并且它可以在没有互联网网关的私有子网中运行,而无需将资源暴露给公共互联网。 How to stream PostgreSQL changes to Amazon S3 with AWS Fargate aws.amazon.com +1
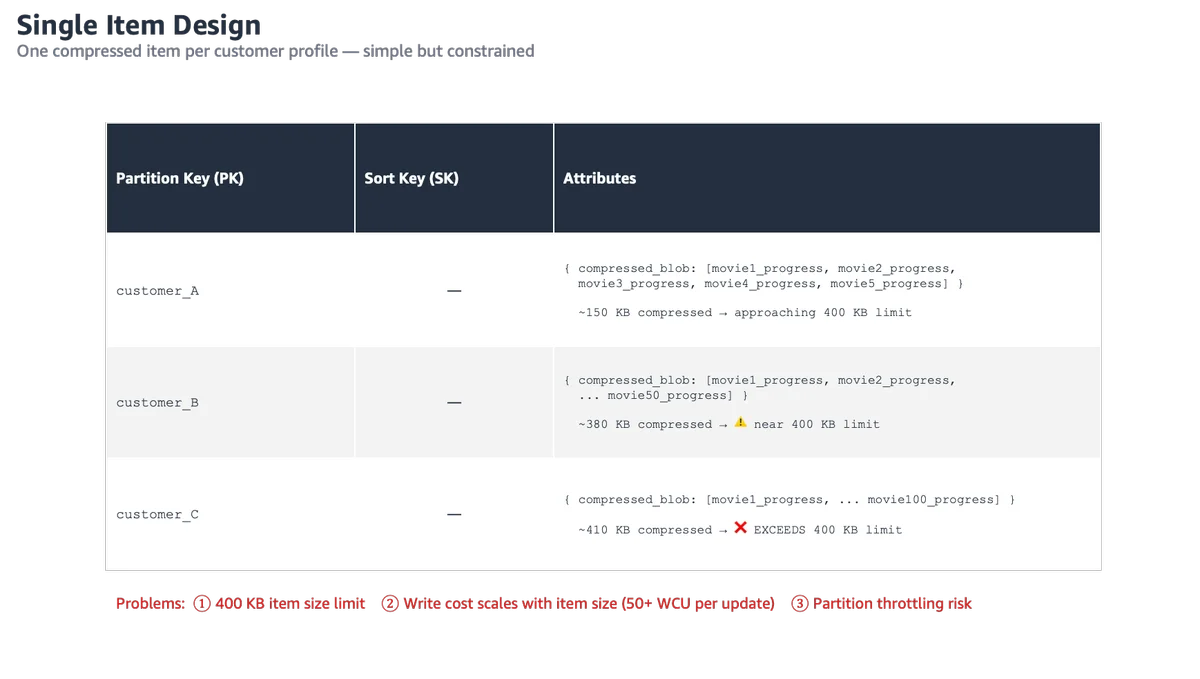
毫秒级兆字节:FireTV 如何利用并行查询和垂直分区在 Amazon DynamoDB 中服务数百万客户 亚马逊 FireTV 如何在 Amazon DynamoDB 中重构“继续观看”的观看进度数据模型:通过垂直分区和以哈希值前缀的排序键实现并行读取,消除项目大小限制,将写入成本降低 97%,并确保在任何用户画像规模下读取延迟始终低于 50 毫秒。 Megabytes in milliseconds: How FireTV uses parallel queries and vertical partitioning to serve millions of customers in Amazon DynamoDB aws.amazon.com +1
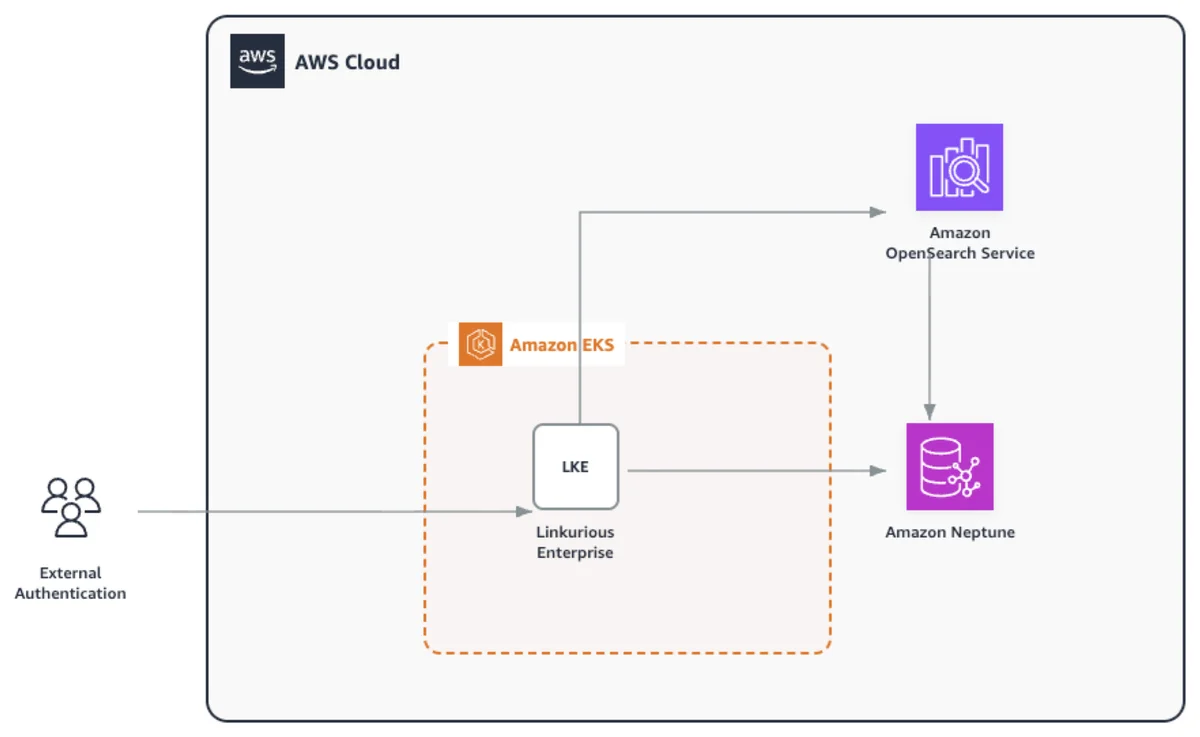
使用 Amazon Neptune 和 Linkurious Enterprise 进行直观的风险调查 了解如何配置 Linkurious Enterprise 以连接 Amazon Neptune,为业务用户提供直观且无需编码的图探索功能,用于风险调查。内容涵盖从使用 Amazon OpenSearch Service 进行设置和全文搜索,到调查最终受益人以符合反洗钱(AML)合规要求的全过程。 Intuitive risk investigation with Amazon Neptune and Linkurious Enterprise aws.amazon.com +1
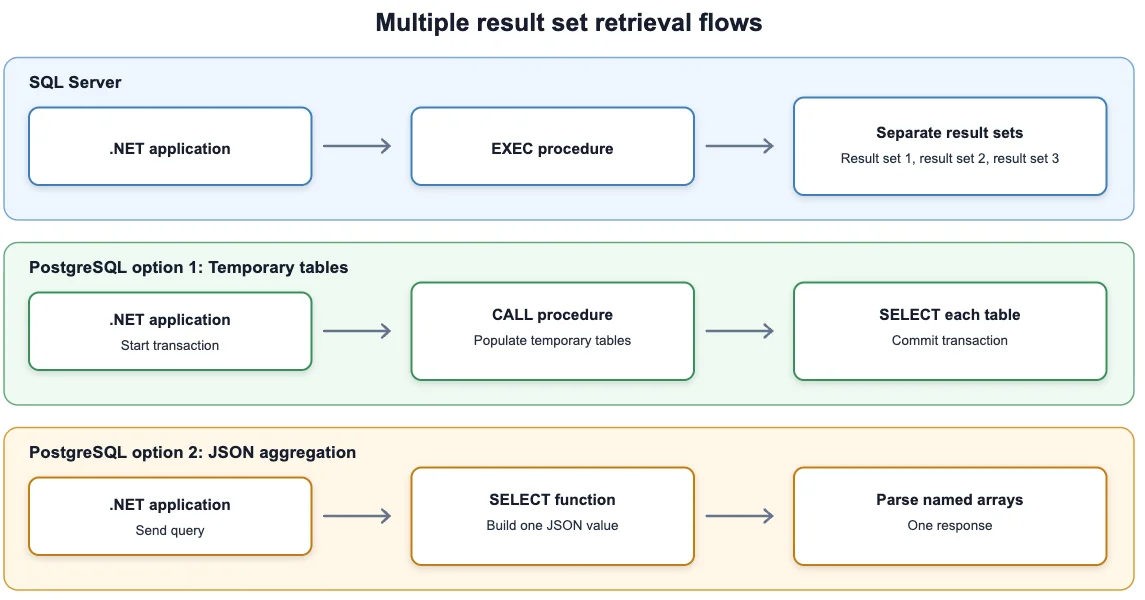
将 SQL Server 多结果集过程迁移到 PostgreSQL SQL Server 存储过程可以从一次调用中返回多个结果集,但 PostgreSQL 无法做到。本文介绍了两种原生的 PostgreSQL 替代方案,分别对应游标、会话作用域临时表和 JSON 聚合,将其与游标基线进行对比,并展示了如何在 .NET 和 Npgsql 中实现及验证每种方案。 Migrate SQL Server multi-result-set procedures to PostgreSQL aws.amazon.com +1
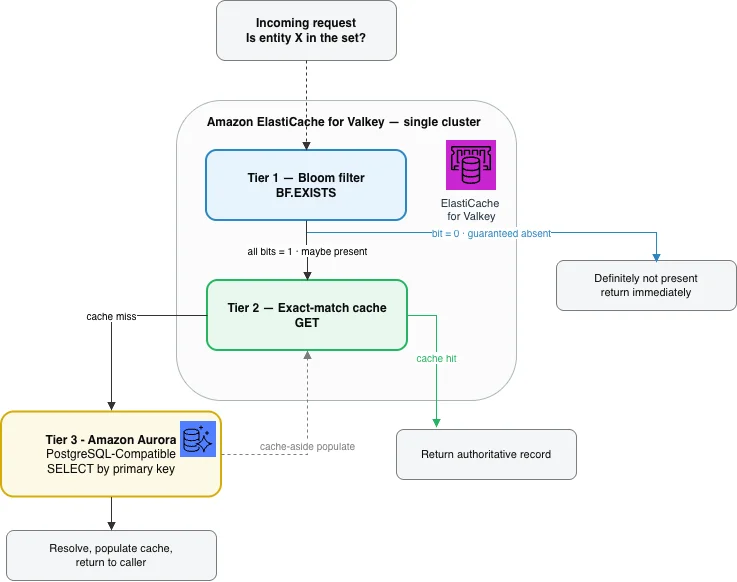
使用 Amazon ElastiCache for Valkey 和 Amazon Aurora PostgreSQL 实现安全正确的 Bloom filter 查找 本文展示了如何将 Bloom 过滤器与精确匹配缓存及关系型事实源组合,构建一个三层、具备正确性保障的成员资格查找机制,利用 Amazon ElastiCache for Valkey 和 Amazon Aurora PostgreSQL,在峰值吞吐量下实现亚毫秒级决策,且无假阳性风险。 Implement a correctness-safe Bloom filter lookup with Amazon ElastiCache for Valkey and Amazon Aurora PostgreSQL aws.amazon.com +1
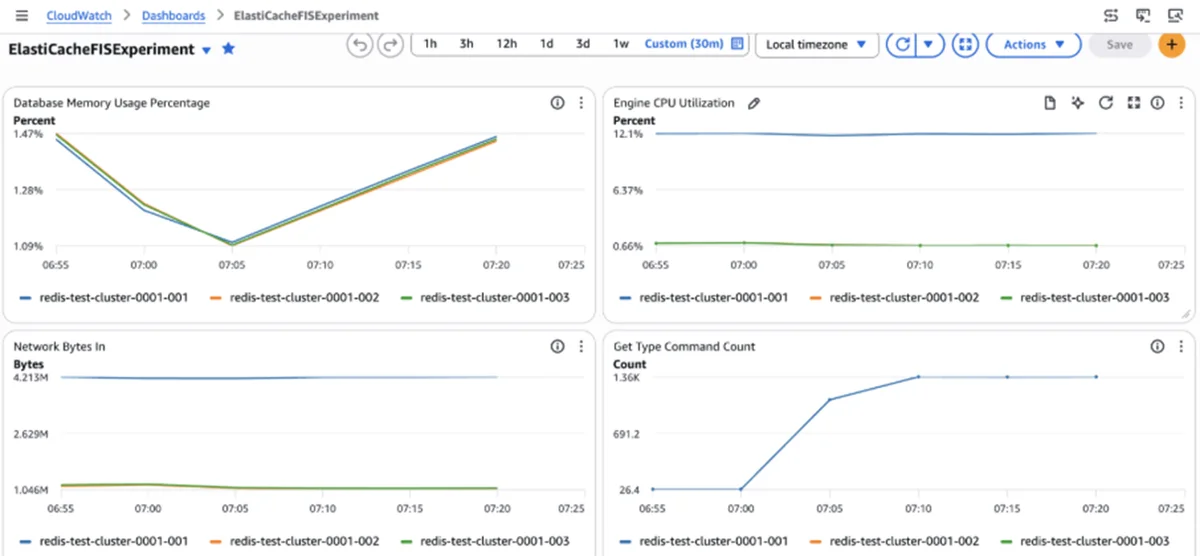
Intuit 和 AWS 如何利用 AWS 故障注入服务系统性地提升 ElastiCache 的弹性 了解 Intuit 和 AWS 如何利用 AWS 故障注入服务(AWS Fault Injection Service)在真实可用区受损场景下验证 Amazon ElastiCache 的弹性,将恢复时间从超过 50 分钟缩短至 2 分钟以内,无需人工干预,并将客户影响降至近乎为零。 How Intuit and AWS systematically improved resiliency on ElastiCache using AWS Fault Injection Service aws.amazon.com +1
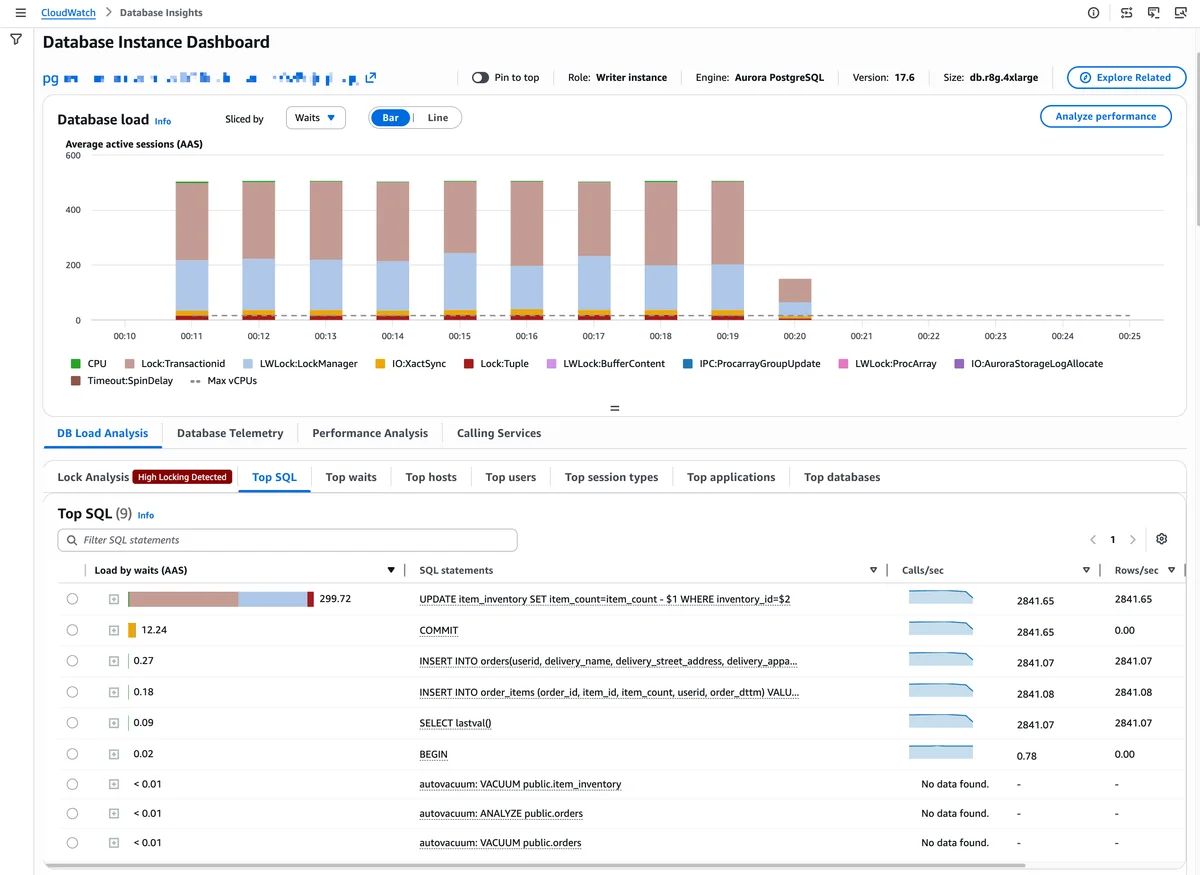
使用数据库洞察解决 Amazon Aurora PostgreSQL 锁竞争:第二部分 第一部分展示了行锁争用如何降低 Amazon Aurora PostgreSQL 的吞吐量。在第二部分中,使用 Amazon CloudWatch Database Insights 及其锁树(Lock Tree)来定位阻塞会话,然后通过查询终止、超时参数以及 SKIP LOCKED 和行拆分等架构模式来解决争用,从而恢复吞吐量。 Resolve Amazon Aurora PostgreSQL lock contention with Database Insights: Part 2 aws.amazon.com +1
在 Amazon Aurora PostgreSQL 中排查行锁争用:第一部分——理解 PostgreSQL 中的行锁争用 行锁争用即使在 CPU 和 I/O 表现健康时,仍可能导致闪购期间数据库吞吐量下降。在本系列文章第一部分中,我们将了解 PostgreSQL 的行锁机制,并学习如何使用系统视图、pgrowlocks 扩展以及 log_lock_waits 参数来监控 Amazon Aurora PostgreSQL 和 Amazon RDS for PostgreSQL 中的锁争用情况。 Troubleshooting row lock contention in Amazon Aurora PostgreSQL: Part 1 – Understanding row lock contention in PostgreSQL aws.amazon.com +1
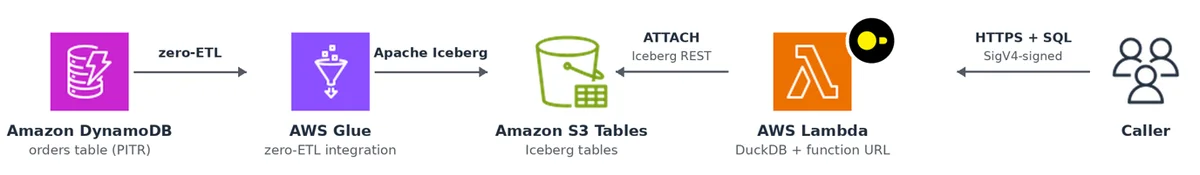
使用零 ETL 在您的 Amazon DynamoDB 数据上运行 DuckDB 分析 使用 DuckDB 对您的 Amazon DynamoDB 数据执行临时 SQL 分析。零 ETL 集成将您的表复制到 Amazon S3 Tables 上的 Apache Iceberg 表,并通过由 IAM 授权的功能 URL 运行 DuckDB 的 AWS Lambda 函数来提供 SQL 查询服务。 Run DuckDB analytics on your Amazon DynamoDB data with zero-ETL aws.amazon.com +1
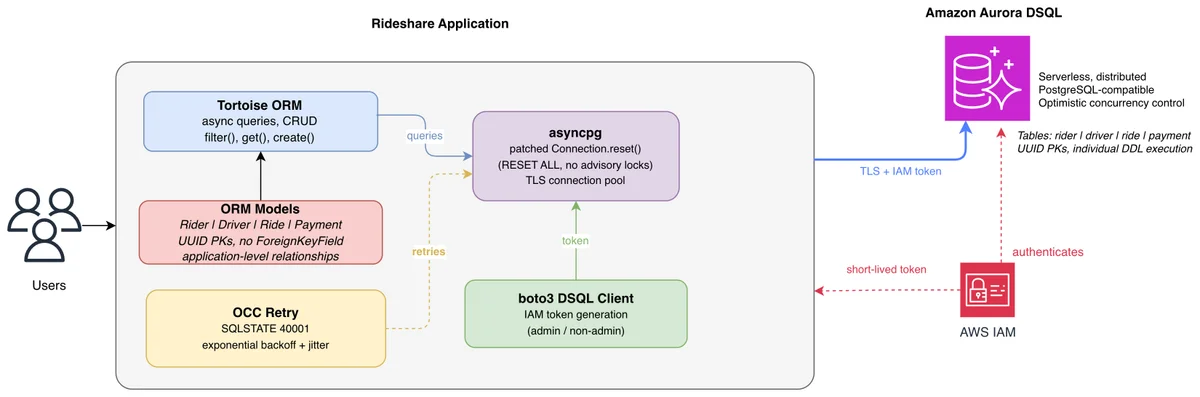
使用 Tortoise ORM 和 Amazon Aurora DSQL 构建异步 Python 应用程序 构建一个高并发异步 Python 拼车应用,采用 Tortoise ORM 和 Amazon Aurora DSQL。本文介绍关键适配方案:UUID 主键、基于 IAM 认证的 asyncpg 连接及连接池补丁、独立 DDL 执行,以及乐观并发控制(OCC)重试逻辑。 Building async Python applications with Tortoise ORM and Amazon Aurora DSQL aws.amazon.com +1
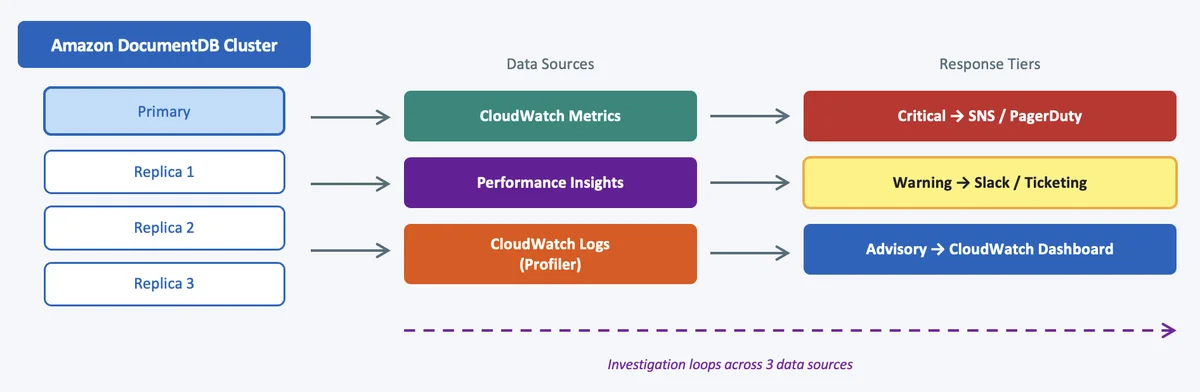
从噪声到信号:像专业人士一样监控 Amazon DocumentDB 学习如何为 Amazon DocumentDB 构建分层告警策略:通过将 CloudWatch 指标划分为关键、警告和建议三个层级,通过三种互补视角诊断慢查询,并在其演变为集群级事件之前监控垃圾回收健康状况。 From noise to signal: Monitoring Amazon DocumentDB like a pro aws.amazon.com +1
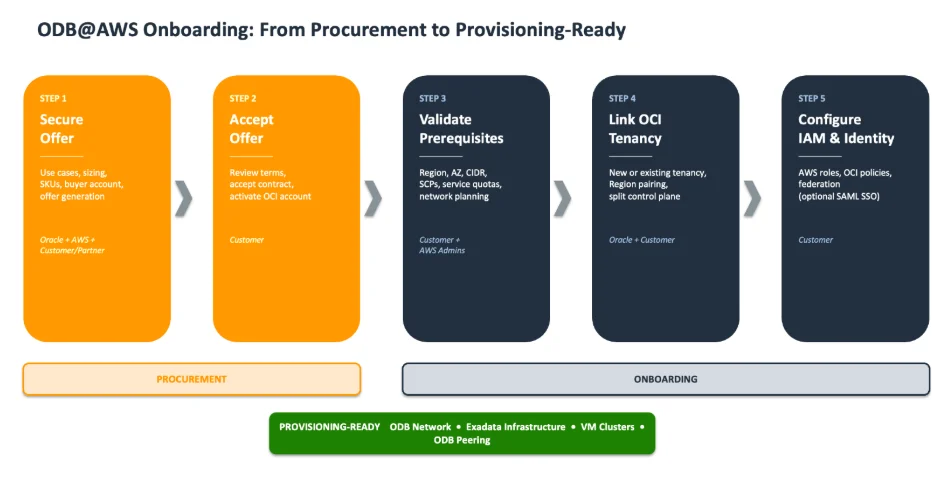
开始使用 Oracle Database@AWS:完整入职指南 《Oracle Database@AWS 实用分步指南》。本书涵盖从获取 AWS Marketplace 服务到验证先决条件、链接 OCI 租户以及配置 IAM 的五个采购与入职步骤,助您从购买阶段过渡到可配置就绪的环境。 Getting started with Oracle Database@AWS: A complete onboarding guide aws.amazon.com +1
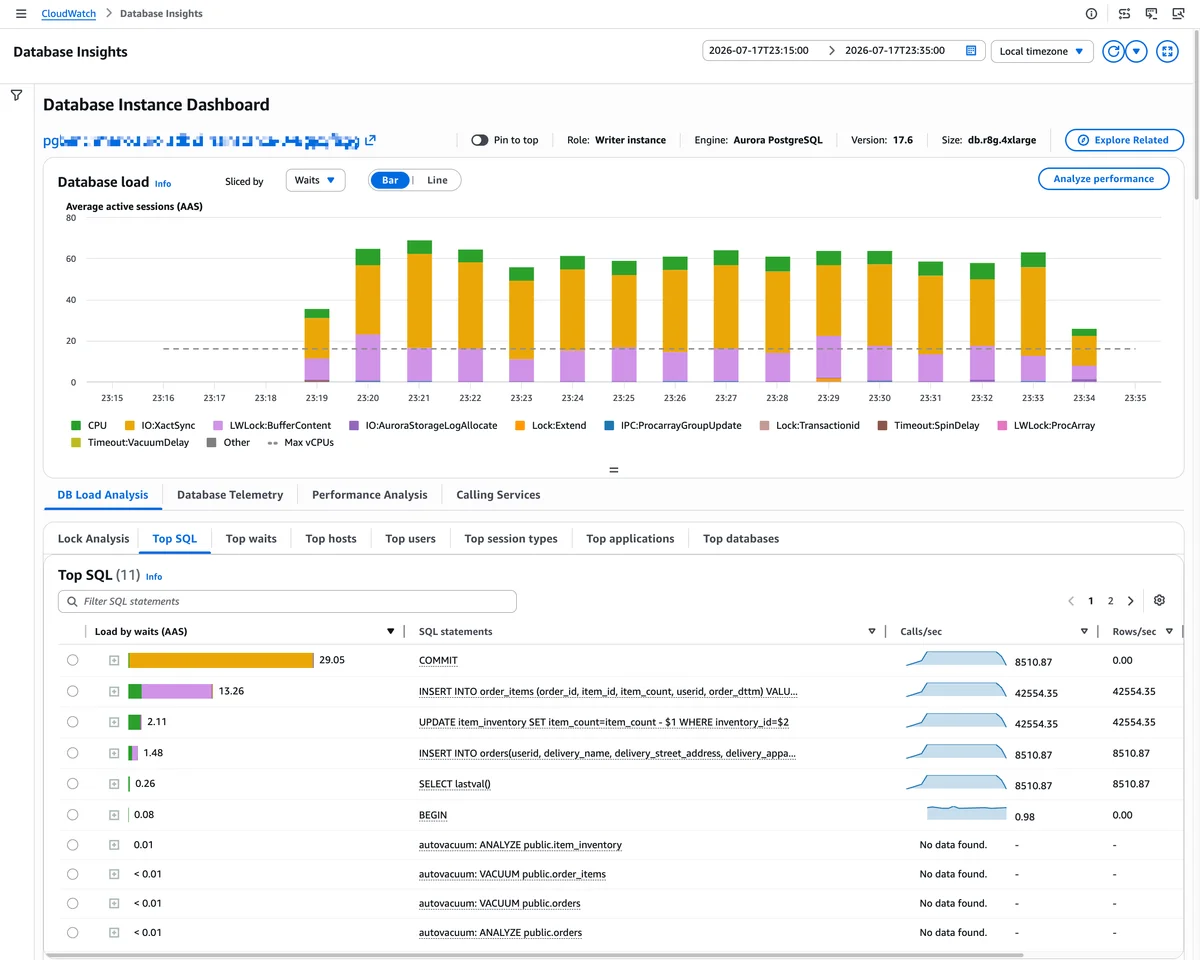
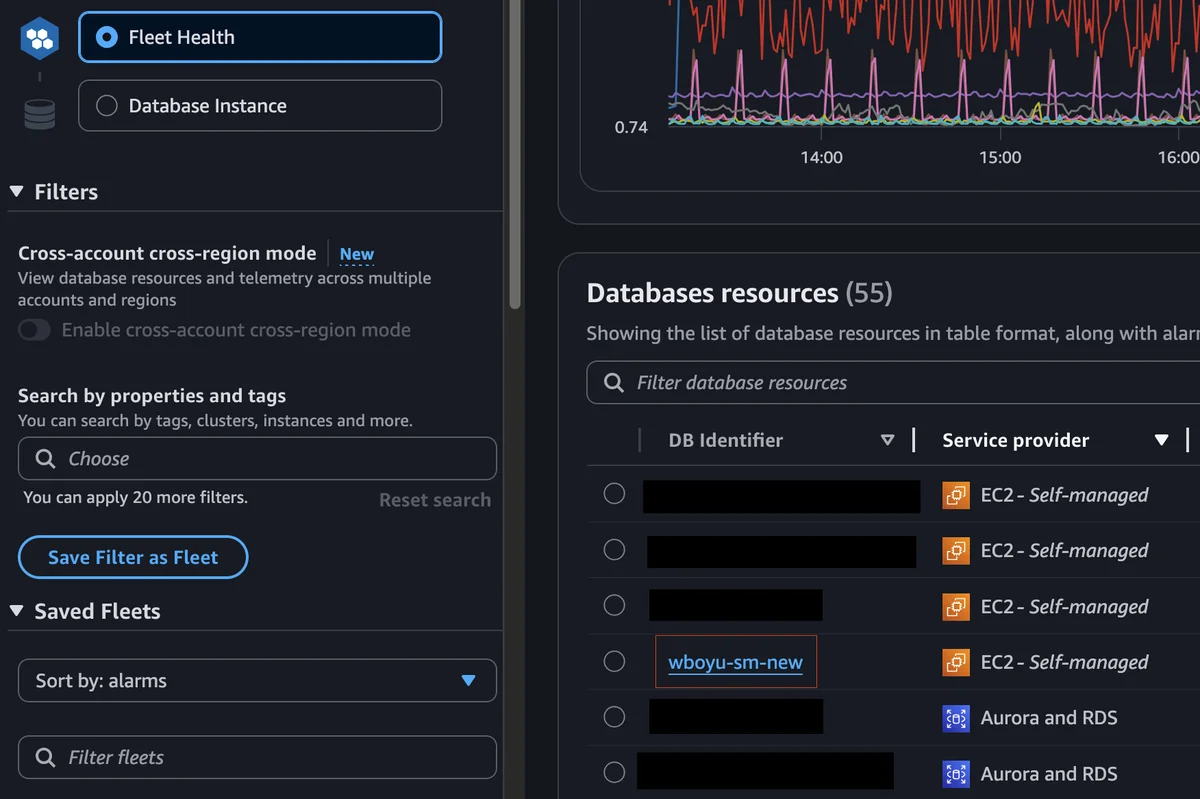
使用 Amazon CloudWatch Database Insights 监控自管理数据库 Amazon CloudWatch Database Insights 现已扩展至自托管数据库。您可在单一控制台中监控 Amazon EC2 上的自托管 PostgreSQL,以及您的 Amazon Aurora 和 Amazon RDS 实例集群,并享受与托管数据库相同的数据库负载、Top SQL 和等待事件分析功能。 Monitor self-managed databases with Amazon CloudWatch Database Insights aws.amazon.com +1
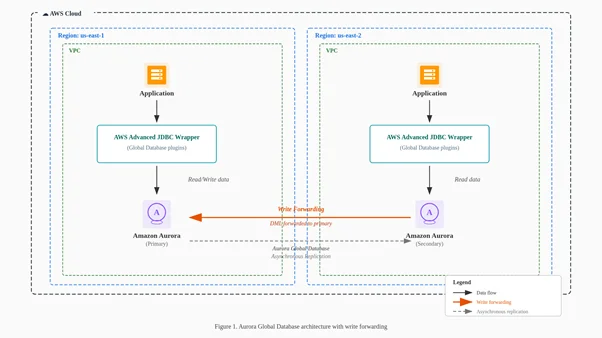
排查 Aurora 全局数据库写转发的高级 JDBC Wrapper 配置问题 配置支持写前向的 Amazon Aurora 全局数据库的 AWS Advanced JDBC Wrapper 需要设置区域特定参数,配置错误会导致延迟激增和连接失败。本文介绍主区域和辅助区域正确的方言、插件、主机模式及写前向设置。 Troubleshoot AWS Advanced JDBC Wrapper configuration for Aurora Global Database write forwarding aws.amazon.com +1
介绍 strands-dynamodb-storage:Strands Agents SDK 的持久化代理存储 推出 strands-dynamodb-storage,这是 Strands Agents SDK 的开源 Amazon DynamoDB 存储后端。只需在您自己的账户中配置一张 DynamoDB 表,即可为 Strands 代理的会话状态、长期记忆和对话记录提供持久化存储,并基于该表上的向量索引赋予代理语义回忆能力。 Introducing strands-dynamodb-storage: Durable agent storage for the Strands Agents SDK aws.amazon.com +1
使用 AI 代理为 AWS DMS 实现从 SQL Server 到 Aurora PostgreSQL 的转换 学习如何使用 AWS DMS 架构转换中的 AI 代理,通过自然语言编排从 SQL Server 到 Amazon Aurora PostgreSQL 的架构转换。了解转换引擎如何处理 T-SQL,代理如何驱动工作流,以及如何利用决策框架解释并解决常见不兼容项的 CRITICAL 操作项。 SQL Server to Aurora PostgreSQL conversion with AI agents for AWS DMS aws.amazon.com +1
在升级 Amazon RDS 和 Amazon Aurora PostgreSQL 之前,请修复循环角色依赖关系。 PostgreSQL 14 或更早版本迁移到 15 或更高版本时,Amazon RDS for PostgreSQL 或 Amazon Aurora PostgreSQL 中的循环角色依赖关系可能导致主版本升级停滞或回滚。了解此现象的原因,如何通过单个预升级查询检测该问题,以及在升级前如何清除它。 Fix circular role dependencies before upgrading Amazon RDS and Amazon Aurora PostgreSQL aws.amazon.com +1
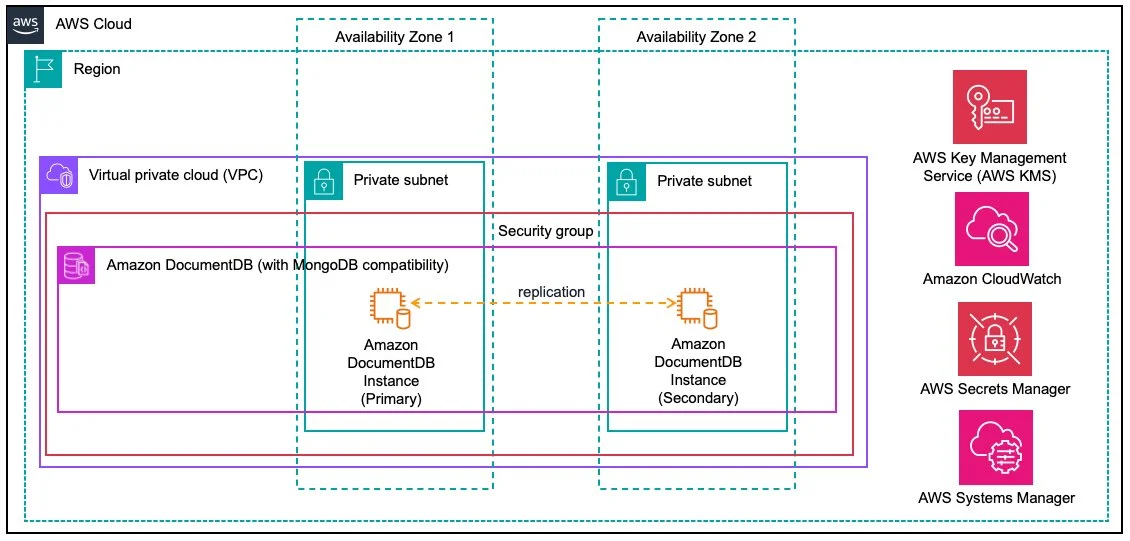
使用 Terraform 部署一个安全的 Amazon DocumentDB 集群 学习如何使用 Terraform 部署安全的 Amazon DocumentDB 集群。本文应用了基础设施即代码的最佳实践,包括加密、AWS Secrets Manager 身份验证、网络隔离以及加密监控。 Provision a secure Amazon DocumentDB cluster with Terraform aws.amazon.com +1
CORTO 基于 Aurora PostgreSQL pgvector 实现的十亿级法律语义搜索” CORTO 如何在生产环境中利用 pgvector 将 Amazon Aurora PostgreSQL 扩展至支持 76 亿向量和 25 亿文档,为 10,000 多家律师事务所提供亚秒级法律搜索,同时将存储成本降低 75%。 CORTO’s billion-scale legal semantic search with Aurora PostgreSQL pgvector aws.amazon.com +1
Channel Corporation 如何利用 Amazon DynamoDB 实现架构现代化(三):用户与徽章 Channel Corporation 分享了他们如何将通用的 Amazon DynamoDB 用户表拆分为按角色划分的专用表,将 Badge 数据迁移至独立的 UserBadge 表,以消除事务冲突导致的限流及 GSI 回压问题,并介绍了他们如何利用 DynamoDB Export 和 Import 功能,结合 Amazon S3 与 AWS Glue,实现零停机在线迁移。 How Channel Corporation modernized their architecture with Amazon DynamoDB, Part 3: User and Badge aws.amazon.com +1