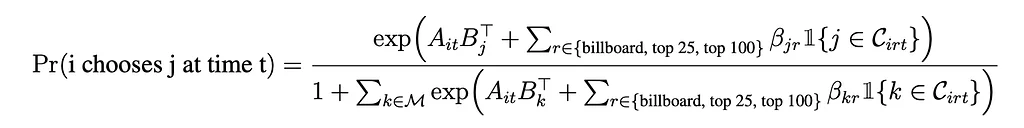Netflix TechBlog | Medium 中文 关注 Netflix 技术博客提供了 Netflix 如何处理技术的见解。他们在数据科学、工程、设计和技术创新方面进行研究。他们展示了自己的创新,如他们的专有内容交付网络,并提供了关于他们服务可靠性努力的见解。 Netflix TechBlog - Medium netflixtechblog.com RSS netflixtechblog.com Netflix TechBlog | Medium 中文 RSS thenote.app
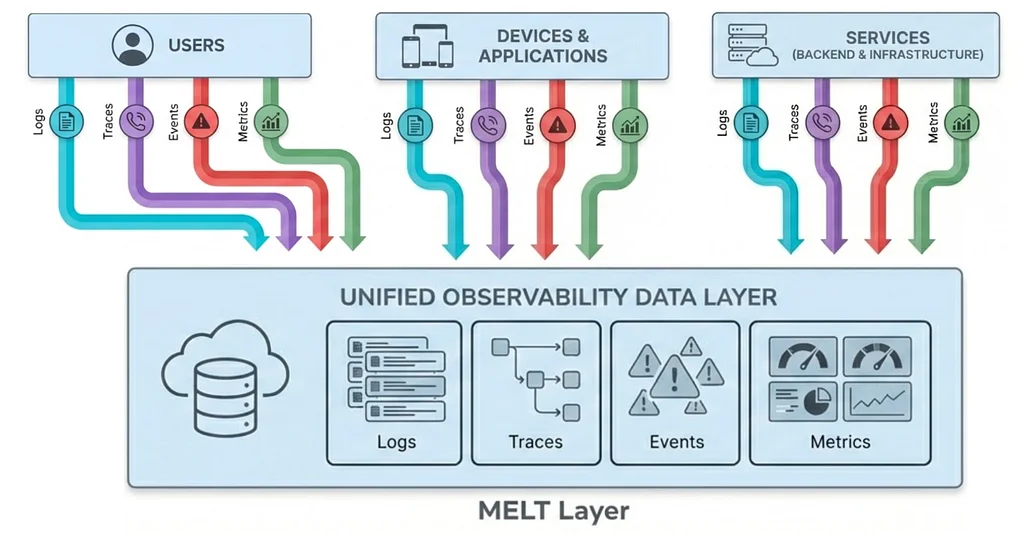
本体驱动的观测:在 Netflix 规模构建端到端知识图谱 该公司在理解其庞大而复杂的基础设施方面面临挑战,尤其是在像 Jake Paul 与 Mike Tyson 对决这样的大型直播活动期间,该活动吸引了 6500 万次流媒体观看。调试问题(例如主页渲染缓慢)可能需要数小时,因为相关信息分散在不同的系统中。这些系统通过指标(metrics)、事件(events)、日志(logs)和追踪(traces,合称 MELT)收集数据,但有效关联这些数据十分困难。核心问题在于缺乏对运维实体的共享、机器可读的理解。为解决这一问题,他们开发了一套“可观测性本体”(Observability Ontology),即对其运维世界中类型、属性和关系的形式化规范。该本体采用 RDF、OWL、SHACL 和 SPARQL 等标准,并将数据存储为知识图谱。一个关键的设计决策是避免使用通用的"Service"类型,转而采用具体且经过验证的类型,如 ops:Application。此外,他们还选择对事故讨论中的推理和上下文进行建模,将非结构化的聊天内容转化为结构化的三元组。该本体通过流水线方法,从本质上具有随机性的过程(如大语言模型 LLM 和模糊匹配)中实现确定性。该流水线使用“增强器”(enrichers),通过将嘈杂的输入转换为带类型的三元组来降低熵值,并遵循严格的契约。这些增强器确保每个实体都具有类型,URI 遵循命名规范,且应用程序需与目录进行验证。流水线按顺序运行以避免竞态条件,外部调用采用尽力而为(best-effort)方式以防止阻塞。随后,“关联引擎”(Correlation Engine)整合来自各种来源的信号,识别事件的因果或相关链条。它分析十三种信号类型,提出带有证据和置信度分数的假设,并存储支持性的图谱记录。每一次观测、增强、关联和存储的循环构成一个“知识飞轮”(Knowledge Flywheel),持续丰富知识图谱并提升系统上下文。该飞轮旨在通过提供统一且互联的系统运维视图,减少调试时间。 Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale netflixtechblog.com +1
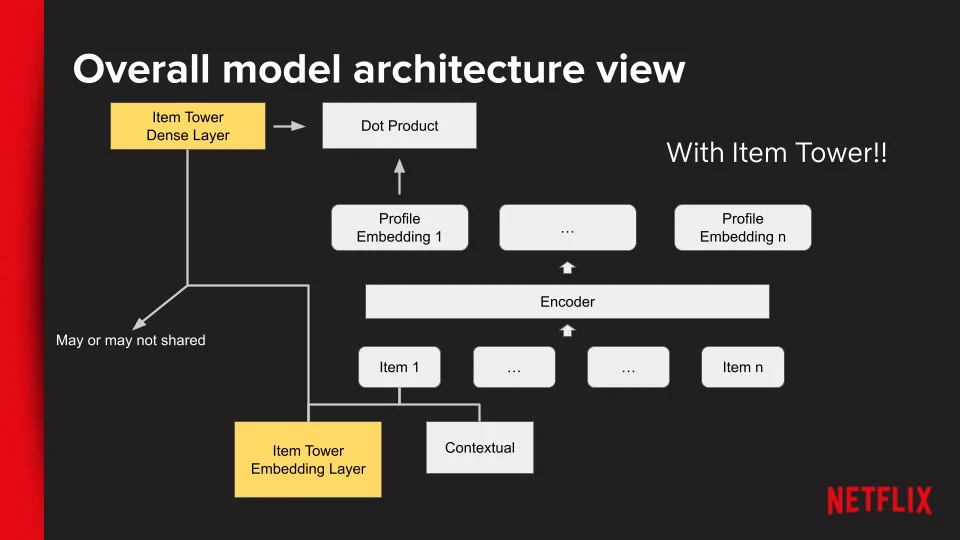
将 Netflix 基础模型集成到个性化应用中 Netflix 开发了一种用于个性化推荐的基座模型(Foundation Model),以集中化成员偏好学习。该强大模型基于广泛的用户交互和内容数据进行训练,并将其学到的知识分发给其他模型。将这一大型模型集成到生产系统中颇具挑战,促使 Netflix 尝试了三种不同的方法:嵌入(embeddings)、子图(subgraph)和微调(fine-tuning)。每种方法均针对不同的应用需求,在延迟、技术栈和模型利用方面各有侧重。嵌入方法利用基座模型预计算的用户画像和物品表示,并将其存储于嵌入存储库(Embedding Store)中。该方法虽简单且成本效益高,但由于计算与推理之间存在时间差,可能导致推荐信息过时。Netflix 通过每日微调及嵌入稳定化技术对此进行增强,并正在开发一种近实时框架,以解决过时问题并提升适应性。子图集成方法将基座模型的解码器作为应用程序更大模型图中的一个组件。这种方式实现了更深层次的集成,能够利用最新的学到的知识,并通过访问基座模型的特定层来释放针对应用特有的价值。然而,它增加了特征生成的复杂性,并扩大了模型规模及推理时间。该方法仅保留用于高影响力场景,即指标提升足以证明其成本的使用案例。微调方法通过在特定产品数据和目标上进一步训练基座模型,使其适应特定应用程序。这提供了优化的性能,并作为新应用程序的基线。尽管需要针对延迟和服务水平协议(SLAs)进行精心优化,但它可能导致模型和流水线的大量增殖。Netflix 提供了一个微调框架以简化此过程。持续的创新包括近实时嵌入推理以及更小、经过蒸馏的基座模型版本,以降低延迟。标准化的 API 和强大的微调框架旨在使应用程序团队更易于利用基座模型。这三种集成模式为 Netflix 应用程序提供了一套综合策略,使其能够从基座模型中获益。 Integrating Netflix’s Foundation Model into Personalization applications netflixtechblog.com +1
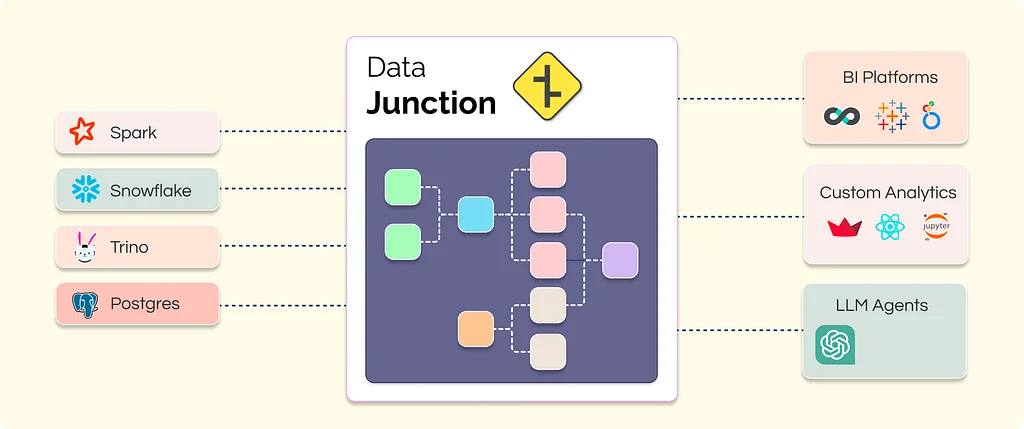
DataJunction:Netflix 为现代数据栈缺失环节提供的解决方案 Netflix 面临指标分散、定义不一致且不可信的挑战,尤其是在其实验平台中。这种复杂性阻碍了数据科学家和分析工程师的工作,使得在旧系统中引入指标需要数周时间。为解决这一问题,Netflix 探索了语义层解决方案,并选择了 DataJunction,因其具备强大的 SQL 解析与生成引擎,以及基于图的数据元数据存储。DataJunction 最初由 Facebook 开发,旨在解决指标可移植性问题,随后由 Netflix 工程师开源并加以扩展。一项关键的架构决策是优先采用 API 优先的方法,构建坚实的语义层引擎,并支持 SQL 输入与输出能力。该平台将多维数据立方体作为核心功能,以适配熟悉的用户界面并实现高效的数据交付。DataJunction 能够将指标定义关联回数据源,从而简化故障排查和临时分析。该平台与 Netflix 实验领域的集成,已简化了指标与维度的定义与管理。未来的计划是通过与其他工具建立更紧密的集成,统一 Netflix 的一般分析能力,从而在整个 Netflix 数据栈中更便捷地发现、使用并进行指标实验。 DataJunction as Netflix’s answer to the missing piece of the modern data stack netflixtechblog.com +1
衡量个性化推荐的成效 个性化是 Netflix 等在线平台的关键功能,影响着用户的内容发现与参与度。然而,衡量个性化的真实价值面临重大挑战,因为推荐是基于预测的用户偏好进行的,这使得难以将推荐效应与内容本身的吸引力区分开来。简单地统计推荐内容的观看次数是不够的,因为它无法确立因果关系。完全关闭个性化以进行实验会损害用户体验,因此不可行。相反,研究人员开发了一种混合方法,结合行为模型与小规模 A/B 测试。该模型通过分离底层用户偏好与推荐的增量影响,来评估推荐如何同时影响观看决策和内容选择。该模型动态地表示用户偏好,捕捉过往观看历史如何塑造当前口味。它显式地对推荐在内容选择上的“额外”效应进行建模,反映了用户认知度和信息获取的提升。为了验证该模型在预测替代模式方面的准确性,研究人员将其与随机实验的结果进行了对比。这些实验通过引入内容可见性的外生变异,模拟了推荐算法的变化方式。该模型展现出强大的预测能力,其模拟的分流比率与实验估计值高度相关。利用经过验证的模型,研究人员进行了反事实分析,将当前的 Netflix 推荐系统与随机推荐、基于流行度的推荐以及基础矩阵分解推荐等基线进行了比较。当前系统在整体参与度方面显著优于这些基线:相比随机推荐,参与度降低了 16%;相比基于流行度的推荐,降低了 12%。即使与矩阵分解相比,当前系统也实现了 4% 的参与度提升。除了提升观看量之外,该模型还评估了消费多样性。当前系统在不同内容之间的观看分布更为广泛,而基于流行度和矩阵分解的推荐则导致了观看集中度的增加。随机推荐虽然提供了更高的多样性,但以大幅牺牲参与度为代价。因此,个性化不仅推动了更多的观看,还将用户匹配到更加多样化的内容集合中,反映了用户多样的口味。 Measuring the Impact of Personalized Recommendations netflixtechblog.com +1
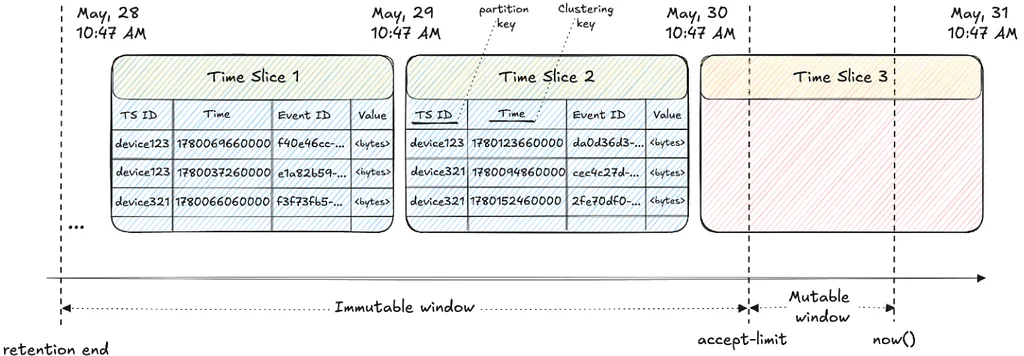
TimeSeries 分层存储之旅:从 Kafka/Flink 流到原生 Cassandra 冷读 Netflix 的时序抽象平台(TimeSeries Abstraction)对于处理 PB 级时序数据至关重要,但其面临显著的存储成本挑战。为解决这一问题,已实施两种方案,旨在将较旧且访问频率较低的数据迁移至更廉价的对象存储,同时保持低延迟访问。第一种方案利用 Apache Kafka 和 Flink 将数据流式传输至 S3,随后执行每日压缩作业,对 Parquet 文件进行合并与优化。该压缩过程包括创建小型行组、按时间对事件进行排序,并利用布隆过滤器实现高效读取。压缩后的文件随后在控制平面中注册,从而允许对热存储进行截断。读取请求会在热存储和冷存储层之间进行扇出,其中冷存储层利用压缩元数据以最小化 S3 读取操作。尽管第一种方案取得了成功,但其流式处理基础设施引入了复杂性与成本。这促使了第二种更为集成的解决方案的开发,该方案利用 Cassandra 备份功能。此方法旨在直接从 S3 备份中读取数据,而无需单独的数据传输。它引入了一种新的 Cassandra 压缩策略,称为只读压缩策略(ReadOnlyCompactionStrategy,ROCS),用于处理不可变的时间切片。ROCS 将 SSTable 与令牌范围对齐,从而减少了读取扇出,并提升了所有存储层的延迟性能。Cassandra 将其数据备份至 S3,生成列出 SSTable 路径的清单。第二种方案对 Cassandra 进行了定制,使其能够直接从这些 S3 备份中读取不可变时间切片的数据。该方案使用了可插拔的内存表(Memtables),具体为"backupmemtable",以重定向读取请求。该 backup Memtable 会从 S3 下载必要的索引和元数据文件至节点。强大的弹性机制确保了组件下载与初始化的可靠性。一旦本地组件准备就绪,Cassandra 便从这些备份中服务读取请求,通过并行化 S3 读取并利用缓存进行进一步优化。该策略通过消除独立的流式处理基础设施,显著降低了运维开销与基础设施成本。 TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads netflixtechblog.com +1
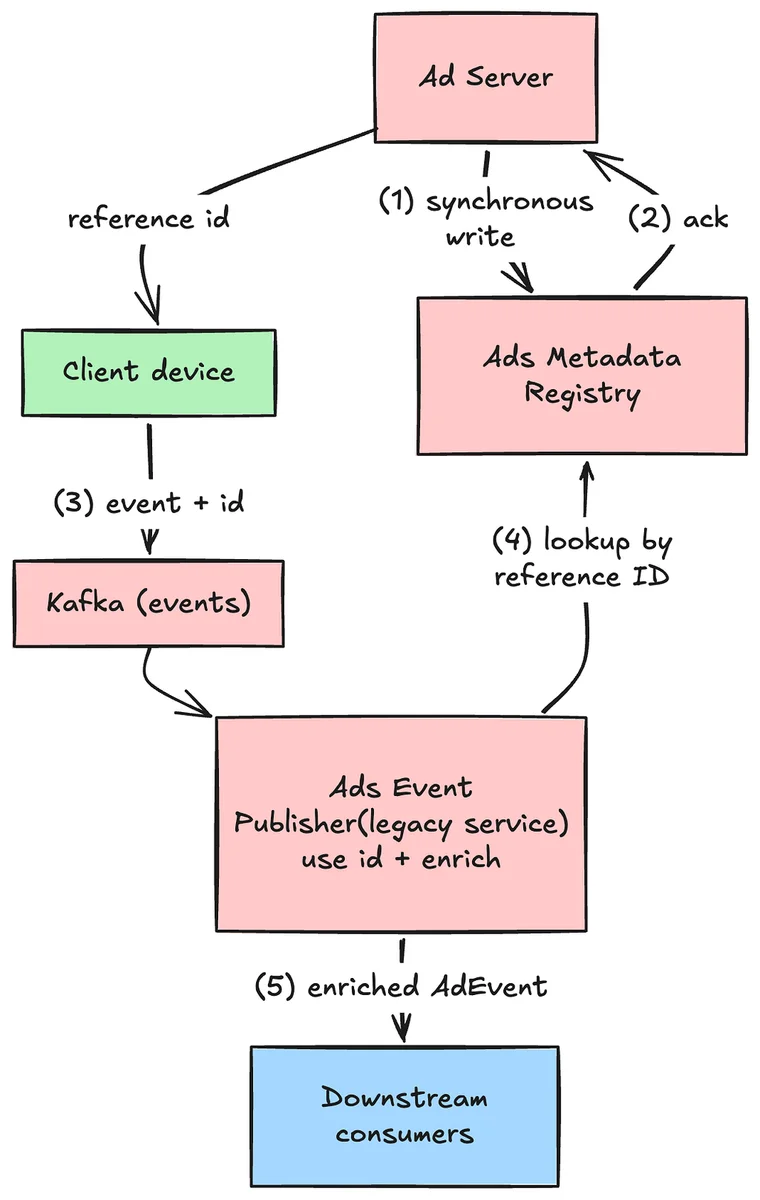
幕后揭秘:Netflix 直播广告事件管道的演进——第二部分 Netflix 重构了其广告事件发布器(Ads Event Publisher),以应对规模扩大和复杂性提升的挑战,尤其是针对直播流广告。原有系统依赖键值存储(Key-Value store)进行广告元数据增强。尽管该方案功能可行,但存在扩展瓶颈和关键路径依赖,不适用于直播场景。直播流会产生大规模且突发的流量,需要更稳健且具备弹性的解决方案。新架构采用 Apache Flink(一种有状态流处理框架)实现准实时增强。广告服务器响应日志不再写入数据库,而是发送至 Kafka。Flink 随后在这些响应与客户端生成的广告事件之间执行实时流式连接(streaming join)。此举消除了关键服务路径上的直接数据库写入,从而避免服务中断并提升可扩展性。Flink 作业负责标准化事件、将其路由至正确的处理区域,并执行有状态连接。该作业将最近的广告服务响应保留在内存中,并在可配置的时间窗口内(通常为 60 分钟)将传入的客户端事件与这些响应进行匹配。此方法允许在两个事件均到达时即时完成增强。若事件先到达,则将其暂存,直至对应的响应出现。为解决跨区域增强问题,系统将客户端事件路由至实际服务广告的区域,而非将所有服务响应在全球范围内复制,这种方式更具成本效益。广告令牌(ad token)现已包含服务区域信息。虽然 60 分钟的时间窗口可覆盖绝大多数事件,但系统还设有独立路径以恢复迟到的事件,从而确保计费与报告所需的数据完整性。这种有状态流处理架构为 Netflix 不断演变的广告需求提供了必要的可扩展性与弹性。 Behind the Scenes: Evolving Netflix’s Ads Event Pipeline for Live — Part II netflixtechblog.com +1
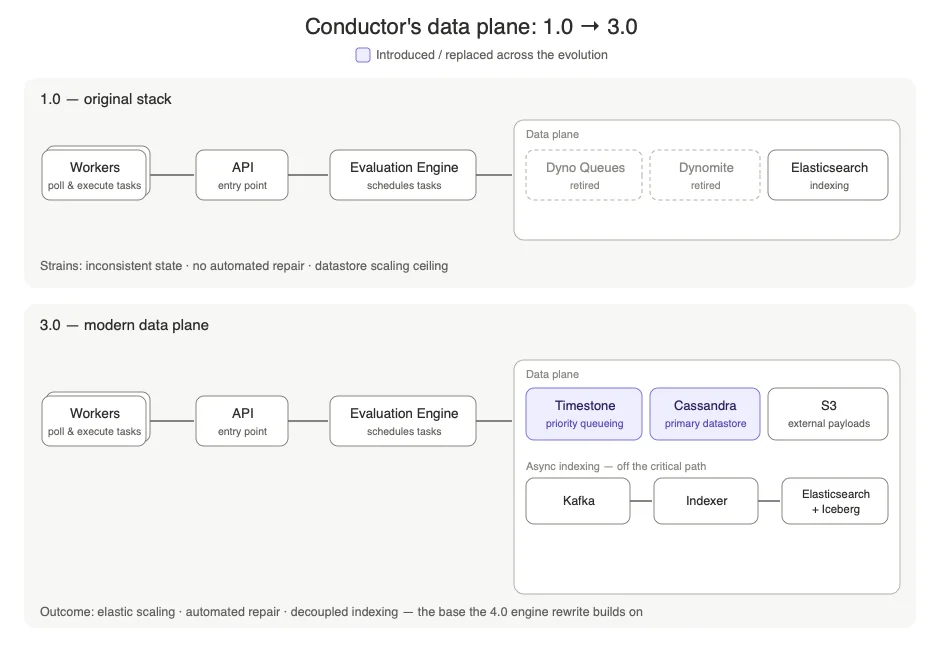
Netflix Conductor:新篇章” Netflix Conductor 在其首次开源发布之后发生了显著演变。尽管开源版本的维护已停止,但内部开发加速推进,最终导致了完全重构。Conductor 的规模急剧扩张,每年处理数十亿次工作流执行,与其早期达成的里程碑式成就形成鲜明对比。这种增长促使从数据平面到评估引擎几乎每一系统层面都进行了现代化改造。如今,Conductor 支持海量的工作流定义,已成为 Netflix 多项业务不可或缺的基础设施,包括内容、工作室工程、广告和游戏。例如,媒体制作套件(Media Production Suite)依赖 Conductor 处理关键的媒体摄入与处理流水线。在架构层面,Conductor 从基于 Dynomite 的堆栈迁移至以 Cassandra 作为主要数据存储、以 Timestone 作为队列系统,显著提升了可扩展性与可靠性。Conductor 3.0 解决了基础性问题,而 Conductor 4.0 则对核心评估引擎进行了重构。此次重写通过数据分区提升了内存效率与性能,并引入了异步评估模型以消除同步瓶颈。最终成果是一个更加稳健、可扩展且高性能的工作流编排引擎,能够应对 Netflix 庞大的运营需求。 Netflix Conductor: The Next Chapter netflixtechblog.com +1
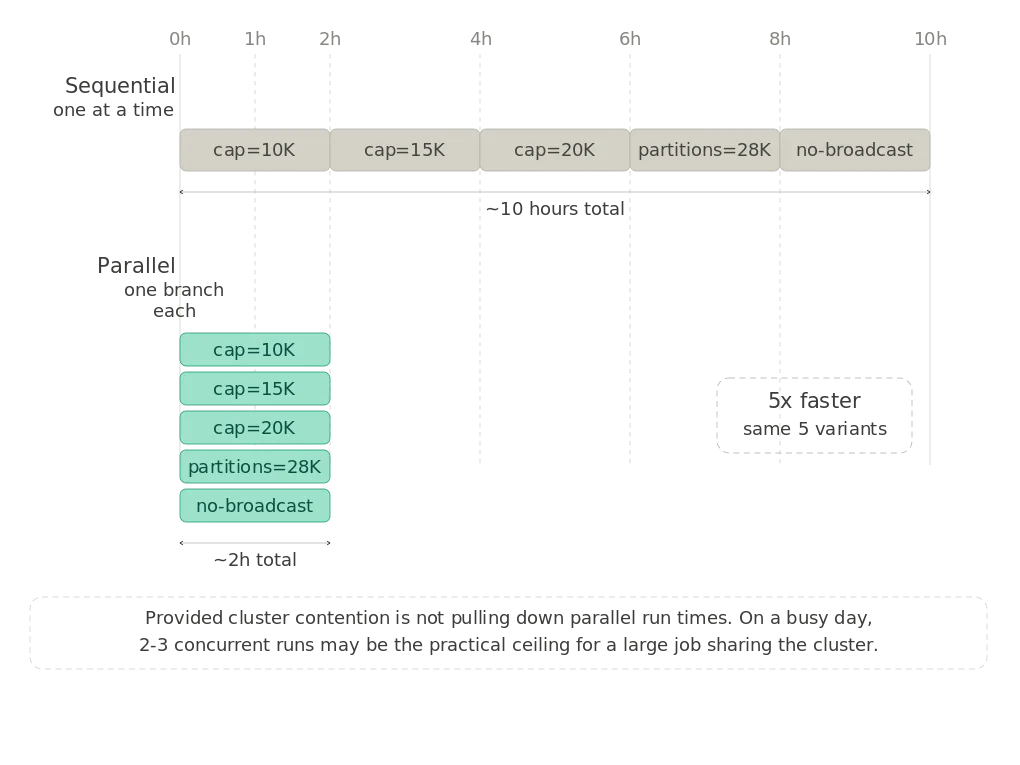
在睡眠中(甚至是在飞机上)运行 Apache Spark 实验 Netflix 的成员会话处理器(member-sessionizer)是一项关键的数据管道,用于处理数十亿条事件以构建用户观看会话。在 Netflix 的生产规模下,标准调试方法失效,因为诸如内存溢出(Out-Of-Memory)等问题仅在大规模且未采样的数据集上因数据倾斜而显现。作者的突破在于将关注点从加速单次运行转变为支持多个并发实验。这一目标通过利用 Dataflow 的分支驱动开发来实现,从而隔离每个测试变体。通过对调度器进行参数化,并为每个实验分配独立的分支和输出表,多个测试得以同时运行。这将总执行时间从每次测试数小时大幅缩短至最长单个作业的持续时间。引入 AI 代理来管理运行大量并行实验的运营复杂性,自动化配置更新、作业触发和指标轮询。这使得作者得以摆脱繁琐的手动检查,能够立即比较结果。在 Netflix 的云开发环境中保持持久的 tmux 会话对于防止多小时的 Spark 作业因网络中断或笔记本电脑关闭而中断至关重要。核心性能瓶颈被识别为 collect_list 算子将整个事件包缓冲在内存中以及低效的数据结构。具体而言,将会话 ID 更改为 UUID 字符串并使用 Scala Option 处理字段显著增加了内存占用。此外,臃肿的字符串属性为每个事件增加了不必要的重量。修复措施包括从 Option 中解包原始字段,并通过移除未使用的属性精简事件包。将与会话无关的元数据提升至会话头部。两项反直觉的发现凸显了 Spark 内存管理的复杂性:缩小行数可能通过强制广播连接而触发更快的内存溢出;自适应查询执行(Adaptive Query Execution, AQE)通过广播哈希连接在内存中静默累积大量数据。调整 AQE 的广播阈值解决了这一问题。一套纪律严明的日志系统追踪了每个实验、其配置和关键指标,形成了单一事实来源,并强制进行隔离的变量变更。一个错误在于在 Spark Window 阶段之前测试会话上限修复,该操作在截断前进行了内存缓冲。最终的修正修复将截断操作上移至上游,以防止内存膨胀。尽管这些调优工作解决了即时问题,但将整个会话聚合为单行这一根本数据形状在未来仍构成扩展挑战。 Running Apache Spark experiments in my sleep (and on a plane) netflixtechblog.com +1
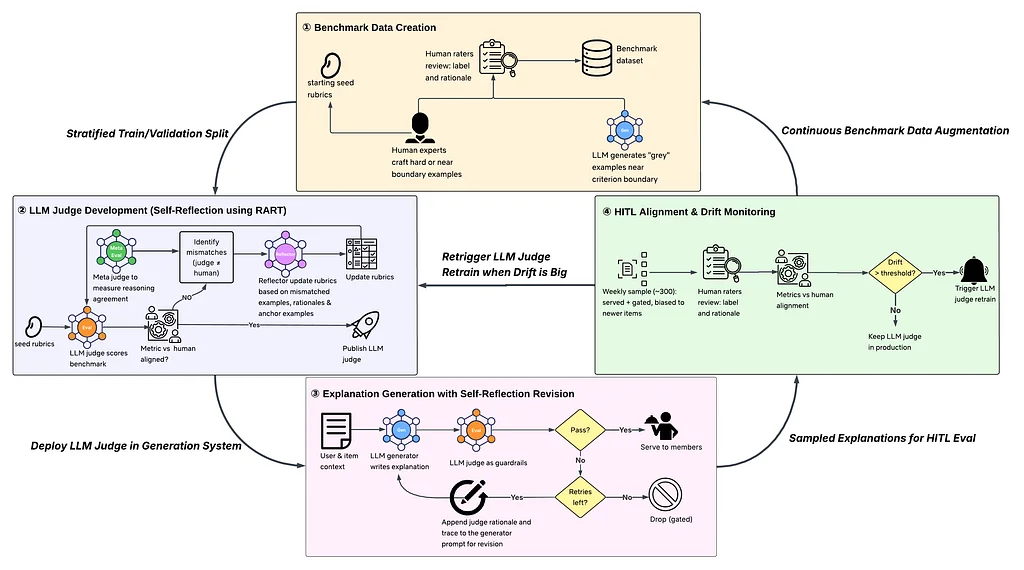
LLM-as-a-Judge 的生命周期:规模化构建、对齐与监控 大规模文本生成依赖大语言模型(LLM)时,由于人工审查存在局限性,必须采用自动化评估方法。"LLM-as-a-Judge"方法利用第二个 LLM 对主 LLM 的输出进行评分,但引发了关于评估者可信度的担忧。该问题通过构建、对齐并持续监控 LLM 评估者来解决,确保其在每个阶段都始终锚定于人类判断。人类负责定义质量标准、创建标注数据集、监控评估者行为并批准更新。可靠的 LLM 评估者并非静态存在;它具有生命周期,涵盖其创建、对齐、运行和维护中的人类所有权。这一过程通过生成推荐解释的任务得以阐明,推荐解释是简短的消息,用于解释物品推荐。质量至关重要,因为误导性解释会侵蚀用户信任。LLM 评估者的生命周期包含四个阶段:诞生(Birth)、训练(Training)、部署(Deployment)以及人机协同对齐与漂移监控(HITL Alignment & Drift Monitoring)。诞生阶段由人类专家构建基准数据,包括对抗性示例和边界案例,随后由人类评分员进行标注。训练阶段利用自我反思和评分标准更新,使 LLM 评估者与人类标注及理由对齐。部署阶段将评估者集成到解释生成系统中,作为守门人和批评者。人机协同对齐与漂移监控通过定期将评估者与人类评分员进行基准测试,并要求任何系统变更均须获得人类批准,从而确保持续的可信度。该阶段使用元评估者(Meta-Judge)比较 LLM 评估者的理由与人类理由,捕捉评估者得出正确答案但理由错误的情况。这一持续反馈循环整合了新的人类标注数据和信号,并反馈至基准和开发阶段。系统组件包括生成器(Generator)、评估者(Judge)、反思器(Reflector)、元评估者(Meta-Judge)以及人类专家和评分员,它们在整个生命周期阶段协同工作,以维护评估者的完整性。 The Lifecycle of LLM-as-a-Judge: Building, Aligning, and Monitoring at scale netflixtechblog.com +1
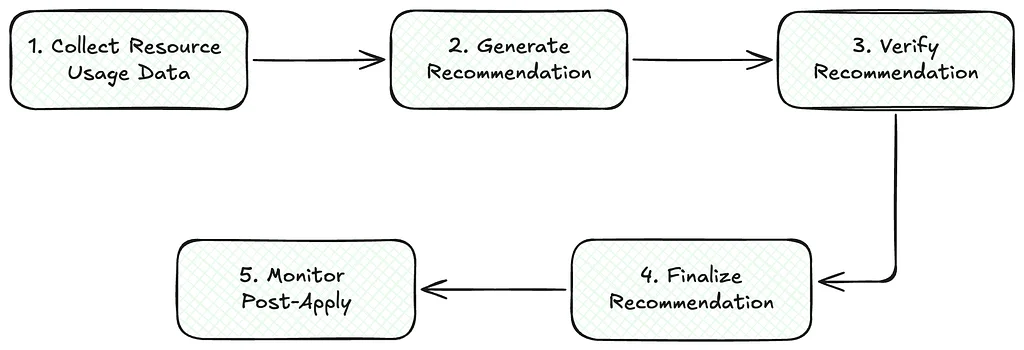
Netflix 分层媒体处理:自动容器尺寸调整 Stratum 是 Netflix 内部的平台级无服务器媒体处理平台,对于处理编码、封装等多样化的媒体工作负载至关重要。工程师将 Stratum 函数定义为 OCI 镜像,随后在 Titus 计算平台上作为批处理作业进行调度。由于需要管理数十万甚至更多的容器,Stratum 必须针对新内容格式(如播客和直播活动)实现动态扩缩容。资源请求以 YAML 格式指定,常因基础设施和应用变更而过度配置,导致效率低下和运营成本增加。为解决这一问题,Netflix 开发了 Stratum 资源调优器(Stratum Resource Tuner, SRT),这是一个旨在在生产环境中自动调整容器资源规模的自动化系统。SRT 的目标是消除人工资源配置,初期聚焦于高吞吐、对延迟要求宽松的工作负载,这类负载占资源使用量的 70% 至 80%。函数所有者可按资源类型(CPU、内存、磁盘、网络)选择启用自动资源调优。SRT 的工作流程包含五个步骤:收集资源使用指标、生成调优建议、通过实验验证建议、应用或拒绝建议,以及监控应用后的指标。建议的状态流转包括:CREATED(已创建)、EVALUATING(评估中)、APPLIED(已应用)、REJECTED(已拒绝)和 MONITORED(监控中)。例如,VideoEncoder.encodeV1 函数的过度配置内存和 CPU 已成功完成调优。指标收集机制稳健:执行级别的汇总数据存储在 Elasticsearch 中以支持短期查询,而高分辨率的原始使用指标则存储在 Iceberg 表中用于长期趋势分析。Conductor 工作流每日运行一次,利用一个月的 Iceberg 数据为所有函数和资源类型生成调优建议。该过程包括筛选高吞吐工作负载,对 CPU 和网络(基于 p99 使用率)进行激进调优,对内存和磁盘(基于 p99.9 使用率并保留安全缓冲)进行保守调优。已部署多种保障措施,例如:若资源缩减幅度过小则丢弃建议;对内存和磁盘的最大单次缩减比例限制为 15%。建议创建时处于 CREATED 状态,一旦越过此阶段即变为不可变。示例显示,CPU 推荐值从 8 降至 4,内存从 18000MB 降至 15300MB,均在单步完成,体现了 SRT 在成本优化方面的实际应用。 Netflix Stratum Media Processing: Automated Container Right-Sizing netflixtechblog.com +1
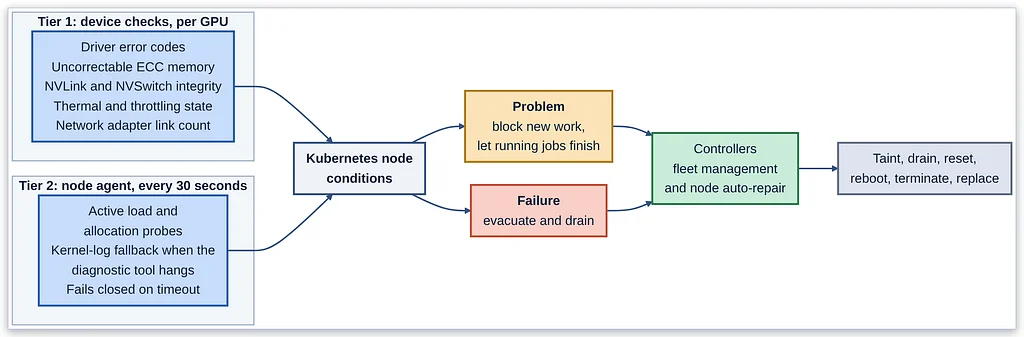
为大规模训练与推理任务提供可靠的 GPU 计算能力 Netflix 严重依赖 GPU 进行个性化内容推荐及其他机器学习应用。这些 GPU 对于内容训练和提供服务至关重要,其可靠性既是保障可用性的商业必需,也是实现成本效率的关键。基础云提供商的健康检查不足,因为它们无法检测可能导致长时间运行训练任务瘫痪的细微 GPU 或网络 fabric 故障。此类故障可能表现为性能缓慢或任务完全停止,从而影响用户体验并造成资源浪费。Netflix 采用分层方法以确保 GPU 基础设施的健康。第一层专注于检测并修复故障硬件,如 GPU 和网络适配器。第二层涉及调度器和平台,在任务重试之前验证机器。第三层使长时间运行的任务能够通过检查点和弹性工作节点在机器丢失时继续运行。第四层是可观测性,用于监控前三层的有效性。健康检查分为两个层级:针对单个 GPU 的设备级检查,以及由代理执行的节点级检查。这些检查将结果报告为 Kubernetes 节点条件。当检测到问题时,会更新机器的状态,并由控制器采取行动。初始问题会被容忍,但持续性故障会升级为机器疏散、资源排空和替换。修复措施是分级的,根据故障严重程度匹配相应操作,范围从重启单个 GPU 到终止并替换整个机器。对于持续故障的硬件,会记录不可变标识符以防止其重新加入资源池。机器在释放用于工作前会经过验证,确保通过所有诊断。最后,通过检查点使长时间运行的任务具备弹性,允许在机器丢失时从最后一个稳定状态恢复。 Reliable GPU compute for large training & inference jobs netflixtechblog.com +1
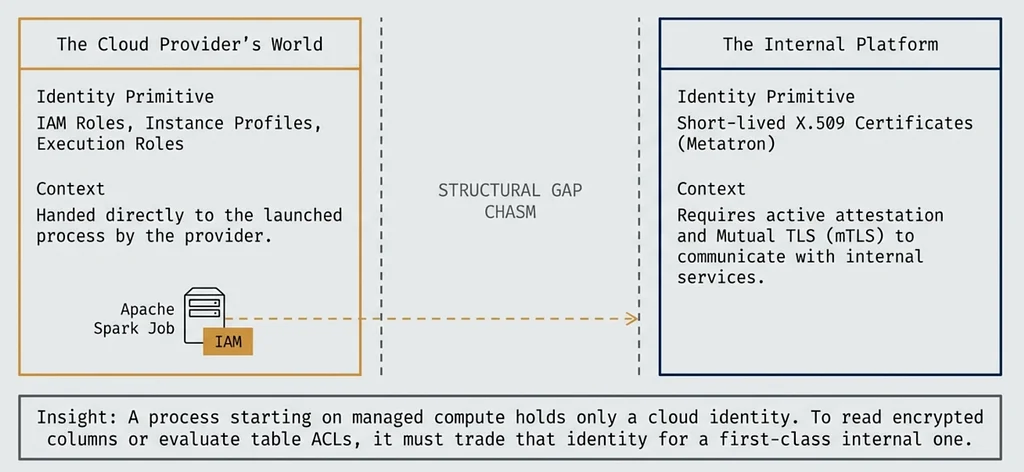
用云身份进行交换:托管计算的工作负载验证 组织通常维护两套并行的身份系统:一套来自云提供商(如 AWS),另一套用于内部服务。本文详细介绍了运行在 Amazon EMR 上的 Apache Spark 工作负载如何弥合这一差距,使其能够从初始的云身份获得一等公民的内部身份。Netflix 使用名为 Metatron 的私有公钥基础设施(PKI)实现服务间通过双向 TLS 的认证,该过程需要 attest(证明)流程来验证工作负载的身份。此外,Netflix 还采用“数据项目”(Data Project)概念,该概念拥有数据并具备独立身份,从而确保访问控制和审计的一致性。核心挑战在于将基于云的 AWS 执行角色转换为托管计算环境中 Spark 作业所需的内部身份。该解决方案在数据项目身份与专用 IAM 角色之间建立直接的一对一映射,由数据项目服务作为该映射的权威方。此映射对于将云提供商的术语体系中的权限语句转换为组织的内部术语体系至关重要。为解决管理大量 IAM 角色的可扩展性问题,这些角色被确定性地在少量专用的 AWS 账户池中分片(sharded)。该方案涉及五个组件:控制平面(负责启动作业并签署元数据)、数据项目服务(管理身份到角色的映射)、身份服务(验证证明并颁发证书)、Spark 插件(钩入进程引导阶段)以及 AWS STS(充当公证人)。流程始于控制平面签署包含工作负载详情的元数据负载。随后,Spark 驱动端插件利用 AWS 凭证从 AWS STS 生成预签名 URL,以证明持有云身份。接着,身份服务核实这两项独立的声明:由 AWS 通过预签名 URL 识别的角色,以及来自控制平面的已签署元数据。若两者一致,则向工作负载颁发证书。这种相互验证至关重要,因为单靠任一声明均不足够:云提供商的声明不可伪造但描述不充分,而控制平面的声明描述充分但可能存在重放风险。该系统通过让驱动端进行一次证明并安全分发凭证,解决了执行器(executors)的扇出(fan-out)问题。证书具有短生命周期,并通过驱动端 JVM 内可重复的证明流程进行续期。信任模型确保没有任何单一参与者能够独立颁发身份,且工作负载本身也无需为其合法性背书。 Trading a Cloud Identity for Your Own: Workload Attestation on Managed Compute netflixtechblog.com +1
将班级之路抛在后视镜里 ja 及其可组合的命令行工具的新预览版旨在现代化 Java 开发。这些工具利用 Java 模块系统简化模块的创建与消费。模块描述符得到增强,能够完整描述项目,包括依赖版本和元数据。jig 等工具负责模块解析、编译和打包,充当 Maven 仓库的桥梁。jfmt 强制执行代码格式约定,以获得更整洁的 Java 代码。jist 提供基于源码的符号搜索,便于代码导航。jdocserver 提供本地 API 文档浏览功能。这些工具与 JDK 的工具发现和执行能力集成,并实现向标准 JDK 工具(如 jdeps 和 jlink)的无缝过渡。该系统通过推断模块坐标并建立规范坐标,解决了现有 Maven 构件的挑战。默认情况下强制完整性,允许显式声明和授权运行时访问需求,防止未经授权的修改,从而确保对模块交互具有更高的安全性和控制力。 Leave the Class Path in the Rearview Mirror netflixtechblog.com +1
MAPS:Netflix 大规模多模态资产个性化系统” Netflix 旨在通过个性化的视觉资产(如海报和视频预览)将会员与其喜爱的内容连接起来。对于新上线的标题,由于缺乏足够的交互数据,难以实现有效的个性化,这一问题被称为“冷启动”问题。传统上,模型将资产视为不透明的 ID,依赖流行度启发式方法,直到积累足够的数据。这意味着新内容的个性化被推迟,影响了内容发现体验。Netflix 的解决方案是利用多模态嵌入,使模型能够“看见”和“听见”这些资产。通过使用 CLIP(一种预训练的图片 - 文本模型)对海报进行编码,资产获得了视觉理解能力。该 CLIP 嵌入与资产的 ID 嵌入拼接,形成更丰富的表示,能够捕捉视觉主题和人才信息。这使得即使在没有交互历史之前,也能根据会员对视觉风格的偏好进行个性化,并促进不同标题之间的知识迁移。该方法还实现了模型整合,将针对不同海报画布的独立模型合并为单一统一模型。由于 CLIP 嵌入对裁剪和缩放具有高度不变性,近乎相同的海报渲染会映射到相似的向量。这种跨画布的交互信号聚合,尤其有利于低数据画布,使得单一模型能够为所有海报放置位置实现个性化。为解决不同画布间的数据不平衡问题,采用基于奖励的加权策略,依据交互的长期价值而非展示量进行优先级排序。该方法的成效通过离线评估(使用逆倾向得分)和大规模 A/B 测试得到验证。将图像嵌入与统一模型(V3)相结合,显著优于仅包含其中一项改进的模型。这种组合方法在 Netflix 主页重大改版期间发挥了关键作用,当时引入了一个历史数据极少的优势画布。带有 CLIP 嵌入的统一模型成功为该新布局实现了内容个性化,在发现指标和流媒体时长上均显示出具有统计显著性的提升,凸显了多模态嵌入在克服冷启动问题方面的强大能力。 MAPS: Netflix’s Multimodal Asset Personalization at Scale netflixtechblog.com +1
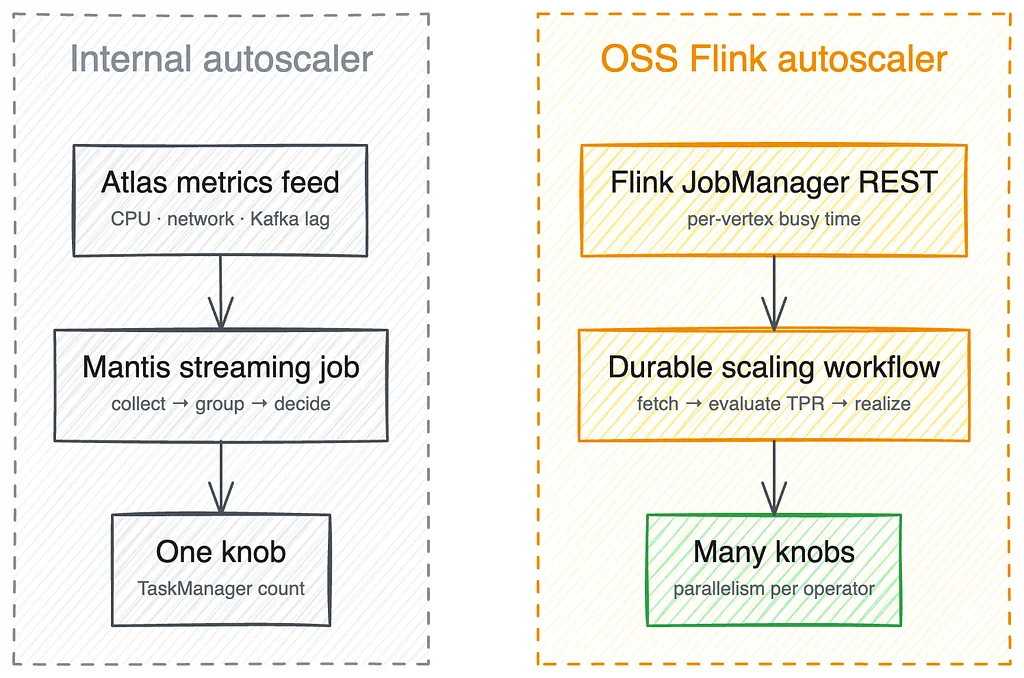
《Flink 两种自动扩缩容器之 tale》 Netflix 目前运行两个 Flink 自动伸缩器,目标是整合为单一开源解决方案。他们最初构建了一个内部自动伸缩器来管理数千个 Flink 作业,该系统行之有效,但在处理复杂的多算子作业时存在局限。该自研系统依赖外部指标,这些指标可能不准确或无法捕捉作业内部的故障。Apache Flink 社区随后开发了一个更为先进的自动伸缩器,能够从作业内部进行推理。该自动伸缩器估算算子的真实处理速率,以确定每个顶点的最佳并行度。Netflix 正趋向于采用这一开源解决方案,因其能够伸缩有状态作业并支持细粒度配置。在 Netflix 部署该开源自动伸缩器需要重大适配工作,包括将其集成到现有的控制平面中。他们还对 Flink 运行时进行了修改,以改进指标收集,并处理特定作业结构,如前向连接子图和 sink 限制。通过采用开源自动伸缩器,Netflix 实现了显著的成本节约和资源利用率提升。经验教训强调,指标质量至关重要,可调节的默认值有益,且在扩展之前先采用现有解决方案是一项明智的策略。他们计划完全迁移至基于开源的自动伸缩器,以简化运营流程。 A Tale of Two Flink Autoscalers netflixtechblog.com +1
Netflix 如何构建实时分布式图:第三部分——使用 gRPC 查询图…… Netflix 构建了一个实时分布式图,以支持其内部合作伙伴的实时洞察,本博客系列的第三部分聚焦于高效查询该图。该图是一个包含数十亿节点和边的复杂网络,对其进行查询需要一个快速且灵活的 serving 层。作者讨论了查询该图所面临的挑战,包括处理广泛的访问模式,并支持浅宽型(shallow-wide)和深窄型(deep-narrow)查询。他们阐述了如何设计一个 serving 层以高效查询该图,采用广度优先(breadth-first)方法和异步组合(asynchronous composition)来最小化延迟。作者还讨论了缓存、按需增强(opt-in enrichments)以及最终一致性(eventual consistency)在查询层设计中的重要性。查询层由三个层级组成:图查询服务(Graph Query Service)、存储抽象层(Storage Abstraction Layer)和增强层(Enrichment Layer),它们协同工作以高效执行查询。作者通过一个示例查询演示了查询层在实际中的运作方式,强调了读取和解析请求、高效从存储读取、以广度优先层级执行遍历、并行运行多个操作、智能过滤,以及利用缓存加速重复查询的重要性。查询层的目标是在 100 毫秒内完成查询,作者展示了其设计如何实现这一目标。查询层旨在每秒处理数万次查询,每次查询可能各不相同,作者讨论了在设计查询层以实现该性能水平时所做出的权衡。总体而言,作者提供了查询层设计与实施的详细概述,突出了构建大规模分布式图的高性能查询层所涉及的挑战与权衡。查询层是实时分布式图的关键组件,作者的设计与实施使 Netflix 能够为内部合作伙伴提供实时洞察。 How and Why Netflix Built a Real-Time Distributed Graph: Part 3 — Querying the graph with gRPC… netflixtechblog.com +1
为分析建模设备能力 Netflix 在各种设备上提供广泛的功能和内容类型,但硬件限制可能导致特定设备无法使用某些功能。为解决这一问题,该公司开发了一套全面的设备能力数据模型,以理解设备能力并确保最佳用户体验。该数据模型整合了内部系统的功能标志(feature flags),从而实现全球设备生态中更智能的功能管理。公司使用累积表存储设备能力信息,例如屏幕分辨率、视频编码配置文件和内存大小,使其非常适合分析与报告。该表的结构能够捕获每台设备的最新状态及其关联能力,从而实现信息的高效处理。对于聚合分析,公司使用直方图表记录过去 28 天内按设备型号和软件版本划分的活跃设备数量,同时记录支持特定能力的设备数量,以支持详细的分布分析。直方图数据可用于分析外部显示能力的分布情况,例如支持高清(HD)或超高清(UHD)配置文件的设备占比。通过利用这些数据集,Netflix 构建了分析产品,以全面展示功能覆盖范围,包括 4K 超高清、Netflix 空间音频和云游戏。公司利用数据驱动的洞察,就哪些功能应在特定设备上启用做出明智决策,从而确保性能与可靠性。 Modeling Device Capabilities for Analytics netflixtechblog.com +1
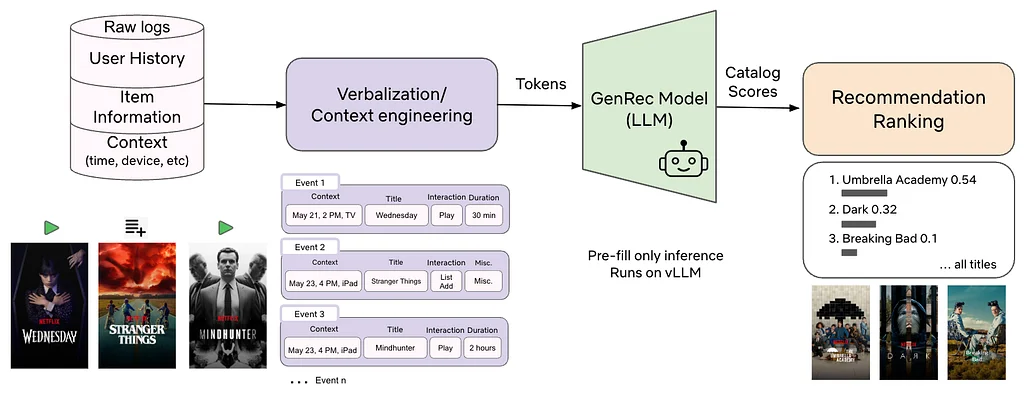
GenRec:迈向Netflix的LLM原生推荐 推荐是 Netflix 体验的关键组成部分,该公司一直使用复杂的生成模型,这些模型依赖数千个手工 crafted 特征和专用架构。然而,这些模型维护与更新成本高昂,公司正寻求更高效、更有效的解决方案。大型语言模型(LLM)在此领域展现出潜力,但尚未达到生产就绪状态,且常存在局限性,例如过度推荐热门内容而忽视业务约束。为此,Netflix 构建了 GenRec,这是一个基于 LLM 的推荐排序器,通过在 Netflix 特定数据和目标上对内部基础 LLM 进行后训练来实现。GenRec 将用户历史、项目元数据和上下文 verbalize 为文本,并利用 catalog-aware 评分头对项目进行排序。该模型采用多目标损失函数进行训练,结合排序、语言和奖励信号,以对齐业务目标和长期会员满意度。与经过良好调优的生产级排序器相比,GenRec 在短期和长期在线指标上均展现出具有统计学意义的提升,同时仅使用少量标注数据和输入信号。该模型部署于 Netflix 内部 LLM 栈,使用 vLLM 进行服务,公司还实施了控制推理成本的策略,包括使用更小模型、激进的上下文压缩以及仅 prefill 推理。总体而言,GenRec 代表了 Netflix 推荐系统迈向更以 LLM 为中心未来的重要一步,其成功有望改变公司处理推荐与个性化方式。该模型从自然语言输入中学习并生成个性化排序的能力,有望提升用户体验并增加参与度。通过利用大型语言模型的力量,Netflix 能够构建更高效、更有效的推荐系统,从而推动业务成功。 GenRec: Towards LLM-Native Recommendation at Netflix netflixtechblog.com +1
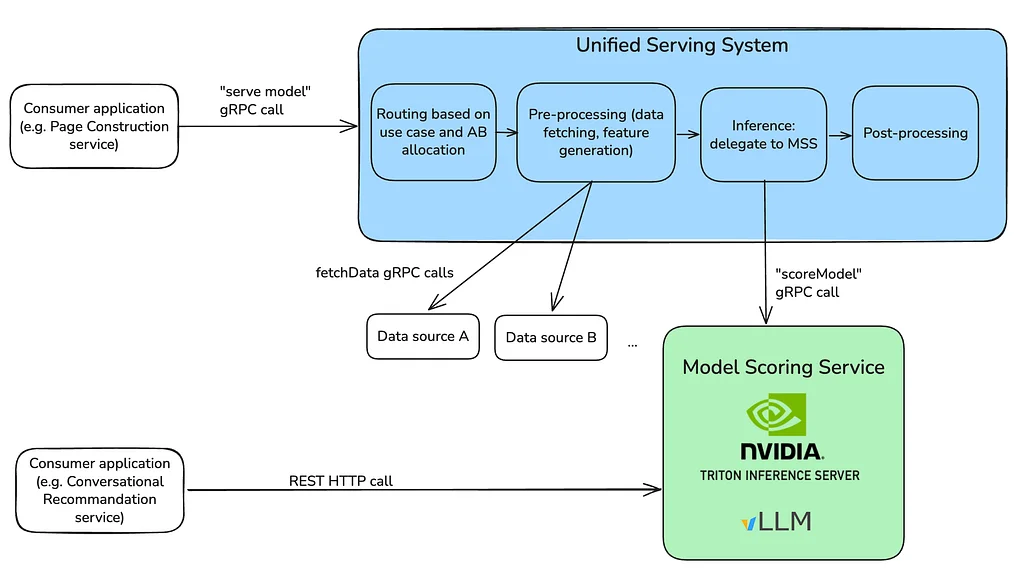
Netflix内部LLM服务 Netflix 在其内部运行整个大型语言模型(LLM)栈,直接管理部署与推理。他们将此集成到现有的生产环境中,而非构建独立的机器学习孤岛。该方案涉及精心选择推理引擎、决定模型打包方式、设计 API 接口、定义部署策略以及强制输出约束。所选的推理引擎为 vLLM,因其操作适配性、支持加载自定义架构、可扩展性、可调试性以及从业人员的熟悉度而被选中。模型采用基于 Triton 的 vLLM 后端进行打包,以支持动态 I/O 张量规格,从而促进模型与前端端的独立演进。此外,在其现有的 gRPC 接口旁增加了一个兼容 OpenAI 规范的 HTTP 前端,以增强与更广泛生态系统的兼容性。在部署方面,Netflix 采用版本化(Versioned)策略来处理不同模型版本之间可能出现的模式(schema)变更,使消费者能够独立更新。当模型接口保持稳定时,则采用成本较低的蓝黑部署(Red-Black)策略。一个关键的操作挑战是模型启动时间过长,他们通过在 Amazon FSx 上预置大型模型来解决这一问题,以实现更快的访问速度。可观测性通过创建一个统一的 /metrics 端点得到提升,该端点聚合来自 vLLM 和 Triton 的数据。一个显著特性是大规模受限解码(constrained decoding),通过 vLLM 的自定义 logits 处理器实现。这使得模型能够直接生成合规输出,避免了推理后的修正步骤。受限解码的初始纯 Python 实现因全局解释器锁(GIL)以及 CPU 上的顺序处理而在扩展性上遇到困难。这一问题仅在高度并发下显现,导致显著的尾部延迟。该系统依赖 Java 控制平面来管理部署、版本控制和自动扩缩容。其服务系统同时支持实时推理和缓存的批量推理路径。这一统一系统处理完整的下游消费者流程,包括路由、候选生成和日志记录。 In-House LLM Serving at Netflix netflixtechblog.com +1
大规模构建服务拓扑:架构、挑战与经验教训 Netflix 开发了一项实时服务依赖图谱,以协助工程师排查问题并理解其分布式架构。该系统将 eBPF 网络流、IPC 指标和分布式追踪整合为独立的图层。初始版本虽在本地运行正常,但在生产环境中暴露出显著的扩展挑战,包括 Kafka 消费者延迟和内存问题。核心架构决策是采用以流式处理为首的方法,提供近乎实时的拓扑更新,而非每小时一次的批处理。这对于事件响应和实时事件监控至关重要。为每秒处理数百万条流记录且无数据丢失,系统采用带背压机制的反应式流,当下游系统过载时,向上传组件发出信号以减缓处理速度。这确保了优雅降级,而非崩溃或数据丢失。该架构采用多层设计,对网络、IPC 和追踪层实施物理存储隔离,从而实现独立优化。网络层的摄入依赖一个三阶段分布式聚合管道:第一阶段从 Kafka 执行初始聚合;第二阶段将网络中间件(如负载均衡器)解析为直接的应用层依赖;第三阶段负责最终聚合、与外部数据融合以及持久化到图数据库。三阶段管道是从初始两阶段设计的关键演进。初始设计因在中间件解析和富集过程中数据集中而导致“热点节点”问题。通过将职责分散到三个阶段,可均衡工作负载,避免瓶颈。此外,由于 gRPC 在大规模场景下存在性能开销,消耗过多 CPU 和内存,各阶段间的通信改用服务器发送事件(SSE)替代了 gRPC。 Building Service Topology at Scale: Architecture, Challenges, and Lessons Learned netflixtechblog.com +1
GenPage:迈向 Netflix 端到端生成式主页构建 Netflix 主页是一个高度个性化且结构化的内容发现界面。传统上,其生成涉及复杂的多阶段流水线。GenPage 是一种新颖的方法,利用单个生成式 Transformer 模型自回归地构建整个主页。该端到端模型以用户上下文为提示,同时生成行、实体和布局。关键目标包括简化推荐栈、通过强化学习实现整页优化,并提升可扩展性与灵活性。生产挑战涉及实时服务延迟、实体冷启动以及保持模型新鲜度。在 A/B 测试中,GenPage 显著提升了用户参与度并降低了服务延迟。数据被分词为表示用户信息的上下文令牌和表示主页结构的页面令牌。与通用文本分词相比,领域特定的分词提升了计算效率并增强了对产品的控制。用户历史、个人资料和请求上下文构成提示,而实体和行则作为令牌出现在生成的页面中。系统采用基于用户反馈的奖励机制来量化推荐价值并指导训练。GenPage 采用标准的仅解码器 Transformer 架构,并遵循类似大语言模型的训练流程,即预训练和后训练。预训练使用下一个令牌预测来教授模型主页的语言,随后通过加权二元分类或强化学习进行后训练。这种生成式方法为优化整个 Netflix 主页体验提供了更加集成和直接的途径。 GenPage: Towards End-to-End Generative Homepage Construction at Netflix netflixtechblog.com +1
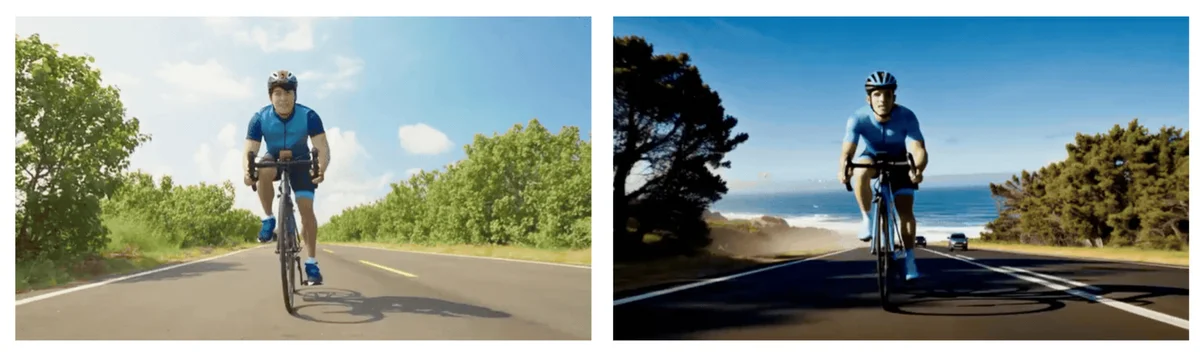
迈向更可控的 AI 视频编辑:Netflix 的早期研究探索 Netflix 研究人员开发了两款人工智能工具,以协助视频编辑人员制作宣传素材。第一款工具名为 Vera,是一种用于内容保留编辑的分层视频扩散模型。Vera 将编辑结果生成为独立图层,使原始素材中未修改的部分保持原样,从而保留人物身份与细节。为训练 Vera,研究团队构建了一个专用数据集,并采用混合 Transformer(Mixture-of-Transformers)架构以实现高效的输出生成。评估结果显示,Vera 在内容保留方面显著优于现有方法,同时视频质量相当。第二款工具名为 VOID,是一个视频对象及交互删除框架。VOID 解决了在移除具有显著交互作用的物体时可能产生物理上不合理的结果这一挑战。它采用两阶段推理流程:第一阶段生成物理上合理的反事实视频;第二阶段对输出进行细化,以防止物体形变等伪影。VOID 使用基于仿真生成的合成数据以及真实世界动作捕捉数据进行训练。实验表明,与以往方法相比,VOID 能更好地保持场景动态的一致性。这些研究探索旨在负责任地推进 AI 视频编辑技术,同时赋能创作者。Vera 和 VOID 的详细信息均发表于公开的研究论文中。 Toward More Controllable AI Video Editing: An Early Research Exploration at Netflix netflixtechblog.com +1
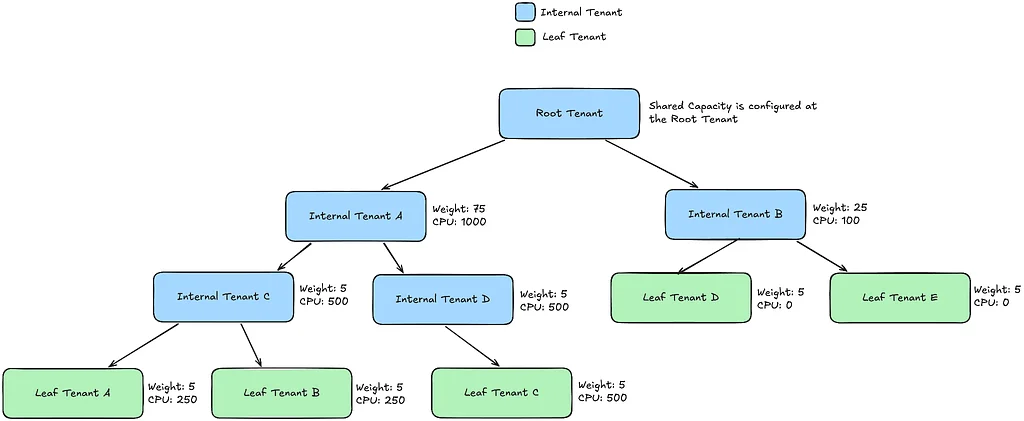
Netflix 如何借助 Kueue 简化批处理计算 Netflix 正将其计算基础设施向 Kubernetes 原生模型过渡,并将 Kueue 等组件集成到其 Titus 平台中。作为一款云原生任务队列系统,Kueue 已基本取代了其自研批处理解决方案 Compute Managed Batch(CMB)中的自定义逻辑。 此次迁移的动因包括 CMB 系统已使用多年、Kubernetes 的不断演进,以及在现有系统中添加预抢占等功能日益困难。最终选择 Kueue 而非其他替代方案,是因为它与现有的 Titus 调度配置文件兼容,采用势头强劲,并且原生支持预抢占等功能。此次迁移项目名为“Netflix Batch”,旨在实现对用户零影响且不降低吞吐量。该过程涉及将作业提交重定向至已启用 Kueue 的 Titus 单元,并由 Titus 联合机制负责作业分发。 运维调整非常有限,主要涉及一个简单的 UI 开关,用于将租户注册到 Kueue 中。此注册过程将 CMB 现有的租户层次结构和容量配置转换为 Kueue 中的“Cohorts”、“ClusterQueues”和“LocalQueues”概念。关键经验教训包括:保持与旧系统的 API 兼容性以确保用户体验顺畅,以及尽早迁移复杂用例以建立信心。对 Kueue 进行负载测试以确保其能够满足 Netflix 的高吞吐量要求也至关重要,这需要对默认配置进行调整。 目前,Kueue 已全面投入运行,管理着数百万个批处理工作负载,并实现了增强的公平共享和抢占功能。这些改进有助于更好地利用预留容量、减少作业饥饿现象,并加快关键工作负载的周转速度,从而显著提高了平均资源利用率。 How Netflix Simplified Batch Compute with Kueue netflixtechblog.com +1
Cassandra 中针对时序工作负载动态拆分宽分区 Netflix 的 TimeSeries Abstraction 利用 Apache Cassandra 作为存储,以毫秒级延迟摄入和查询 PB 级的时序事件数据。宽分区(即单个分区随时间累积大量事件)对时序工作负载构成重大挑战,导致 Cassandra 集群中出现高读取延迟、超时、CPU 利用率上升以及垃圾回收停顿。为此,TimeSeries 数据被划分为离散的时间块,形成可管理的段。初始的预配策略依赖用户指定的工作负载特征和蒙特卡洛模拟来确定最优的基础设施和分区配置。然而,当工作负载未知、估算不准确、随时间演变或包含数据异常值时,该方法证明不足。为自动化调整,引入了后台工作进程,用于监控分区直方图,并根据观测到的数据密度动态重新划分未来的时间片。这种时间片重划分策略在大多数数据表现出类似宽分区行为时,能有效降低读取延迟和超时。然而,该策略并未解决仅少数 ID 在表中呈现宽分区的场景。针对此类情况,以及当调用方即使面临较高延迟也需要获取全部数据时,开发了按 ID 的动态分区。该异步流水线在读取操作期间检测宽分区,并将其透明地分割为最优大小。该过程包括检测、规划与分割,以及通过重定向查询至分割后的分区来服务读取请求。检测发生在读取操作超过配置的字节阈值时,此时会向 Kafka 发出事件。系统最初专注于不可变分区以简化实现。规划阶段读取整个分区以生成分割计划,并利用检查点机制处理故障。分割涉及将数据划分委托给特定策略,例如将更多事件桶分配给时间桶。验证分割至关重要,通过校验和确保数据完整性后再标记分割完成。最后,TimeSeries 服务器使用内存中的布隆过滤器高效地将读取查询重定向至分割后的分区,使得该重定向对调用方而言几乎不可见。 Dynamically Splitting Wide Partitions in Cassandra for Time Series Workloads netflixtechblog.com +1
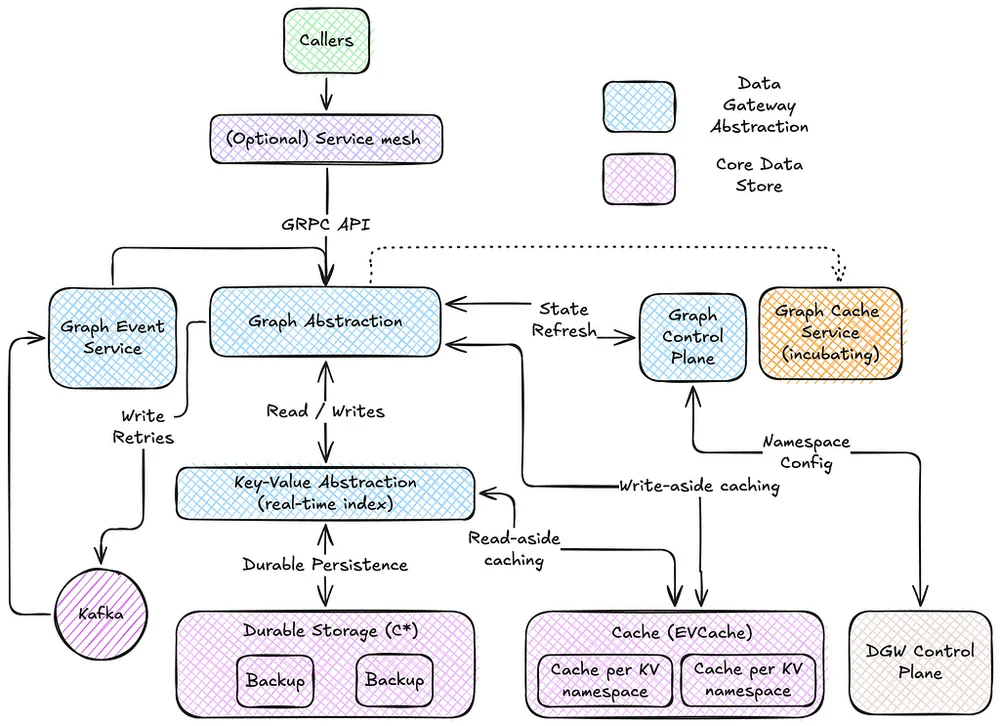
Netflix 的高通量图抽象:第一部分 Netflix 构建了一种图抽象层,以处理高吞吐、低延迟的图操作,尤其适用于实时分布式图和社会关系图等场景。该抽象层涵盖两个类别:用于深度分析的 OLAP 和用于流式用户体验的 OLTP。该抽象层采用属性图模型,具有强类型的节点和边,并划分为隔离的命名空间。每个命名空间拥有预定义的图模式,通过数据网关控制平面进行管理。该模式支持数据质量强制约束和高效查询规划等优化措施。实时索引对节点和边采用键值存储,并为链接和属性分别建立索引。边链接通过源 - 目标关系进行索引。为确保无论方向如何均可访问,该设计按字典序组织标识符。缓存机制用于最小化写放大和读放大。该抽象层的架构优先考虑高性能,并采用了如写旁路缓存等策略。 High-Throughput Graph Abstraction at Netflix: Part I netflixtechblog.com +1
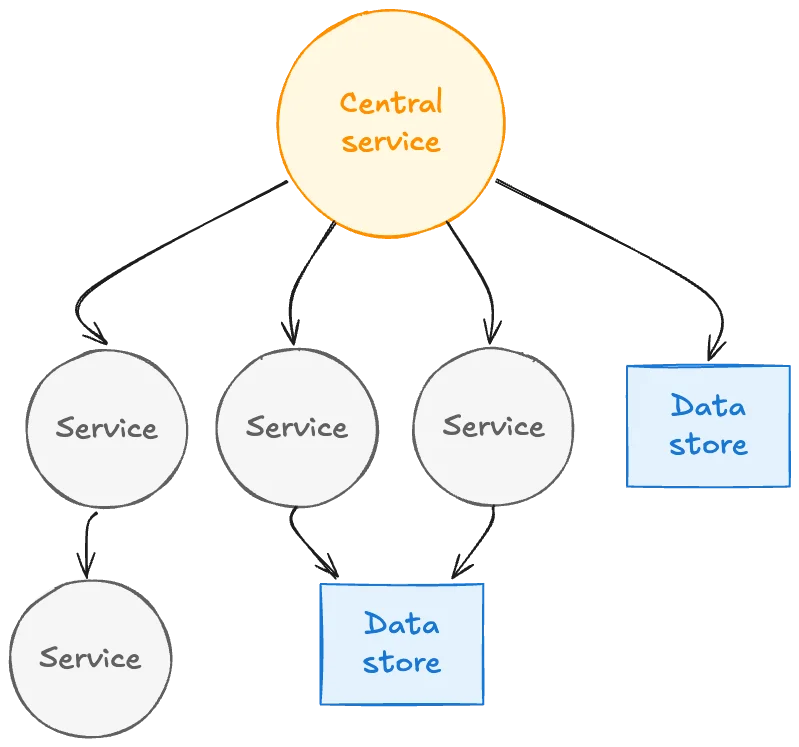
从孤岛到服务拓扑:Netflix 为何构建实时服务地图 Netflix 开发了一种名为“服务拓扑”(Service Topology)的分布式基础设施“动态地图”,以帮助工程师理解服务依赖关系并排查问题。该地图旨在满足更快识别服务关联及故障期间潜在影响的需求,能够回答诸如哪些服务相互依赖、问题源头何在等关键问题。数据来自三个来源:eBPF 网络流、IPC 指标以及端到端追踪。每个数据源提供独特的视角——网络连接性、应用层细节以及实际请求流。这种多层架构将这些视图整合为统一的实时地图。系统为每个数据源使用独立的图数据库,以保持独立性并支持并行查询。工程师可以单独查看每个图,或将它们组合起来,以获得对服务交互的全面理解。系统从多个区域的 Kafka 中摄入流日志,进行处理,并将数据存储于图数据库中。这一动态地图帮助 Netflix 工程师快速诊断并解决问题,从而确保流畅的流媒体体验。 From Silos to Service Topology: Why Netflix Built a Real-Time Service Map netflixtechblog.com +1
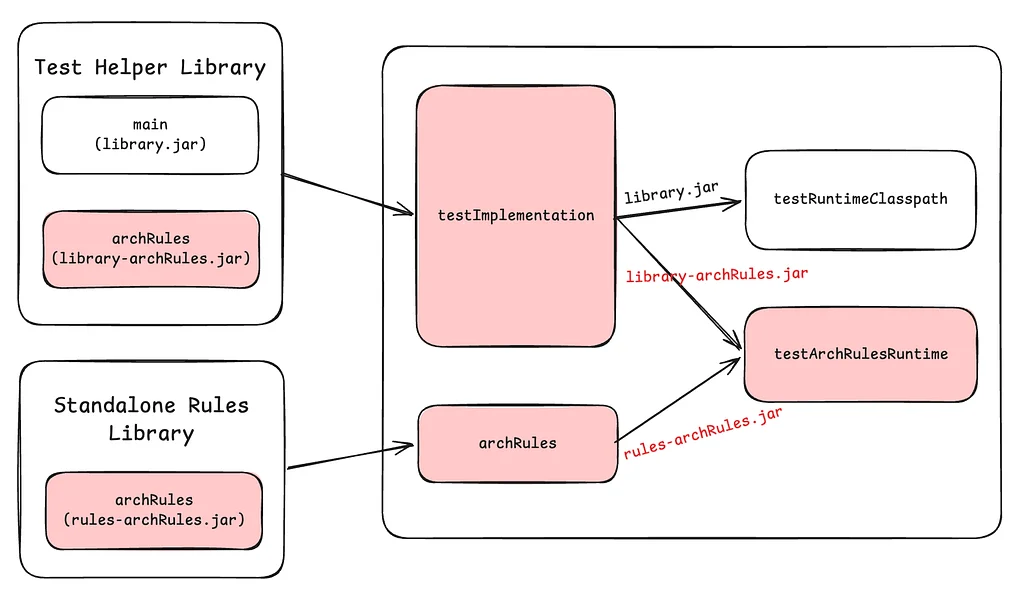
使用 Nebula ArchRules 扩展 ArchUnit Netflix 采用多仓库策略,管理着数千个 Java 仓库,需要高效的构建逻辑共享。为此,他们构建了 Nebula 系列 Gradle 插件,其中包括 ArchRules,用于管理依赖并强制执行代码规范。该举措源于对 Java 库生命周期管理的改进需求,起因是一次向后不兼容变更引发的事故。Netflix 利用 API 生命周期注解(@Deprecated、@Public、@Experimental)来识别废弃代码可能带来的问题。ArchUnit 是一款广受欢迎的用于强制执行架构规则的库,被选中用于检测这些注解的误用及其他技术债务问题。Nebula ArchRules 插件实现了 ArchUnit 规则在多个仓库间的共享与应用,从而增强了功能。ArchRules 使用字节码分析(ASM)支持跨语言,并通过易于使用的构建者模式简化规则创建。规则可以打包在库中,或定义在独立的规则库中,由插件自动检测并运行。ArchRules Runner 插件针对源集评估规则,并生成 JSON 和控制台报告,从而提升了报告能力。通过使用 ArchRules,Netflix 为库作者提供了一个平台,用于追踪 API 使用情况并检测废弃 API 的误用。 Scaling ArchUnit with Nebula ArchRules netflixtechblog.com +1
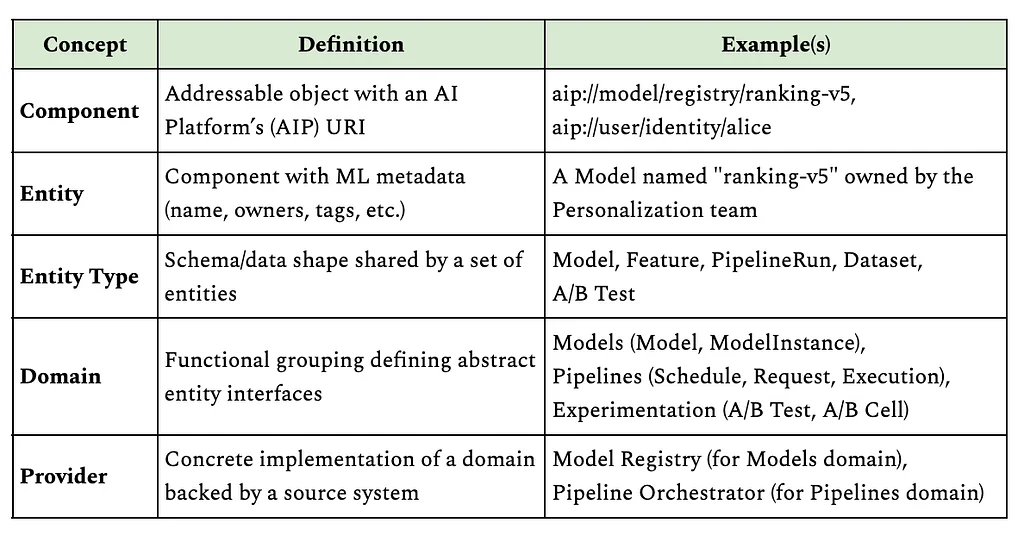
Netflix 实现机器学习民主化:构建模型生命周期图谱 Netflix 在个性化、制片厂制作、支付和广告等多个业务领域广泛采用机器学习。随着机器学习(ML)应用的扩展,一个挑战随之出现:模型与数据分散在孤岛中,阻碍了协作与发现。机器学习从业者难以理解模型血缘、特征来源及其在不同系统中的影响。这种碎片化使得关于现有特征、数据来源、管道依赖以及变更影响的查询难以获得便捷答案。核心难点在于连接生成元数据的异构机器学习基础设施组件。从管道编排器到实验平台和特征存储,数十个系统以各种格式产生数据。解决这一问题需要收集异构元数据,将其转换为统一模型,并构建一个用于探索的连接图。解决方案是元数据服务(MDS),它在 Netflix 内部构建模型生命周期图(Model Lifecycle Graph),以互联机器学习实体。MDS 实时摄入机器学习元数据,支持跨域查询,例如识别使用特定模型的实验,或共享某些特征的模型。其愿景是使公司内所有机器学习资产均可被发现、可理解且可复用。MDS 基于以下核心抽象构建:组件(Component),每个拥有唯一的 AIP URI;实体(Entity),即具有属性的机器学习专用资产;实体类型(Entity Type),定义数据形状;域(Domain),用于分组相关的实体类型;以及提供者(Provider),即来自源系统的域的具体实现。这种基于 URI 的地址机制允许任何服务以通用方式引用任何机器学习资产。构建该图的过程包含多个阶段。首先,MDS 通过 Kafka 和 AWS SNS/SQS 与源系统集成,消费表示变更的轻量级事件。专用的事件处理器处理来自管道编排、模型注册表、特征存储、实验平台和身份平台等系统的事件。其次,MDS 实现水合契约(hydration contract),验证事件并调用源系统 API 获取完整状态,随后将其转换为标准化实体。这种“变更通知”模式确保了针对事件顺序问题的鲁棒性,但会将读取负载施加到源系统上。第三,原始事件被转换为具有标准化字段的统一实体模型,为下游消费者提供一致接口。标准化实体统一字段名称和格式,并将平台特定 ID 转换为全局 AIP URI。最后,标准化实体被持久化到 Datomic 用于缓存和关系存储,同时也在 Elasticsearch 中建立索引。Datomic 凭借其不可变事实模型,支持复杂的图遍历和实体关系查询,使得跨多域查询无需低效的 N+1 查询模式。 Democratizing Machine Learning at Netflix: Building the Model Lifecycle Graph netflixtechblog.com +1
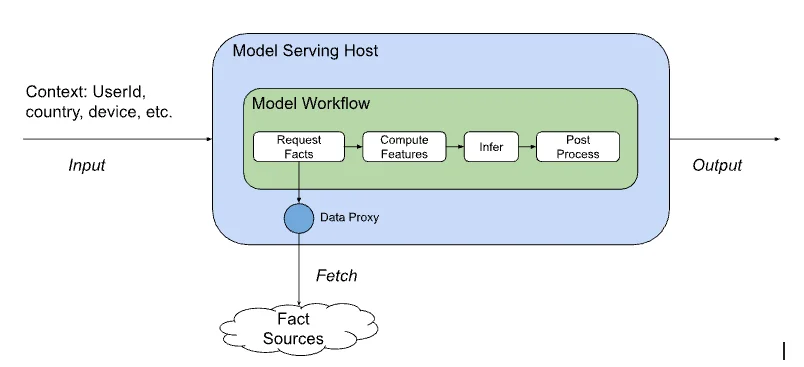
模型服务中的路由状态 该博客文章深入探讨了 Netflix 机器学习(ML)模型服务基础设施如何在多个领域以大规模方式支撑个性化体验的技术见解。中央 ML 模型服务平台向多个领域特定的微服务暴露了与领域无关的 API 抽象和流量路由能力,用于模型推理。这一统一的 API 加快了现有 ML 体验新版本的迭代创新速度,并支持通过 ML 实现新产品体验。ML 模型服务基础设施的成功取决于使研究人员能够快速验证新假设,并安全地将模型发布到生产环境。该平台服务于数百种模型类型和版本,每秒处理 100 万次请求,其运作层级为工作流,而不仅仅是单个评分函数。模型定义包含一组用于计算特征的必要事实,并依赖模型服务平台在推理时通过调用其他微服务来提供这些事实。调用服务仅需提供标准请求上下文和相关领域上下文,模型即可在执行流程中自行计算特征并执行推理。该平台作为快速 ML 创新的推动者,同时将 ML 模型迭代对客户端应用的暴露降至最低。平台的关键原则包括:模型创新与客户端应用解耦、客户端与模型分片解耦,以及灵活的流量路由规则。该平台使用一个名为 Switchboard 的自定义服务,作为所有流量的灵活代理层,每秒处理超过 100 万次请求,同时保持高可用性和高可靠性。Switchboard 为所有客户端的模型需求提供单一接入点,并可根据丰富的上下文特征集对请求进行路由。平台还引入了"Objective"的概念,这是由服务平台定义的一种枚举,系统中每个进入的请求都必须提供该 Objective。Objective 将客户端与具体模型解耦,并指导平台的流量路由和模型选择决策。Switchboard Rules 是一种 JavaScript 配置,允许研究人员在不修改客户端代码的情况下,将模型变体、实验和流量拆分绑定到 Objective 上。这些规则规定了给定 Objective 的默认模型、为一系列 Objective 配置的 A/B 实验,以及逐步将流量迁移到新模型的自定义策略。这些规则由 Switchboard 和模型服务集群共同消费,服务平台组件可基于这些规则采取各种操作。总体而言,该平台为 Netflix 提供了一套可扩展且灵活的 ML 模型服务解决方案,在最小化对客户端应用影响的同时,实现了快速创新与实验。 State of Routing in Model Serving netflixtechblog.com +1
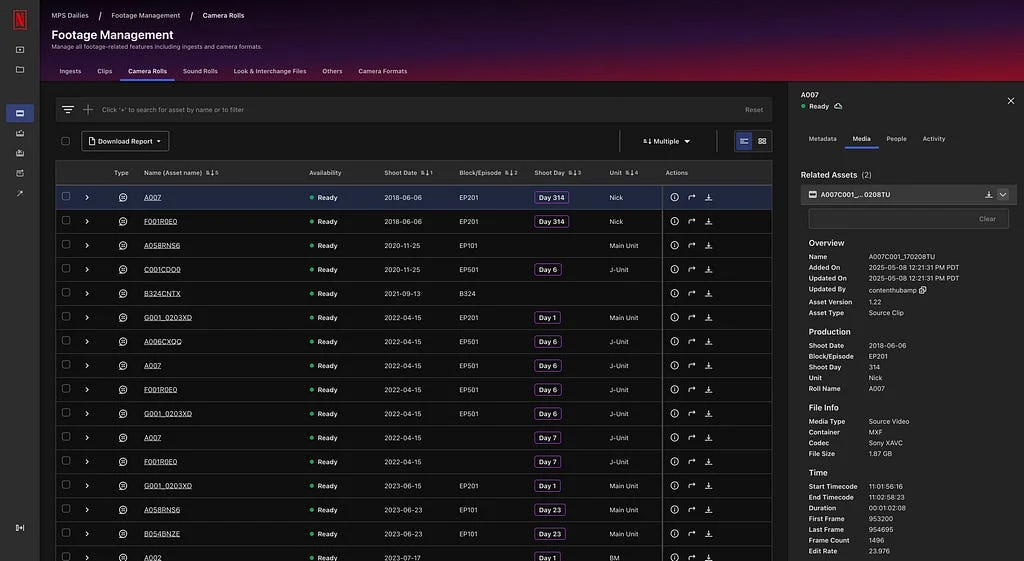
Netflix 的相机文件处理规模化 Netflix 构建了媒体制作套件(Media Production Suite,简称 MPS),旨在为全球制作项目优化媒体工作流程,以实现效率与一致性。MPS 的核心依托 FilmLight 的应用程序接口(FLAPI)进行图像处理,这一合作避免了从零开始构建所有功能。MPS 解决了文件管理混乱和媒体处理不一致等挑战,通过自动化任务并最大限度减少错误来提升效率。FLAPI 用于检查相机文件的元数据、对其进行标准化处理并使其可搜索,从而确保数据的一致性。此外,FLAPI 还能生成具有精确色彩管理和去马赛克处理的视觉特效底片及交付成果。MPS 通过 Cosmos 实现云集成,支持在 Docker 化环境中仅使用 CPU 实例,从而最大化运行效率。生产负载采用弹性处理方式,可根据需求动态扩展,确保快速交付。MPS 既适用于经验丰富的团队,也能为需要指导的团队提供支持,而 FLAPI 则负责处理其中的复杂性。这一合作促进了开放沟通与联合验证,有利于标准化生态系统的建设。总体而言,其成效包括减少延误、加快交付周期以及提升制作流程的整体效率。 Scaling Camera File Processing at Netflix netflixtechblog.com +1
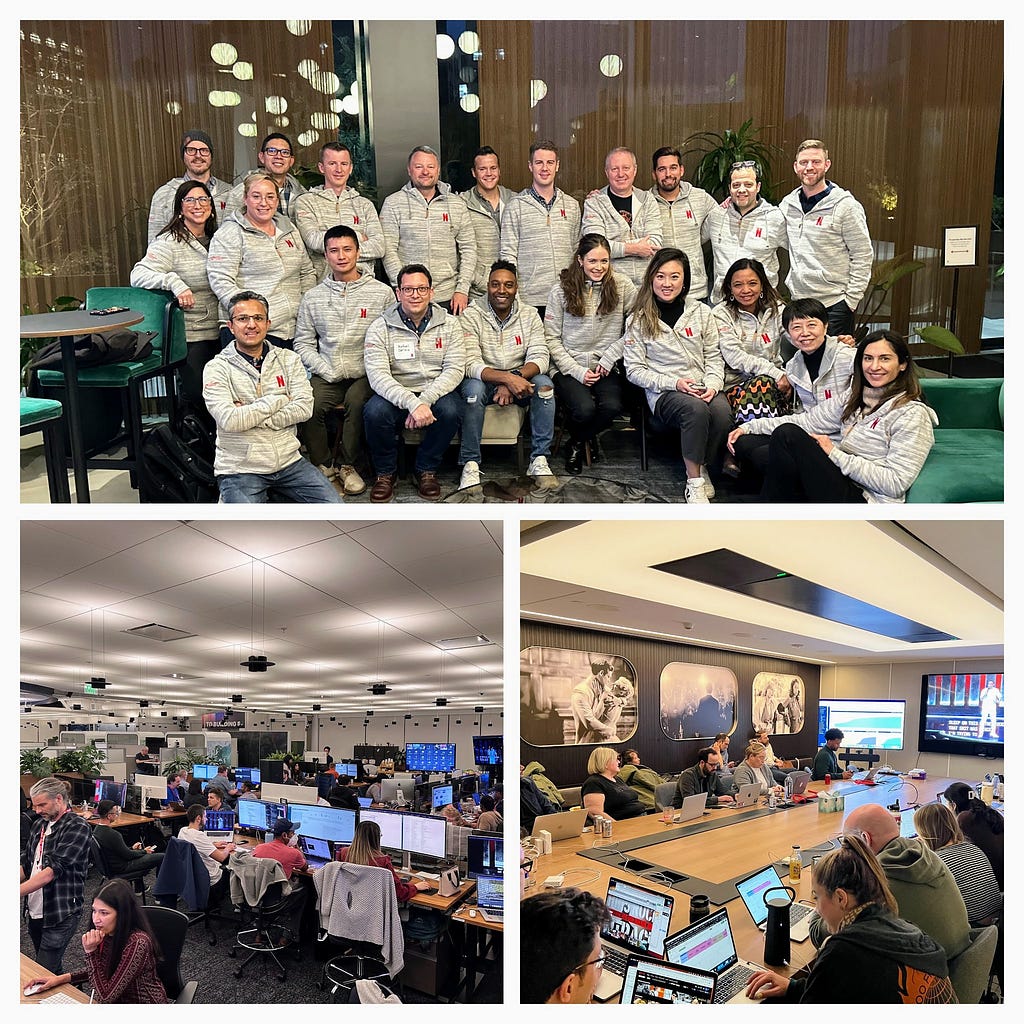
《人类基础设施:Netflix 如何构建支撑“大规模直播”的运营层》 自 Netflix 推出首场直播节目以来,其直播流媒体业务迅速扩张,目前已实现每日多场活动同步直播。早期的直播节目依赖工程师和临时搭建的方案,缺乏专门的运营团队。随着业务发展,Netflix 建立了专用的广播运营中心(BOC),以管理直播播出流程。为确保信号可靠性,Netflix 对场馆提供的音视频素材制定了严格的技术规范。Netflix 的运营模式经历了多个阶段演进,从以工程为主导的运营模式逐步发展为由专业化工程团队支撑的体系。为此,公司推出了传输运营中心(TOC)模式,以提升效率并支持高并发事件的管理。在 TOC 模式中,传输、流媒体和广播控制操作员等关键角色各司其职。对于重大高关注度活动,Netflix 采用专门的“大赌注”(Big Bet)模式,配置专属资源。直播指挥中心(LCC)负责监控整个直播流媒体链路,为操作人员提供实时数据支持。LCC 采用自研的可观测性技术栈,以应对海量数据并快速响应各类问题。LCC 运营负责人与技术发布经理则负责突发事件的应急响应。 The Human Infrastructure: How Netflix Built the Operations Layer Behind Live at Scale netflixtechblog.com +1
用 "法官即法律硕士 "评估 Netflix 节目概要 Netflix 旨在优化其庞大内容库的简介筛选流程。数千部作品使用户的选择变得复杂,因此简介在决策过程中至关重要。高质量的简介能够提升用户参与度,而低质量的简介则会导致用户沮丧并放弃观看。挑战在于如何将质量验证规模化,以覆盖数十万条简介。Netflix 开发了一种基于大语言模型(LLM)的方法,从四个关键维度评估简介质量。该系统与创意撰稿人的意见一致性超过 85%,确保了由专家主导的质量标准。简介质量既通过撰稿人定义的创意质量进行评估,也结合会员的隐性反馈(如流媒体指标)进行衡量。"LLM 作为裁判”系统采用分层推理、共识评分和事实核查代理等技术,以优化评估准确性。这些由 LLM 生成的质量评分与关键流媒体指标(如取用比例和放弃率)存在相关性。这使得 Netflix 能够主动识别并修复简介问题,从而提升会员体验和内容发现效果。 Evaluating Netflix Show Synopses with LLM-as-a-Judge netflixtechblog.com +1
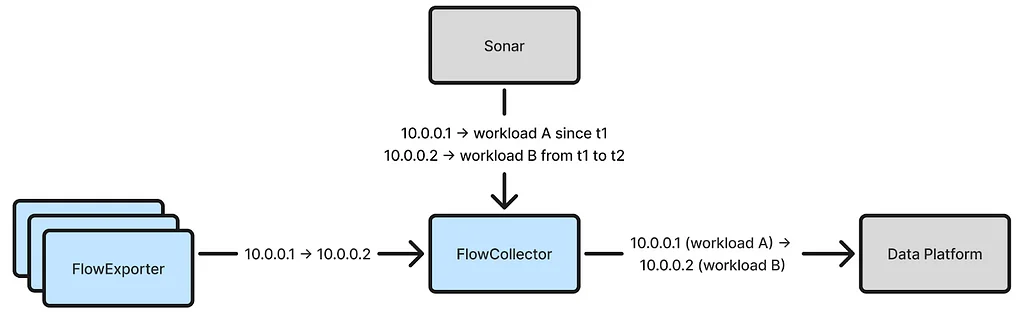
Netflix 如何准确地将 eBPF 流日志关联起来 Netflix 使用 eBPF 捕获大规模 TCP 流日志以获取增强的网络见解,但准确地将流 IP 地址归因于工作负载身份是一个significant挑战。初始归因方法依赖于 Sonar,一个内部 IP 地址跟踪服务,但它由于分布式系统中的延迟和故障而导致了误归因。误归因使流数据不可靠,用于决策,并且在归因前等待 15 分钟的解决方法也无法消除该问题。为了解决这个问题,Netflix 开发了一种新的归因方法,该方法通过确定环境中的本地工作负载身份来归因本地 IP 地址。对于容器工作负载,Netflix 利用 IPMan,一个容器 IP 地址分配服务,来归因本地 IP 地址。一旦本地 IP 地址被归因,远程 IP 地址可以通过学习每个工作负载拥有的 IP 地址的时间范围来归因。FlowCollector 维护一个内存哈希表来表示这种知识,并使用 Kafka 与其他节点共享学习的时间范围。新的方法实现了准确的归因,并且可以优雅地处理暂时性问题,同时由于其简单性和内存查找也具有成本效益。该方法被扩展到归因跨区域 IP 地址,方法是将流转发到相应区域的节点。最后,该方法进一步扩展到归因非工作负载 IP 地址,如 Netflix 的内容交付网络所属的 IP 地址。 How Netflix Accurately Attributes eBPF Flow Logs netflixtechblog.com +1