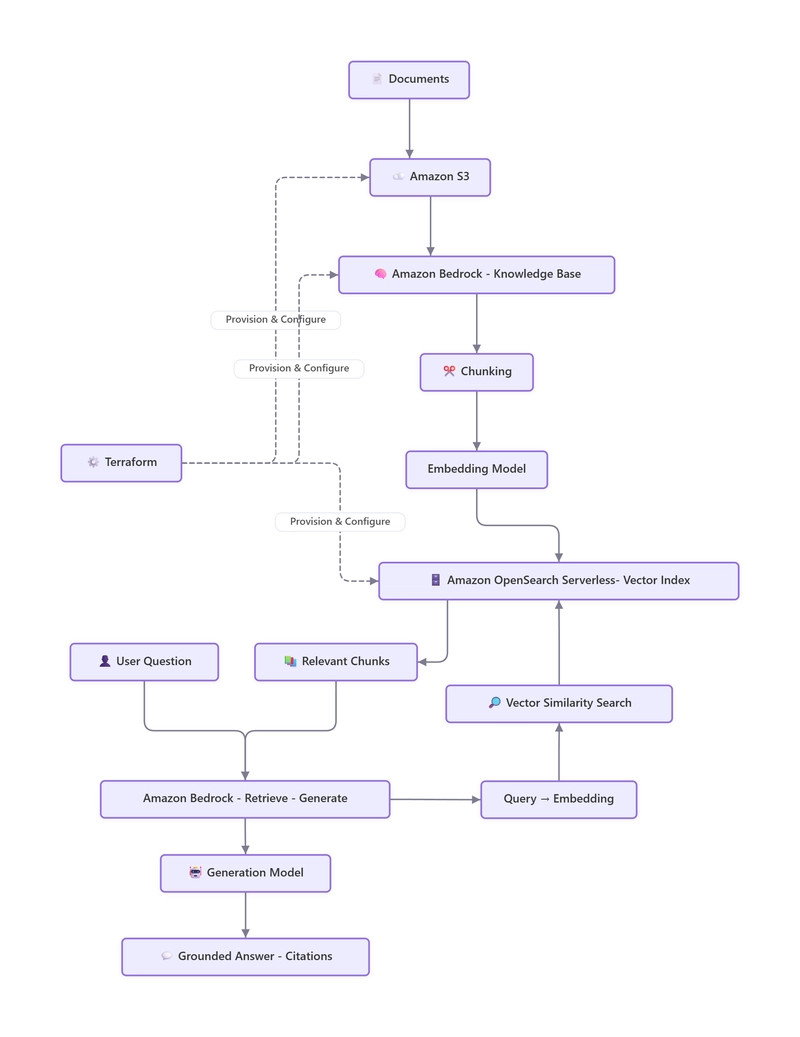
使用 Terraform 在 AWS 上实现 RAG,涉及 S3、Bedrock KnowledgeBase、OpenSearch Serverless 和 IAM
本文详细介绍了如何在 AWS 上利用 Terraform、S3、Bedrock Knowledge Bases 和 OpenSearch Serverless 实现检索增强生成(RAG)系统。RAG 允许大型语言模型(LLMs)利用外部知识源进行答案生成,从而提高准确性。RAG 流程包含两个主要阶段:摄入和查询。在摄入阶段,来自 S3 的文档被分块,由 Bedrock 转换为数值嵌入(embeddings),并存储于 OpenSearch Serverless 中。查询阶段涉及将用户问题转换为嵌入,从 OpenSearch 检索相关文档分块,并将其作为上下文供 LLM 生成带有引用的基于事实的答案。该系统使用 Amazon S3 作为文档源,并采用 Amazon Bedrock Knowledge Bases 管理摄入流程。OpenSearch Serverless 被配置为向量数据库,使用 knn_vector 字段存储嵌入,并采用 HNSW 与 FAISS 实现高效的相似度搜索。OpenSearch 索引还存储原始文本和元数据,支持向量搜索、词项搜索及基于元数据的过滤搜索。向量比较采用余弦相似度。Terraform 脚本定义了 AWS 基础设施,包括 IAM 角色、S3 存储桶、Bedrock Knowledge Base 配置以及 OpenSearch Serverless 访问策略。一个 Streamlit 应用程序提供了用户界面,用于上传文档至 S3、触发知识库同步以及向 RAG 系统提交查询。此全面配置为构建自定义 RAG 系统提供了一个实用的起点。