Amazon SageMaker AI 上的专家混合(Mixture-of-Experts)内核工程
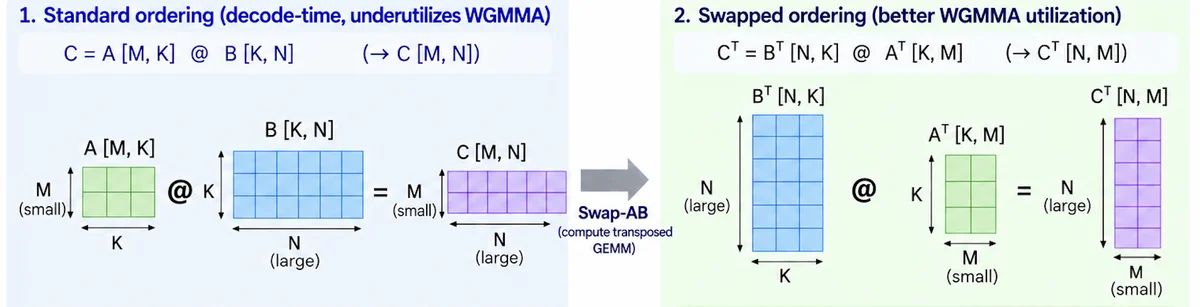
AWS 工程师分享了针对 Amazon SageMaker AI 上融合式混合专家(MoE)模型的内核优化:利用 Swap-AB 提升 WGMMA 利用率,通过 Triton 后端路由实现 FP8 量化,并消除 Triton JIT 重新编译。这些优化共同实现了 H200 GPU 上高达 10% 的吞吐量提升和高达 9% 的首个 Token 生成时间(Time to First Token)缩短。