AWS Machine Learning Blog 中文 关注 提供的 URL 是 Amazon Web Services (AWS) 机器学习博客。该 AWS 网站部分展示了关于机器学习技术的文章和更新、如何使用 AWS 以及机器学习在实际应用和用例中的应用。这些博客旨在帮助开发者、科学家和工程师了解如何利用机器学习来执行各种任务,如预测分析、自然语言处理和计算机视觉等。此博客部分还讨论了机器学习领域中的新兴趋势和如何将其与 AWS 服务集成。 AWS Machine Learning Blog aws.amazon.com RSS aws.amazon.com AWS Machine Learning Blog 中文 RSS thenote.app
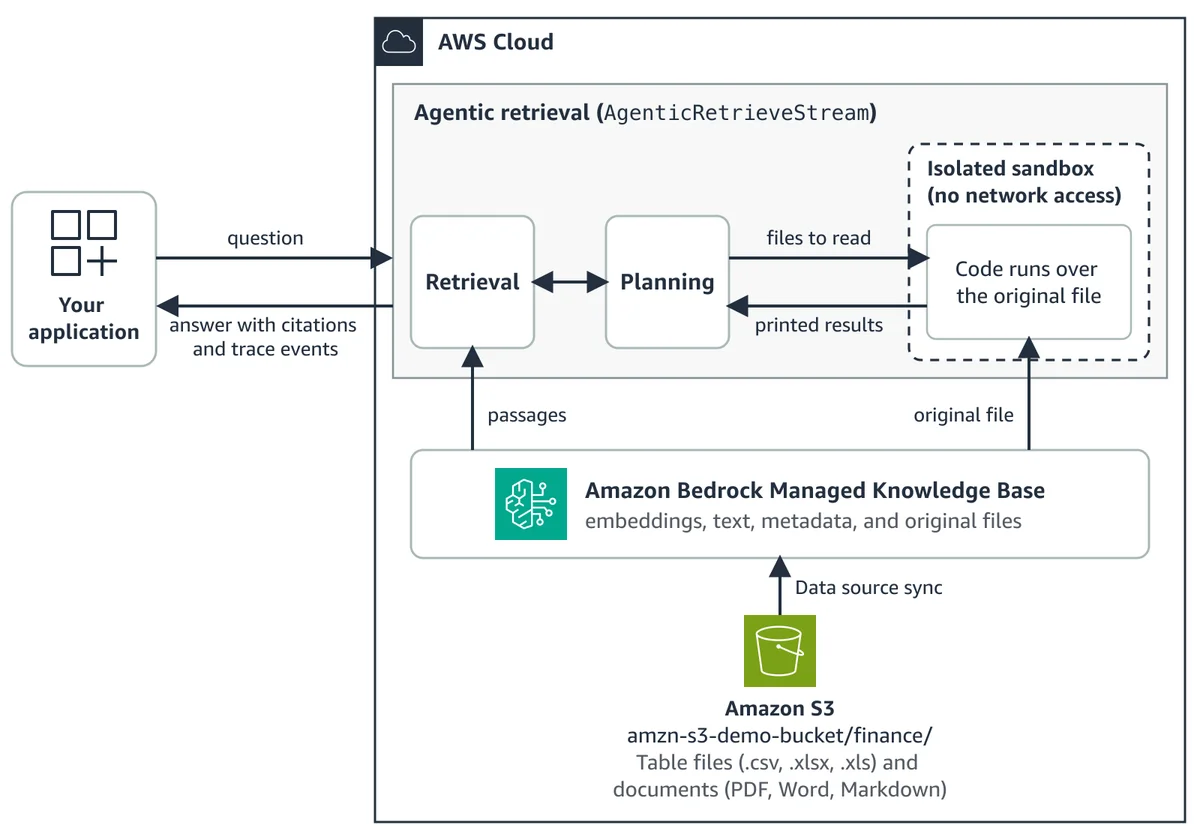
在 Amazon Bedrock 托管知识库中,通过表格搜索从表格获取答案 Amazon Bedrock 托管知识库现已支持表格搜索,因此代理检索功能可针对 CSV、XLSX 和 XLS 文件回答问题。它会检索相关行中的所有值并执行跨行计算,随后将结果与相关文档中的事实相结合,以回答多步骤分析性问题。 Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base aws.amazon.com +1
在 Amazon Bedrock Guardrails 中编写拒绝主题的编写最佳实践 在 Amazon Bedrock Guardrails 中,通过“拒绝主题”(Denied Topics)功能,您可以使用自然语言描述内容类别以进行拦截;该功能基于语义匹配而非关键词匹配,这可能导致拦截范围超出预期。本文介绍了八项最佳实践,帮助您精准撰写主题,使 Guardrails 能够拦截您希望阻止的内容,同时放行您希望允许的内容。 Best practices for writing Denied Topics in Amazon Bedrock Guardrails aws.amazon.com +1
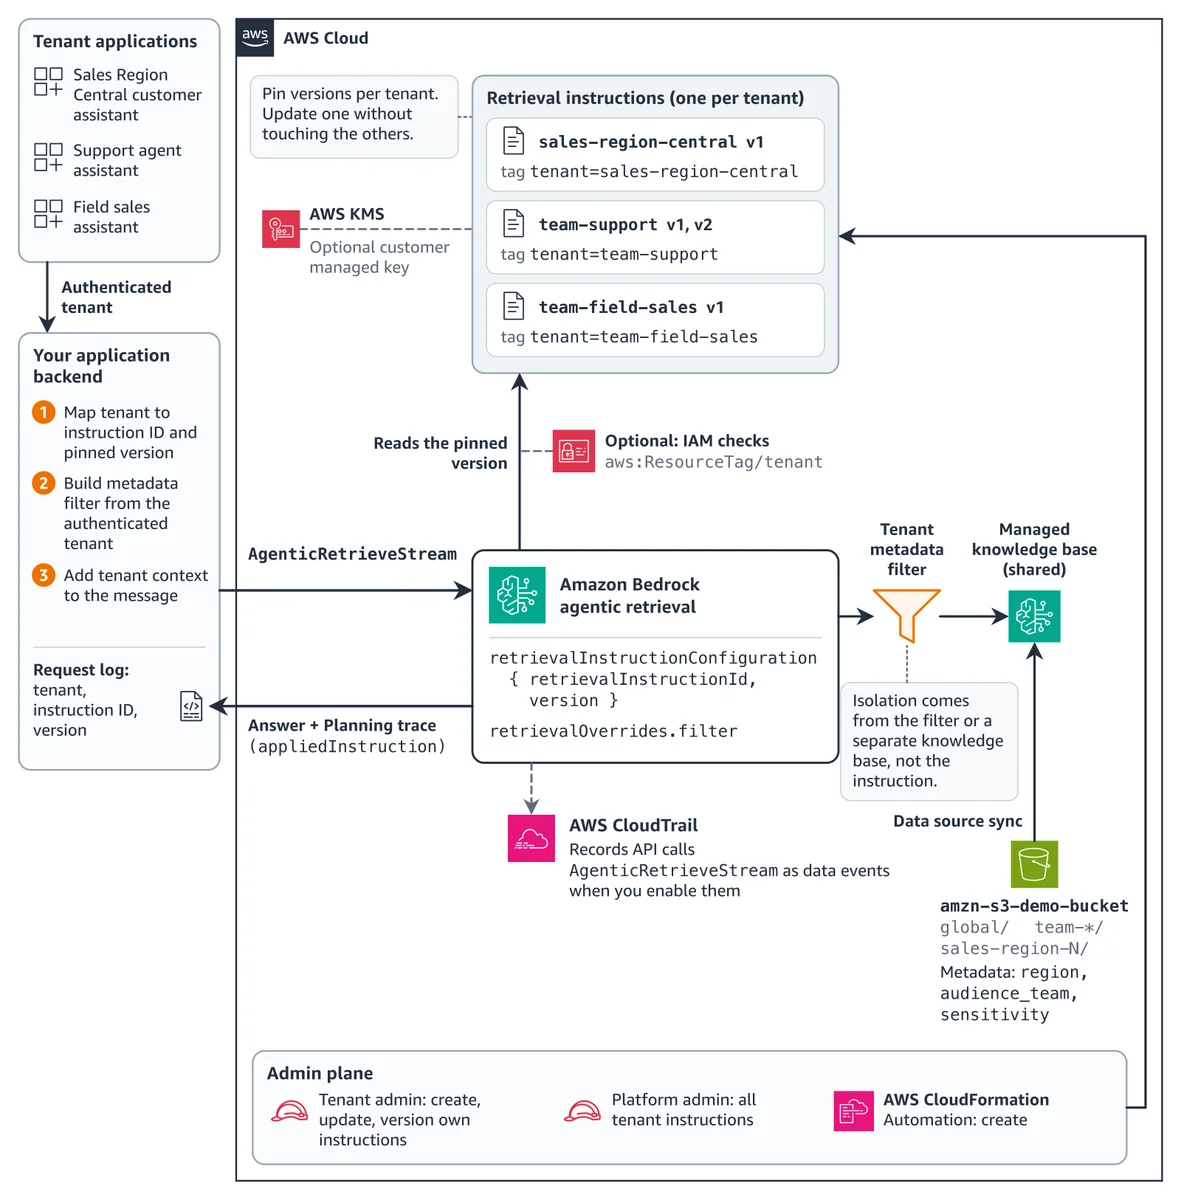
在 Amazon Bedrock 托管知识库中按租户自定义答案 Amazon Bedrock 托管知识库中的检索指令可为共享知识库上的每个租户设置语音、格式、检索指南和回答策略。本文介绍如何为每个租户提供独立的答案,通过元数据过滤器隔离租户数据,利用 IAM 标签限定访问范围,并逐个租户部署变更。 Customize answers per tenant in Amazon Bedrock Managed Knowledge Base aws.amazon.com +1
在 Amazon Bedrock 上使用开源模型进行提示缓存 许多生成式 AI 应用会在每次请求时重新发送相同的长上下文。提示缓存(Prompt caching)允许 Amazon Bedrock 上的开源权重模型复用该上下文,从而降低输入成本并减少延迟。本文展示了通过 Chat Completions API 实现的隐式缓存和显式缓存,并将缓存应用于 OpenCode 代码代理会话。 Use prompt caching with open-weight models on Amazon Bedrock aws.amazon.com +1
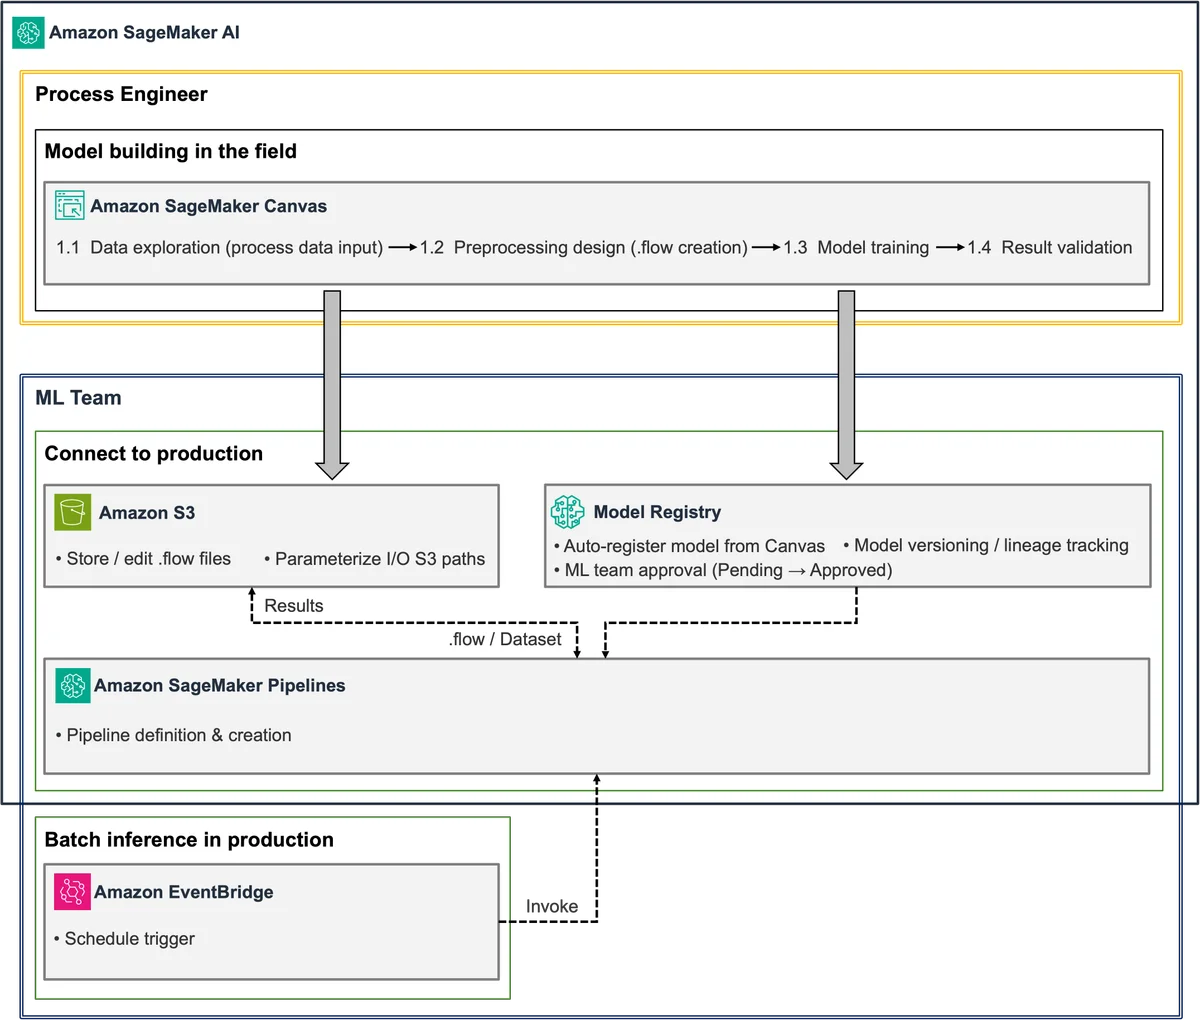
GS Caltex 使用 Amazon SageMaker Canvas 实现生产级 MLOps,第一部分 GS Caltex 将 Amazon SageMaker Canvas 与 Amazon SageMaker Pipelines 相连接,使工艺工程师的无代码模型能够在生产环境中运行。本文展示了机器学习工程师如何复用经验证的预处理流程和模型,从而将部署时间从约一周缩短至数小时,并实现每 30 分钟一次的批量推理。 Production MLOps at GS Caltex with Amazon SageMaker Canvas, part 1 aws.amazon.com +1
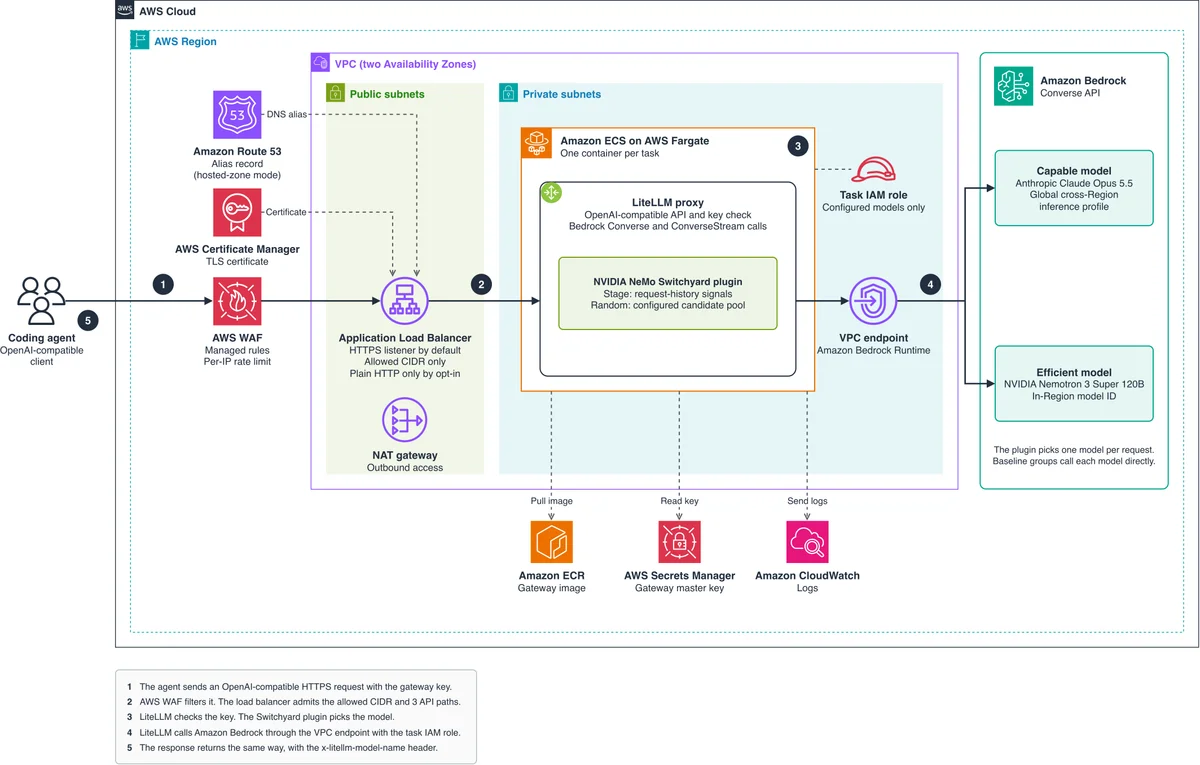
使用 NVIDIA NeMo Switchyard 将路由编码代理请求至 Amazon Bedrock 上的正确模型 编码代理在任务中运行,关键指标是每解决一个任务的成本,而非每 token 的价格。在本篇博客中,您将使用 AWS CDK 在 Amazon Bedrock 上部署 LiteLLM,并集成 NVIDIA NeMo Switchyard 路由插件,随后针对路由模型组与单模型基线进行对比,测量每解决一个任务的成本。 Route coding agent requests to the right model on Amazon Bedrock with NVIDIA NeMo Switchyard aws.amazon.com +1
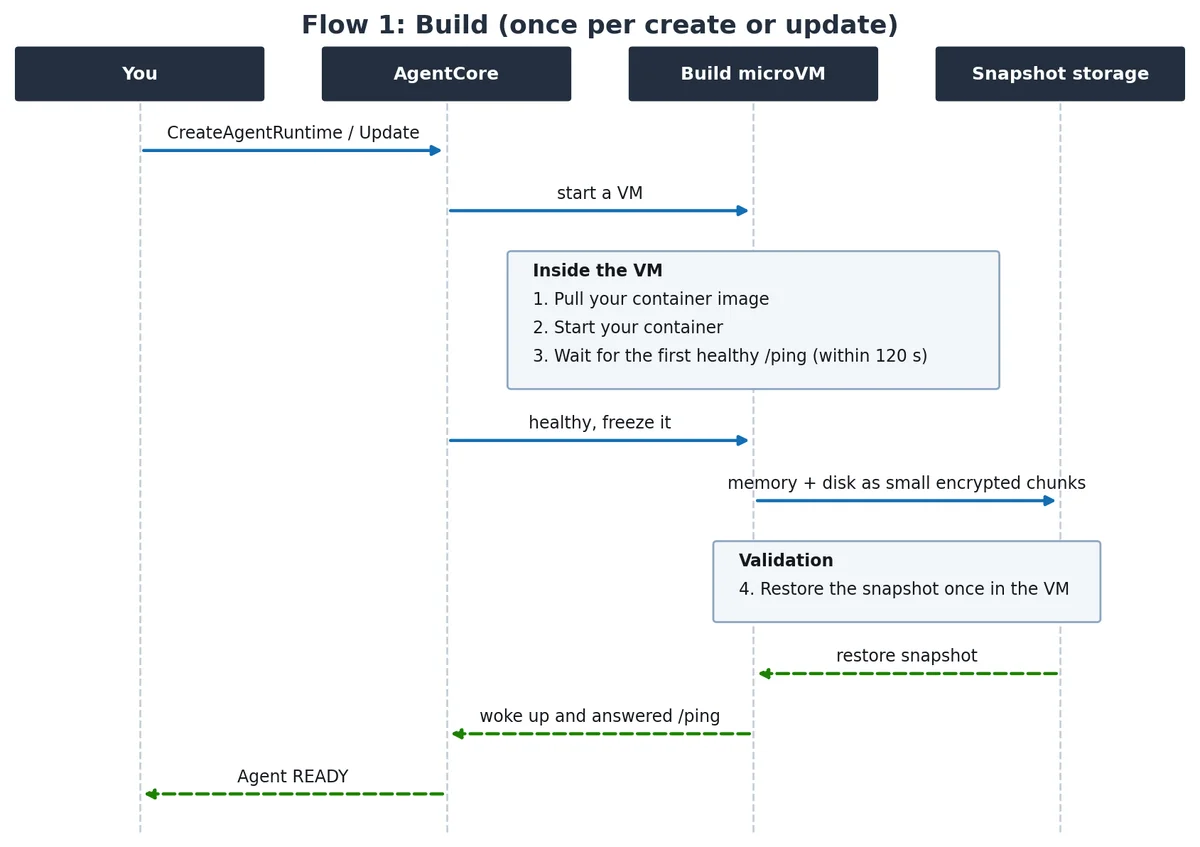
用于 Amazon Bedrock AgentCore 运行时快速会话启动的架构模式 Amazon Bedrock AgentCore 运行时 V2 会快照化您的初始化环境,并在每个新会话中恢复该环境,因此会话启动时间不再随镜像大小增长。本文解释了 V2 如何启动会话、如何测量会话启动时间,以及四种模式可将工作负载从首个请求中剥离。 Architecture patterns for fast session startup on Amazon Bedrock AgentCore runtime aws.amazon.com +1
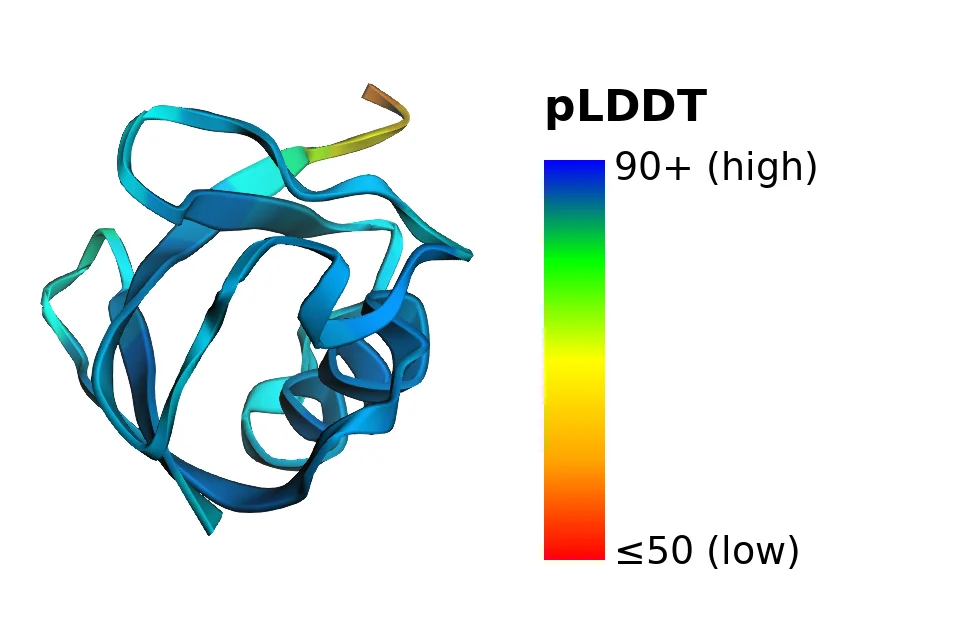
OpenFold3 在 Amazon SageMaker JumpStart:预测生物分子结构” 从 Amazon SageMaker JumpStart 部署 OpenFold3-preview,以在您自己的 AWS 账户中预测蛋白质、DNA、RNA 及配体复合物的三维结构。本文涵盖异步推理、多 GPU 并行处理、引入自定义 MSA 以提升准确性与隐私性,以及按需伸缩至零以降低成本。 OpenFold3 on Amazon SageMaker JumpStart: Predict biomolecular structures aws.amazon.com +1
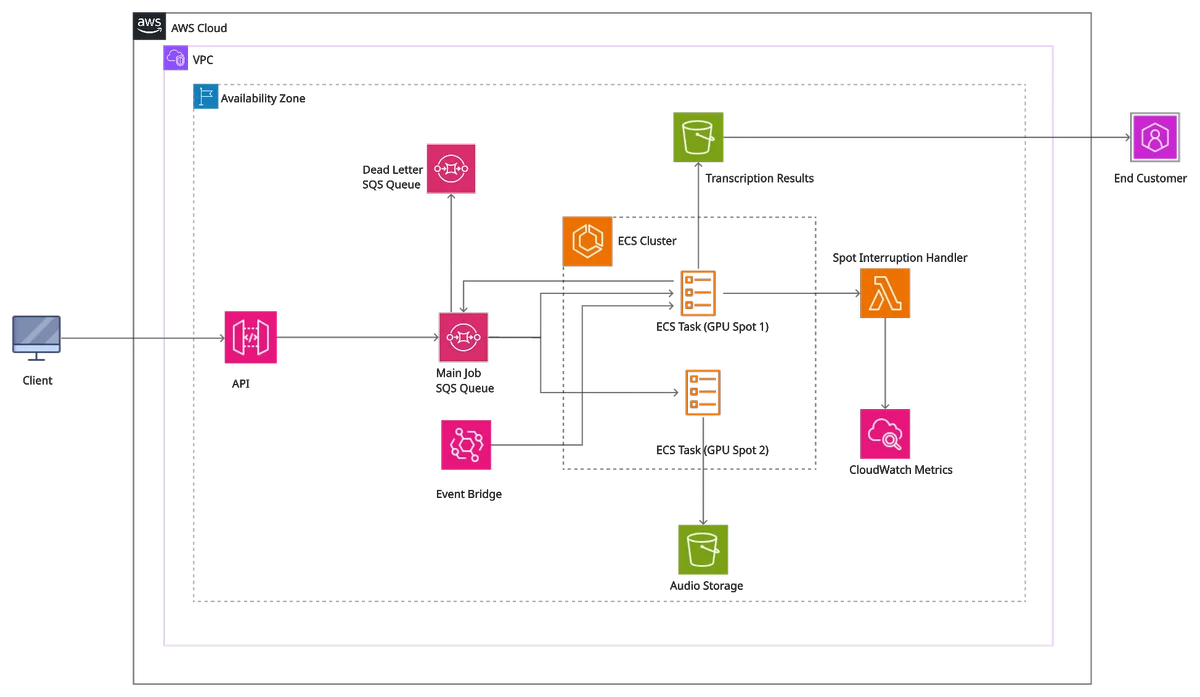
使用 Amazon EC2 Spot 在 AWS 上优化成本的 AssemblyAI 语音转文本推理 了解 AssemblyAI 如何在 AWS 上利用 Amazon ECS、Amazon EC2 Spot GPU 实例以及基于 Amazon SQS 的重试架构,实现大规模成本优化的语音转文本推理,在保持欧洲区域服务等级协议(SLA)承诺的同时,达成 70% 的成本节约。 Cost-optimizing AssemblyAI speech-to-text inference on AWS with Amazon EC2 Spot aws.amazon.com +1
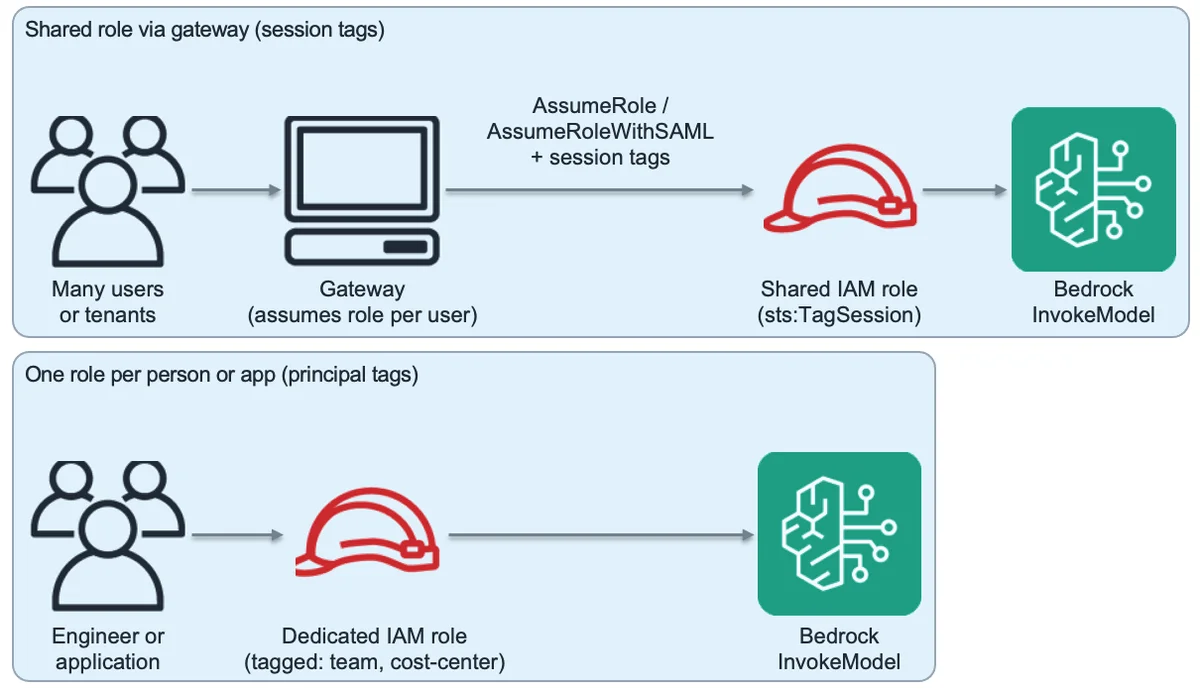
Amazon Bedrock 上 AI 开发者与生产力工具的计费分摊与控制 Amazon Bedrock 提供内置的零代码成本归因功能,可追踪每一次推理调用并关联到发起该调用的 IAM 主体。本文介绍如何使用 IAM Identity Center、会话标签和 CUR 2.0 对 AI 开发者和生产力工具的每位用户进行 Bedrock 成本归因,以及如何实施每位用户的用量限制。 Cost attribution and controls for AI developer and productivity tools on Amazon Bedrock aws.amazon.com +1
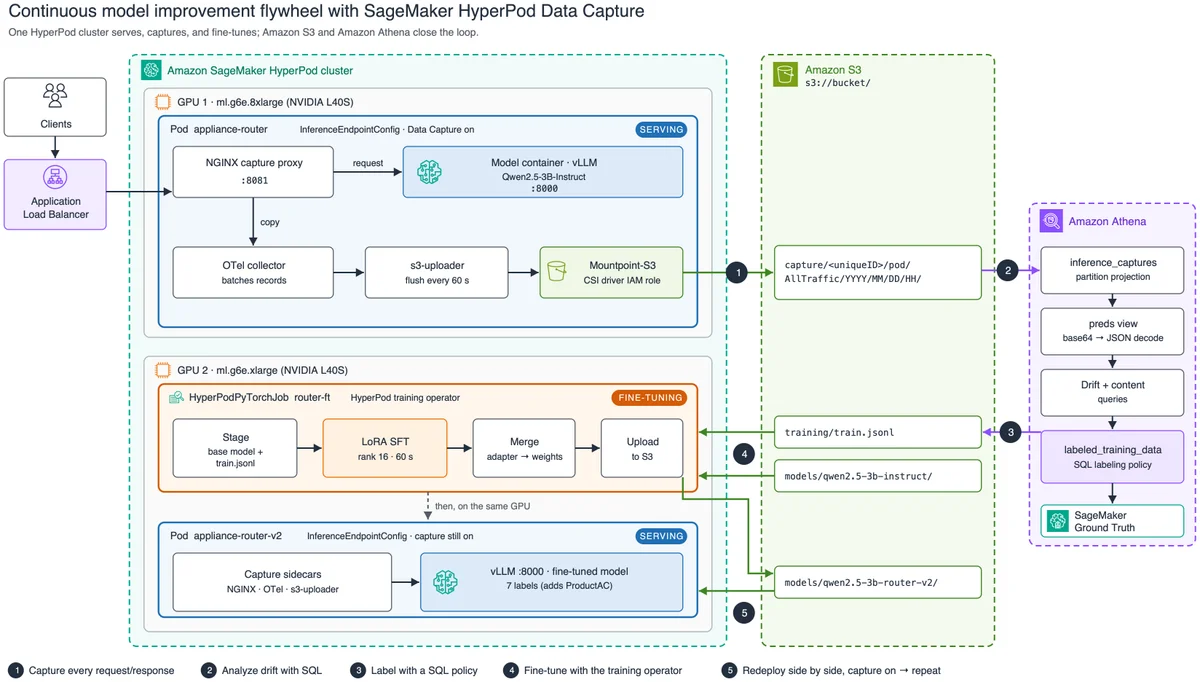
使用 Amazon SageMaker HyperPod Data Capture 构建模型改进飞轮 Amazon SageMaker HyperPod Data Capture 将实时推理的输入和输出记录到 Amazon S3。本文介绍了一个端到端的示例:捕获支持路由器的生产流量,利用 Amazon Athena 揭示新产品盲点,使用 HyperPod 训练算子对捕获的数据进行微调,并衡量优化前后的提升效果。 Build a model improvement flywheel with Amazon SageMaker HyperPod Data Capture aws.amazon.com +1
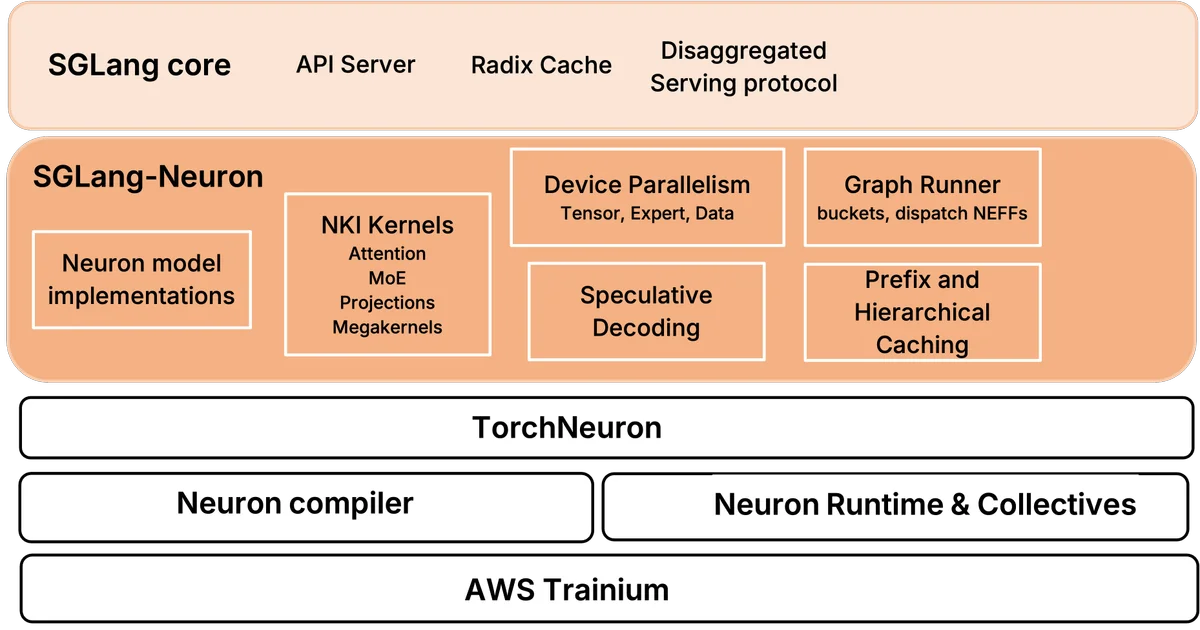
在 AWS Trainium 上使用 SGLang-Neuron 部署前沿 AI 模型 SGLang-Neuron 现已通过 AWS 深度学习容器公开提供。借助 SGLang-Neuron,您可以在 AWS Trainium 上使用您已熟悉的 SGLang 接口,通过 SGLang 部署模型并生成强化学习 rollout,且全部运行于原生 PyTorch 之上。 Deploy frontier AI models on AWS Trainium with SGLang-Neuron aws.amazon.com +1
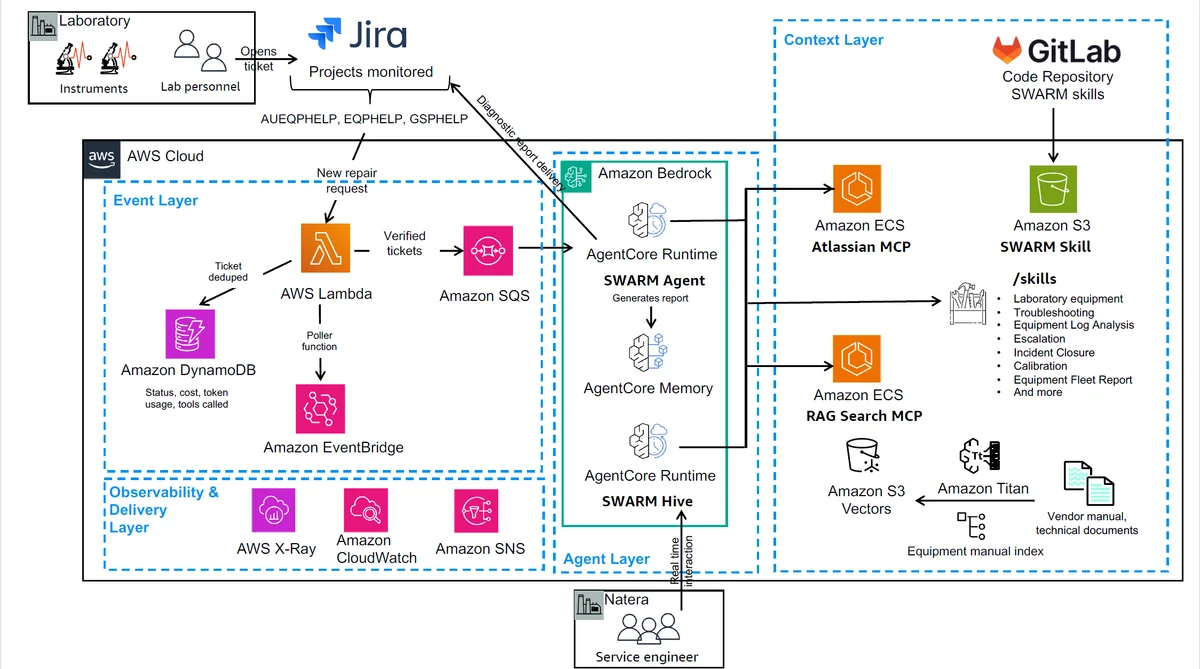
Natera 如何利用 Amazon Bedrock AgentCore 设计用于实验室运营的代理式 AI 系统 Natera 构建了 SWARM,这是一个基于 Amazon Bedrock AgentCore 的代理式 AI 系统,能够捕捉机构实验室运营知识并将其规模化部署。本文详细介绍了从知识库构建到部署与评估的完整架构,实现了支持工单的首次响应速度提升约 130 倍,自动化覆盖率达到 96.2%。 How Natera designed an agentic AI system for lab ops with Amazon Bedrock AgentCore aws.amazon.com +1
四个影响成本的亚马逊基岩推断选项 即使调整了提示词和应用逻辑,您的 Amazon Bedrock 推理账单仍可能持续攀升。四个请求级别的选项(缓存时长、服务层级、推理努力程度和 maxTokens)会影响服务处理的 token 数量及所应用的费率。我们展示了如何测试每一项,以及如何验证其影响。 Four Amazon Bedrock inference choices that affect cost aws.amazon.com +1
大规模 Token 经济学:使用 CUR 2.0 和 AWS Budgets 按 IAM 主体跟踪并限制 Amazon Bedrock 的支出 使用仅 AWS 原生功能,无需针对常见场景编写应用程序代码,即可实现按身份维度的 Amazon Bedrock 成本可见性并实施可执行的花费限额。通过 IAM 主体标签归因花费,利用 CUR 2.0 或成本探索器进行报告,并通过 AWS Budgets 操作实施限制:当超过阈值时应用拒绝策略。 Tokenomics at scale: Track and cap Amazon Bedrock spend per IAM principal with CUR 2.0 and AWS Budgets aws.amazon.com +1
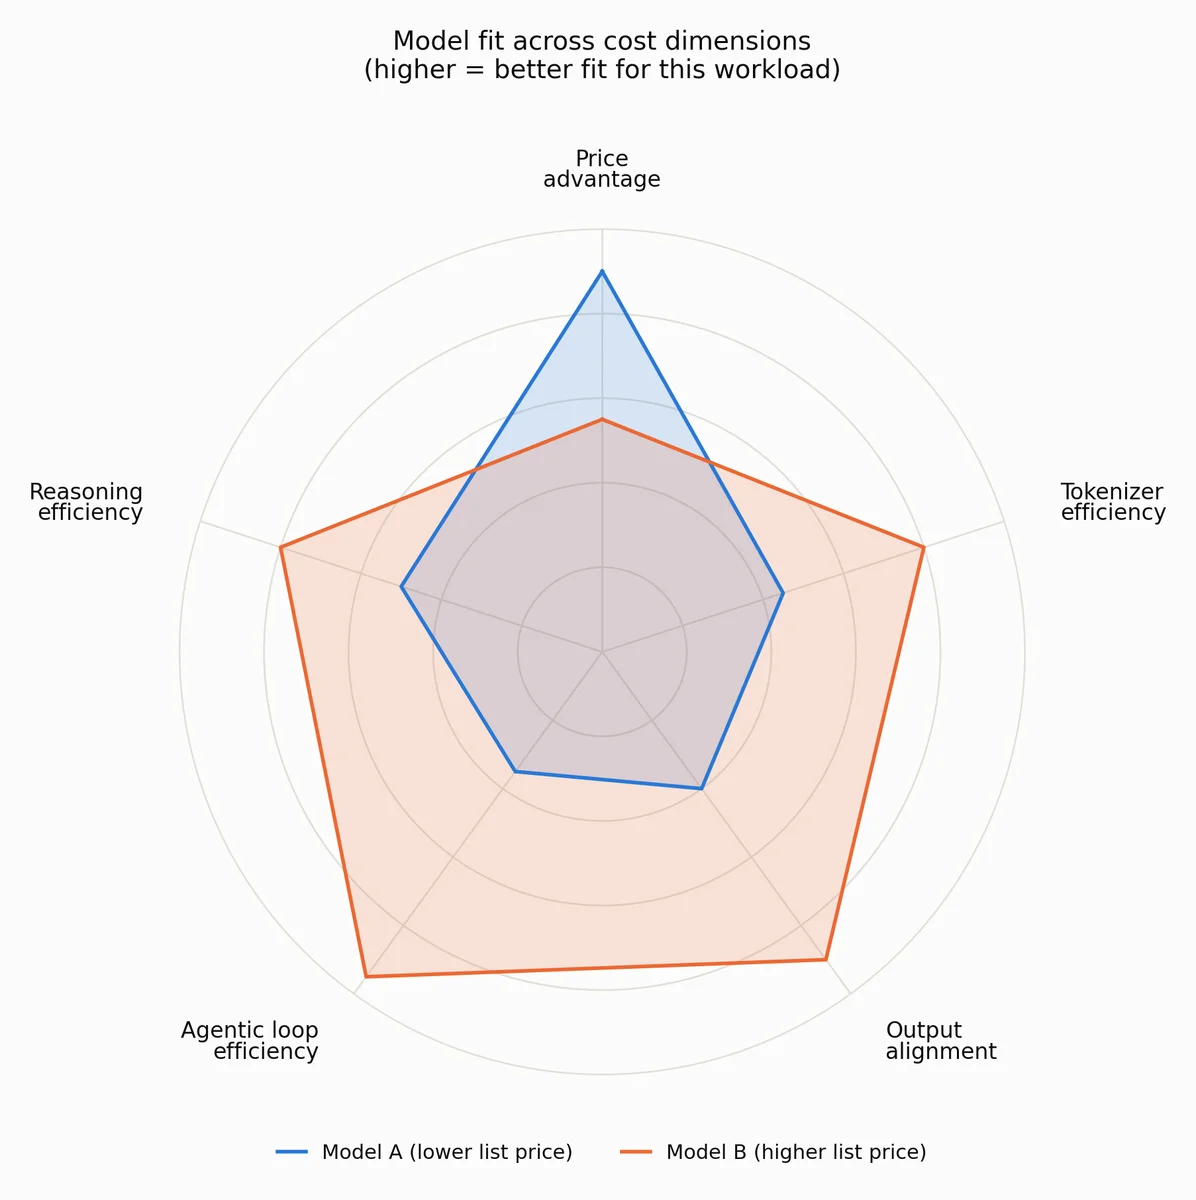
优化每任务成本并在 Amazon Bedrock 上验证智能体投资回报率 比较每 token 价格掩盖了在 Amazon Bedrock 上运行模型的真实成本。本文展示如何计算跨四个隐藏成本驱动因素的真实每任务成本,并通过缓存、路由和输出约束来降低该成本,同时利用人类基准、留置实验和五维评分卡来证明智能体的投资回报率。 Optimizing cost per task and proving agent ROI on Amazon Bedrock aws.amazon.com +1
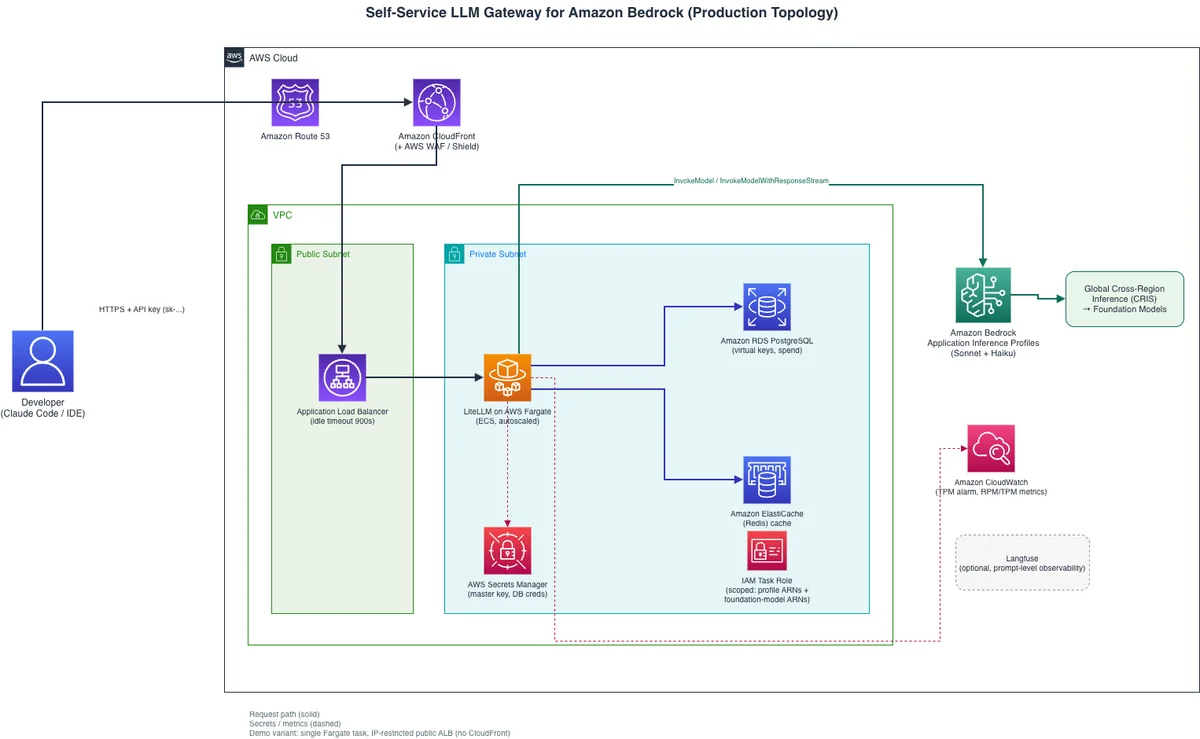
使用 Amazon Bedrock 和 LiteLLM 构建自助式 LLM 网关 在 AWS Fargate 上构建一个基于 LiteLLM 的自助式 LLM 网关,将 Amazon Bedrock 基础模型置于兼容 OpenAI 的 API 之后。开发人员可通过单个 API 密钥立即获得访问权限,而平台团队则可实现按用户计费的成本控制、配额隔离及可观测性。 Building a self-service LLM gateway with Amazon Bedrock and LiteLLM aws.amazon.com +1
使用下一代 AgentCore 运行时安全高效地运行代理 如今,AI 代理可运行多步骤工作负载长达数小时,并代表用户执行操作,这对安全、可扩展的代理计算提出了更高要求。了解下一代 Amazon Bedrock AgentCore 运行时如何提供硬件隔离会话,实现更快的启动速度、更强的计算能力、按使用量计费,并将隔离性扩展至您的数据。 Run agents securely and efficiently with the next generation AgentCore runtime aws.amazon.com +1
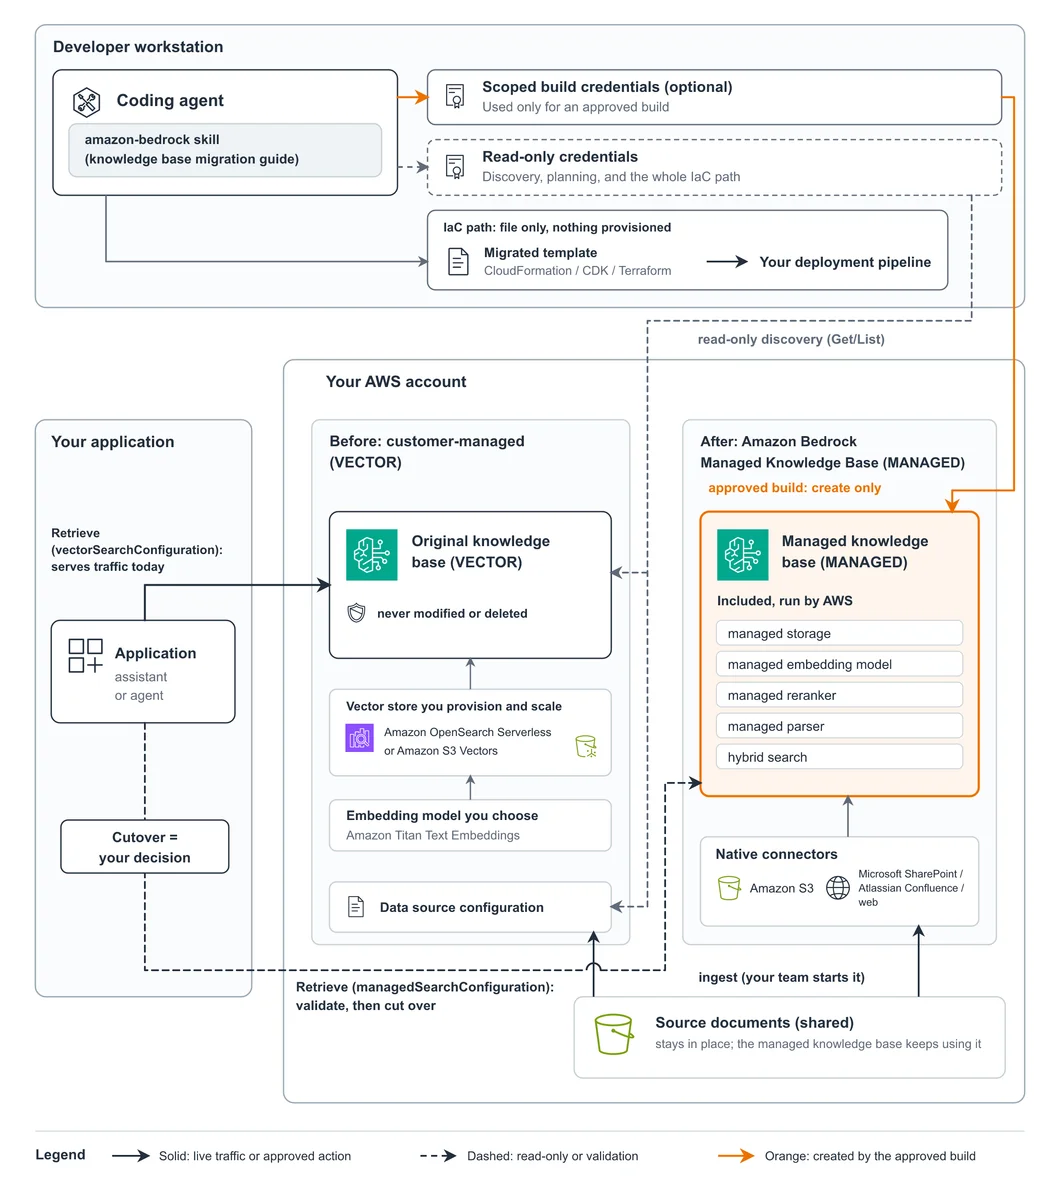
使用您的编码代理迁移至 Amazon Bedrock 托管知识库 Amazon Bedrock 技能中的迁移指南可帮助您将客户托管的 Amazon Bedrock 知识库迁移至托管知识库。您的编码代理通过只读发现规划迁移,在原始知识库旁创建新的知识库或基础设施即代码模板,并在切换前验证检索效果。 Migrate to Amazon Bedrock Managed Knowledge Base with your coding agent aws.amazon.com +1
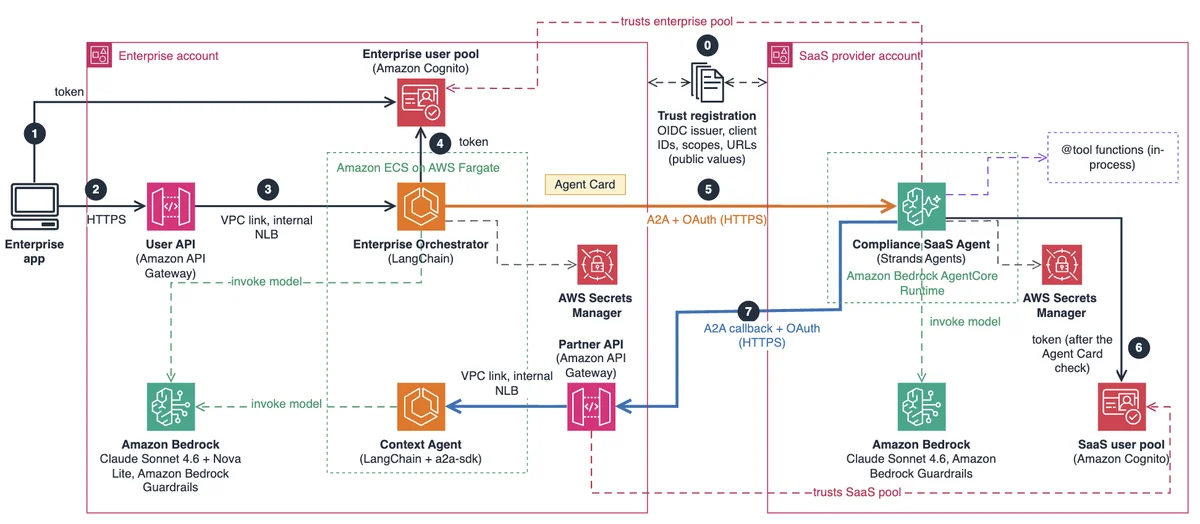
使用 AWS 上的 A2A 构建可组合、可互操作的智能体系统 在 AWS 上构建一个基于 Agent-to-Agent (A2A) 协议的模块化、可互操作的多智能体系统。部署在 Amazon ECS 上的 LangChain 编排器与部署在 Amazon Bedrock AgentCore 上的 Strands 智能体跨越组织边界进行通信,采用双向、OAuth 认证的调用方式,且双方均不依赖对方的框架或 SDK。 Build composable, interoperable multi-agent systems with A2A on AWS aws.amazon.com +1
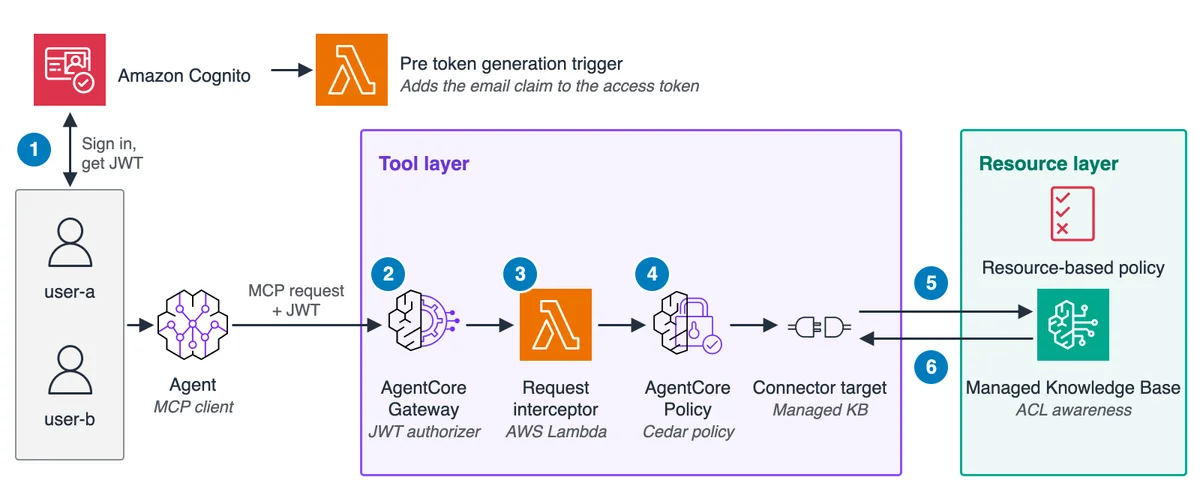
用于 Amazon Bedrock 托管知识库工具的细粒度访问控制 学习如何通过 Amazon Bedrock AgentCore Gateway 将 Amazon Bedrock 托管知识库作为 MCP 工具暴露给 AI 代理,同时保持基于用户的访问控制。请求拦截器注入已验证的身份,AgentCore 中的策略独立验证该身份,而基于资源的策略则限制对知识库的直接访问。 Fine-grained access control for Amazon Bedrock Managed Knowledge Base tools aws.amazon.com +1
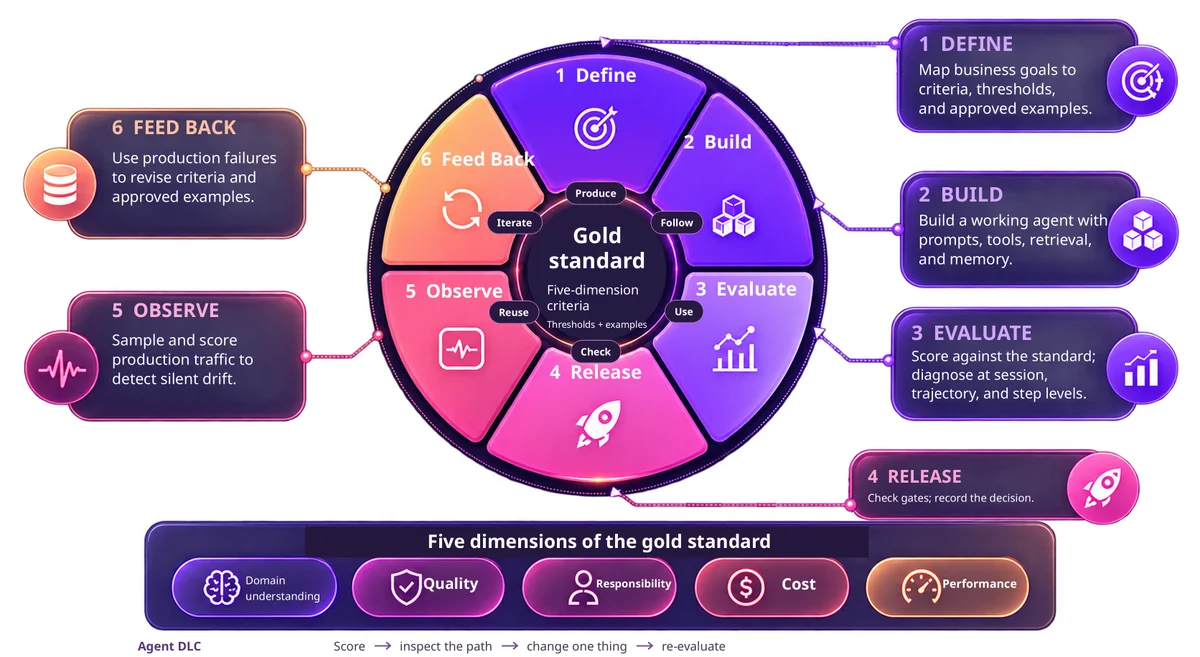
从原型到量产:使用 Agent DLC 构建工程智能体 当团队缺乏可重复评估智能体质量及判断最新变更是否有效的方法时,智能体往往在演示与发布之间停滞不前。本文探讨三个破坏传统 CI/CD 的智能体属性,分析一个因聚合指标掩盖覆盖度差距的实测案例,并介绍 Agent DLC:一个生命周期、两个循环,以及用于评判每一项变更的明确标准。 From prototype to production: Engineering agents with Agent DLC aws.amazon.com +1
使用 Amazon Bedrock 和 Spring AI 构建自主 AI 代理 了解 Java 开发者如何利用 Amazon Bedrock 和 Spring AI 构建生产就绪的自主 AI 代理。本文介绍了工具调用、对话记忆、弹性模式以及多代理编排,随后使用 Amazon Bedrock AgentCore 将代理部署至 AWS。 Build autonomous AI agents with Amazon Bedrock and Spring AI aws.amazon.com +1
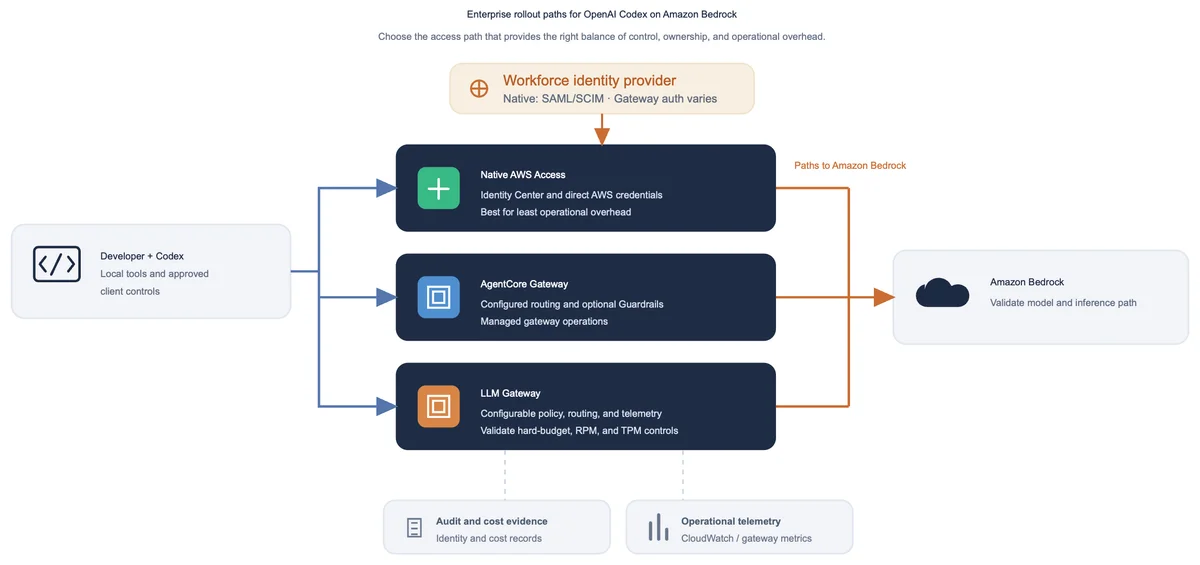
亚马逊Bedrock上的OpenAI手册 面向在 AWS 上向开发人员部署 OpenAI Codex 的企业提供的一份实用指南,以 Amazon Bedrock 作为模型后端,涵盖平台、安全与财务团队需协同确定的访问、治理与成本决策。 OpenAI Codex on Amazon Bedrock aws.amazon.com +1
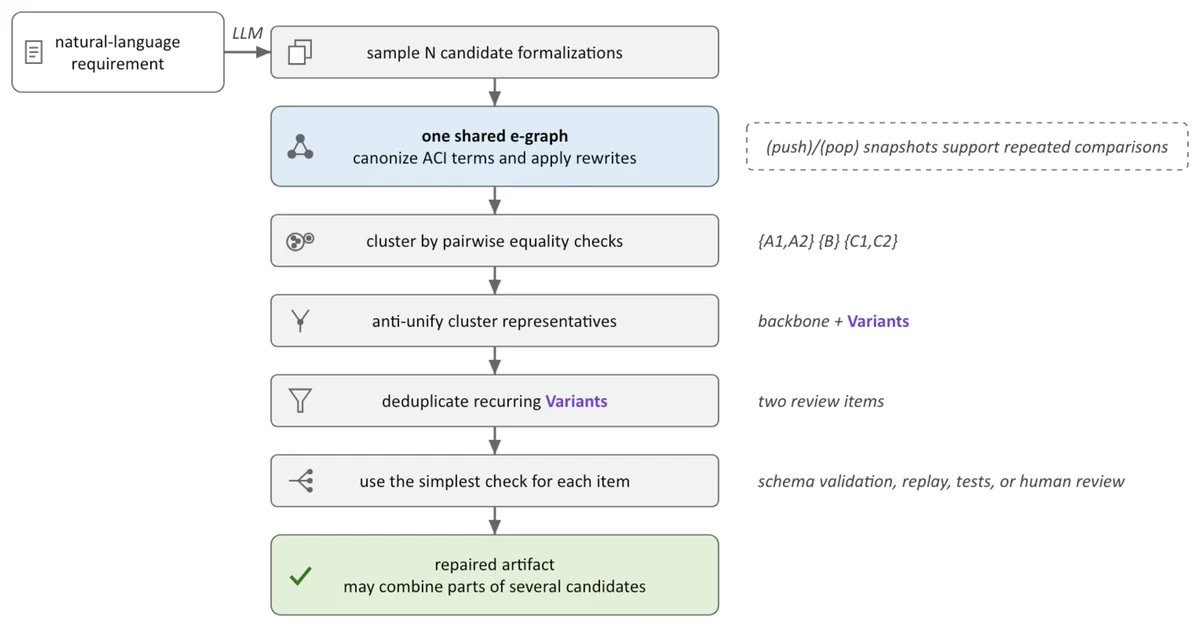
形式政策与反统一政策的语义差异 两个正式策略的文本差异报告标记了所有外观变更,却隐藏了改变行为的那一项。本文展示如何利用开源反统一引擎计算符号化、确定性的语义差异,从而使审查者仅能看到两个候选授权策略之间真正的分歧。 Semantic diffing of formal policies with anti-unification aws.amazon.com +1
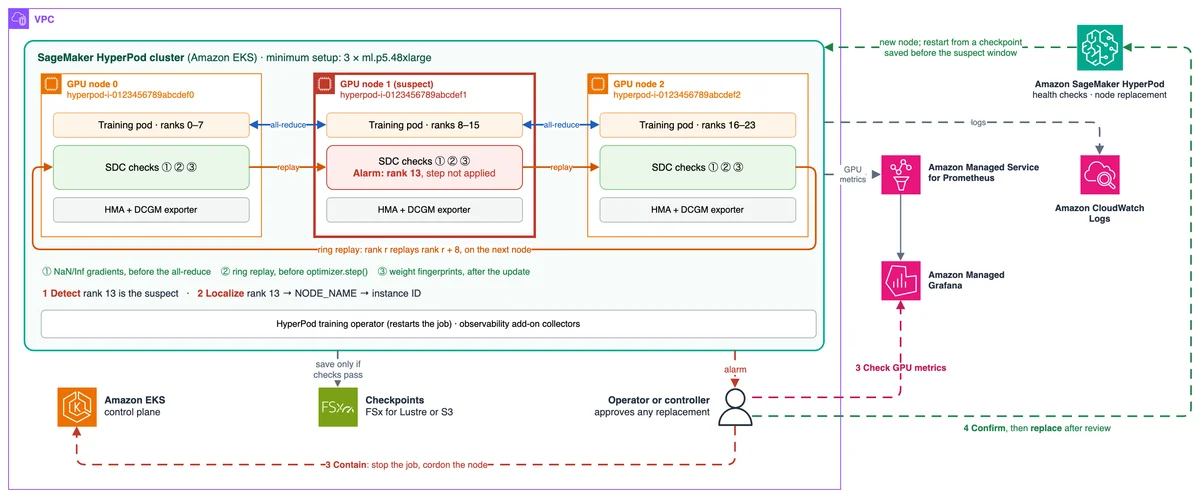
在 Amazon SageMaker HyperPod 上检测并恢复静默数据损坏 “静默数据损坏”是一种 GPU 故障,其返回错误但看似合理的数值且无报错,从而悄无声息地污染分布式训练。本文在 PyTorch DDP 循环中增加三项检查,以检测该故障、定位 Amazon SageMaker HyperPod 上的故障节点,并将该节点移交至自动恢复流程进行替换。 Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod aws.amazon.com +1
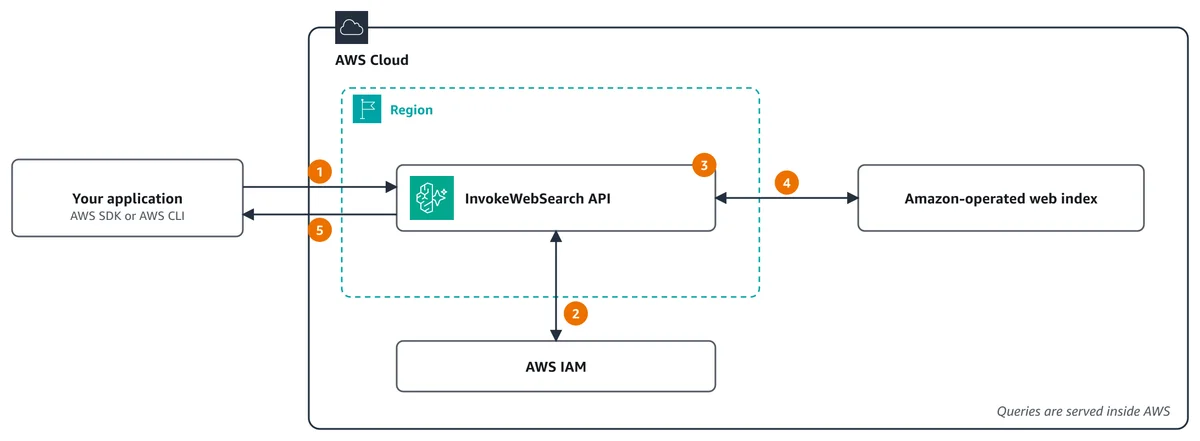
在 Amazon Bedrock AgentCore 中推出 Web 搜索 API 今天,我们宣布在 Amazon Bedrock AgentCore 推出 Web 搜索 API:您只需一次签名 API 调用,即可让自有代码搜索网络,无需网关,也无需创建任何资源。您可以通过 AWS SDK 或 AWS CLI 调用该 API,并将其应用于应用程序、智能体循环和数据管道中。 Introducing the Web Search API on Amazon Bedrock AgentCore aws.amazon.com +1
ICYMI:2026 年 10 月 AI 开发者落地了什么 2026 年 10 月 Amazon Bedrock、Amazon Bedrock AgentCore 和 Strands 的主要更新回顾:为每项任务匹配的新模型、确保代理可用且基于事实的更新,以及为 AI 构建者提供更清晰的成本报告。 ICYMI: What landed for AI builders in October 2026 aws.amazon.com +1
《AWS re:Invent 2026 人工智能/机器学习议程指南》 AWS re:Invent 2026 包含超过 140 场 AI/ML 主题会议。本参会指南可帮助您找到适合您角色与目标的专题研讨、粉笔讲座、工作坊及开发者会议,涵盖 AI 芯片、模型与推理、智能体、智能体信任以及可持续发展等主题,助您制定更明智的 re:Invent 日程。 The attendee’s guide to the AWS re:Invent 2026 AI/ML track aws.amazon.com +1
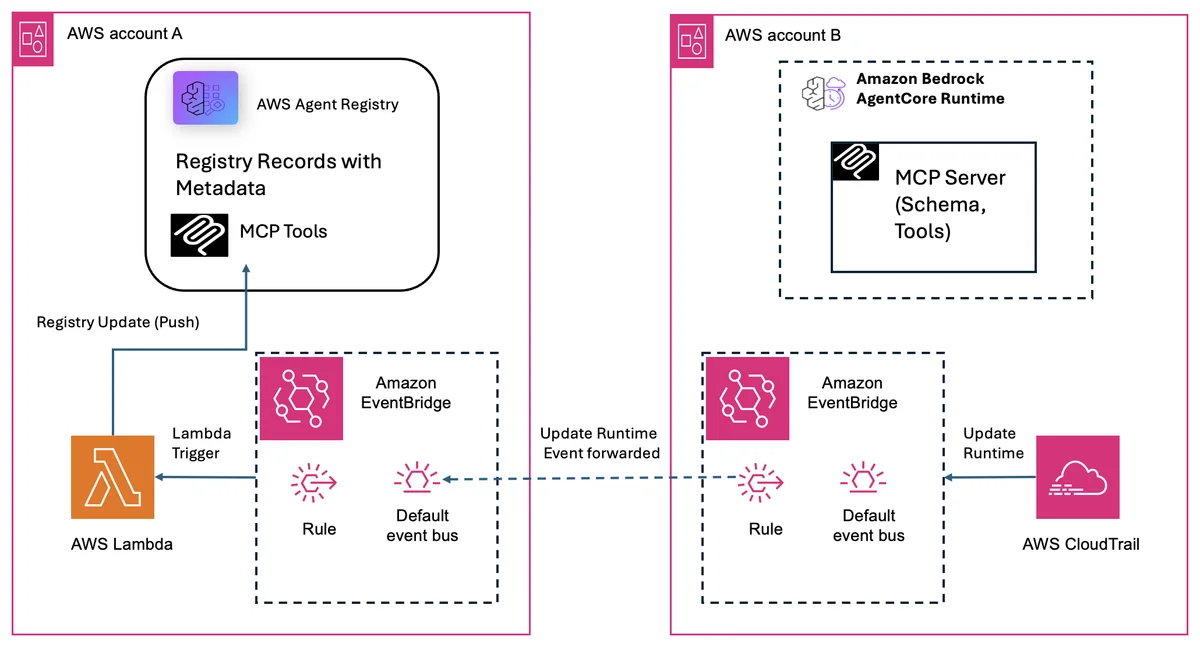
基于推送架构自动化更新 AWS Agent 注册表 本文介绍如何自动保持 AWS Agent Registry 的最新状态。通过结合 AWS CloudTrail、Amazon EventBridge、AWS Lambda 和 AgentCore Identity,构建一个事件驱动管道,可检测 MCP 服务器变更,并将更新后的工具元数据推送到注册表,无需存储密钥,同时支持单账户和多账户环境。 Automating AWS Agent Registry updates with push-based architecture aws.amazon.com +1
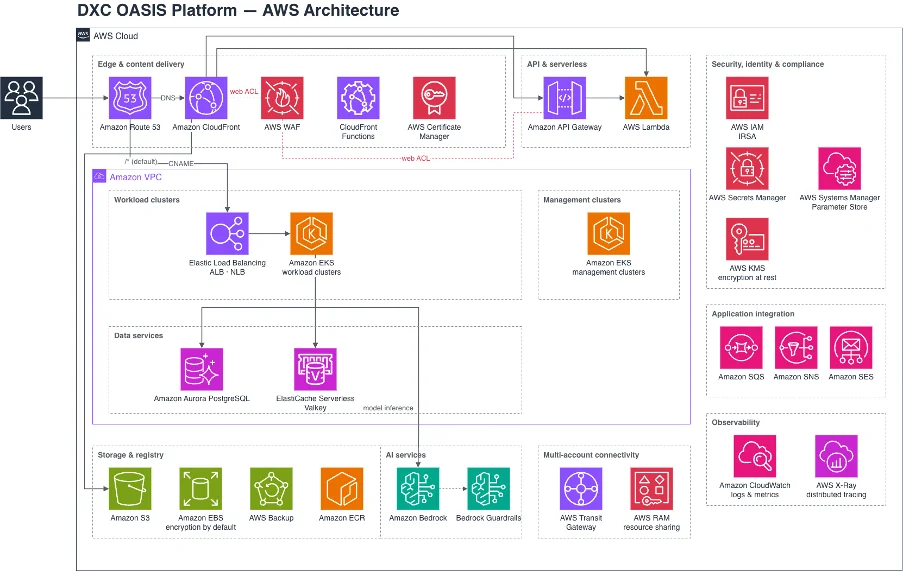
DXC Technology 如何在 Amazon Bedrock 上构建多模型 AI 基础架构” DXC Technology 为遍布 70 个国家的受监管组织提供关键任务托管 IT 服务。了解 DXC 如何在 Amazon Bedrock 上构建其受管制的多模型基础架构,打造 DCX OASIS 这一“人类 +AI"运营模式,将弹性模型基础与可信编排器分离开来,后者能够在大规模场景下对 AI 代理进行编排、治理和审计。 How DXC Technology built a multi-model AI substrate on Amazon Bedrock aws.amazon.com +1
加速生成式AI交付,利用可复用资产 每个生成式 AI 团队都在不断重构相同的组件:RAG 管道、文档处理器和代理脚手架。本文展示了如何访问 AWS 生成式 AI 创新中心提供的 23 个经过精选、生产就绪且可复用的开源资产目录,并附带 DoorDash、Lyft 和 Ricoh 的实际交付成果。 Accelerating generative AI delivery with reusable assets aws.amazon.com +1
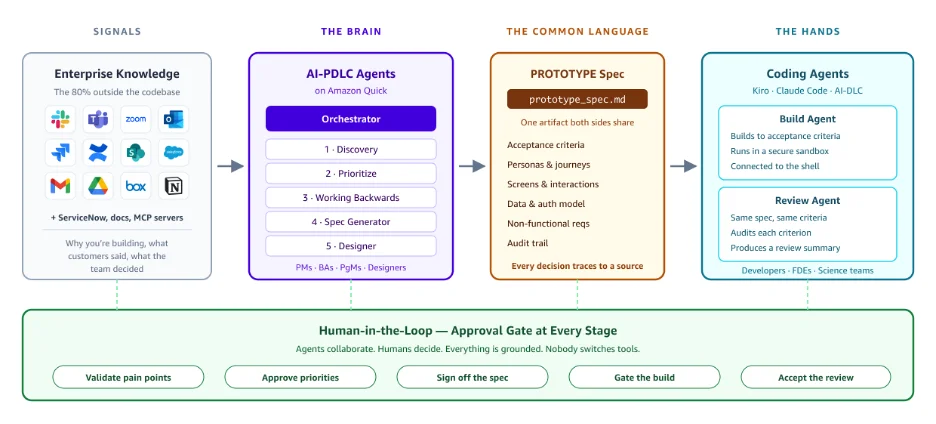
在 AWS Quick 中利用 AI 驱动的全生命周期管理(AI-PDLC)加速产品开发 学习如何构建一个由 AI 驱动的产品开发生命周期(AI-PDLC),利用一套六个 AWS Quick Agent,从分散的客户信号出发,贯穿发现(Discover)、决策(Decide)、设计(Design)和原型(Prototype)阶段,直至产出经人工审批的验证原型,并准备好可直接交付给编码代理(如 Kiro)的规格说明。 Accelerating product development with AI-driven lifecycle management (AI-PDLC) in AWS Quick aws.amazon.com +1
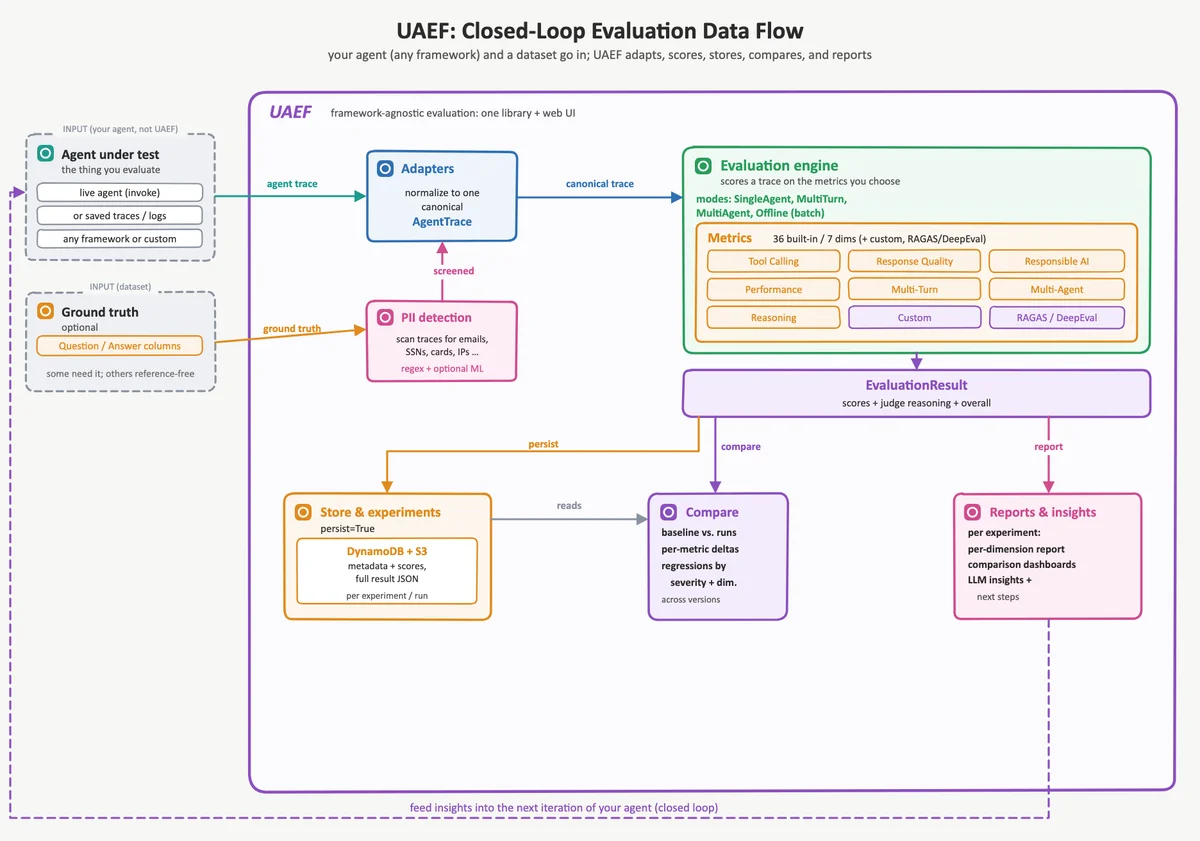
UAEF:一种用于 AI 代理闭环评估的与框架无关的系统 通用智能体评估框架(UAEF)是一个与框架无关的系统,用于评估 AI 智能体。UAEF 将各框架的追踪数据转换为一种规范格式,利用 36 个内置指标在 7 个维度上进行评分,并存储结果,使团队能够比较智能体版本并检测性能回退。 UAEF: A framework-agnostic system for closed-loop evaluation of AI agents aws.amazon.com +1
为 Amazon SageMaker AI 双向流式传输引入基于使用的定价 AWS Marketplace 现已支持为 Amazon SageMaker 双向流式推理提供基于使用量的计量功能,因此模型提供商可以根据客户在实时流处理过程中实际消耗的资源进行计费。Deepgram 作为首发合作伙伴,将基于使用量的语音转文本和文本转语音计费引入 AWS Marketplace。 Introducing usage-based pricing for Amazon SageMaker AI bidirectional streaming aws.amazon.com +1
亚马逊Bedrock上介绍Kimi K3.1 Pro。 Moonshot AI 的 Kimi K3.1 Pro 现已在 Amazon Bedrock 上线。了解如何通过 OpenAI 兼容的 Chat Completions、Responses 和 Converse API 开始使用,利用显式提示缓存优化推理,并在 OpenCode 中将模型用作编程助手。 Introducing Kimi K3.1 Pro on Amazon Bedrock aws.amazon.com +1
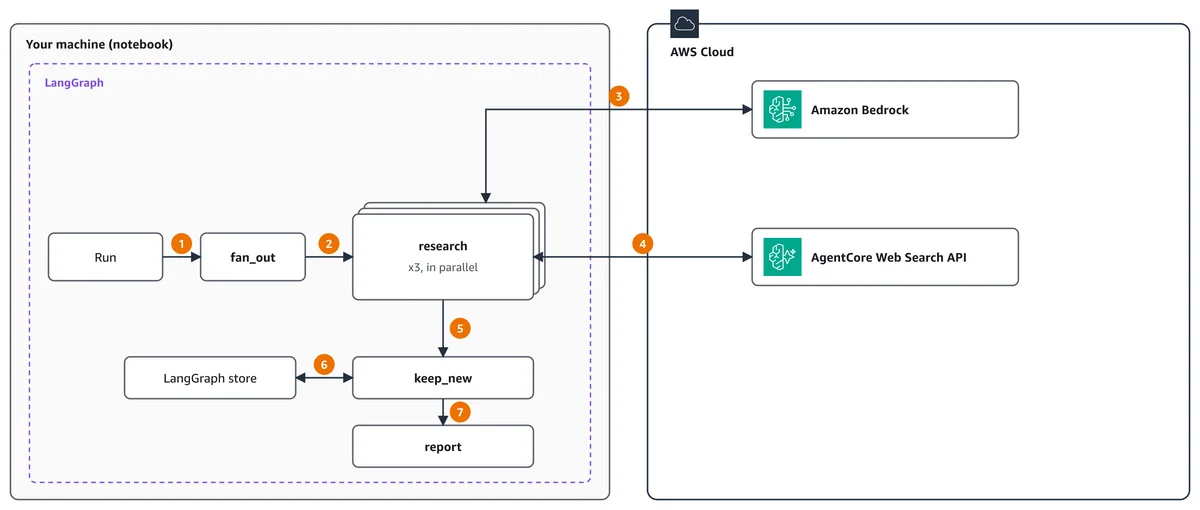
使用 LangGraph 和 Amazon Bedrock AgentCore 网络搜索构建每日依赖关系监控器。 Amazon Bedrock AgentCore 中的 Web 搜索 API 可为智能体提供带有其已使用 AWS 凭据签名的当前且可引用的网络搜索结果。在本篇博客中,我们将构建一个基于 LangGraph 的每日依赖监控器,该监控器以并行方式研究包生态系统,将规则保留在代码中,并针对其引用的来源验证每一项发现。 Build a daily dependency watcher with LangGraph and Amazon Bedrock AgentCore web search aws.amazon.com +1
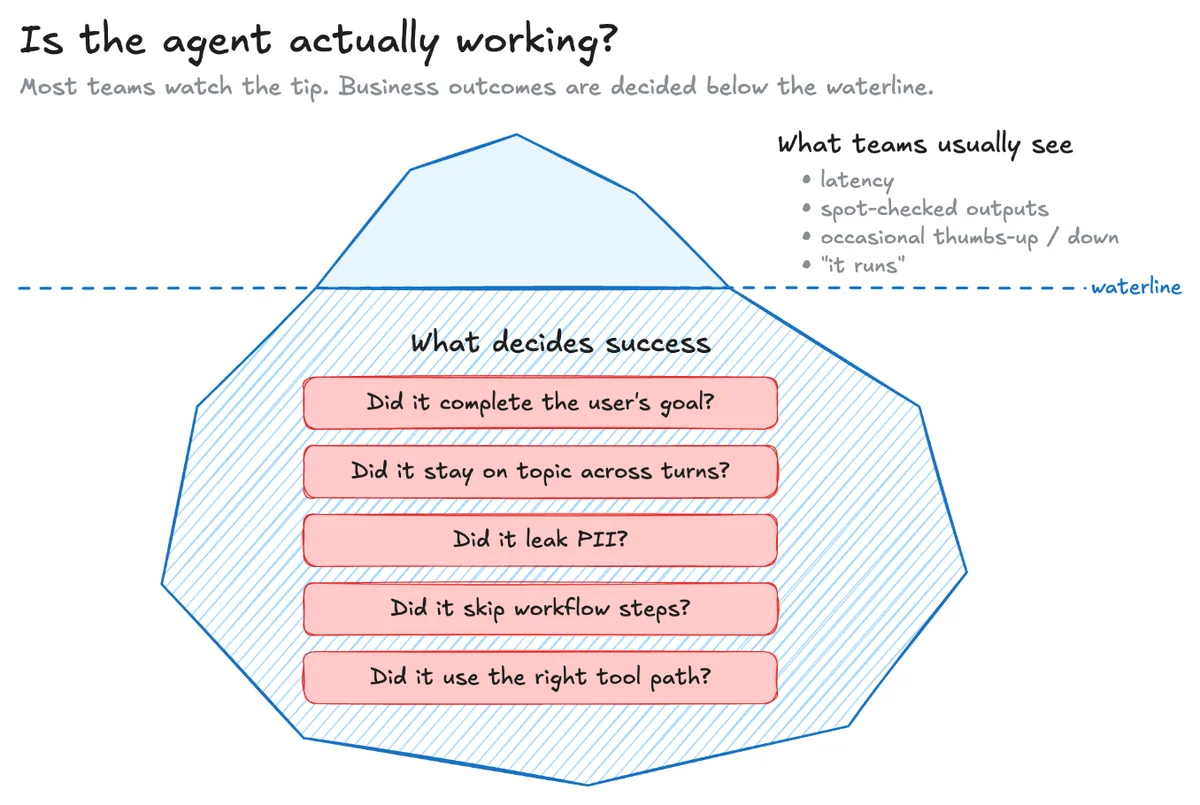
智能体评估指南:Amazon Bedrock 中的内置评估、DeepEval 与 AutoEval 部署智能体后,其是否正常工作实际上涉及多个问题:它是否完成了任务、是否保持主题相关、是否泄露数据,或是否跳过了步骤?本文介绍如何在 Amazon Bedrock AgentCore 上利用内置的 DeepEval 和 AutoEval 评估器对智能体进行评估,以及如何将每个关键行为匹配到合适层级的对应评估器。 The agent evaluation playbook: Built-in, DeepEval, and AutoEval on Amazon Bedrock AgentCore Evaluations aws.amazon.com +1
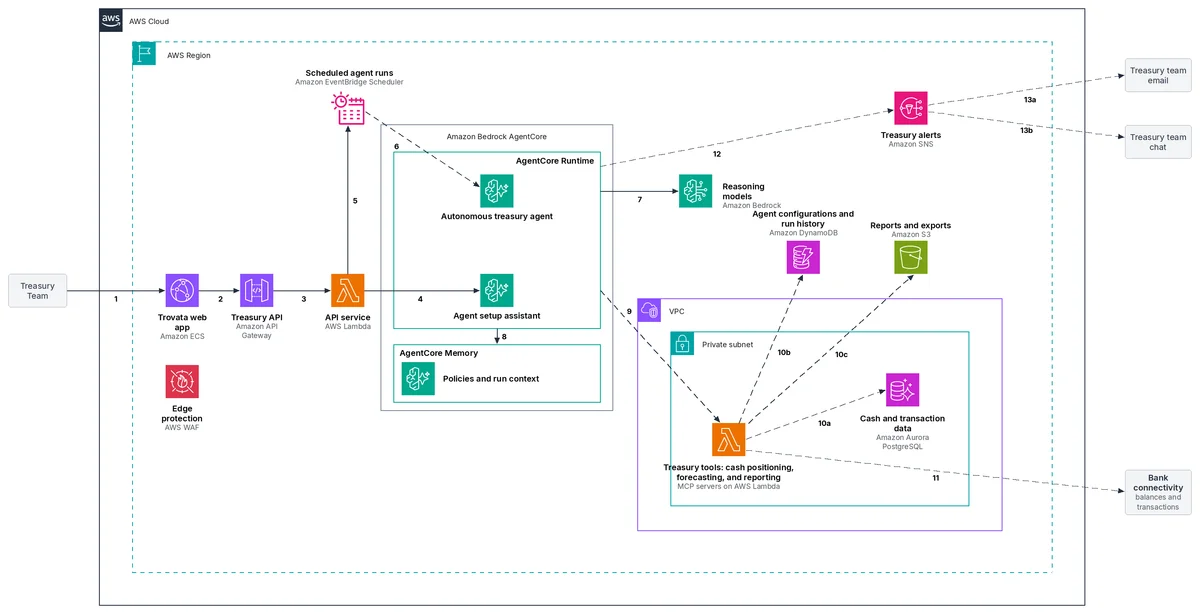
自主财资代理:Trovata 如何在 Amazon Bedrock 和 AgentCore 上构建 AI 原生解决方案 了解 Trovata 如何在 Amazon Bedrock 和 Amazon Bedrock AgentCore 上构建自主财资代理,采用基于 RBAC 的安全架构用于银行品牌 AI 部署,并通过代理工作流推动企业财资从人工操作迈向企业级实时决策。 Autonomous treasury agents: How Trovata built an AI-native solution on Amazon Bedrock and AgentCore aws.amazon.com +1
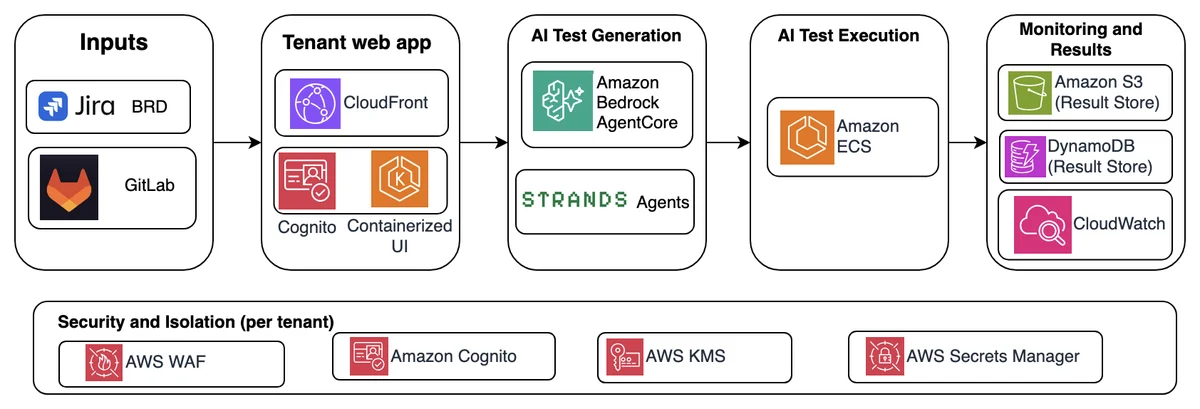
TCS 如何利用 Amazon Bedrock AgentCore 构建智能体测试编排器 Tata Consultancy Services (TCS) 基于 Amazon Bedrock AgentCore 构建了一个智能体测试编排器,能够将其银行、金融服务和保险(BFSI)客户的需求转化为可执行且受管制的测试。了解专用智能体、租户级隔离以及工作负载感知执行如何在内部基准测试中将测试工作量减少 88%。 How TCS built an agentic test orchestrator with Amazon Bedrock AgentCore aws.amazon.com +1
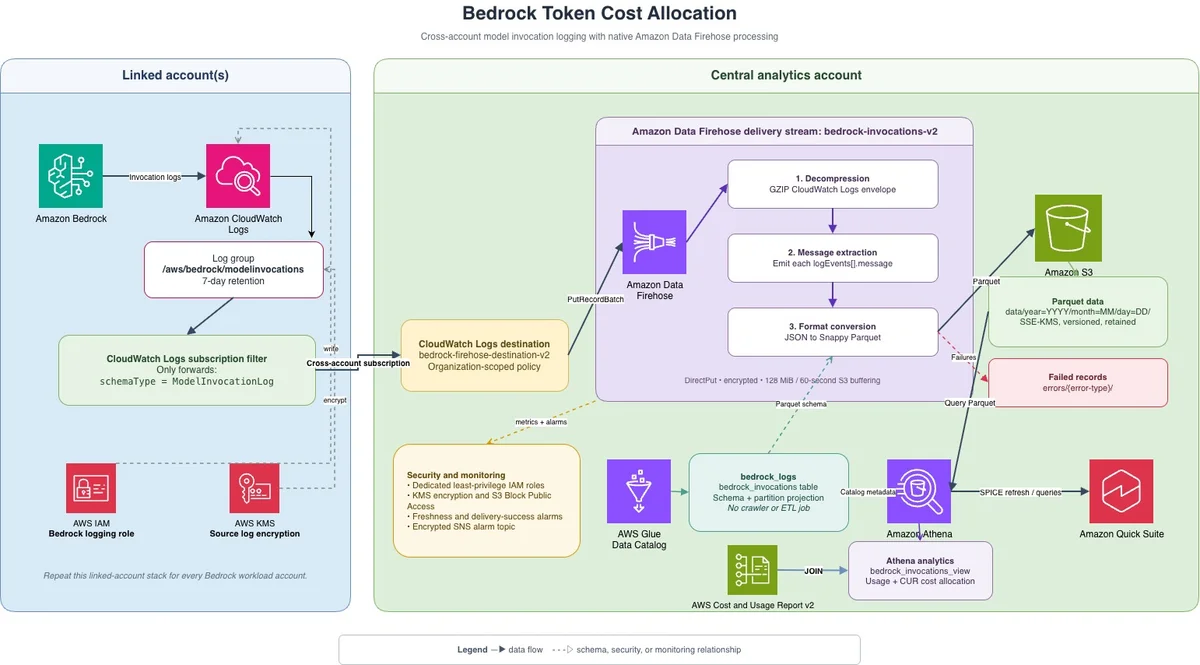
Amazon Bedrock tokenomics数据湖 在多个账户中运行 Amazon Bedrock 时,您只能看到账单,而无法了解每次调用的内部情况。本文构建了一个集中式可观测性数据湖,将每个关联账户中的 Bedrock 调用日志聚合到一张可查询的表中,使您能够查看整个组织中各次调用的提示词、令牌数量、模型选择及单次调用成本。 Amazon Bedrock tokenomics data lake aws.amazon.com +1
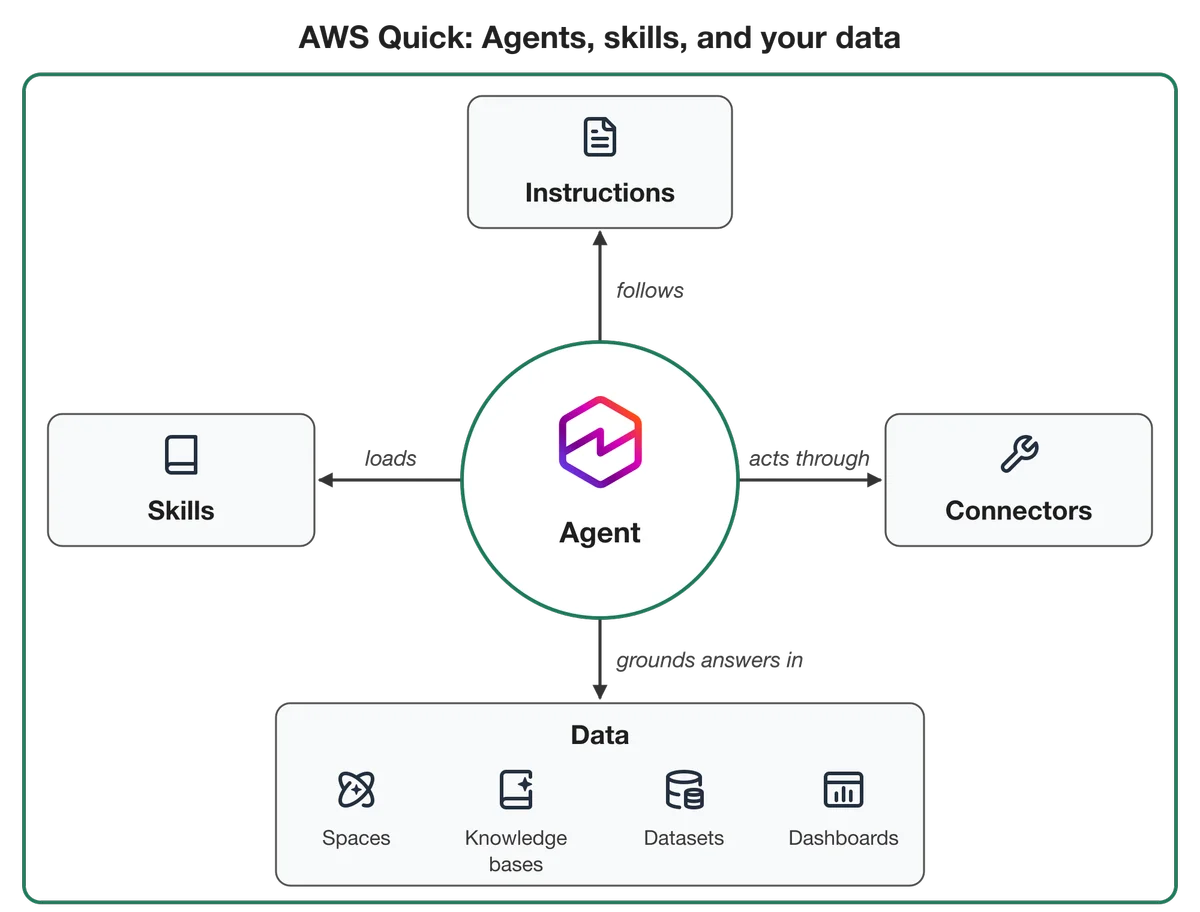
AWS Quick 中技能和代理的工作原理 可重复的任务(如状态更新、发布说明和工单创建)可以通过代理和技能在 AWS Quick 中进行编码。本文介绍了代理、技能以及您的数据如何在 AWS Quick 中协同工作,如何为您的团队构建和共享技能,以及如何利用官方目录和自定义代理来使用这些功能。 How skills and agents work in AWS Quick aws.amazon.com +1
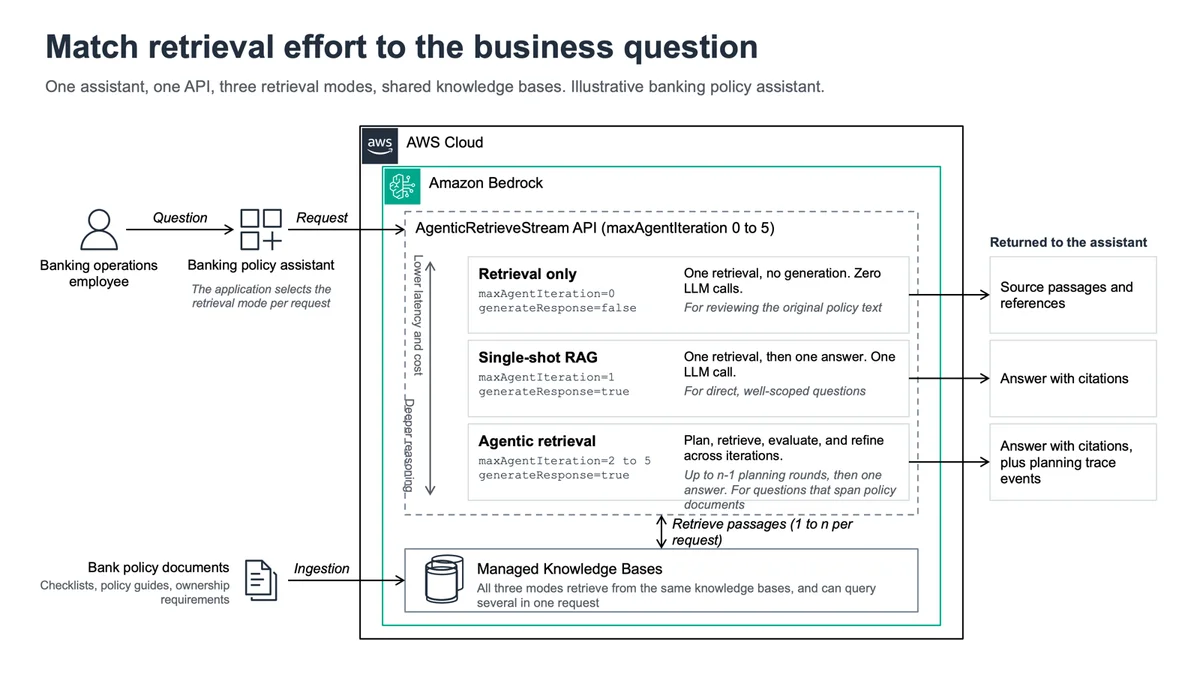
使用 Amazon Bedrock 托管知识库实现单次查询与代理检索 Amazon Bedrock 托管知识库现已支持通过 AgenticRetrieveStream 实现单次检索增强生成(RAG)和仅检索请求,同时支持代理式检索。本文通过一个内部银行政策助手示例,说明 maxAgentIteration 参数如何根据每个请求匹配检索努力程度。 Single-shot and agentic retrieval with Amazon Bedrock Managed Knowledge Base aws.amazon.com +1
在AWS上推出Claude Fable 5.2 Claude Fable 5.2 和 Claude Mythos 5.2 现已在 AWS 的 Amazon Bedrock 和 Claude Platform 上推出。了解这两个模型的新特性,Fable 5.2 为何对您的技术工作负载至关重要,以及如何开始在 Amazon Bedrock 上构建应用。” Introducing Claude Fable 5.2 on AWS aws.amazon.com +1
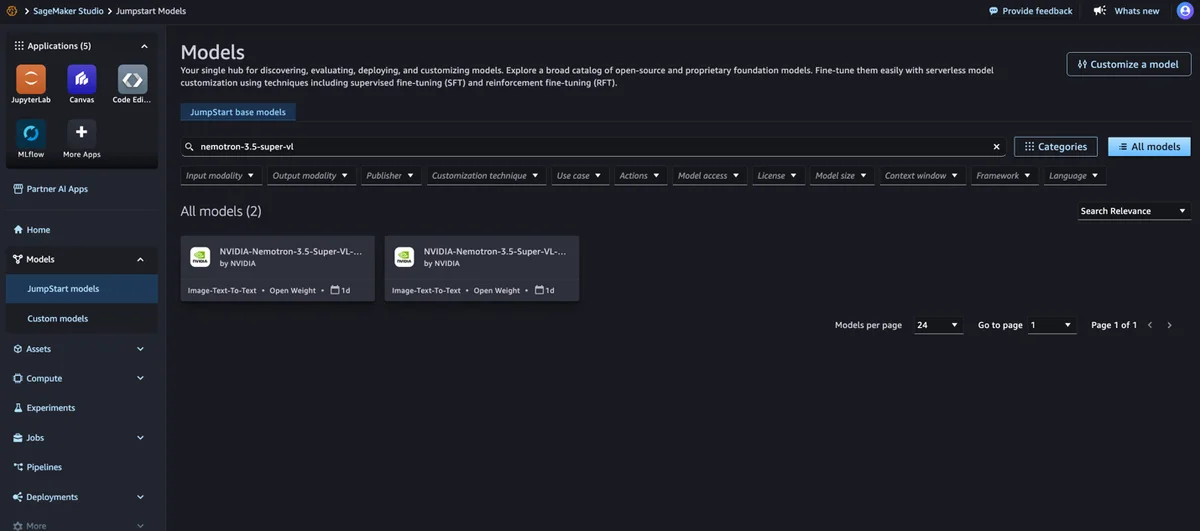
NVIDIA Nemotron 3.5 Super VL 现已在 Amazon SageMaker JumpStart 中提供。 NVIDIA Nemotron 3.5 Super VL,一款拥有 120B 参数的多模态视觉语言模型,现已在 Amazon SageMaker JumpStart 中提供。只需几步即可部署 NVFP4 或 BF16 变体,随后即可运行文本、图像和视频推理,以支持文档智能、计算机使用代理及多模态代理工作负载。 NVIDIA Nemotron 3.5 Super VL is now available in Amazon SageMaker JumpStart aws.amazon.com +1
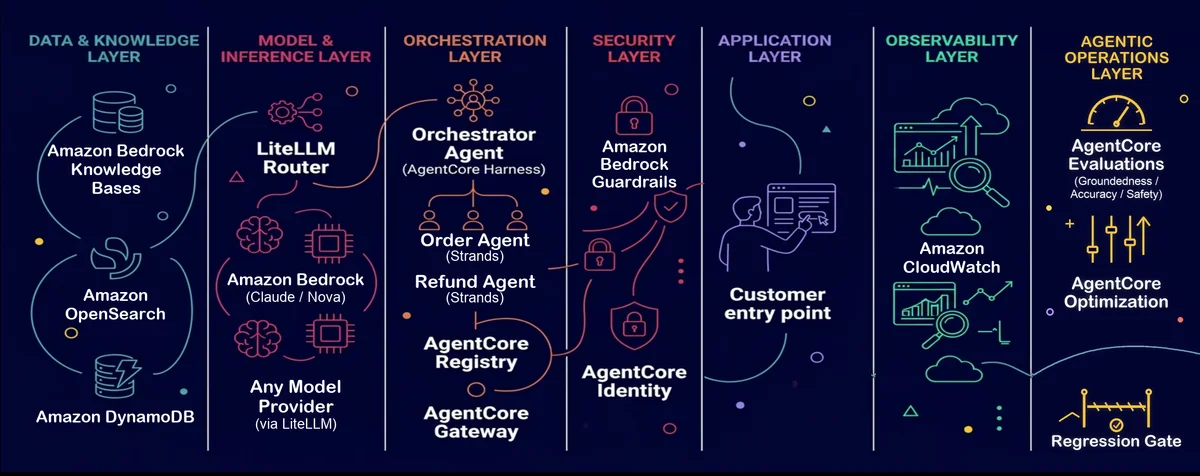
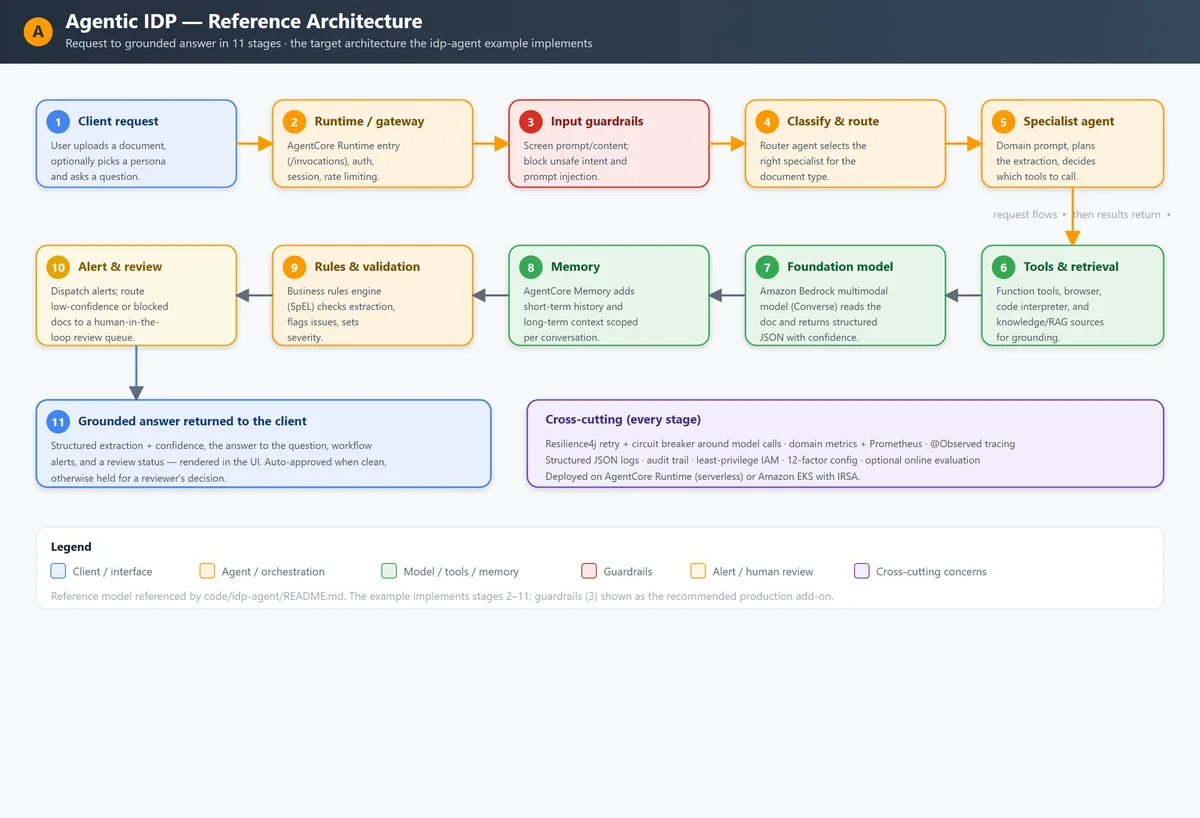
可插拔代理式人工智能框架:基于 Amazon Bedrock AgentCore 的七层可组合企业代理式人工智能参考架构 一种七层可组合参考架构,用于在 Amazon Bedrock AgentCore 上将企业级智能体 AI 从原型开发推进至生产环境。每一层均具备稳定的接口契约,因此可在任意层替换技术,而无需重新设计其余堆栈。 Pluggable Agentic AI Framework: A seven-layer composable enterprise agentic AI reference architecture on Amazon Bedrock AgentCore aws.amazon.com +1
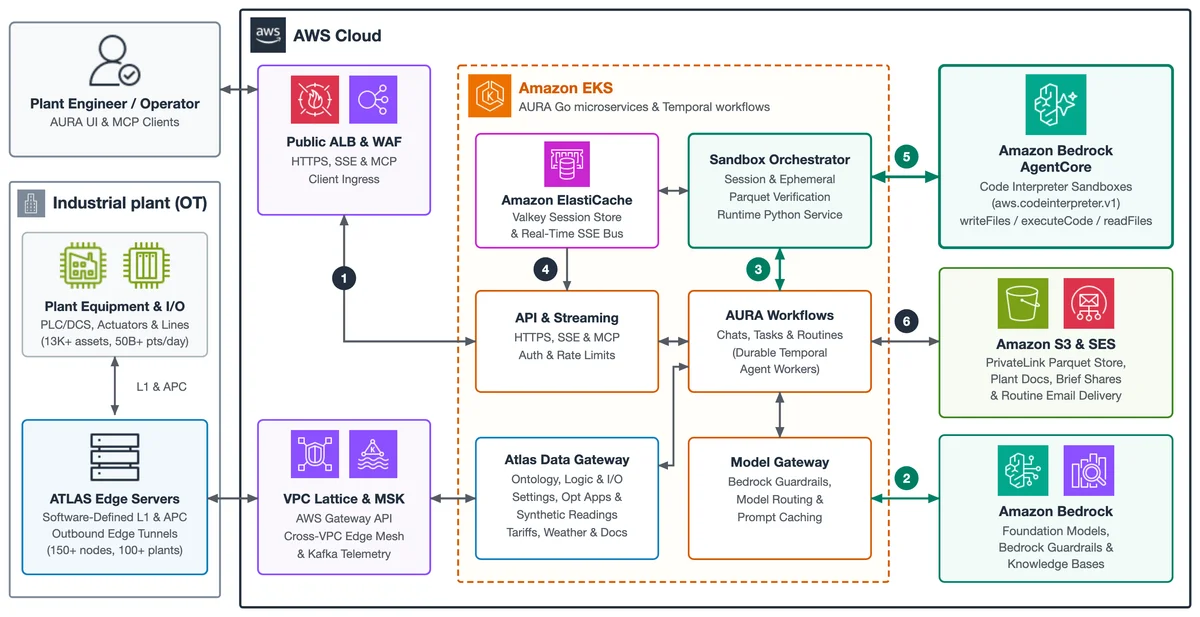
CrossnoKaye 如何利用 Amazon Bedrock AgentCore 为物理 AI 奠定坚实基础 CrossnoKaye 借助 Amazon Bedrock AgentCore 将物理 AI 引入重工业领域。其 ATLAS 平台与 AURA 代理系统基于实时工厂数据夯实 AI 推理能力,并在隔离的 AgentCore 沙箱中运行可验证的 Python 代码,为工厂工程师提供可核查、以数学为依据的答案,而非模型的猜测。 How CrossnoKaye grounds physical AI with Amazon Bedrock AgentCore aws.amazon.com +1
专业工作值得专业工具。认识 AWS Quick。 隆重推出 AWS Quick(原 Amazon Quick),以及我们首个品牌活动的亮相,以此致敬那些推动业务前行的团队。AWS Quick 是专为工作打造的 AI 工作空间,团队在此利用 AI 代理,在其已依赖的数据和应用中进行研究、分析并采取行动。 Professional work deserves professional tools. Meet AWS Quick. aws.amazon.com +1
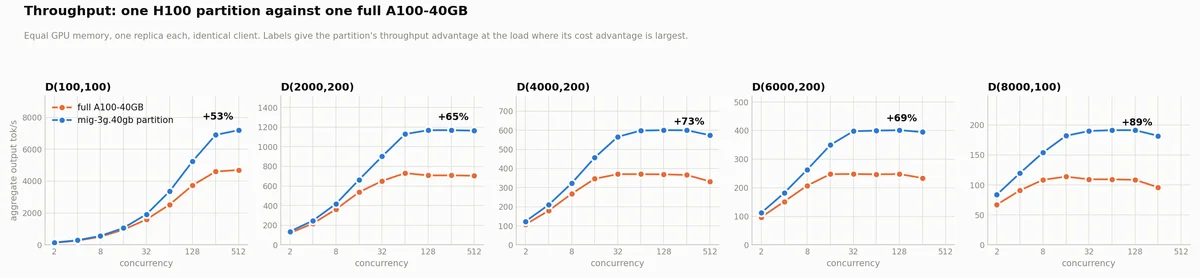
SageMaker Inference 现已支持多实例 GPU,以最大化模型端点的 GPU 利用率。 Amazon SageMaker 推理现已支持使用 NVIDIA 多实例 GPU(MIG)进行 GPU 分区,该技术可将单个 GPU 划分为硬件隔离的分区,使您能够在每个分区中运行不同的模型,或占用新一代加速器的合适比例。本文展示了如何通过两个可选的 API 字段实现每个分区部署一个模型,并对比了与整个旧版 GPU 的实测结果。 SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints aws.amazon.com +1
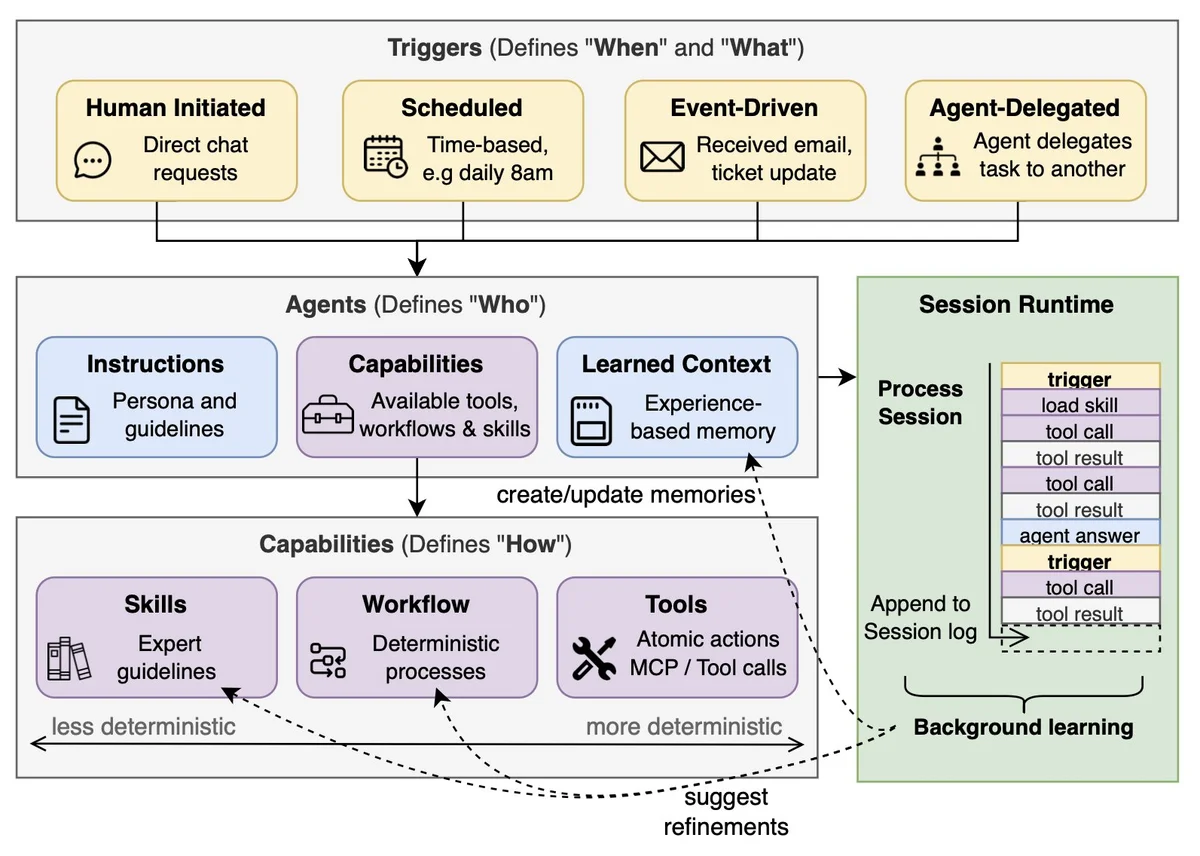
亚马逊快速智能原语的分类学 随着 Amazon Quick 的构建,其智能体从回答问题发展到执行操作,而相同的基础原语在不同名称下被反复重构。本文分享了我们最终收敛的分类体系——触发器、智能体、能力与学习上下文——该体系通过将智能体工作分解为四个朴素问题得出:何时(When)、何事(What)、何人(Who)以及如何(How)。 Taxonomy of agentic primitives in Amazon Quick aws.amazon.com +1