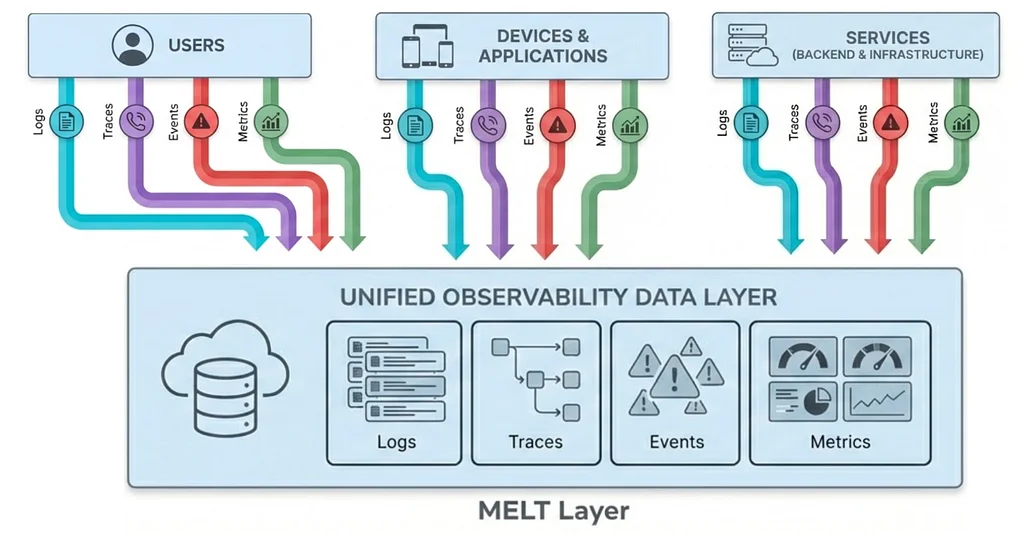
Netflix TechBlog | Medium 中文 关注 本体驱动的观测:在 Netflix 规模构建端到端知识图谱 该公司在理解其庞大而复杂的基础设施方面面临挑战,尤其是在像 Jake Paul 与 Mike Tyson 对决这样的大型直播活动期间,该活动吸引了 6500 万次流媒体观看。调试问题(例如主页渲染缓慢)可能需要数小时,因为相关信息分散在不同的系统中。这些系统通过指标(metrics)、事件(events)、日志(logs)和追踪(traces,合称 MELT)收集数据,但有效关联这些数据十分困难。核心问题在于缺乏对运维实体的共享、机器可读的理解。为解决这一问题,他们开发了一套“可观测性本体”(Observability Ontology),即对其运维世界中类型、属性和关系的形式化规范。该本体采用 RDF、OWL、SHACL 和 SPARQL 等标准,并将数据存储为知识图谱。一个关键的设计决策是避免使用通用的"Service"类型,转而采用具体且经过验证的类型,如 ops:Application。此外,他们还选择对事故讨论中的推理和上下文进行建模,将非结构化的聊天内容转化为结构化的三元组。该本体通过流水线方法,从本质上具有随机性的过程(如大语言模型 LLM 和模糊匹配)中实现确定性。该流水线使用“增强器”(enrichers),通过将嘈杂的输入转换为带类型的三元组来降低熵值,并遵循严格的契约。这些增强器确保每个实体都具有类型,URI 遵循命名规范,且应用程序需与目录进行验证。流水线按顺序运行以避免竞态条件,外部调用采用尽力而为(best-effort)方式以防止阻塞。随后,“关联引擎”(Correlation Engine)整合来自各种来源的信号,识别事件的因果或相关链条。它分析十三种信号类型,提出带有证据和置信度分数的假设,并存储支持性的图谱记录。每一次观测、增强、关联和存储的循环构成一个“知识飞轮”(Knowledge Flywheel),持续丰富知识图谱并提升系统上下文。该飞轮旨在通过提供统一且互联的系统运维视图,减少调试时间。 Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale netflixtechblog.com Netflix TechBlog | Medium 中文 RSS thenote.app

ops:Application。此外,他们还选择对事故讨论中的推理和上下文进行建模,将非结构化的聊天内容转化为结构化的三元组。该本体通过流水线方法,从本质上具有随机性的过程(如大语言模型 LLM 和模糊匹配)中实现确定性。该流水线使用“增强器”(enrichers),通过将嘈杂的输入转换为带类型的三元组来降低熵值,并遵循严格的契约。这些增强器确保每个实体都具有类型,URI 遵循命名规范,且应用程序需与目录进行验证。流水线按顺序运行以避免竞态条件,外部调用采用尽力而为(best-effort)方式以防止阻塞。随后,“关联引擎”(Correlation Engine)整合来自各种来源的信号,识别事件的因果或相关链条。它分析十三种信号类型,提出带有证据和置信度分数的假设,并存储支持性的图谱记录。每一次观测、增强、关联和存储的循环构成一个“知识飞轮”(Knowledge Flywheel),持续丰富知识图谱并提升系统上下文。该飞轮旨在通过提供统一且互联的系统运维视图,减少调试时间。