并非所有 LLM 工作负载都相同:分类与生成任务下的 TPU 性能基准测试
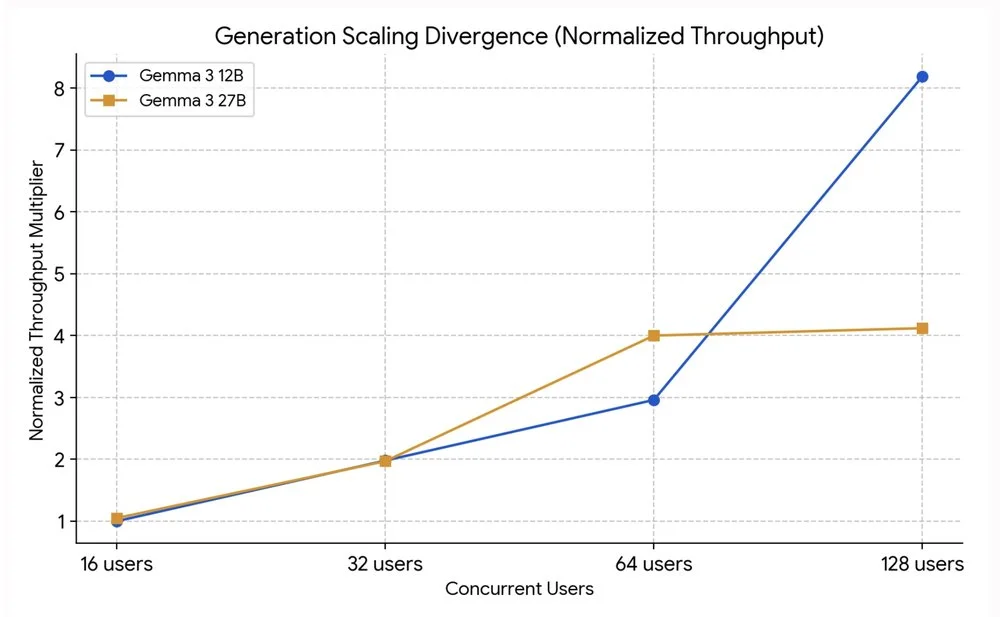
LLM 的企业级生产部署揭示了基础设施在性能与成本方面的关键作用。并非所有 LLM 请求对硬件的压力均等,因此标准基准测试不足以反映实际情况。本研究在 Google Cloud TPU v6e 上对比了 Gemma 3 12B 与 27B 模型,旨在理解在具有不同工作负载的规模化场景下的基础设施性能。对于以解码为主的生成任务,Gemma 3 12B 模型在高并发下具有更好的扩展性,而 27B 模型则会出现饱和现象;对于以预填充为主的分类任务,12B 与 27B 模型均表现出相似的扩展特性,使得部署更大模型而无需牺牲吞吐量。硬件饱和会导致延迟尖峰和静默请求丢失,因此必须依据端到端延迟而非仅凭 CPU/内存指标进行扩缩容。系统架构包括 GKE、TPU v6e、vLLM 服务框架以及 Gemma 3 模型。分类任务具有高输入、低输出特征,而生成任务则具有低/中输入、高输出特征。基准测试表明,12B 模型在高并发下的生成扩展性优于 27B 模型,而两者在分类任务上表现相近。为优化系统,应将模型选择与服务配置与特定工作负载的输入/输出特征相匹配。