Google Cloud Blog 中文 笔记

Google Cloud Blog 中文

cloud.google.com/blog 是 Google Cloud 的官方博客。它提供了 Google Cloud 产品和服务的新闻、更新和见解,以及云计算行业中的趋势和创新。 博客上有 Google Cloud 的专家、工程师和思想领袖撰写的文章,涵盖了人工智能、机器学习、数据分析、安全等广泛的主题。文章经常包括技术教程、案例研究和最佳实践,使博客成为开发者、IT 专业人士和对 Google Cloud 感兴趣的商业领袖的宝贵资源。 博客组织良好,文章按主题、产品和行业分类。访问者可以浏览最新的文章、搜索特定的主题或订阅博客的 RSS 订阅以跟踪最新的新闻和更新。 博客的一些关键特点包括: - 关于 Google Cloud 产品和服务的深入文章,如 Google Cloud Platform、Google Cloud Storage 和 Google Cloud AI Platform - 如何使用 Google Cloud 服务的技术教程和指南 - 来自 Google Cloud 客户的案例研究和成功故事 - 对行业趋势和创新见解和分析 - Google Cloud 的合作伙伴关系和协作的新闻和更新 - 与 Google Cloud 专家和思想领袖的采访 总之,Google Cloud 博客是任何对云计算、人工智能和相关技术感兴趣的人的宝贵资源。

笔记线程

CdXz5zHNQW_Me7SwPag7x.jpeg
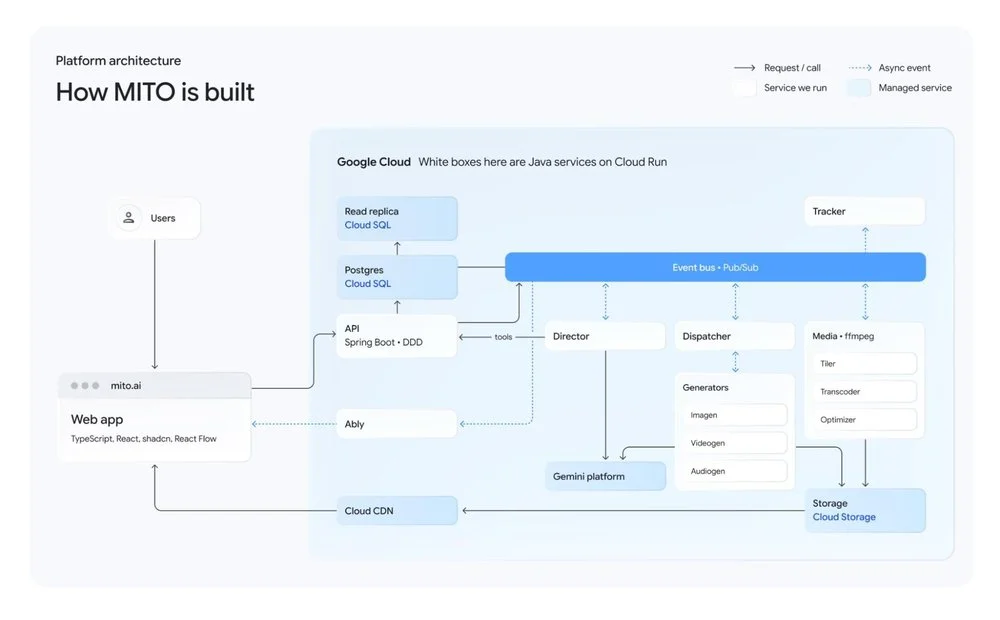
Mito 致力于推动 AI 驱动的视频创作民主化,使先进技术惠及所有人。其发展历程揭示了利用生成式 AI 制作长篇叙事内容时面临的重大基础设施与工作流挑战,包括管理庞大的本地媒体库、缺乏实时协作能力以及渲染延迟过长。生成式模型之间的一致性差异以及对公共 API 的容量限制,进一步加剧了这些困难。为应对这些问题,Mito 在 Google Cloud 上构建了一种无服务器、异步架构。他们利用 Cloud Run 部署 API 和后台工作进程,实现可扩展的处理能力;Google Cloud Pub/Sub 作为中央事件总线,用于解耦任务执行。媒体资产存储于 Google Cloud Storage,并通过 Cloud CDN 分发以最小化延迟。采用隔离的数据库架构,结合 Cloud SQL 和 PostgreSQL,支持分析工作而不影响生产环境。他们通过 Vertex AI 调用基础模型,并辅以自定义系统提示词。前端实施"6 条规则”以优化提示词变量,并优先采用静态帧生成以提升成本效益。该方案成功助力 Movistar Plus+ 打造了一项具有里程碑意义的全国性广播活动,其中 95% 的内容由 AI 生成。该活动覆盖西班牙所有主要电视频道,展示了 AI 导演(AI Director)的对话能力与实时协作功能。Mito 的架构具备前瞻性,能够适应日益快速的渲染速度和更先进的 AI 能力。他们构建了由 Gemini 驱动的自动化评估框架,用于验证创意输出。AI 导演能够动态将任务路由至多个专用模型,实现智能协调。此外,Mito 还拥抱“不完美美学”,以增强叙事的真实性,并融入超现实视觉元素。
CdXz5zHNQW_tOhDlbvIcv.jpeg
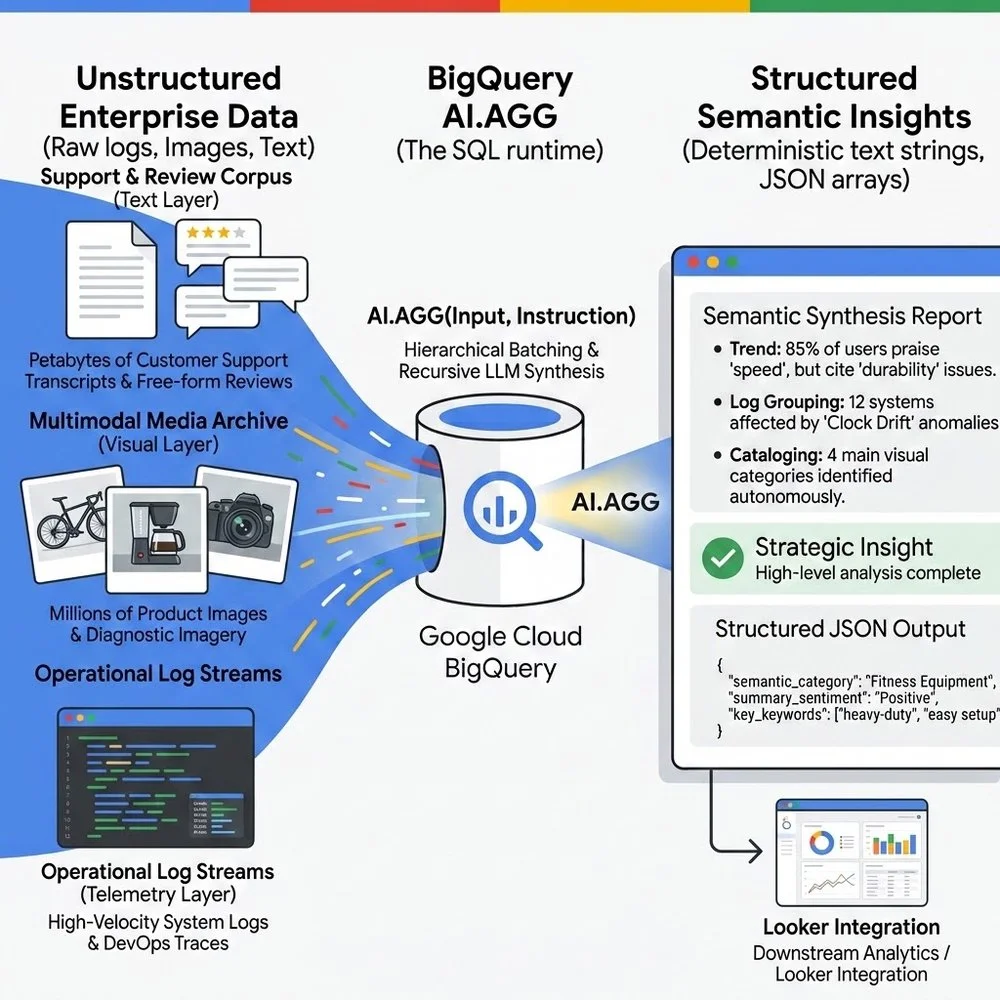
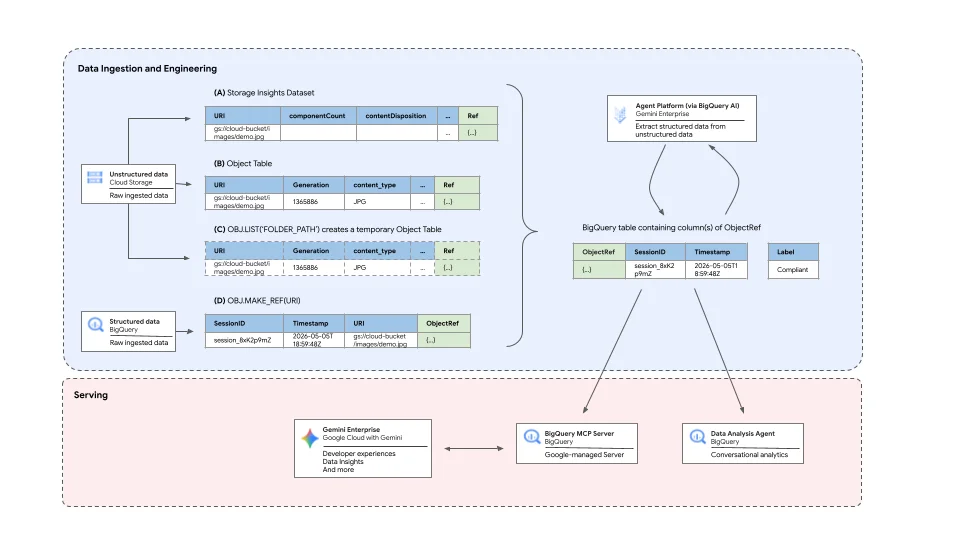
BigQuery 的新功能 AI.AGG 目前处于预览阶段,通过直接在 GoogleSQL 中实现多层级语义聚合,彻底改变了非结构化数据分析。该功能解决了传统关系型 SQL 引擎因大语言模型(LLM)上下文窗口限制而在从海量文本和多模态数据集中综合洞察方面存在的重大缺口。AI.AGG 将语义聚合概念化为分布式 Map-Reduce 问题,使数据团队能够通过单个 SQL 查询对数百万行数据执行自然语言指令。其底层的多层级批处理架构自动处理行验证、上下文安全批处理、通过 Vertex AI 进行并行推理,以及使用全权重 LLM 进行递归合成,直至生成单个聚合字符串。该功能原生支持文本和多模态输入,利用 BigQuery 对象表进行图像分析而无需数据移动。AI.AGG 旨在支持变革性的企业用例,例如对高容量系统日志进行诊断分析,以及构建用于自主数据标注管道的“代理数据云”。AI.AGG 的提示工程需要明确的输出契约、上下文分隔符、失败状态设计和少样本锚点,以确保程序化的 SQL 输出。成本管理涉及使用 WHERE 和 LIMIT 子句进行预过滤,并利用 Gemini 上下文缓存,同时使用 AI.COUNT_TOKENS 进行估算。该功能运行在 BigQuery 的治理框架内,支持 VPC 服务控制,并在瞬态错误时优雅降级。预览阶段的护栏包括每组 10,000 个 token 的输出上限、每行 10 MiB 的限制,以及针对处理最多 2,000 万行数据和 1,000 个不同 SQL 组的建议。AI.AGG 将企业数据仓库转变为活跃的语义运行时,使 PB 级语义分析得以普及。
CdXz5zHNQW_uaHoQyzKVt.jpeg
CdXz5zHNQW_rMp6SvhdPH.png
当前数据库难以跟上由 AI 驱动的软件开发的高速发展,导致在资源 provisioning、测试和生产环境迁移中出现瓶颈。AlloyDB Express 作为 AlloyDB for PostgreSQL 的新产品,旨在解决这些挑战。它专为开发人员和 AI 编码代理设计,可在两秒内快速创建数据库。该服务在空闲时自动暂停,通过实现 15 分钟无活动后缩容至零(scale-to-zero)的功能来降低成本。这一新产品弥合了快速 AI 驱动开发与稳健企业级基础设施之间的差距。AlloyDB Express 提供面向代理的数据库体验,内置企业级安全性和 AI 能力。它支持一键升级至生产规模,同时保留数据和配置。安全至关重要,其功能包括用于隐藏 IP 地址的公共 DNS 端点以及用于安全内部集成的私有 VPC 网络。细粒度的访问控制(包括 Google Cloud IAM 和原生 PostgreSQL 角色)确保用户和代理遵循最小权限原则。关键的是,AlloyDB Express 将 AI 工具直接集成到数据库中,无需外部向量存储。开发人员可利用 pgvector HNSW 和 Google 的 ScaNN 索引进行快速向量搜索,以支持语义搜索和推荐引擎。该服务还提供在 SQL 查询中直接访问 Gemini 模型的能力,用于文本和图像嵌入生成、过滤及摘要等任务。自然语言转 SQL 生成功能进一步简化了开发人员和 AI 代理的查询创建过程。AlloyDB Express 具备简单直观的定价模式,在空闲时缩容至零,同时确保数据安全。活跃计算按每计算单元(Compute Unit)小时 0.115 美元计费,暂停的计算不收费。存储费用为每 GB-月 0.30 美元,并提供每月 50 个免费计算单元的免费层级。这一具有成本效益的解决方案加速了应用构建,并能无缝扩展至生产环境。AlloyDB Express 目前处于预览阶段,邀请用户探索其功能以提升开发效率。
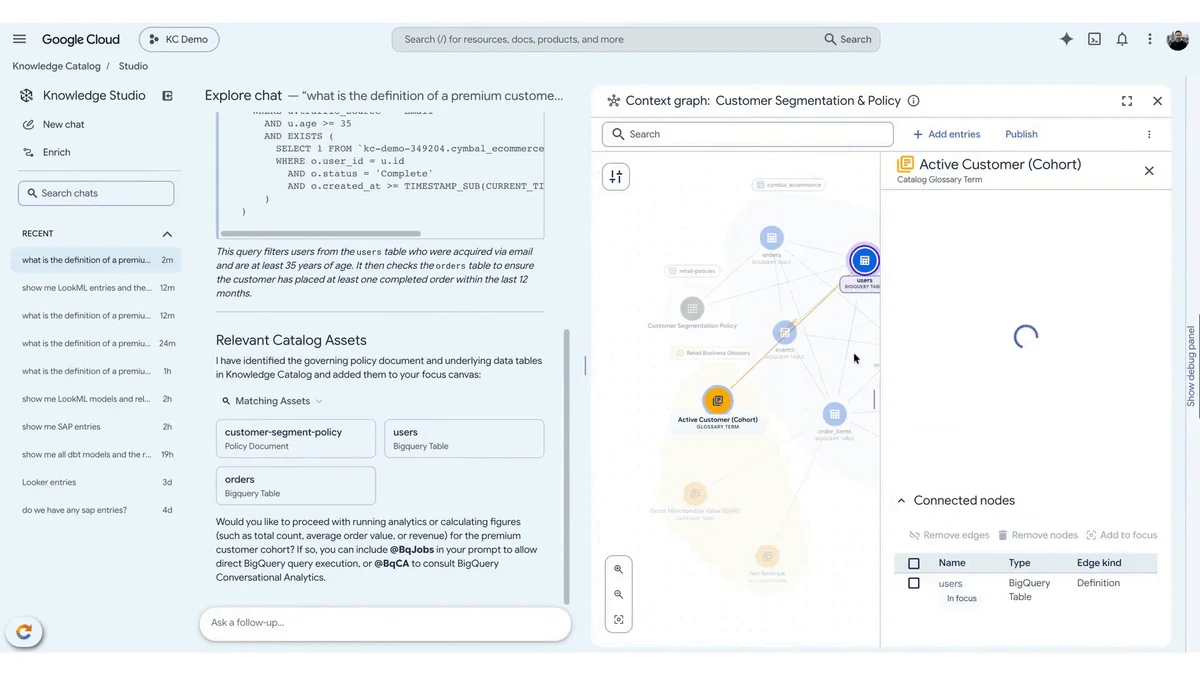
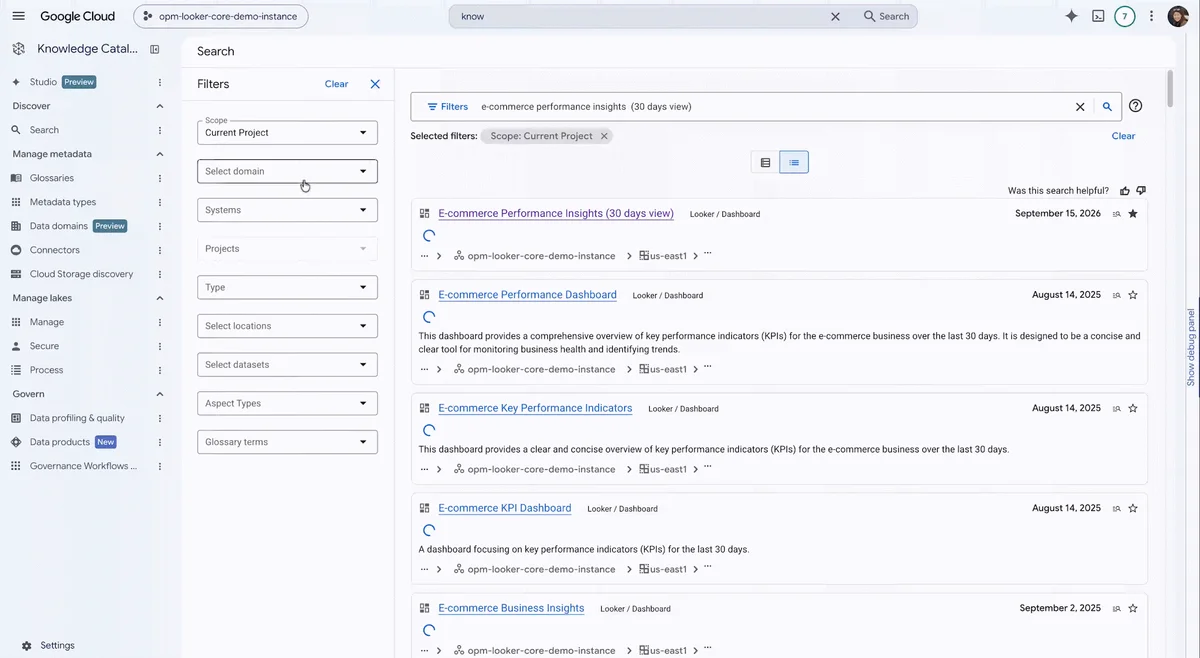
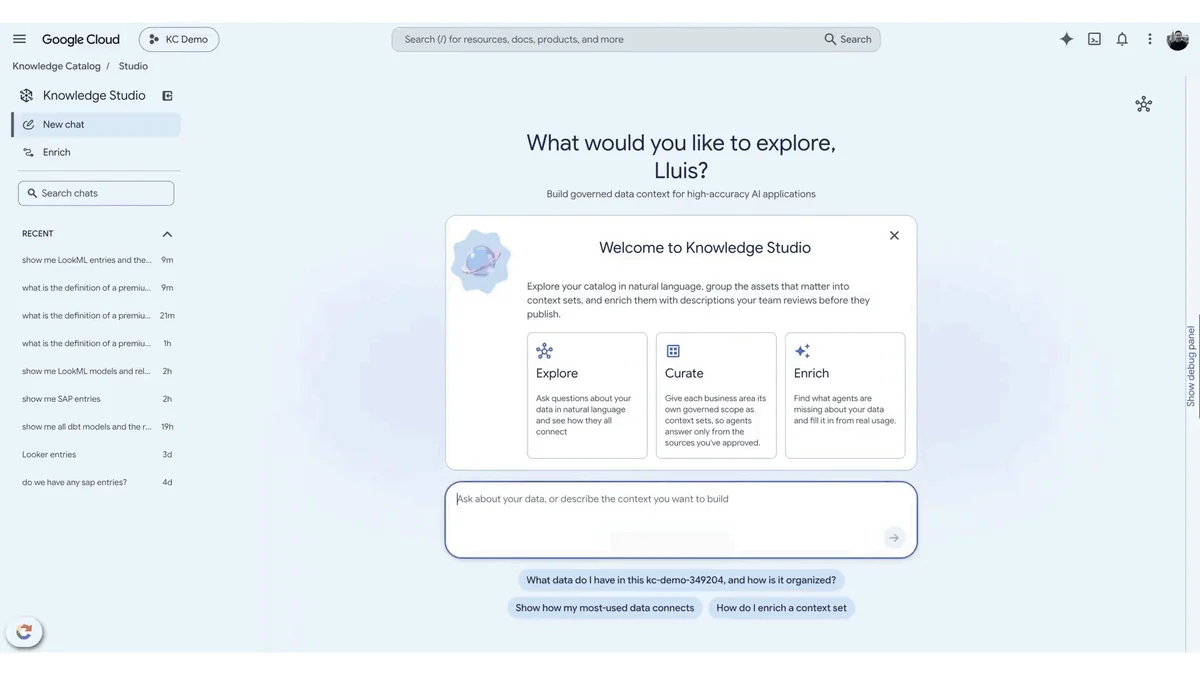
组织正越来越多地利用代理驱动自动化来提升收入、效率及风险管理能力。Google 的代理数据云(Agentic Data Cloud)是一套行动系统,旨在统一企业数据、确保数据准确性,并以低成本实现主动运营。无边界湖仓(borderless Lakehouse)采用开放的 Apache Iceberg 格式,激活分布于多云、本地及 SaaS 平台上的分布式数据。新增功能使 Gemini 能够通过自然语言查询湖仓,跨云互连则提供安全且无数据出网费用的数据访问。AlloyDB 集成使代理能够直接查询 Iceberg 表,高效地关联历史数据与实时数据。Spanner Omni 为混合代理应用扩展了 Google 级别的 consistency 与扩展能力。Knowledge Catalog 作为 Google Cloud 的通用上下文引擎,为代理提供企业级上下文,从而提升准确性、降低延迟并减少 token 成本。自学习增强与可复用的 OKF 上下文集可自动化从 Google Workspace、SharePoint 等非结构化来源的上下文策展。Knowledge Catalog 新增的 Studio 体验提供对话式界面,用于探索和管理上下文。Knowledge Catalog 现已成为 Gemini 的默认选项,将数据问题锚定于受管制的业务上下文,并支持来自各类平台的可信语义模型。Google 正在重塑从业者体验,使数据与机器学习工程师能够借助 Gemini 的机器学习能力,编排代理以实现意图驱动的结果。业务用户只需提问即可生成实时运营报告。Data Agent Kit 将 Google Data Cloud 工具集成至开发者偏好的 IDE 和命令行界面中。Google 还在为代理规模构建数据基础设施,推出 AlloyDB Express 用于快速原型开发,以及用于 AlloyDB 中代理生产的 PostgreSQL。Managed Service for Apache Spark 进一步提升了性价比,BigQuery 则通过更快的查询、用于 PB 级图分析的 BigQuery Graph,以及新的 Google Research 模型(如 TimesFM 3.0 和 TabFM)得到增强。
CdXz5zHNQW_OVtRDwO1CM.gif
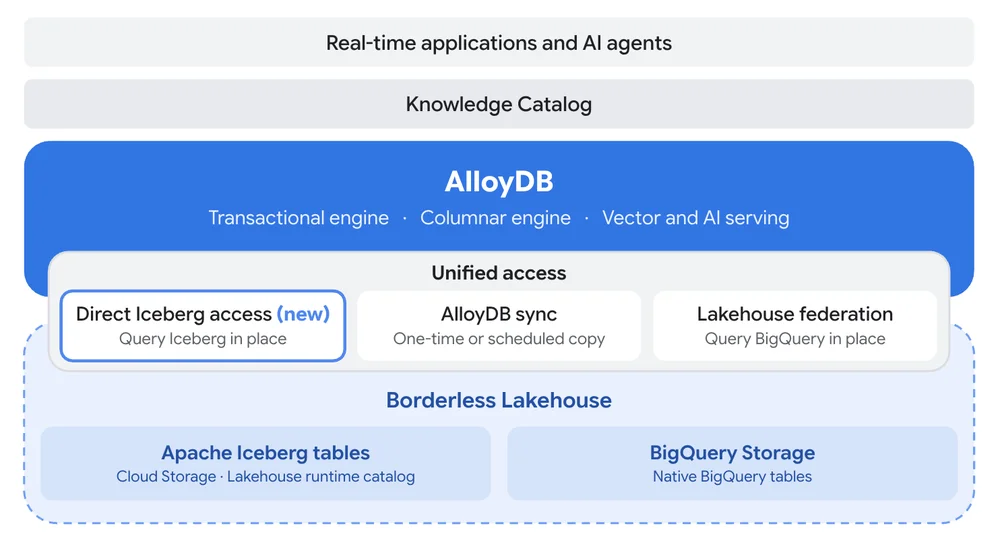
企业需要实时运营数据和历史分析数据以支持有效决策。传统上彼此分离的数据系统如今正趋于融合,AlloyDB for PostgreSQL 的新功能便是例证。Google Cloud 现已推出直接访问 Iceberg 的功能,允许开发人员直接从 AlloyDB 查询云存储中的 Apache Iceberg 表,并通过单条 SQL 查询将其与实时数据关联。此项集成目前处于预览阶段,在聚合查询方面显著快于其他服务。此外,AlloyDB Sync 和 Lakehouse 联邦现已普遍可用,提供了三种与“无边界 Lakehouse"交互的主要方式。直接 Iceberg 访问就地读取 Iceberg 表,利用 AlloyDB 的列式引擎实现加速。AlloyDB Sync 将 Lakehouse 数据从 BigQuery 复制到 AlloyDB,适用于低延迟、频繁访问的工作负载,并按用户定义的 schedule 进行刷新。Lakehouse 联邦使 AlloyDB 能够直接查询原生 BigQuery 表,由 BigQuery 负责处理。这些集成消除了对自定义数据管道的需求,使应用程序和 AI 代理能够无缝地基于合并的运营数据和 Lakehouse 数据采取行动。现实应用案例包括欺诈检测、个性化推荐和动态定价,其中 Lakehouse 提供的历史背景信息可 informing 数据库中的实时决策。数据团队还可将精心整理的表一次性发布到 Iceberg,允许多个应用程序就地读取。直接 Iceberg 访问允许像操作其他 PostgreSQL 表一样注册和查询 Iceberg 表,从而受益于内置支持和列式引擎。AlloyDB Sync 解决了需要极低延迟读取非频繁变更数据的需求,通过在 AlloyDB 中创建可刷新的本地副本来实现。Lakehouse 联邦则面向那些在 BigQuery 中拥有大量历史数据的组织,将处理下推至 BigQuery 并仅返回结果。集成方式的选择取决于数据位置、应用程序读取模式以及延迟要求。
CdXz5zHNQW_fVS3LutEP2.png
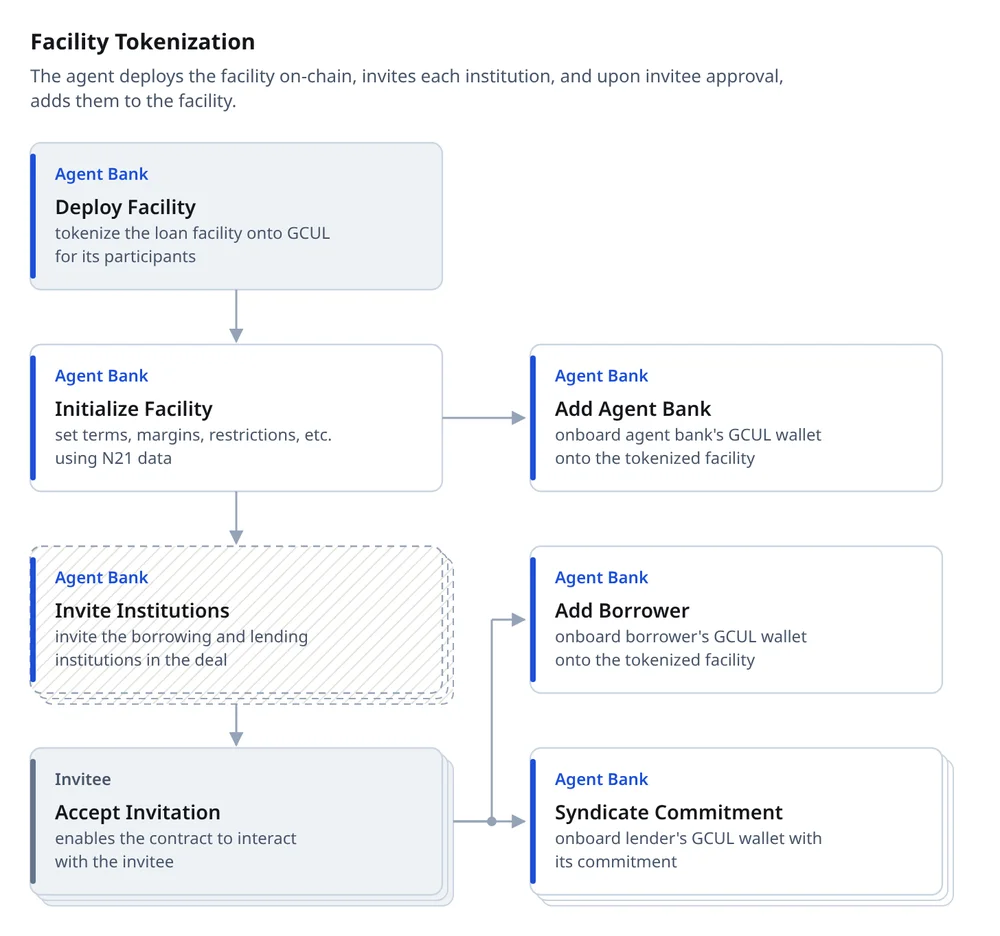
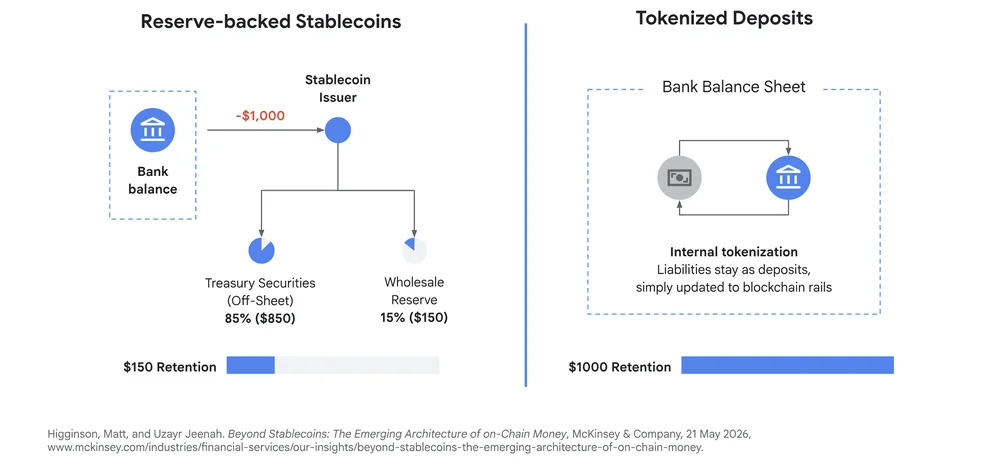
银团贷款和私募信贷市场因手工流程而面临结算缓慢和估值不透明等挑战。金融科技创新者 Nammu21 与 Google Cloud 合作,通过一个新的概念验证项目解决这些问题。该解决方案利用 Nammu21 的 AI 平台,将法律协议结构化并部署为 Google Cloud 通用账本(GCUL)上的智能合约,从而自动化整个贷款生命周期。当前贷款市场受限于对法律文本的碎片化、人工解读,导致结算周期冗长,进而占用资本并增加风险。Nammu21 将定制化信贷文件数字化为数字信贷工具(DCIs),将所有条款映射至其原始法律条款,并将其表达为可执行的行为。GCUL 为实例化这些工具提供安全、高性能的分布式账本环境,实现近乎即时的交易最终性和可预测的成本。GCUL 上的可编程合约使用 gculpy 编写,这是一种安全、可读且可审计的领域优化编程语言。该平台通过简化复杂的内存管理,为金融机构 streamlined 开发流程。Nammu21 发挥双重作用:程序化地从法律协议渲染 DCIs,并推导用于治理 GCUL 上贷款的 gculpy 合约。该架构创建了一个单一、不可篡改的真相来源,如建模的 Term Loan B 交易所示。该系统通过门控执行确保合规性,为敏感数据维护基于角色的隐私,并提供结算最终性。这一结构性转变从根本上改变了信贷市场,缩短了结算时间,降低了后台运营成本和交易对手风险。
CdXz5zHNQW_BVawpnmXci.png
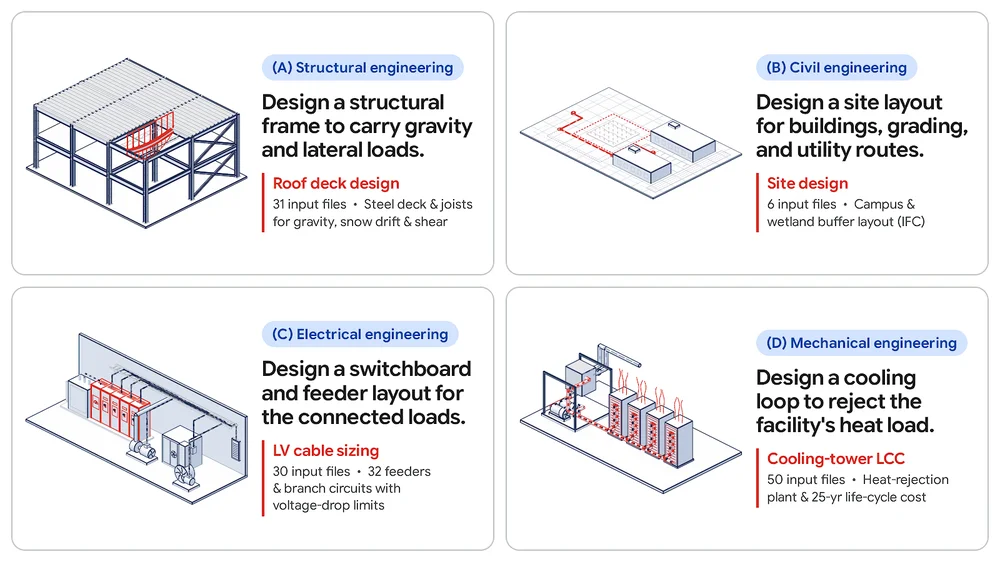
Google AI 与基础设施团队与 Mercor 合作推出了 Physical-Engineering's Last Exam(PLE),一项新的基准测试与开放竞赛。PLE 评估前沿模型完成机械、电气、土木及结构工程任务的能力。该举措填补了现有基准的空白,后者主要集中于教科书式问题或孤立的工程设计问题。与以往如“人类终极考试”或“智能体终极考试”不同,PLE 专门衡量 AI 在物理世界构建任务方面的能力。PLE 包含 85 个长周期任务,模拟真实世界工程项目,每个任务平均涉及 61 个文件。这些文件涵盖各类工程文档,要求智能体通过代码、规范限制和计算进行推理,以生成可交付的生产就绪成果。这些任务通过与从业工程师合作开发而成,或由专家撰写,或与智能体流水线共同完成。在 14 个前沿模型上使用七种智能体框架进行的初步测试显示,所有模型在私有测试集上的得分均低于 50%。表现最佳的模型平均得分为 48.3%。一项重要发现是,尽管在共同撰写的任务中满足了 91% 的单项约束,但仅有 41.3% 的高分智能体交付成果通过了所有严格的安全性与可行性检查。模型选择对性能影响显著,得分差距可达 50 分;而框架的影响较小(中位数为 3 分差距),但会影响运行成本。该基准为开发能够支持物理工程师的 AI 工具提供了务实的一步。研究人员可访问 29 个公开任务、评分工具,并前往 ple-bench.com 加入开放竞赛。Google 将免费在其服务器上为 13 个模型提供评估服务,奖金详情即将公布。
CdXz5zHNQW_wib2wXWofK.png
CdXz5zHNQW_vlPfeReDza.png
CdXz5zHNQW_rJ0u9E2bkZ.png
CdXz5zHNQW_Kz3Qpap97Z.png
CdXz5zHNQW_qDLEvNBkS9.gif
在应用程序开发中自主代理的日益普及,为身份与访问管理(IAM)带来了重大挑战。这些代理能够以机器速度配置云资源并部署服务,却可能遭遇安全摩擦,从而拖慢持续集成/持续部署(CI/CD)流水线。为应对这一“代理时代”的 IAM 挑战,Google Cloud 推出了 IAM Helper。IAM Helper 提供面向代理的智能构建模块,可自动化自主代码助手和部署流水线中的复杂 IAM 工作流。它作为 Google Cloud IAM 的原生代理编排层,与现有引擎(如策略智能和特权访问管理器)集成。这种集成使自主代码能够直接调用 IAM 技能,降低管理开销并提升安全性。IAM Helper 赋能代理动态管理访问权限,将策略评估和复杂编排的负担转移至 Google Cloud 后端。这些端到端工作流和护栏采用 Agent Skills 标准封装,可与 Gemini、Claude 等常见代理协同工作。IAM Helper 技能内置护栏,将只读发现与策略变更分离,并提供自动化诊断与模拟。策略变更需通过可定制的风险等级获得人工确认。例如,代理遇到权限错误时可自动排查问题、请求临时授权并解决该问题。自主流水线可通过生成最小权限策略、对照日志验证并将变更路由至审批流程来实现自愈。IAM Helper 还协助编写合规策略,生成并验证 IAM v1 和 v2 规则,同时阻止高风险配置。它通过识别缺失权限实现 403 错误的快速排查,并允许在发布前模拟策略变更以评估影响范围。此外,它支持按需特权访问而非长期权限,确保访问经过审计且有时限。这些代理技能由基础 Google Cloud IAM MCP 工具驱动,提供原子性、只读函数以高效查询 IAM 端点。使用这些工具可避免定制 API 包装器,最大化 token 效率,并允许代理安全执行多步骤操作。团队可访问 IAM Helper 代理技能目录和官方文档,开始实施这些能力。
CdXz5zHNQW_xA5im0bBF2.gif
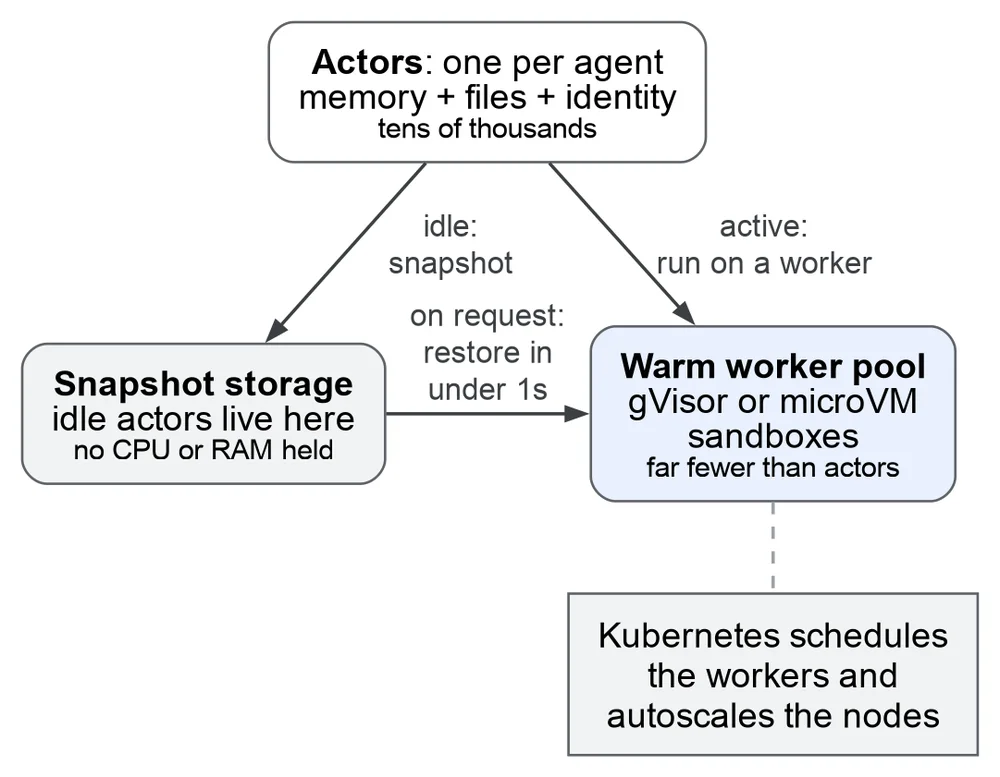
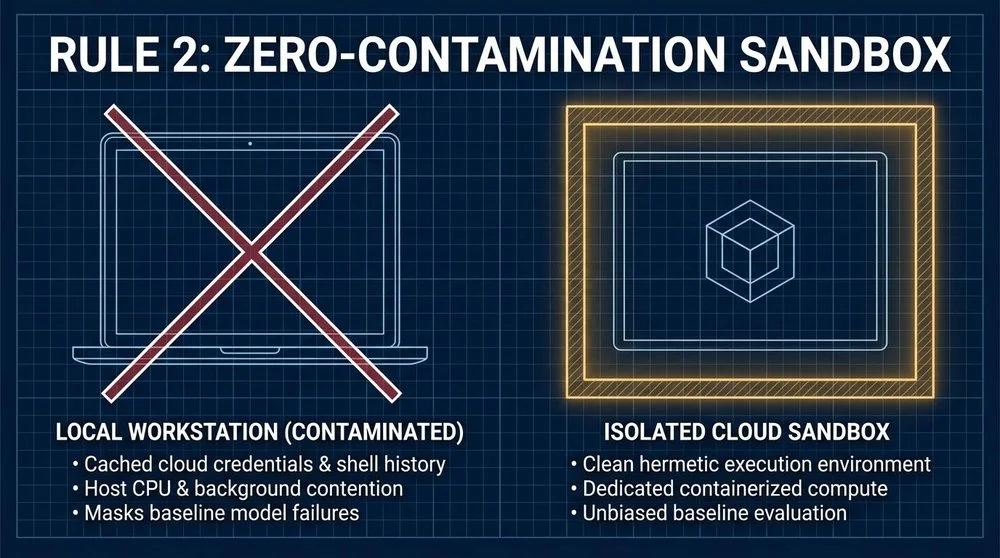
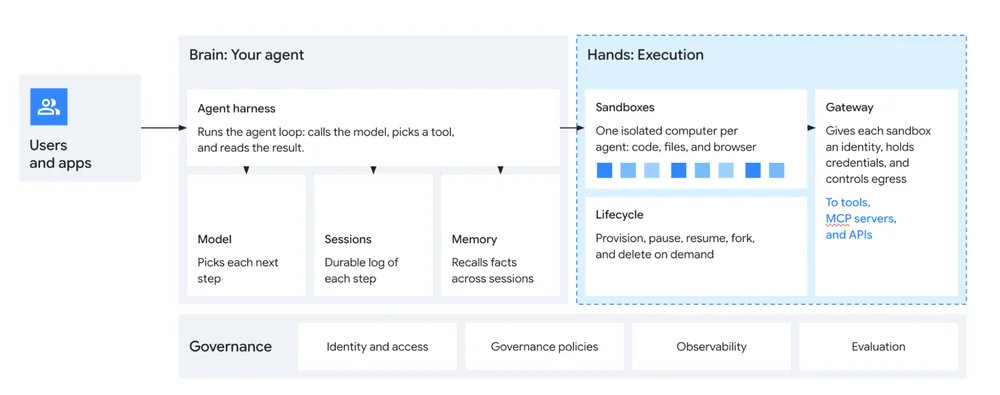
软件行业面临周期性的架构变革:在 Web 规模爆发之后,出现了仓库级计算和容器技术,而张量处理单元(TPU)则是为了满足深度学习需求而开发。谷歌还推出了 Titanium,以提供基于硬件的安全保障。如今,一个根本性的转变正在发生,即代理式人工智能(agentic AI)的兴起:AI 代理不再仅限于回答问题,而是能够执行行动。这些代理正越来越多地编写代码、运行工具并编排工作流,从而迅速消耗计算和存储资源。传统的计算原语已不足以以低成本和低延迟运行数百万个此类代理。这催生了一种新的形态,即 Agent Compute Engine,一项谷歌云服务,为 AI 代理提供硬件隔离的微虚拟机(microVM)。Agent Compute Engine 旨在弥合虚拟机隔离性与容器的速度和密度之间的差距。现有虚拟机启动和停止速度过慢,难以满足频繁暂停和恢复代理的需求;而容器虽然快速,却缺乏某些代理任务所需的隔离性和内核级控制。该系统需要高效地管理代理,识别其活跃或空闲状态,以避免资源浪费并保留工作状态。Agent Compute Engine 被设计为一个统一平台,为持久化、硬件隔离的计算提供微虚拟机抽象。这一新架构支持多样化的工作负载,包括交互式代理界面、自主软件工程、大规模评估以及针对谷歌服务的轻量级沙箱。安全至关重要,采用纵深防御策略,以通过 Titan 硅芯片和 Titanium IPUs 实现的硬件根信任为基石。主机完整性通过无状态、不可变设备得以维持,代理会话则在单租户微虚拟机内进行隔离。零密钥架构确保敏感凭证不会驻留在沙箱内,即使 guest 操作系统被攻破也能保障安全。网络访问受到严格限制,所有流量均通过中介代理流转,由策略驱动的出站代理机制进行管控。对传输中及静态数据均实施了端到端加密。系统配备了自动补丁、运行时检测以及持续的安全措施,并严格分离代理运行环境与沙箱。系统基于“沙箱可能被攻击者控制”的假设运行,因此不持有任何凭证,且无直接网络访问权限。治理通过一等代理身份实现,由注册表和认证管理器统一管理;该认证管理器充当代理的保险库和代理。
CdXz5zHNQW_XUm165nYZ0.png
CdXz5zHNQW_U6mQXXQiGC.png
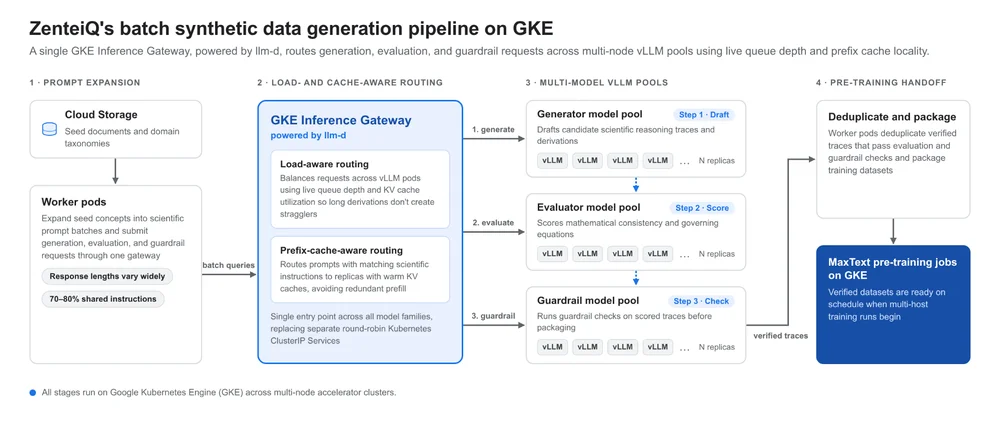
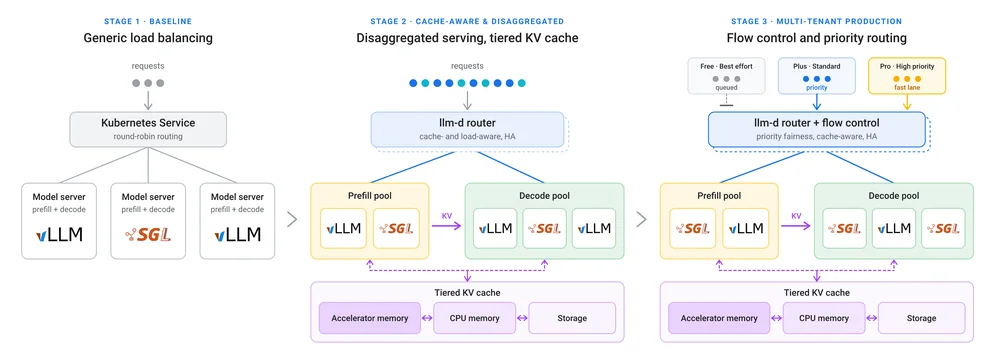
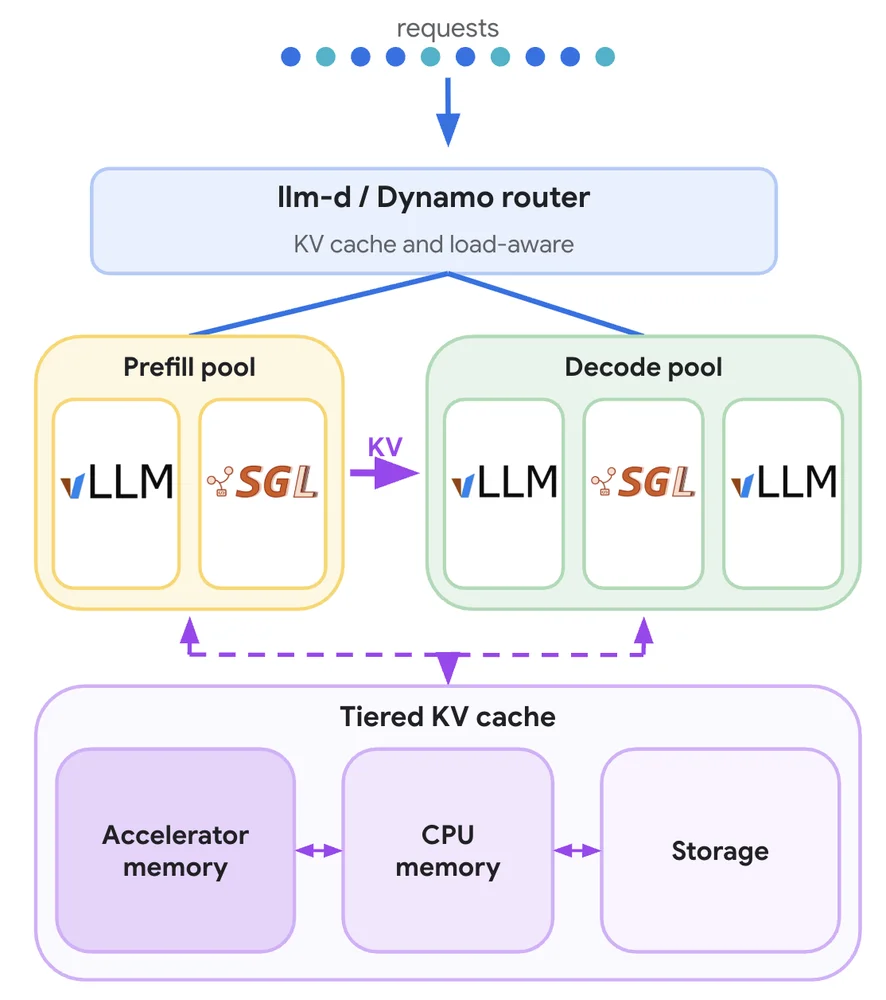
PyTorch Conference 2026 推出了用于在 Google Cloud 及其他基础设施上运行 PyTorch 的新产品与集成方案。TorchTPU 作为 Google TPU 的原生 PyTorch 栈,现已在 GitHub 上开源。这使得用户能够借助 vLLM、SGLang 和 Hugging Face 等熟悉工具,在 TPU 上实现模型的无缝训练、推理与服务部署。该集成为用户提供包括 TPU、GPU 和 CPU 在内的多种计算选项,并保持一致的操作模型。TorchTPU 支持以最小代码改动和熟悉的 API 在 TPU 上运行现有的 PyTorch 工作负载;它支持 eager 模式调试,并通过 torch.compile 优化 TPU 利用率与内存使用。Hugging Face 模型现可原生运行于 TorchTPU,通过设置 device_map="tpu" 简化部署。推理优化通过 TorchTPU 与服务引擎的集成以及跨 TPU 和 GPU 的舰队路由实现。vLLM 在 TPU 上提供高吞吐服务与内存效率,支持连续批处理与量化等特性。SGLang 通过在请求间复用 KV 缓存,加速 TPU 上的代理式与结构化工作负载。llm-d 1.0 作为 CNCF Sandbox 项目,将 PyTorch 服务引擎与 Kubernetes 连接,以支持分布式 LLM 推理。TorchTitan 提供原生的 PyTorch 分布式高性能大规模训练,已在数千个 TPU 上得到验证。VeRL 这一流行的强化学习框架现已包含 TPU 后端,支持可扩展的后训练与强化学习工作负载。Ray 已添加原生 TorchTPU 支持,可在单一工作流中编排跨多种加速器的 AI 流水线。LiteRT 作为 Google 的端侧 AI 推理解决方案,现已加入 PyTorch 生态系统,使 PyTorch 模型能够在多样化设备上运行。TPU 代理套件也已在 GitHub 上进入早期预览阶段,用于自动化 PyTorch 模型在 TPU 上的接入、诊断与性能调优。
CdXz5zHNQW_YCinlopqHk.jpeg
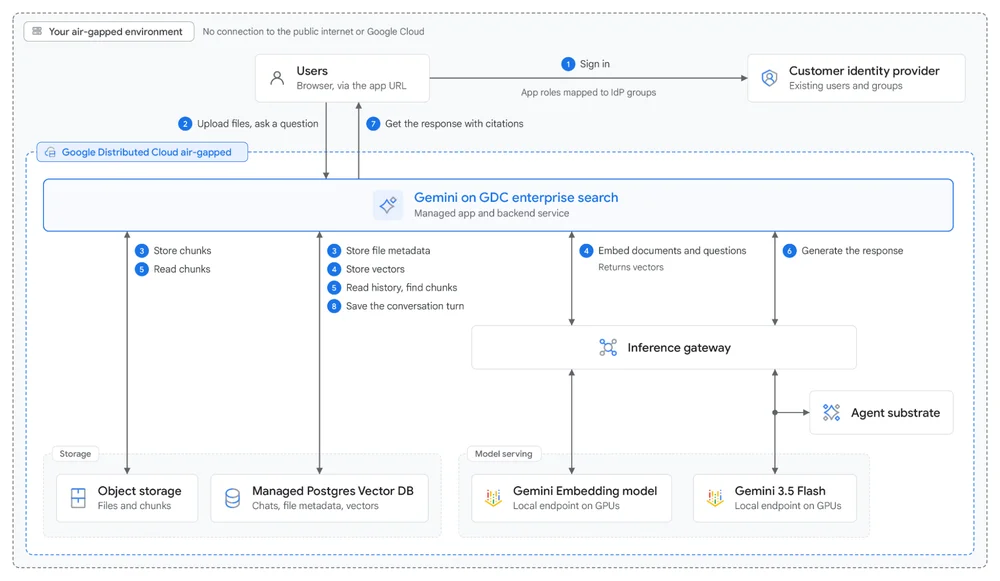
Google 正在举办一场峰会,探讨公共部门如何通过技术实现雄心勃勃的目标。公共部门领导层面临着在复杂性和资源有限的背景下,对速度与效率日益增长的需求。尽管许多机构已采用 AI 智能体,但其广泛普及仍受限于遗留数据孤岛和集成挑战。Google 旨在通过安全、可扩展的技术简化这些流程。该公司推出了 Gemini 智能体,这是一款适用于各类工作任务的通用助手,能够与现有系统集成并遵循组织的安全控制策略。"Gemini for Government Services"是一个专为公共部门安全和工作流需求设计的新平台,能够在无需数据迁移的情况下实现与现有系统的安全连接。Wiz 智能体现已在通过 FedRAMP 认证的"Wiz for Gov"环境中可用,以加速关键优先事项(如后量子密码学)的修复工作。Wiz 还通过其"Scan for Good"计划提供免费的安全评估服务。企业级搜索能力正被引入 Google Distributed Cloud 上的 Gemini,以支持隔离环境(air-gapped environments),从而在不牺牲互联网安全的前提下对机密数据进行分析。与 America.gov、SUNY、能源部、美国陆军及战争部的合作,展示了 Google 技术如何推动任务成效。这些合作聚焦于简化联邦服务访问、推进研究、加强国家安全以及优化后勤。凯斯西储大学(Case Western Reserve University)正利用 Gemini 提升学习与研究能力。Google 强调其作为智能体时代任务合作伙伴的角色,鼓励公共部门实体携手共建并创造影响力。
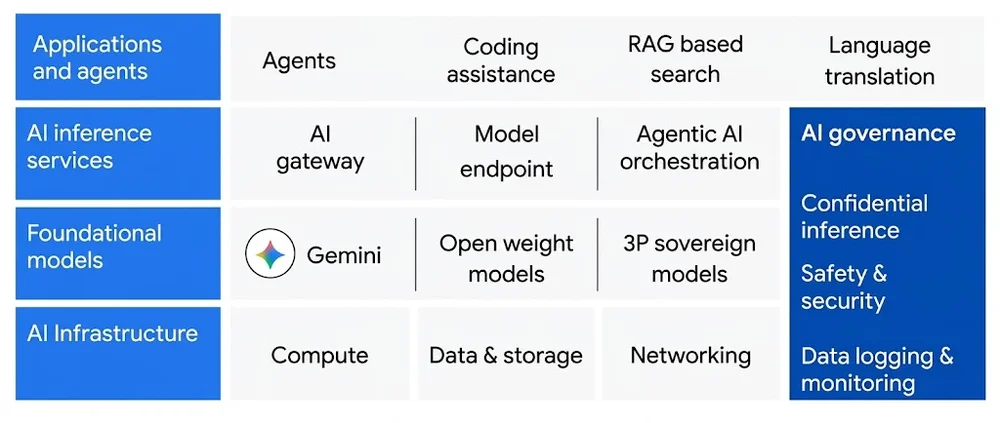
代理系统对企业日益重要,但拥有严格数据主权要求的组织在部署时面临挑战。将敏感数据发送至公有云往往不可行,而构建私有 AI 堆栈则耗时漫长。Google 分布式云(GDC)的隔离式创新现已解决这一问题,使代理系统能够直接部署在敏感数据所在之处。关键进展包括由 Gemini 驱动的企业主机搜索、对开放权重模型的支持、开箱即用的 ISV 应用程序以及加速的基础设施。GDC 旨在将孤立的基础设施转变为具备灵活性的现代代理创新平台,其灵活性源于基础模型与开放模型。GDC 上的 Gemini 企业搜索提供对话式界面,用于查询主权边界内庞大的数据仓库。它支持文本、音频和视频等多模态数据,具备低延迟推理和内置的检索增强生成(RAG)能力。GDC 隔离式现已普遍可用,支持 Gemini 3.5 Flash 以及 Gemma、Mistral 等领先的开放模型,赋予工作负载选择权。该平台具备全新的、升级的基础设施即服务(IaaS)堆栈,可共同运行 AI 与传统工作负载。其中包括搭载 NVIDIA Blackwell GPU 的 A4 Ultra 机器类型,用于高性能代理基础设施,以及高可用托管网络解决方案。不断扩展的 ISV 合作伙伴生态系统将 Teradata、Solo.io 和 Mattermost 等熟悉软件原生引入 GDC。这些集成使组织能够在不牺牲数据隐私、不遗留熟悉工具的前提下利用 AI,在合规、安全且受控的隔离环境中将敏感数据转化为可操作的洞察。
CdXz5zHNQW_WoYmLn2p8a.png
汽车行业正迅速向软件定义车辆转型,将核心功能从物理硬件迁移至数字系统。虽然信息娱乐系统和高性能计算系统常采用云原生方法开发,但许多关键微芯片和控制模块仍采用硬连线方式。这造成了显著瓶颈,使得制造后的更新与扩展变得困难,并将昂贵的缺陷修复工作推至开发周期的末端。Google 通过与 RemotiveLabs 等合作伙伴合作及其 Horizon 平台,旨在解决这些效率低下问题。Android Automotive OS(AAOS)已利用基于 Arm 的 Google Cloud 实例上的 Cuttlefish 等虚拟测试环境,实现座舱软件的无缝开发。RemotiveTopology 将该虚拟模型扩展至整车电气与电子(E/E)架构。通过将车辆网络转化为“车辆即代码”,RemotiveTopology 构建了一个完整的模拟 E/E 架构,连接 AAOS 与其他车辆系统。这使得开发者能够按需启动完整的虚拟车辆,实现持续的信号与跨域可见性。该系统基于标准 Linux 工具构建,可在多种平台上运行,从笔记本电脑到 Google Cloud。这种方法促进了所有车载系统在虚拟环境中尽早而非晚期的集成,在涉及物理硬件之前完成。关键的跨域交互(例如 ADAS 事件出现在信息娱乐集群中)可从一开始就持续测试。这种早期集成显著降低了在开发后期发现缺陷的可能性和成本。最终目标是实现可扩展的软件开发,即使针对最小的车辆组件,从而弥合通往完全软件定义车辆的差距。Google Cloud 基于 Arm 的基础设施(包括 Axion 的裸金属 C4A 实例)确保了云端开发软件与实际车辆控制模块之间的对等性。这一整体系统首次实现了整车系统的云端开发与集成测试,并可直接迁移至物理车辆。其优势十分显著,据早期客户参与情况衡量,集成周期可加快超过 10 倍。虚拟系统对于跟上 AI 辅助工作流至关重要,后者能够快速生成、测试和完善车辆软件。RemotiveTopology 使该架构易于访问,在 GitHub 上提供开源的简化车辆模型,可立即使用而无需新的第三方工具。制造商可以利用现有工具链,轻松将 RemotiveTopology 集成到基于 Arm 的 Google Cloud 环境中。对于那些目前仅将虚拟开发局限于座舱的厂商,是时候通过这一创新方法将云端虚拟开发扩展至整车了。
CdXz5zHNQW_vlOyaZLNoM.jpeg
CdXz5zHNQW_eem4fhIiKn.png
现代 AI 代理充当简单的调度器,快速处理提示和 API 调用。然而,生物技术任务(如蛋白质折叠和化合物筛选)是复杂的持续模拟,与快速的 API 查找截然不同。由于超时和知识产权暴露风险,标准 AI 范式无法应对这些高需求的工作流。构建企业级研发代理需要一种新方法,超越单体助手模式。这涉及一个三层架构,将认知编排、计算执行和企业治理分离开来。执行层负责繁重的科学计算,工作负载在专用 GPU 或托管云端点上运行。为减轻 GPU 冷启动惩罚,维持热池和预加载权重对于响应性至关重要。容器化的 NVIDIA 推理微服务(NIMs)确保快速原型开发,同时为专有化学信息保持严格的数据隔离。认知层使用分层多代理结构编排代理工作流。关键的编排模式包括进程内原生代理交接以提升速度,以及通过云存储按引用传递大型负载以保持上下文窗口紧凑。工作流逻辑与生化推理解耦,将规划任务分配给通用大语言模型,将领域专业知识分配给专用模型。评估采用基于上下文的评估而非僵化的截断阈值,从而在药物候选评估中实现动态风险容忍度。性能最佳实践强调优化 I/O 和负载大小,而非原始 token 速度。将客户端并发与后端机制对齐,并避免深层工具链同样至关重要。按引用传递大型负载以及流式传输中间阶段完成结果可提升可见性和效率。将端到端管道封装在单一、清晰的接口之后可简化计算。Gemini 平台提供企业治理,包括代理身份、用于安全入口/出口的代理网关以及用于已批准工具的代理注册表。Model Armor 检查提示和负载的安全性。非对称自主权在可逆的自动化操作与需要人工审批的不可逆操作之间取得平衡。这种解耦的架构确保了可扩展、安全且可审计的研究系统,以应对未来复杂的模拟任务。