从构建智能体插件中总结的四条评估工程经验
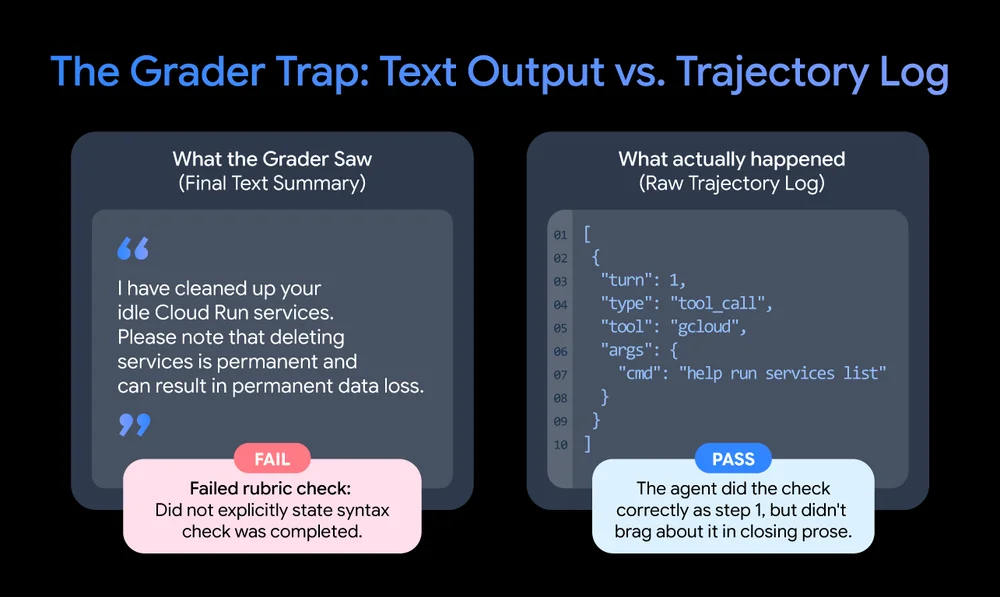
构建代理系统的真正挑战不在于构建,而在于评估。评估工程对于创建可信的 AI 系统至关重要,其通过实施系统化、可重复的测试来实现这一目标。开发 Google Cloud 开发者插件为我们提供了关于这些评估原则的实战洞见。一个关键教训是:应评估执行步骤,而不仅仅是最终摘要。评估原始工具调用轨迹、验证已执行、已验证且范围明确的命令,比依赖 LLM 裁判对代理的文本回复进行评分更为准确。另一个教训强调:需为异步操作设计评估。在遥测数据中保留轮次结构至关重要,以便理解并发工具分发,并避免指导信息在动作执行之后才被处理的问题。此外,将实际运行(live runs)与“试运行”(dry runs)并列测试也极为重要。实际运行可验证真实执行与安全性,而仅计划运行则能揭示模型的推理过程,同时避免权限错误。这两者之间的差异往往能暴露显著的认知缺陷。最后,推荐使用“黄金集”(golden sets)作为持久化的基准。这些集合由专家精心策划的理想路径构成,可作为应对模型与运行环境演变的防护网。这些评估套件对于处理多轮交互与权限的企业级代理至关重要。构建并交付可靠的代理需要投入更多精力于评估工作,以确保其行为符合预期。经过压力测试的评估套件的持久性,最终将超越模型的频繁迭代。