大规模管理 Apache Iceberg:Spanner 如何驱动湖仓运行时目录
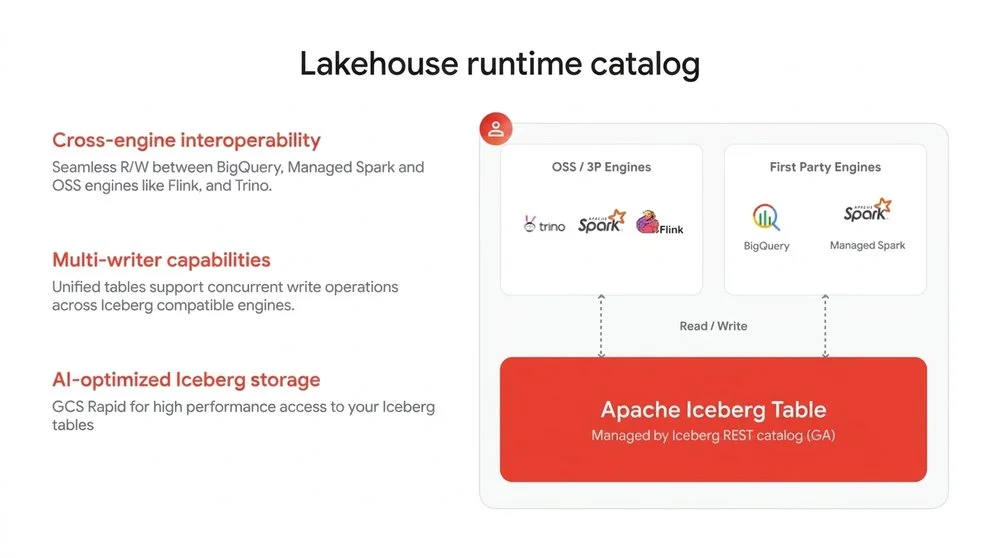
客户正在采用湖仓一体架构,标准化使用 Apache Iceberg 等开放格式,以构建面向 AI 原生解决方案的共享数据资产库。其中的关键组件是 Apache Iceberg REST Catalog,负责管理表指针、原子提交,并作为单一事实来源。企业需要一种高度可扩展、高可用且托管的目录,以支持 AI 代理产生的海量小型重复查询。此类目录必须解决原子提交、高可用性、数据库扩展、表维护以及稳健治理等挑战。由 Spanner 驱动的 Google Cloud 无服务器湖仓运行时目录为此类挑战提供了解决方案。该目录完全无服务器化、高度可用,并统一元数据,原生实现 Apache Iceberg REST Catalog 规范。其关键优势包括开放 API、多引擎互操作性(支持 BigQuery 和托管 Spark),以及对 Iceberg 表的读写能力。它提供完全托管的 Iceberg 存储,具备企业级功能,并通过直接指向对象存储中现有数据实现零数据复制。该目录还支持跨云的双向联邦(涵盖 Databricks Unity、Snowflake Horizon 和 AWS Glue),并利用凭证分发实现安全访问。它可与 Knowledge Catalog 和 Cloud IAM 集成,为 AI 驱动的情境感知和治理提供支持,提供表级安全、搜索和血缘追踪。至关重要的是,它依托 Google 的行星级基础设施和 Spanner,确保原子提交、并发控制、高可用性和可扩展性。Spanner 提供完整的关系型 SQL 语义,具备读写操作的横向弹性扩展能力,并通过区域配置实现高可用性。它自动扩展计算和存储资源,动态监控数据量和查询负载。这一基础支持可串行化事务,为代理级操作提供业界领先的强一致性保障。湖仓运行时目录与 Knowledge Catalog 集成,实现 Iceberg 表的高效发现,利用 Spanner 的全文本搜索和本征向量搜索提升召回率。这种集成方式消除了运维负担,加速了 AI 代理用例的上市时间。Google Cloud 的无边界湖仓统一了数据、治理和 AI 情境,同时降低了运维总拥有成本。