带点的零(Oleg Żero):面向 AI 系统的文本转图表:设计一种 LLM 能正确理解的领域特定语言
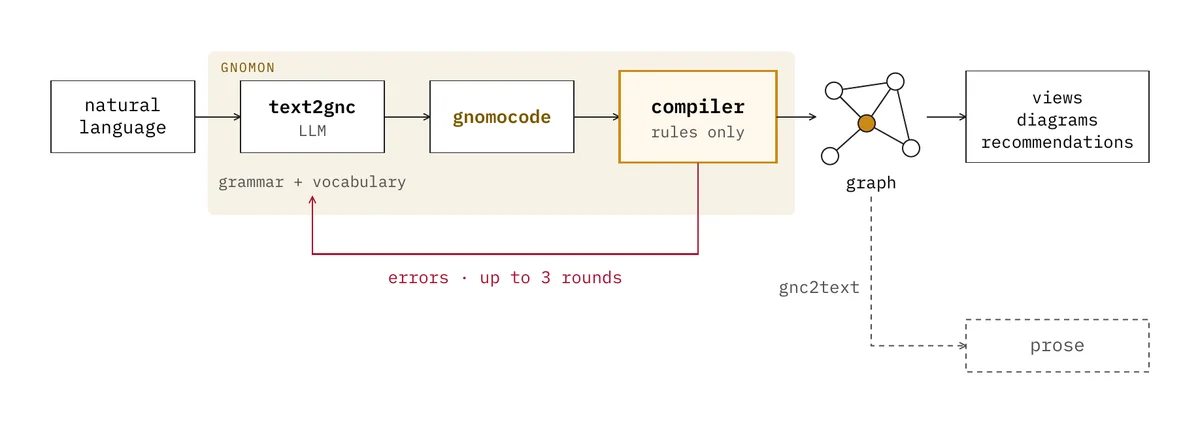
本文介绍了 Gnomon,一种解决软件开发中沟通断裂的解决方案。在软件开发的语境下,不同利益相关者对系统描述往往产生不同的解读。作者凭借多元化的从业经验指出,诸如“修复”一词在“我们正在构建一个代理来修复发票”这类表述中,会导致理解分歧并引发项目失败。大型语言模型(LLMs)的兴起进一步加剧了这一现象,其生成的架构设计图虽看似合理,却可能存在不准确之处。Gnomon 通过提供一种小型语言 gnomocode 以及一个编译器来解决上述问题。该编译器将语句与本体(ontology)进行验证。LLM 将自然语言翻译为 gnomocode,编译器检查其有效性,输出结果可被可视化、查询或转换回文本。该编译器采用 Python 编写,使用了 Lark、rdflib 和 pySHACL 等工具。Gnomon 的动机在于弥合口语与可执行图之间的鸿沟,确保一致性与可问责性。其目标支持双向运作:从对话到模型,以及从代码/图到可读文本。本文主要聚焦于从对话到模型的前向方向。Gnomon 的关键需求包括:术语无歧义、原生支持现代架构元素(LLMs、记忆、工具)、对人类和模型均具备可读性、从单一模型生成多种视图、版本控制,以及表达不确定性的能力。该方法论的演进源于尝试更简单的方法(如直接询问 LLM 或使用结构化对象),但这些方法未能解决架构图的复杂性及信息缺失问题。现有的表示法(如 UML 或 C4)也被发现不足,原因在于其符号固定、缺乏“可能”类陈述,且语义检查能力有限。采用带编译器的自定义语言被证明是最可行的解决方案。编译器能够提供本地化错误反馈,指导 LLM 进行修正。Gnomon 的核心在于其本体,该本体构建于现有的 RDF 词汇表(如 SKOS、PROV-O 和 DPV)之上。由 57 个术语和十二个模块构成的内核定义了关系与规则,确保一致性。该本体规定了词汇表、编译器错误消息、文本生成以及图视图。gnomocode 本身旨在兼顾可读性与精确性,其语法借鉴了 Markdown、Python 和图查询语言。它支持声明、属性赋值、动作和流等概念。一个关键特性是能够表达事实的置信度水平,使系统能够识别需要进一步确认的信息。该编译器采用 Python 编写,使用 Lark 进行解析。其语法直接由本体生成,这意味着扩展语言涉及修改数据而非代码。这种模块化设计允许在不改变核心解析规则的前提下灵活扩展词汇。