基于多集群 GKE 推理网关的全局 AI 路由,开销低于 1%
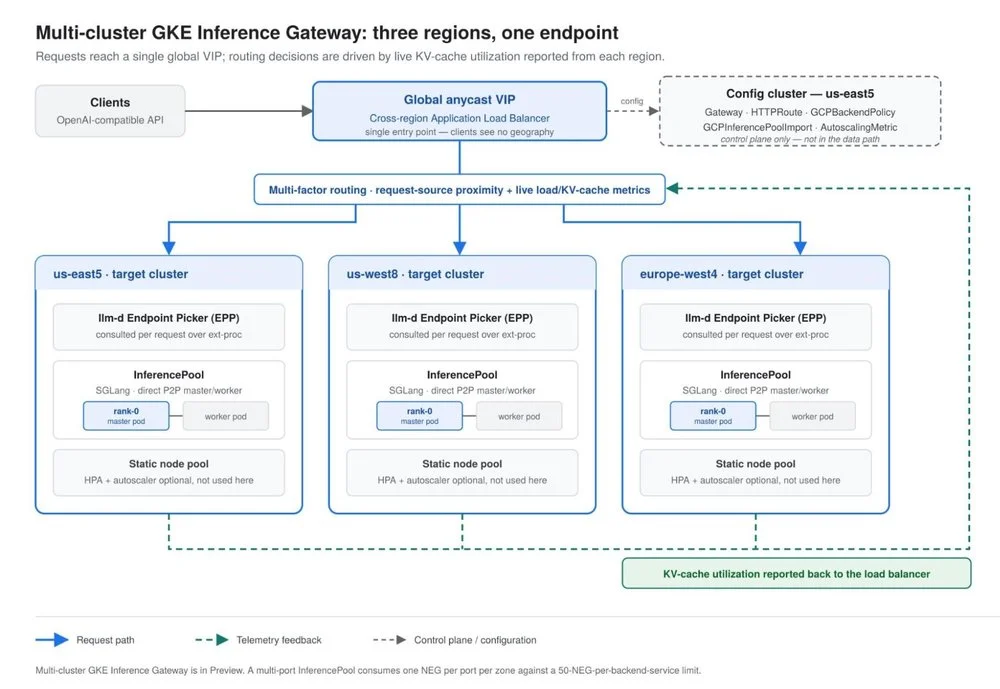
对 AI 基础设施(尤其是加速器)的需求极高,导致全球数据中心出现供应短缺和计算能力碎片化。现代 AI 工作负载具有较大的上下文窗口,会快速消耗加速器内存,加剧利用率问题。为解决这一问题,开发了一种分层路由架构,将全球分散的计算能力视为单一资源池。该系统具备多集群 GKE 推理网关,用于全球流量分发,以及基于大语言模型的 LLM-d 路由器,实现感知内存的调度。该架构对运行时、模型类型及加速器类型均保持无关性。在大规模多区域 GKE 部署上的基准测试表明,系统实现了接近线性的吞吐量扩展,成功率达到 99.9%。GKE 推理网关带来的额外开销小于 1%,可提供直接集群调用吞吐量的 99.5%。流量路由基于实时应用信号,特别是 KV 缓存 token 利用率,使系统能够智能地在区域间分流流量。这种感知内存的路由通过防止因内存饱和而导致加速器闲置,确保了高效利用。通过从新增加速器中获得近乎比例的性能提升,并避免资本浪费,实现了“每美元最大智能度”的收益。关键经验强调:智能负载均衡的重要性、考虑代理工作负载的内存瓶颈、适应 AI 流量的延迟特性、将路由与原生服务模式集成,以及选择开放且可移植的技术栈。