将 Netflix 基础模型集成到个性化应用中
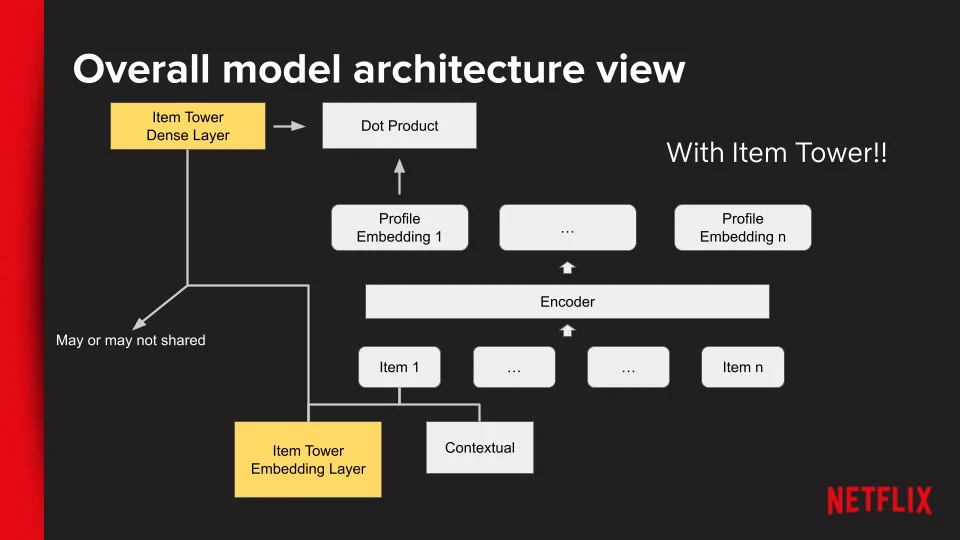
Netflix 开发了一种用于个性化推荐的基座模型(Foundation Model),以集中化成员偏好学习。该强大模型基于广泛的用户交互和内容数据进行训练,并将其学到的知识分发给其他模型。将这一大型模型集成到生产系统中颇具挑战,促使 Netflix 尝试了三种不同的方法:嵌入(embeddings)、子图(subgraph)和微调(fine-tuning)。每种方法均针对不同的应用需求,在延迟、技术栈和模型利用方面各有侧重。嵌入方法利用基座模型预计算的用户画像和物品表示,并将其存储于嵌入存储库(Embedding Store)中。该方法虽简单且成本效益高,但由于计算与推理之间存在时间差,可能导致推荐信息过时。Netflix 通过每日微调及嵌入稳定化技术对此进行增强,并正在开发一种近实时框架,以解决过时问题并提升适应性。子图集成方法将基座模型的解码器作为应用程序更大模型图中的一个组件。这种方式实现了更深层次的集成,能够利用最新的学到的知识,并通过访问基座模型的特定层来释放针对应用特有的价值。然而,它增加了特征生成的复杂性,并扩大了模型规模及推理时间。该方法仅保留用于高影响力场景,即指标提升足以证明其成本的使用案例。微调方法通过在特定产品数据和目标上进一步训练基座模型,使其适应特定应用程序。这提供了优化的性能,并作为新应用程序的基线。尽管需要针对延迟和服务水平协议(SLAs)进行精心优化,但它可能导致模型和流水线的大量增殖。Netflix 提供了一个微调框架以简化此过程。持续的创新包括近实时嵌入推理以及更小、经过蒸馏的基座模型版本,以降低延迟。标准化的 API 和强大的微调框架旨在使应用程序团队更易于利用基座模型。这三种集成模式为 Netflix 应用程序提供了一套综合策略,使其能够从基座模型中获益。