介绍 ModuleLens:深入 PyTorch 模块以能人类与智能体工程
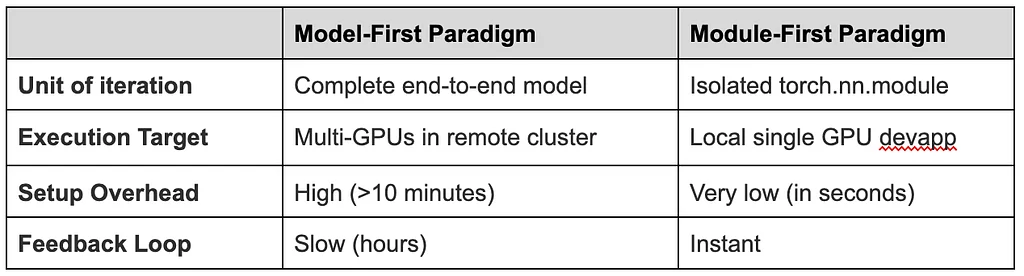
现代推荐系统因其大规模和分布式特性,在测试与调试方面面临重大挑战。传统的“模型优先(Model-First)”方法导致硬件瓶颈、输入数据依赖以及迭代反馈循环缓慢。ModuleLens 引入了一种“模块优先(Module-First)”范式,使工程师能够本地隔离、重构和剖析各个模块。这显著加速了开发工作流,并促进了自主 AI 代理的优化。ModuleLens 架构由 ModuleTracer、ModuleRepo 和消费层(Consumption Layer)组成。ModuleTracer 通过 PyTorch 前向钩子(forward hooks)以无侵入方式捕获关键的运行时数据,包括张量、参数和初始化参数,高效处理大张量并在内存中追踪模块初始化。ModuleRepo 将提取的模块状态集中存储于 Weights & Biases(WandB)注册表中,通过集合索引进行组织,并以包含元数据和二进制负载的版本化制品形式进行管理。消费层为人类工程师提供交互式 Jupyter 扩展和 IPython 命令行接口,并为大语言模型(LLM)代理提供 Agent Skills。这使得调试、探索以及自主模块分析与优化成为可能。ModuleLens 已被应用于多种内部工具,包括用于瓶颈识别的训练分析器(Training Analyzer)、用于 GPU 内核生成与验证的 KernelAgent,以及用于评估基础设施成本的扩展定律投资回报率工具(Scaling Law ROI Tools)。未来计划包括稳定核心系统、增强 Agent Skills 以支持高级优化(如 Triton/CUDA 内核合成),并实现自主训练与服务优化。ModuleLens 旨在提升人类工程效率,并为模型自动研究和递归自我改进提供执行基础。通过提供对隔离模块和性能信号的可靠访问,ModuleLens 赋能代理进行实验、修改组件、基准测试并保留成功的变更。本项目感谢来自产品机器学习基础设施(Product ML Infra)、ATG、HomeFeed 和广告排序团队的众多贡献者,他们在领导、设计洞察、测试、采用及代码开发方面提供了关键支持。