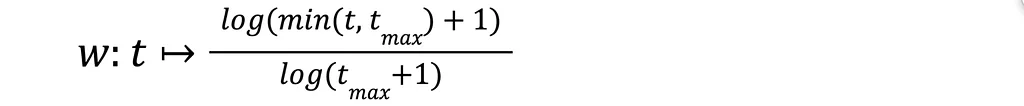Stories by Pinterest Engineeri... 笔记

Stories by Pinterest Engineering | Medium 中文

Medium 上的 Pinterest 工程展示了推动流行视觉发现平台的技术创新。通过深入的文章,工程师们分享了他们在可扩展性、机器学习、数据基础设施等方面的工作见解。该出版物强调了 Pinterest 的工程文化,强调协作、实验和解决复杂问题的热情。读者可以探索诸如构建推荐系统、优化搜索功能和开发数据分析工具等主题。内容为工程师和技术爱好者提供了宝贵的视角,了解像 Pinterest 这样的大型平台的技术细节。无论是深入研究图像识别的挑战还是他们基础设施的演变,Medium 上的 Pinterest 工程都为人们提供了一个迷人的技术视角。

笔记线程

CdXz5zHNQW_ydHVPNTidy.png
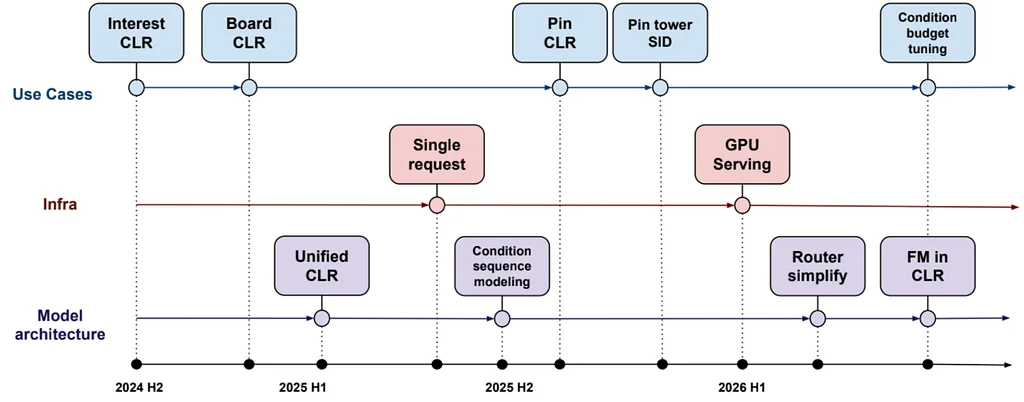
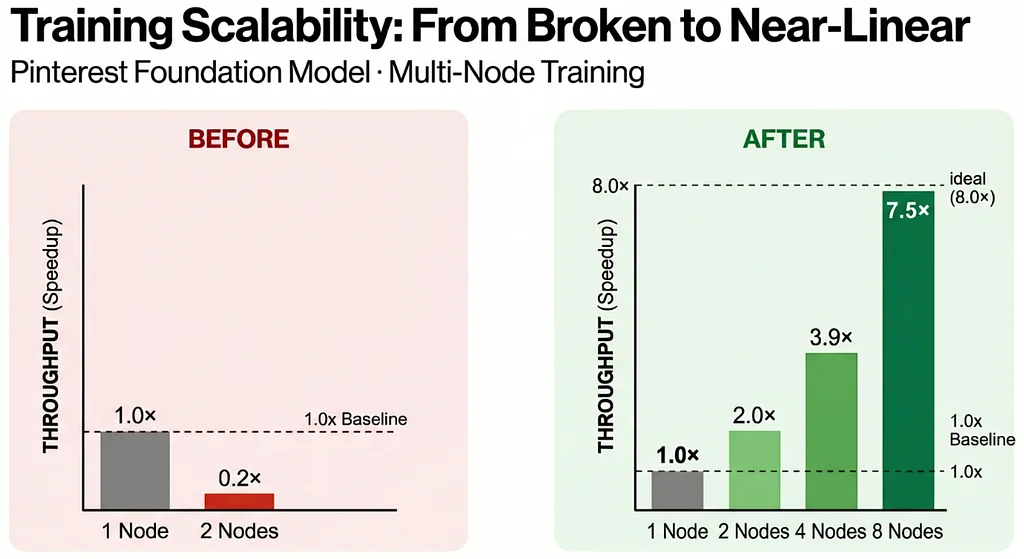
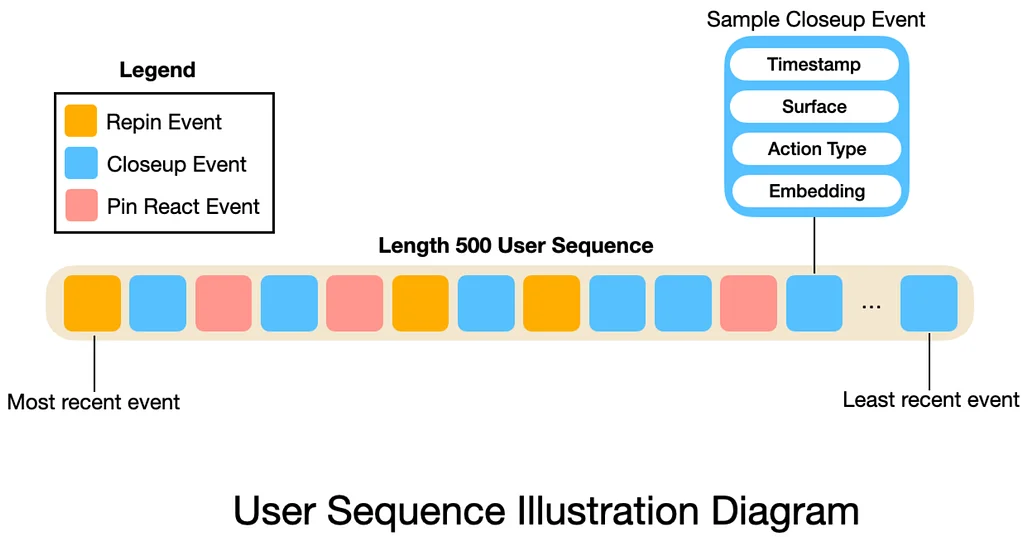
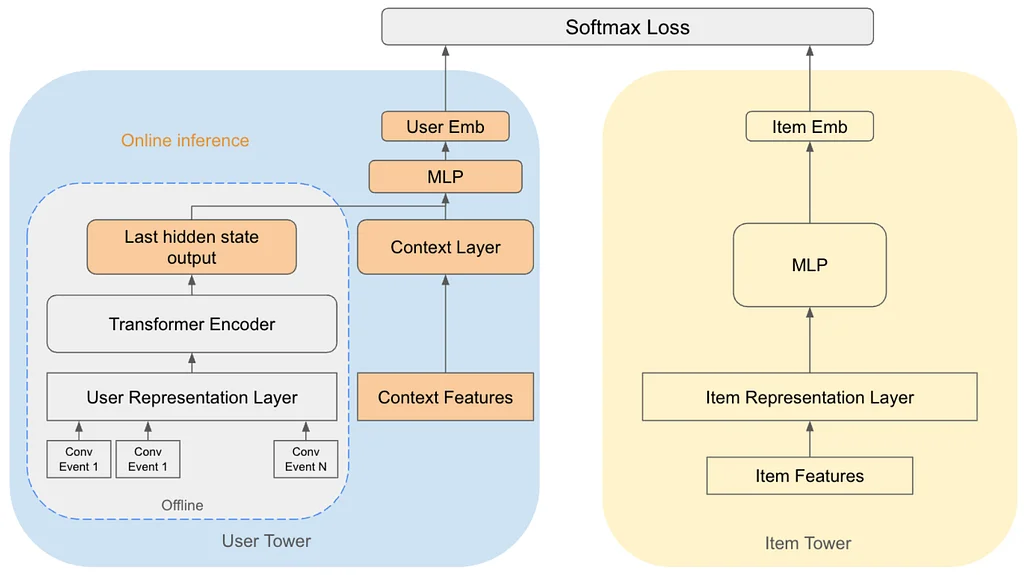
Pinterest 的主页信息流旨在通过改进推荐系统,为用户检索相关的 Pins。最初采用双塔模型,分别对用户和物品进行编码,但难以应对用户的多重兴趣。为此,提出了条件化学习检索(Conditional Learned Retrieval, CLR),通过显式检索上下文对用户嵌入进行条件化以解决该问题。 prior 工作已探索将 CLR 用于通知的引导式训练,并将其集成到主页信息流的多嵌入框架中。本文详细介绍了 CLR 如何演变为 Pinterest 主页信息流的更广泛检索系统。CLR 通过引入兴趣(Interests)、Pins 和 Boards 等新条件类型,扩展以支持多样化的检索候选项。兴趣条件最初从用户信号中引导式训练,随后利用大语言模型(LLM)生成的兴趣进行增强。Pin 条件通过对已互动的 Pins 进行聚类,并使用嵌入表示,使 CLR 能够替代遗留的生成器。Board 条件则通过在 Pin-Board 图上执行随机游走构建,并使用嵌入表示 Boards。模型基础通过序列建模和增强的条件表示进行了扩展。引入了条件化用户序列 Transformer(Conditioned User Sequence Transformer),使 CLR 具备序列感知能力,通过同时编码用户行为和条件 token 来实现。该架构进一步演化为基于基础模型(Foundation Model)的 CLR 架构,整合了在大规模全局用户序列上训练的大型 Transformer。该基础模型对用户塔和物品塔共享 Pin 嵌入,并采用对比对齐损失(contrastive alignment loss)。条件表示被统一,以便在单个模型内处理异构条件,减少重复工作。统一 CLR 将不同条件类型整合到一个模型中,支持多种条件输入并补全缺失特征。路由简化涉及将路由逻辑重构为与条件无关的槽位架构(Slot Architecture),为不同类型的嵌入预定义槽位。CLR 的训练效率通过无损的基础设施优化得到提升,训练吞吐量翻倍。请求级训练(request-level training)在批次内去重相同的用户特征,进一步优化工作正在进行中。该系统现已能在生产规模下高效处理多条件检索,通过提供更多样且相关的内容提升用户参与度。
CdXz5zHNQW_6wtn6E8XMD.png
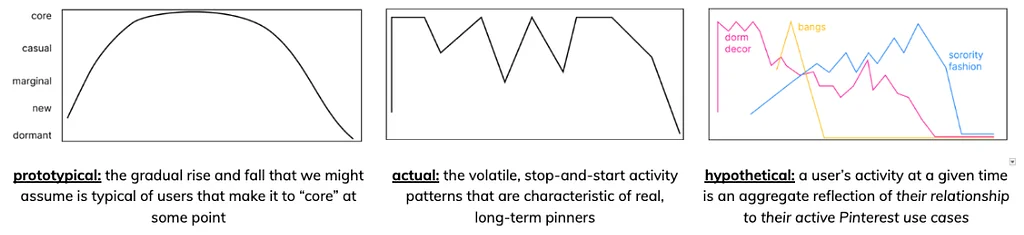
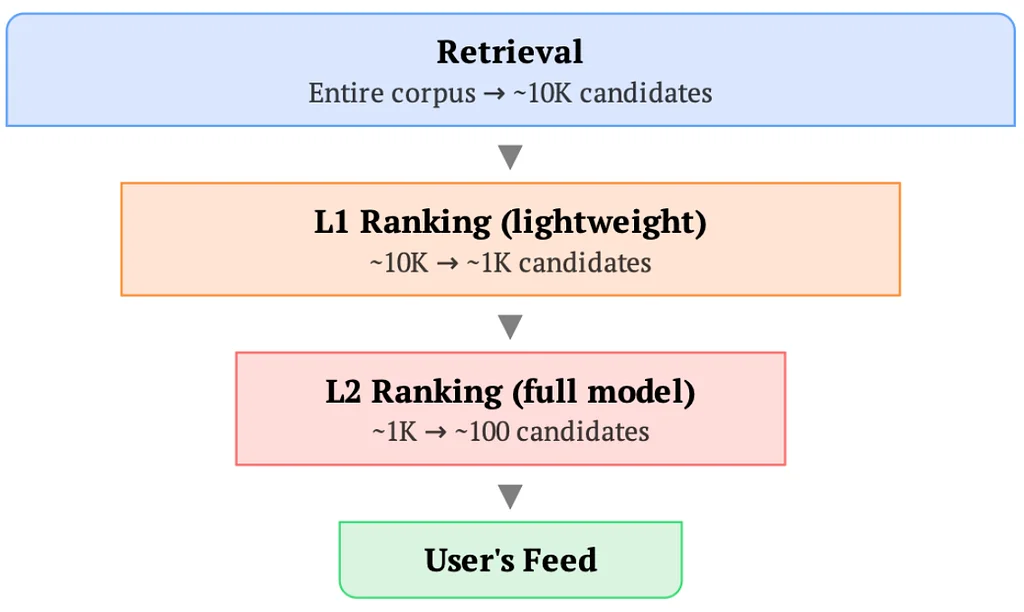
Pinterest 旨在通过其推荐系统帮助用户发现通往更美好生活的灵感。主页信息流作为关键发现平台,采用多阶段管道进行推荐。此前,优化工作侧重于点击和收藏等参与度指标。然而,参与度与留存率截然不同,仅优化参与度可能导致用户流失。本文介绍了"Pinner Progression"计划,该计划通过理解用户不断演变的需求,将用户留存置于优先地位。其核心理念是将顺序用户理解与持久用例表示相结合。这种方法有助于预判用户行为,并提供能够促进意外发现的推荐。引入的关键信号是用户兴趣簇(User Interest Clusters, UICs),它们代表了用户参与的各类不同用例。可持续增长依赖于建立用户与特定用例之间的长期关系,而不仅仅是短期参与度。分析表明,用例的采用与持续参与度和留存率呈正相关。现代推荐系统擅长理解用户当前的偏好,但在建模这些偏好的生命周期方面存在困难。区分用户处于活跃的“公寓装饰”阶段还是衰退的“酸面团”阶段,对于长期留存至关重要。UIC 表示建立在 PinnerSage 和 OmniSage 等过往工作基础之上,其创新之处在于仅针对已参与的内容进行个性化聚类,从而允许每个用户拥有动态数量的簇。关键的是,每个 UIC 均包含有状态的生命周期元数据,提供时序和行为洞察。这些元数据有助于推断用户兴趣的成熟度,区分转瞬即逝的好奇心与新兴的习惯。UIC 由 OmniSage 嵌入空间中的中心点(medoids)和地标图钉(landmark Pins)定义,其中接近度表示功能效用。信号构建涉及对用户近期参与嵌入进行层次聚类。完全连接算法基于其最不相似对的相似度合并簇,并设定相似度阈值。该过程在剩余任何一对的相似度未超过阈值或达到最大簇数量时停止。系统级集成涉及将 UIC 作为推荐管道检索、排序和混合阶段的共享抽象。这使得系统不同组件能够推理用户兴趣的成熟度。UIC 被外部化到共享特征存储中以提升效率,减少了多次信号获取带来的延迟。未来工作包括扩展 UIC,加入能够保留时序动态的长序列表示。检索是首个集成点,在此阶段,条件学习检索(Conditional Learned Retrieval)利用用户信息和条件生成候选项,以确保语义相关性。
CdXz5zHNQW_3eUbsaOfmV.png
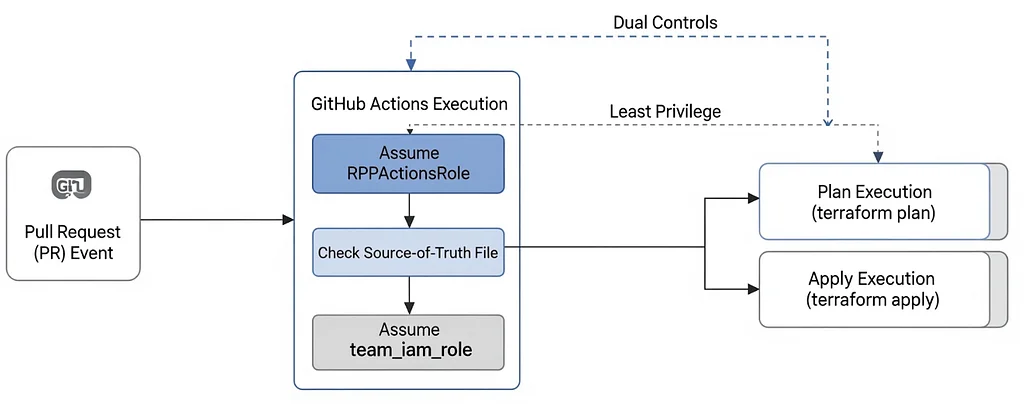
在 Pinterest 这样的大型分布式组织中管理基础设施即代码(IaC)面临着显著的安全与后勤挑战。为此,Pinterest 开发了资源供应管道(Resource Provisioner Pipeline, RPP),一种专有的 Terraform 执行引擎。RPP 能够在多仓库架构下安全地管理关键与非关键的基础设施变更。该系统通过双重控制、集中化的 GitHub Actions 以及安全的角色链式调用,为全球 AWS 运营提供合规性与强健的安全保障。RPP 管理着数百个 Terraform 工作区,管控着数万个 AWS 资源,涵盖安全策略、网络及计算资源。RPP 的 GitHub 工作流采用集中执行模型,由拉取请求(PR)事件触发。该流程使用组合式 GitHub Actions,并通过为每个工作区独立执行计划来隔离工作区的影响。双重控制增加了必要的人工审查层,需经代码审查员批准。为贯彻最小权限原则,RPP 实施了严格的工作区 - 路径 - 角色映射,利用安全的角色链式调用。流程始于通过 GitHub OIDC 认证并假设集中化的 RPPActionsRole,随后确定工作区属性,将其映射到允许的仓库、路径及执行角色。关键的后端验证确保代码路径严格引用指定工作区对应的 S3 状态后端及 KMS 密钥。若验证通过,RPPActionsRole 将假设一个作用域受限的团队 IAM 角色,从而确保权限最小化。部署流程包括代码检查、在 PR 上输出计划结果,以及通过特定评论触发的审慎应用。该方法带来的优势包括统一审计、即时系统性补丁以及集中化的资源指标。
CdXz5zHNQW_ggFzV94AMK.png
Pinterest 为其基于 Kafka 的 CDC 摄入平台开发了一套稳健、自动化的模式演进框架。模式变更是跨系统的关键契约,若缺乏管控的演进可能导致管道故障和数据不一致。其解决方案旨在通过将其视为多阶段收敛过程,使模式演进具备安全性、可重复性和可扩展性。该架构涉及 CDC 源、Kafka、用于转换的 Flink 以及用于向 Iceberg 表执行 upsert 操作的 Spark。核心组件是一个可靠的接入模型,该模型以包含稳定数字标识符的模式定义文件作为单一事实来源。更新通过基于 PR 的发布流程(包含版本控制和审计)自动传播至 Kafka、Flink、Spark 和 Iceberg。该系统主要支持增量式模式变更,以维持向后兼容性并最小化复杂性。类型变更严格限制为保留语义含义的变更,例如数值精度扩展。模式演进通过三阶段收敛模型进行管理,以维持管道可用性。第一阶段更新 Iceberg 模式,第二阶段部署更新后的 Flink 和 Spark 代码,第三阶段确保数据收敛。这种分阶段方法将模式传播与数据正确性解耦,允许在定义的 SLA 范围内存在临时差异。Pinterest 采用基于 SLA 的模式演进模型,优先保证可预测性和运营安全性。部署策略经过精心管理,尤其是针对 Flink,以防止数据丢失。对于不支持或存在歧义的情况(如默认值或主键变更),设有特定的手动恢复路径。针对 CREATE TABLE 差异的歧义问题,通过对比数据库的实际 DDL 历史记录来解决,而非从文本变更中推断意图。并发模式变更按顺序处理,以防止竞态条件,确保串行收敛。列转换通过为模式添加所需转换注解进行管理,这些注解随后被注入摄入管道。错误处理与恢复机制(特别是针对 Spark 故障)确保处理能够从最后一个成功的水印处恢复。
CdXz5zHNQW_srAU1TSiiq.png
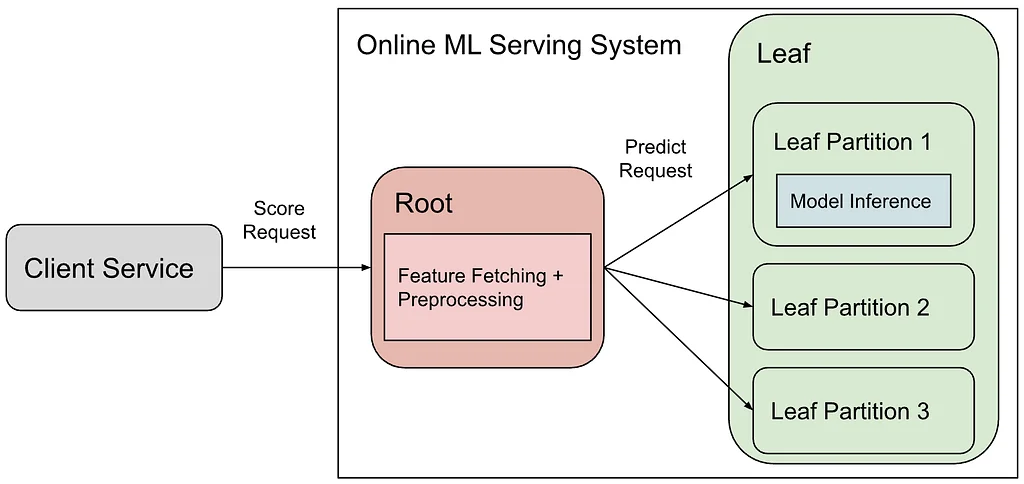
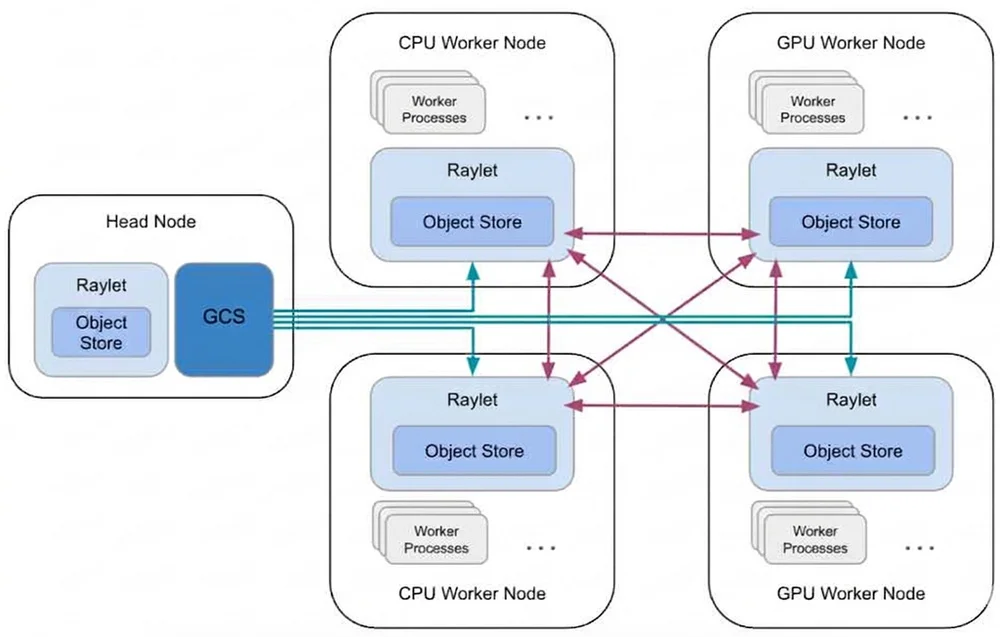
Pinterest 的在线机器学习(ML)服务系统采用根 - 叶架构,客户端服务通过该架构请求 Pin 的预测分数。根组件负责特征检索与预处理,而叶节点执行模型推理,通常利用 GPU。该设计简化了新模型的接入流程,并通过分离 CPU 与 GPU 工作负载优化资源利用率。然而,由于传递大量特征,根与叶分区之间出现了网络瓶颈。最初,系统实施了 lz4 压缩以减少网络用量,虽显著节省了带宽,但导致 CPU 使用率和延迟略有上升。这虽是一个良好的开端,但核心问题——传输不必要的特征——依然存在。随后,团队开发了“按需发送”(Send What You Use)方案,仅发送特定模型所需的特征,以解决这一问题。模型签名(model signature)定义了模型的输入与输出,是特征需求的权威来源。模型在训练并导出时,其签名会一同保存。Leaf 节点加载这些签名,构建特征转换器,仅处理必要特征。为同步根与叶之间的特征需求,模型签名被发布为轻量级工件(artifacts)。这些签名被聚合为包级映射(bundle-level mappings),随后与现有配置一同部署至根节点。该部署流程遵循与模型发布相同的分阶段交付机制,确保一致性并支持优雅回滚。此集成使得 Feature Trimmer 能够动态更新根节点上的特征白名单,确保仅传输必要特征。系统通过版本化查找和降级机制,处理频繁模型更新与渐进式发布,确保根节点对所需特征的视图与实际部署在叶节点上的模型保持同步。通过剪枝不必要的特征,Pinterest 显著降低了网络流量并提升了基础设施效率。
CdXz5zHNQW_Pr67hugpQp.png
CdXz5zHNQW_iZkUUBsGZ2.png
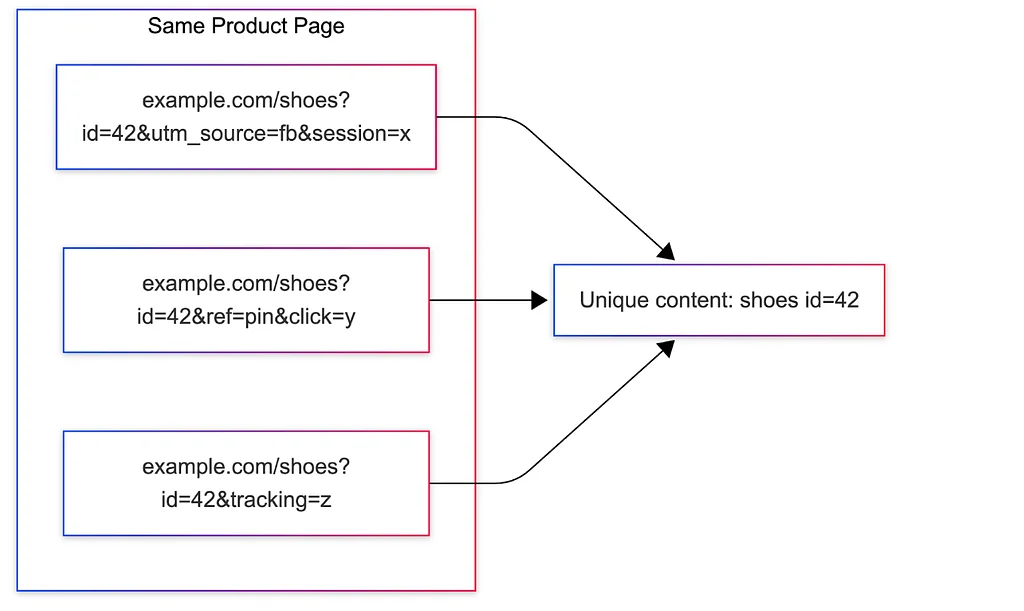
Pinterest 利用内容理解来驱动内容分发与用户互动,这需要深入理解图像和出站链接。核心问题在于 URL 规范化:由于跟踪参数的存在,相同的产品页面可能以多种不同的 URL 形式出现。这种冗余会导致重复抓取和处理,从而浪费计算资源。项目规范化旨在将不同 URL 所代表的相同项目统一起来,这对于购物目录至关重要。当项目 ID 缺失时,高级 URL 规范化对于去重尤为关键。最小重要查询参数集(MIQPS)算法能够自动学习哪些 URL 参数会影响内容身份。该算法能够区分中性参数(不影响页面内容)和非中性参数(会影响页面内容)。虽然静态规则适用于知名平台,但 Pinterest 拥有庞大的域名集合,因此需要一种动态的、数据驱动的方法。MIQPS 算法分为三个步骤。首先,从 Pinterest 的摄入管道中收集每个域名的观测 URL 语料库。其次,根据查询参数模式对 URL 进行分组,确保参数在其特定上下文中进行分析,避免因 URL 类型不同而错误分类参数。最后,对于模式中的每个参数,算法通过实证测试其重要性。它会采样具有不同参数值的 URL,并计算原始 URL 和修改后(移除该参数)URL 的内容 ID。如果在一定比例的样本中,移除该参数会导致内容 ID 发生显著变化,则该参数被归类为非中性参数并予以保留;否则,该参数被视为中性参数,可在规范化过程中安全移除。每个商家域名都会获得专属的 MIQPS 映射表,以反映该域名下参数的特定含义。
CdXz5zHNQW_WVip85jMBw.png
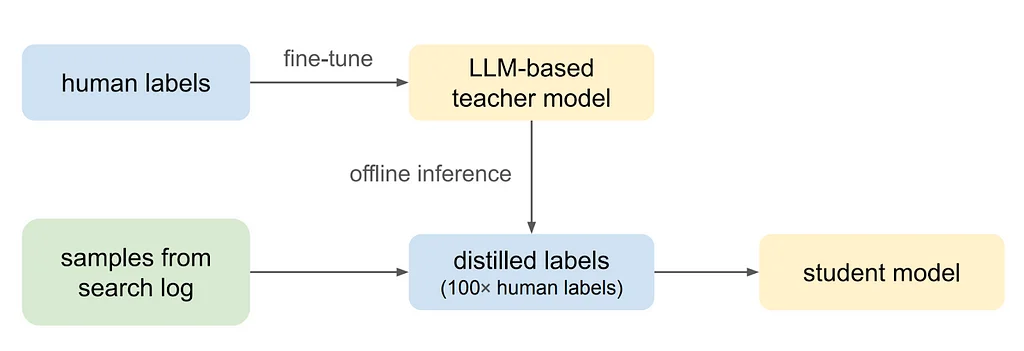
Pinterest 搜索是用户可以发现与他们的信息需求相符的启发性内容的关键入口,搜索相关性衡量搜索结果与搜索查询的匹配程度。为了改进搜索相关性模型,我们使用一个 5 级准则来衡量查询和 Pins 之间的相关性。我们使用交叉编码器语言模型来预测 Pin 与查询的相关性,同时结合 Pin 文本,并将任务表述为多类别分类问题。该模型使用人工标注的数据进行微调,最小化交叉熵损失。为了表示每个 Pin,我们使用了一系列不同的文本特征,包括 Pin 的标题和描述、合成的图像标题、高参与度的查询词、用户策划的板块标题以及链接标题和描述。然而,基于交叉编码器 LLM 的分类器由于实时延迟和成本的考虑,难以在 Pinterest 搜索中进行扩展。因此,我们使用知识蒸馏将基于 LLM 的教师模型蒸馏成一个轻量级的学生相关性模型。学生模型使用查询级特征、Pin 级特征和查询-Pin 交互特征来预测 5 级相关性分数。我们采用知识蒸馏和半监督学习来训练学生模型,这有效地利用了大量最初未标记的数据,并将数据扩展到世界范围内的多种语言。离线实验证明了每个建模决策的有效性,包括语言模型的比较、丰富文本特征的重要性以及通过蒸馏扩大训练标签规模。在线结果显示,搜索 feed 相关性提高了 +2.18%(通过 nDCG@20 衡量),并且在全球范围内搜索完成率显着提高。所提出的相关性建模流程有效地推广到训练期间未遇到的语言,而基于多语言 LLM 的相关性教师模型则推广到未见的语言。未来的工作将探索整合可服务的 LLM、视觉与语言多模态模型以及主动学习策略,以动态扩展和提高训练数据的质量。
CdXz5zHNQW_lGLj8VappE.png