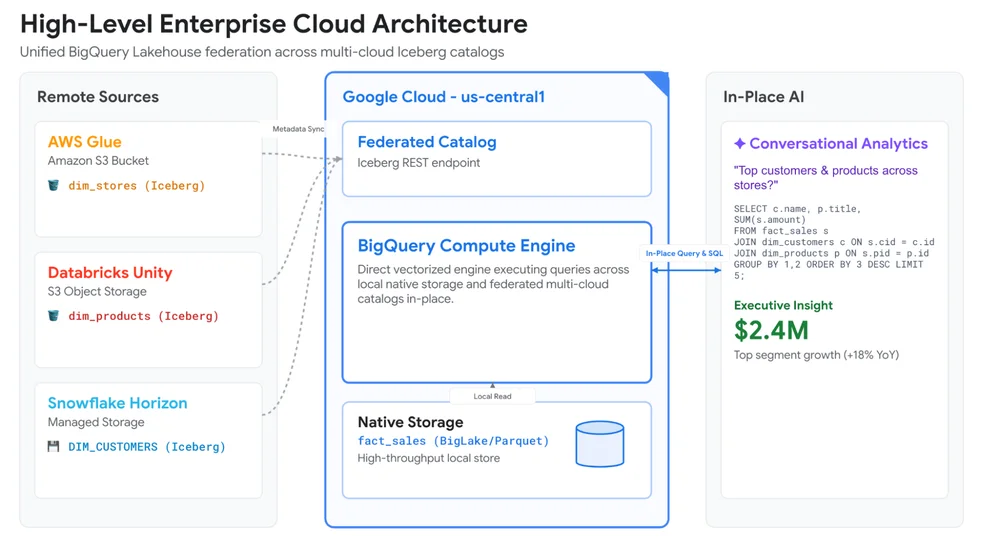
借助开放标准,让跨云对话分析变得简单
组织常面临数据分散在多个专用平台和云环境中的碎片化挑战。以往,这要么需要构建复杂的数据管道,要么只能接受报告不完整。传统方法涉及将数据复制到中央数据仓库,导致同步问题、存储成本增加,以及当模式变更时管道中断。Google Cloud 基于 Apache Iceberg 构建的无边界湖仓(borderless Lakehouse)提供了一种解决方案,它使计算和 AI 能够跨不同平台就地访问数据。该架构在同步元数据的同时,允许直接访问数据文件。它支持将来自 Databricks、Snowflake 和 AWS Glue 的数据联邦至 BigQuery,而无需数据迁移。BigQuery 中的联邦查询使用四部分路径来访问这些外部目录中的数据。这种集成实现了对异构数据集的统一查询与分析。此外,联邦表可与 BigQuery 的对话式分析结合,用于通过自然语言进行探索。运营层面的考量包括管理后台刷新时机、理解查询缓存机制,并确保数据驻留合规性。无边界湖仓旨在通过消除昂贵的迁移和复杂的数据管道来简化数据激活。