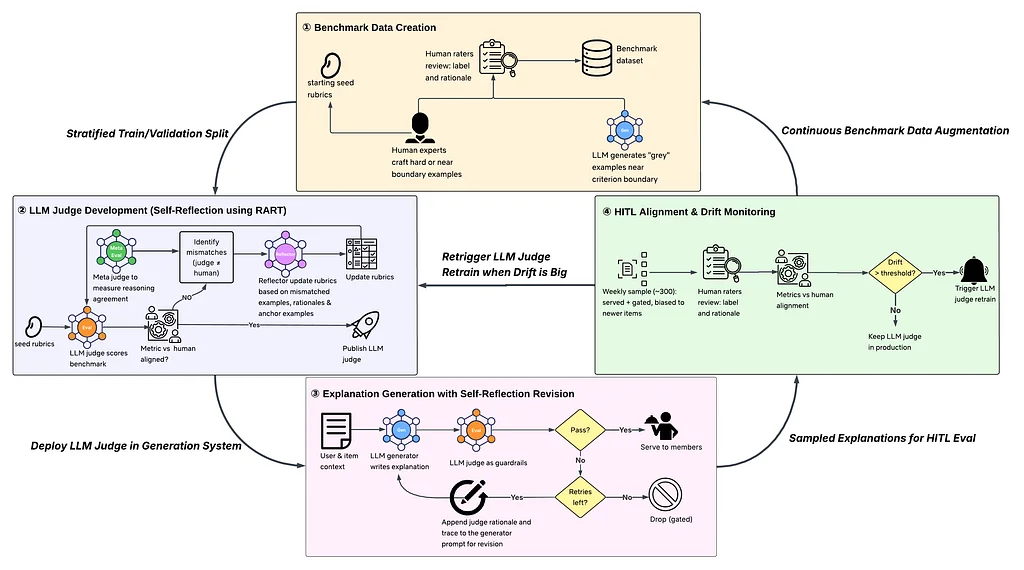
LLM-as-a-Judge 的生命周期:规模化构建、对齐与监控
大规模文本生成依赖大语言模型(LLM)时,由于人工审查存在局限性,必须采用自动化评估方法。"LLM-as-a-Judge"方法利用第二个 LLM 对主 LLM 的输出进行评分,但引发了关于评估者可信度的担忧。该问题通过构建、对齐并持续监控 LLM 评估者来解决,确保其在每个阶段都始终锚定于人类判断。人类负责定义质量标准、创建标注数据集、监控评估者行为并批准更新。可靠的 LLM 评估者并非静态存在;它具有生命周期,涵盖其创建、对齐、运行和维护中的人类所有权。这一过程通过生成推荐解释的任务得以阐明,推荐解释是简短的消息,用于解释物品推荐。质量至关重要,因为误导性解释会侵蚀用户信任。LLM 评估者的生命周期包含四个阶段:诞生(Birth)、训练(Training)、部署(Deployment)以及人机协同对齐与漂移监控(HITL Alignment & Drift Monitoring)。诞生阶段由人类专家构建基准数据,包括对抗性示例和边界案例,随后由人类评分员进行标注。训练阶段利用自我反思和评分标准更新,使 LLM 评估者与人类标注及理由对齐。部署阶段将评估者集成到解释生成系统中,作为守门人和批评者。人机协同对齐与漂移监控通过定期将评估者与人类评分员进行基准测试,并要求任何系统变更均须获得人类批准,从而确保持续的可信度。该阶段使用元评估者(Meta-Judge)比较 LLM 评估者的理由与人类理由,捕捉评估者得出正确答案但理由错误的情况。这一持续反馈循环整合了新的人类标注数据和信号,并反馈至基准和开发阶段。系统组件包括生成器(Generator)、评估者(Judge)、反思器(Reflector)、元评估者(Meta-Judge)以及人类专家和评分员,它们在整个生命周期阶段协同工作,以维护评估者的完整性。