使用 GKE Pod 快照,更快地、更高效地扩展您的 AI 工作负载
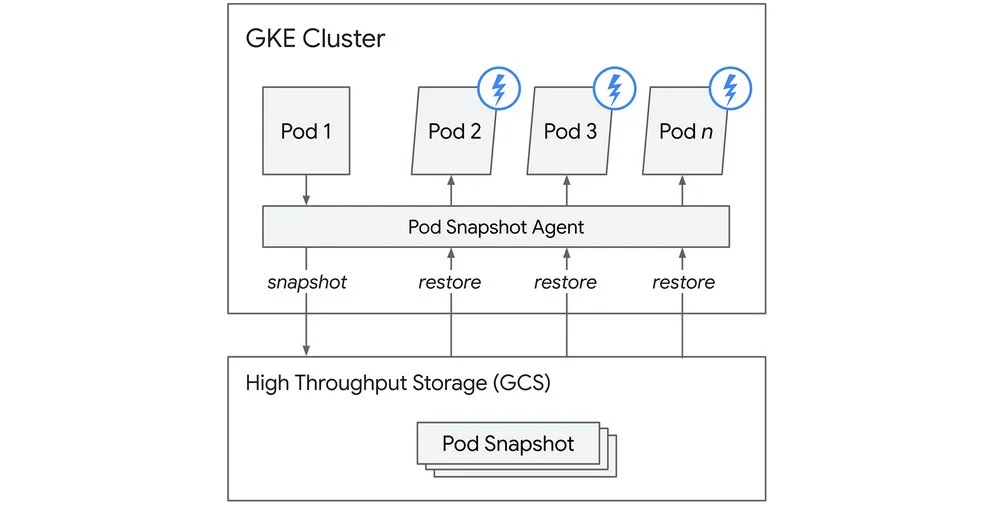
现代 AI 工作负载因初始化时间长而面临性能与成本的困境。大型语言模型和即时代码执行需要快速 provisioning,往往导致基础设施过度支出。Google Kubernetes Engine (GKE) Pod 快照提供了一种解决方案,通过保存和恢复运行中的工作负载状态。该功能大幅缩短了 AI 推理的启动时间,可在数秒内加载大型模型。冷启动是许多应用程序面临的问题,在 AI 领域尤为突出,主要源于显著的 GPU 内存加载开销。传统方法涉及过度 provision 或用于状态恢复的复杂自定义方案。GKE Pod 快照通过消除新副本中冗余的模型加载,实现了 AI 推理的高效扩展。单次初始化即可创建持久化快照,使新实例能够瞬间恢复。这加速了扩展过程,并减少了对昂贵过度 provision 的依赖。对于代理工作流,Pod 快照可改善启动延迟并有效管理空闲沙箱。快照能快速初始化新的代理环境,并允许空闲沙箱即时挂起和恢复。该功能适用于各种具有长初始化阶段的工作负载。GKE Pod 快照通过用于快照管理的声明式策略,与 Kubernetes 工作流无缝集成。