TimeSeries 分层存储之旅:从 Kafka/Flink 流到原生 Cassandra 冷读
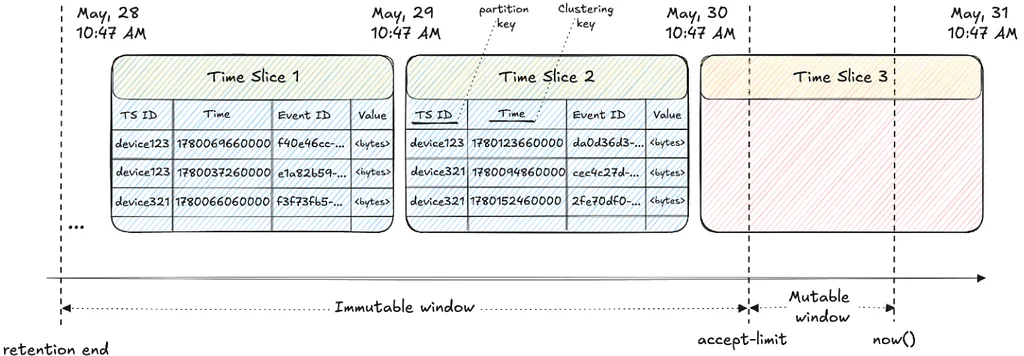
Netflix 的时序抽象平台(TimeSeries Abstraction)对于处理 PB 级时序数据至关重要,但其面临显著的存储成本挑战。为解决这一问题,已实施两种方案,旨在将较旧且访问频率较低的数据迁移至更廉价的对象存储,同时保持低延迟访问。第一种方案利用 Apache Kafka 和 Flink 将数据流式传输至 S3,随后执行每日压缩作业,对 Parquet 文件进行合并与优化。该压缩过程包括创建小型行组、按时间对事件进行排序,并利用布隆过滤器实现高效读取。压缩后的文件随后在控制平面中注册,从而允许对热存储进行截断。读取请求会在热存储和冷存储层之间进行扇出,其中冷存储层利用压缩元数据以最小化 S3 读取操作。尽管第一种方案取得了成功,但其流式处理基础设施引入了复杂性与成本。这促使了第二种更为集成的解决方案的开发,该方案利用 Cassandra 备份功能。此方法旨在直接从 S3 备份中读取数据,而无需单独的数据传输。它引入了一种新的 Cassandra 压缩策略,称为只读压缩策略(ReadOnlyCompactionStrategy,ROCS),用于处理不可变的时间切片。ROCS 将 SSTable 与令牌范围对齐,从而减少了读取扇出,并提升了所有存储层的延迟性能。Cassandra 将其数据备份至 S3,生成列出 SSTable 路径的清单。第二种方案对 Cassandra 进行了定制,使其能够直接从这些 S3 备份中读取不可变时间切片的数据。该方案使用了可插拔的内存表(Memtables),具体为"backupmemtable",以重定向读取请求。该 backup Memtable 会从 S3 下载必要的索引和元数据文件至节点。强大的弹性机制确保了组件下载与初始化的可靠性。一旦本地组件准备就绪,Cassandra 便从这些备份中服务读取请求,通过并行化 S3 读取并利用缓存进行进一步优化。该策略通过消除独立的流式处理基础设施,显著降低了运维开销与基础设施成本。